ai-powered-markdown-translatorArtículo traducido del francés al español con gpt-6.1-sol.
Anthropic cierra su salida a bolsa: unos 93,5 mil millones de dólares brutos por la oferta, y otros 26 mil millones aportados por siete grupos, entre ellos NVIDIA, Google y Microsoft, en una colocación privada realizada en paralelo. Thinking Machines publica Inkling 2 Mini, un modelo de pesos abiertos de 26,4 mil millones de parámetros que cabe en 20 Go, y OpenAI reduce del 54,0 % al 0,2 % la tasa de éxito de los ataques que extraen el razonamiento protegido de sus modelos. ChatGPT Space se abre a los suscriptores Plus, Runway confía a agentes el 38 % de sus fusiones de código, y Claude Code, Codex CLI y Vibe CLI publican cada uno una nueva versión.
Finanzas: Anthropic cierra su salida a bolsa, con 93,5 mil millones de dólares brutos y una colocación privada de 26 mil millones
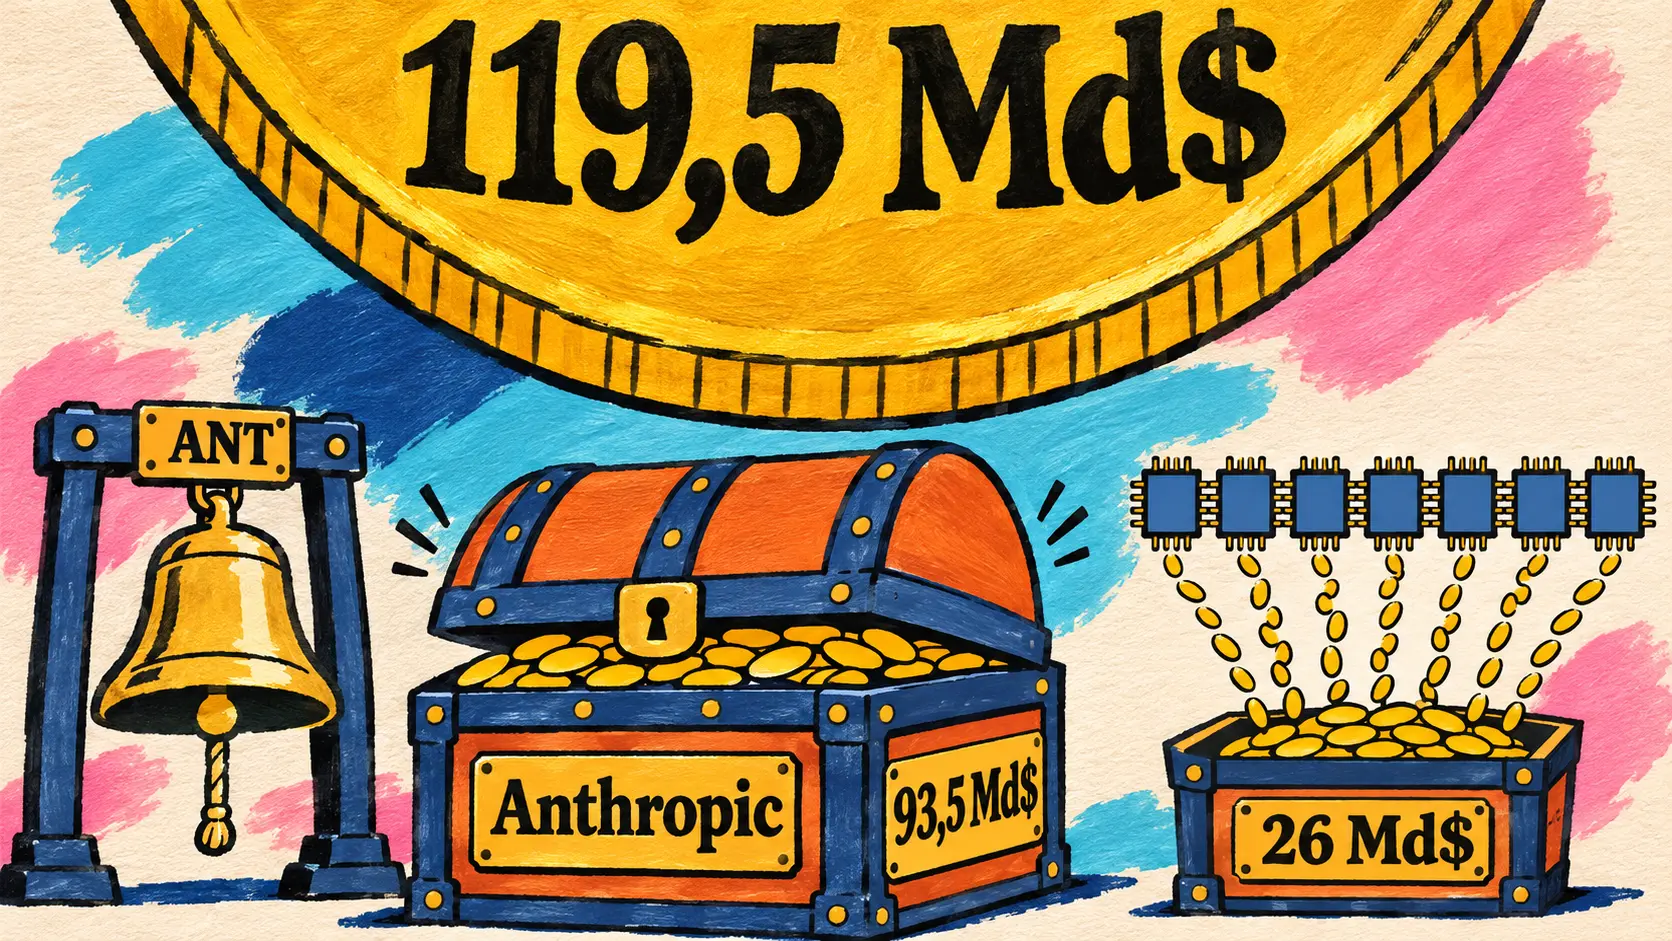
20 de noviembre — Al día siguiente de su debut bursátil, Anthropic anuncia el cierre de su salida a bolsa, cuyo precio se había fijado el 18 de noviembre en 83 dólares por acción. Los bancos han ejercido íntegramente su opción sobre 147 millones de acciones adicionales: en total, se han vendido 1 127 000 000 acciones de clase A. Los ingresos brutos alcanzan unos 93,5 mil millones de dólares antes de comisiones y gastos, de los que unos 91,6 mil millones corresponden a Anthropic, que no recibe nada por las 23 648 646 acciones vendidas por accionistas existentes.
La publicación también informa de una colocación privada realizada en paralelo y también cerrada, que no se mencionaba en el anuncio del precio: 313 253 007 acciones de una clase N, vendidas al mismo precio de 83 dólares a siete grupos de los sectores de semiconductores e informática (AMD, Broadcom, Google, Micron, Microsoft, NVIDIA y TSMC Partners), por unos 26,0 mil millones de dólares. Estas acciones no están registradas conforme a la Securities Act de 1933. Sumando la oferta pública y esta colocación, el importe bruto se acerca a los 119,5 mil millones de dólares, antes de comisiones y gastos.
| Elemento de la operación | Valor anunciado por Anthropic |
|---|---|
| Acciones de clase A vendidas | 1 127 000 000, de las que 147 000 000 corresponden a la opción de los bancos |
| de las que vendidas por Anthropic | 1 103 351 354 |
| de las que de accionistas existentes | 23 648 646 |
| Precio por acción | 83 dólares |
| Ingresos brutos de la oferta | unos 93,5 mil millones de dólares |
| Parte recibida por Anthropic | unos 91,6 mil millones de dólares |
| Colocación privada (clase N) | 313 253 007 acciones, unos 26,0 mil millones de dólares |
| Total bruto, oferta y colocación | unos 119,5 mil millones de dólares |
| Cotización | desde el 19 de noviembre, Nasdaq Global Select Market, símbolo ANT |
La publicación confirma la cotización, sin dar el precio de la acción ni la capitalización bursátil. Goldman Sachs y Morgan Stanley han dirigido la operación, con un sindicato de una veintena de bancos, entre ellos J.P. Morgan, Citigroup, BNP Paribas, Crédit Agricole CIB y Société Générale. Ese mismo día, @AnthropicAI publicó un vídeo en el que los siete cofundadores, Dario Amodei, Daniela Amodei, Tom Brown, Jack Clark, Jared Kaplan, Sam McCandlish y Chris Olah, cuentan la historia de la empresa.
🔗 Cierre de la salida a bolsa (Anthropic) · @AnthropicAI en X: los cofundadores
Modelos abiertos: Inkling 2 Mini de Thinking Machines, Tencent Hy4, un superadaptador para Qwen3.8-27B, Ayb 0.5 y Depth Pro 2
20 de noviembre — Thinking Machines Lab publica Inkling 2 Mini, el hermano pequeño de Inkling 2 Small (594 mil millones de parámetros, del que hablamos aquí el 12 de noviembre). Esta mezcla de expertos (Mixture-of-Experts) de pesos abiertos, bajo licencia Apache 2.0, cuenta con 26,4 mil millones de parámetros, de los que 3,4 mil millones están activos por token. Lee texto e imágenes, con un contexto de un millón de tokens. Sus pesos se distribuyen con la precisión del entrenamiento, NVFP4 para veinte capas y MXFP8 para las cuatro últimas, lo que supone unos 20 Go sin pérdida por conversión: funciona con Ollama en cualquier Mac con al menos 32 Go.
Today we are releasing Inkling 2 Mini, a fast, powerful model that’s small enough to run on your laptop.
🇪🇸 Hoy publicamos Inkling 2 Mini, un modelo rápido y potente, lo bastante pequeño para ejecutarse en tu ordenador portátil. — Thinking Machines Lab, anuncio de Inkling 2 Mini
Su particularidad está en la arquitectura: es un transformador con bucles (looped transformer). De sus 24 capas, las 12 centrales se recorren tres veces, lo que supone 48 pasos por capas por token con 24 capas almacenadas, de ahí los 5,4 mil millones de activaciones de pesos por token. Durante el entrenamiento, el laboratorio también podó dos tercios de los expertos (de 384 a 128) y después reparó el modelo con 1 000 mil millones de tokens destilados de un modelo Inkling interno más grande. Según el laboratorio, con la misma pérdida, un modelo sin bucles requeriría un 7,5 % menos de cómputo de entrenamiento, pero un 140 % más de cómputo de inferencia.
| Prueba (tabla de Thinking Machines) | Inkling 2 Mini | Qwen3.8-27B | Nemotron 3.5 Super VL |
|---|---|---|---|
| Activaciones de pesos por token / parámetros totales | 5,4B / 26,4B | 27,0B / 27,0B | 12,0B / 124,5B |
| AA Index v5.0 | 20,1 | 20,1 | 13,6 |
| DeepSWE v1.1 | 48,2 % | 42,2 % | 24,7 % |
| SWE-bench Pro v2 Hard | 77,9 % | 73,8 % | 44,1 % |
| Terminal-Bench 2.1 (pi) | 71,6 % | 73,0 % | 60,7 % |
| BrowseComp | 79,0 % | 61,6 % | 78,9 % |
| MCP Atlas | 82,7 % | 77,3 % | 67,7 % |
Según Thinking Machines, el modelo lidera los modelos abiertos de menos de 100 mil millones de parámetros en DeepSWE v1.1 y en el Vals Index v2.2 (46,5 %). Queda por detrás de Qwen3.8-27B en Terminal-Bench 2.1, y Thinking Machines reconoce que no es el mejor modelo pequeño en conversaciones de varios turnos (50,0 % en MultiChallenge) ni con instrucciones sujetas a múltiples restricciones (33,4 % en ComplexConstraints v1.1); la leyenda del gráfico precisa que las configuraciones de evaluación varían de un modelo a otro. Investigadores de Stanford, con acceso anticipado, han medido 0,703 de inteligencia por julio en DGX Spark, frente a 0,430 de Qwen3.6-35B-A3B.
El laboratorio también lo utiliza como objeto de investigación sobre la supervisión de la cadena de pensamiento (chain of thought): un modelo con bucles realiza más cálculos sin plasmarlos por escrito, lo que podría escapar a un monitor. En una variante con un número variable de pasadas, también publicada, la tarea resuelta sin razonamiento escrito pasa de equivaler a 16 segundos de trabajo humano a 37 al pasar de una a tres pasadas. Con cinco pasadas, el razonamiento tiene la mitad de longitud (1 661 frente a 3 703 tokens de media en GPQA Diamond) y sigue siendo igual de legible; Thinking Machines no observa un aumento del sabotaje agéntico con el número de bucles. El modelo está disponible en Tinker, Ollama, SGLang, vLLM, llama.cpp, MLX y Transformers, con versiones GGUF en Unsloth.
🔗 Inkling 2 Mini (Thinking Machines) · Publicación de Hugging Face · Pesos en Hugging Face
Together AI ofrece Tencent Hy4, una mezcla de expertos de 770 mil millones de parámetros, a 0,83 dólares por millón de tokens de entrada
19 de noviembre — Together AI añade Tencent Hy4 a su oferta de inferencia sin servidor, con un contexto de un millón de tokens, llamadas a herramientas y salida JSON. Según el proveedor de alojamiento, el modelo insignia de Tencent es una mezcla de expertos de 770 mil millones de parámetros, de los que 49 mil millones están activos por token; sucede a Hy4 Preview, añade el uso del ordenador y se convierte en el primero de la familia Hy capaz de leer imágenes.
| Tarifa por millón de tokens | Together AI | Tencent (comunicado del 4 de noviembre) |
|---|---|---|
| Entrada | 0,83 dólares | unos 0,90 dólares |
| Entrada en caché | 0,042 dólares | unos 0,045 dólares |
| Salida | 2,50 dólares | unos 2,70 dólares |
Tencent había lanzado Hy4 el 4 de noviembre, presentándolo como uno de los mejores modelos open source y prometiendo publicar los pesos en unos días; el repositorio tencent/Hy4 está en Hugging Face, bajo una licencia de tipo «other». Su comunicado citaba una evaluación financiera a ciegas (213 profesionales, 579 tareas) en la que Hy4 obtenía 3,04, por delante de DeepSeek-V4.1-Flash-1017 (2,97), y una tasa interna de alucinaciones reducida del 12,95 % al 7,2 %.
🔗 Tencent Hy4 en Together AI · Comunicado de Tencent del 4 de noviembre
Hugging Face publica la receta de sus harness adapters y un superadaptador único para Qwen3.8-27B
20 de noviembre — Tras tres días de publicaciones, entre ellas el adaptador Hermes del que hablamos aquí ayer, Hugging Face presenta la receta completa de sus harness adapters: LoRA entrenados mediante aprendizaje por refuerzo dentro de un arnés de agente (pi, Hermes Agent u OpenCode), sobre Qwen3.8-27B. La novedad es un superadaptador: los tres LoRA de rango 32 se concatenan en un único LoRA de rango 96, que funciona en los tres arneses. Como sus actualizaciones son casi ortogonales (coseno de 0,01 a 0,02), el ensamblaje aplica exactamente las tres.
| SWE-bench Pro (51 tareas difíciles), con reflexión | Modelo base | Con el superadaptador |
|---|---|---|
| Arnés Hermes Agent | 45 % | 61 % |
| Arnés OpenCode | 47 % | 67 % |
| Arnés pi | 74 % | 74 % |
Con reflexión, la media de las seis parejas de arnés y prueba pasa del 55,5 al 63,5 %, con entre un 19 y un 48 % menos de llamadas a herramientas, según el hilo del equipo; sin reflexión, el superadaptador gana entre 6 y 18 puntos en SWE-bench Pro, con entre un 53 y un 73 % menos de llamadas a herramientas, según la publicación. Las puntuaciones no son comparables entre arneses, ya que sus configuraciones predeterminadas difieren. El entrenamiento requirió 598 pasos y 167 millones de tokens; la protección safeagents comprobó 1,3 millones de llamadas a herramientas y bloqueó 647. Se han publicado las tareas, los adaptadores, los GGUF y las trayectorias de evaluación.
🔗 Harness adapters a escala (Hugging Face) · @yb2698 en X
Metric AI publica Ayb 0.5, OhanTTS y OhanASR, modelos abiertos de texto y voz para el armenio
20 de noviembre — El equipo armenio Metric AI publica el mismo día tres familias de modelos para su lengua. Ayb 0.5 reúne tres modelos de lenguaje (0,8B, 4B y 9B) construidos sobre Qwen3.5 y adaptados al armenio, desde la ampliación del tokenizer hasta el posentrenamiento; Ayb-9B gestiona el diálogo de varios turnos, las llamadas a herramientas y las imágenes. OhanTTS-v0.1 sintetiza voz en ocho idiomas, entre ellos el armenio y el francés, y clona una voz a partir de entre 3 y 10 segundos de audio. OhanASR-v0.1, un modelo de reconocimiento de voz de 2B, está ajustado con 820 horas de armenio.
| Modelo de Metric AI | Resultado publicado por los autores |
|---|---|
| Ayb-9B | 3.º en la clasificación general de ArmBench (0,6164) |
| OhanTTS-v0.1, 61 horas de armenio | 14,70 % de WER, primer sonido en 331 ms en una GB10 |
| OhanASR-v0.1 | 16,12 % de WER (2.º) y 3,49 % de CER (1.º) en ArmBench-ASR |
Los pesos de Ayb-9B están bajo una licencia no comercial (CC BY-NC 4.0) y son accesibles tras una validación manual.
🔗 Ayb 0.5 (Metric AI) · OhanTTS · OhanASR
Apple publica Depth Pro 2, que estima la profundidad en metros en fotos y vídeos
19 de noviembre — Apple publica Depth Pro 2, una familia de modelos que estiman la profundidad en metros, tanto en fotos como en vídeos, con resolución nativa. Según el resumen del artículo, los métodos existentes debían elegir entre la coherencia de una imagen a otra y la nitidez de los contornos; Depth Pro 2 busca ambas con una sola red. Los pesos están en Hugging Face en cuatro tamaños (S, B, L, H), con una versión Core ML y un estimador de distancia focal común, útil cuando falta la distancia focal en los datos EXIF.
| Resolución procesada por DepthPro2-L (334M, en B200) | Imágenes por segundo |
|---|---|
| VGA | 150,1 |
| 720p | 33,7 |
| 1080p | 9,1 |
| 4K | 0,7 |
Los pesos están reservados para investigación no comercial (licencia Apple Machine Learning Research Model), y el código está en GitHub. Pedro Cuenca, de Hugging Face, dio a conocer el lanzamiento el 20 de noviembre, con una demostración en línea.
🔗 @pcuenq en X · Artículo arXiv 2611.26603 · DepthPro2-L (Hugging Face)
Seguridad de los modelos: OpenAI contra la destilación adversaria, Sakana AI crea su Security Research Group
OpenAI detalla su lucha contra la destilación adversaria y reduce del 54,0 % al 0,2 % la extracción del razonamiento protegido
20 de noviembre — OpenAI publica una entrada sobre la destilación adversaria (adversarial distillation): el uso no autorizado de las respuestas de un modelo de vanguardia para entrenar otro, desplegado sin las mismas salvaguardas, por ejemplo para ataques que el modelo original habría rechazado. La entrada se centra ante todo en el razonamiento protegido, la cadena de pensamiento producida antes de la respuesta: según un estudio interno, un modelo alumno suele mejorar más con las trazas exactas de razonamiento que con sus resúmenes.
| Ataque medido (evaluación adaptativa, seis modelos atacantes) | GPT-6 Astra, salvaguardas originales | GPT-6.2 Astra, salvaguardas actualizadas |
|---|---|---|
| Razonamiento de una consulta anterior | 54,0 % | 0,2 % |
| Razonamiento de la consulta actual | 22,9 % | 0,9 % |
La defensa combina entrenamiento adversario, clasificadores de entrada y salida (incluidos los argumentos de las llamadas a herramientas), controles de la API e investigaciones, con sanciones semanales contra campañas que abarcan desde unos pocos miles hasta varias decenas de miles de cuentas. Con GPT-6.2 Astra y Sol, el razonamiento protegido queda vinculado al historial que lo produjo: la API lo descarta si se reescribe un mensaje anterior, y las familias de modelos más antiguas ya no pueden leerlo. OpenAI recuerda que en febrero informó al Congreso de una actividad que indicaba que DeepSeek intentaba destilar modelos estadounidenses, y que en septiembre atribuyó una campaña a personas asociadas con Moonshot AI; afirma que apoya la Chip Security Act, la AI OVERWATCH Act y la MATCH Act.
🔗 Lucha contra la destilación adversaria (OpenAI) · @OpenAI en X
Sakana AI crea su Security Research Group, un equipo independiente para la ciberdefensa colectiva
20 de noviembre — Sakana AI lanza su Security Research Group, un equipo de R&D independiente con sede en Tokio, separado de su actividad comercial y orientado al interés público.
Excited to announce the Sakana AI Security Research Group, an independent, public-interest R&D team in Tokyo co-led by Akihiro Umegai and me.
🇪🇸 Me complace anunciar el Sakana AI Security Research Group, un equipo de R&D independiente y de interés público, en Tokio, codirigido por Akihiro Umegai y por mí. — @hardmaru en X
David Ha es cofundador y director general de Sakana AI. El equipo trabajará en tres ejes: la prevención desde el diseño, la defensa colectiva mediante agentes distribuidos entre organizaciones y la protección de los propios agentes defensores, cuya autoridad estará limitada a su tarea y cuyas acciones quedarán registradas. Parte de trabajos propios como Digital Red Queen, ShinkaEvolve y Fugu-Cyber, para el que Sakana AI anuncia un 86,9 % en CyberGym y un 72,1 % en CTI-REALM; una nota de la entrada precisa que la página de Fugu-Cyber no ofrece ni puntuaciones de referencia ni un protocolo de evaluación. Publicará libros blancos, bancos de pruebas y guías defensivas, pero no material de explotación, y las vulnerabilidades encontradas se comunicarán mediante divulgación coordinada. Sakana AI recuerda que las solicitudes de CVE aumentaron un 263 % entre 2020 y 2025, según el NIST.
🔗 Security Research Group (Sakana AI)
Agentes conectados a la entrega de software: la fábrica de Runway, Stitch Loop de Google Labs
Runway confía su cadena de entrega de software a agentes, que dirigieron el 38 % de sus fusiones de octubre
20 de noviembre — Runway publica en su blog de ingeniería el balance con cifras de su «fábrica de software» (software factory): siete etapas, desde la escritura del código hasta la coordinación de las fusiones, confiadas una a una a agentes. Los agentes cloud dirigieron el 38 % de las pull requests fusionadas en octubre, y de 100 de estas PR fusionadas en la primera mitad de noviembre, 78 no contenían ningún commit humano.
| Indicador de la fábrica de software | Punto de partida | Última medición |
|---|---|---|
| Fusiones dirigidas por agentes cloud | 0,1 % (junio) | 38 % (octubre) |
| Espera mediana para una primera aprobación | 2,3 h (septiembre) | unos 5 min (mediados de noviembre) |
| Promedio de fusiones semanales | 929 (septiembre) | 2 235 (desde mediados de octubre) |
Desde mediados de octubre, la IA aprueba por sí sola las PR clasificadas como de riesgo bajo, y las de riesgo medio si el repositorio lo permite; las de riesgo alto corresponden a una persona, y los responsables del código siempre dan su aprobación a las migraciones, la configuración de CI y despliegue, los secretos y la autenticación. En septiembre y octubre, una persona cuestionó 15 de las 977 PR aprobadas por la IA, y las fusiones aprobadas únicamente por la IA tienen una tasa de reversión del 0,10 %, frente a aproximadamente 1 de cada 200 en las aprobaciones humanas. Otros agentes también prueban App Studio como un usuario (86 errores confirmados en cuatro días), y un coordinador distribuyó más de 14 000 tareas en dos semanas. Se trata de herramientas internas, sin producto ni tarifa.
🔗 Construir una fábrica de software (Runway)
Google Labs lanza Stitch Loop, un agente de producto que mejora continuamente una aplicación en línea
18 de noviembre — Google Labs presenta Stitch Loop, un agente de producto de larga duración que retoma el trabajo donde lo deja un agente de código: después de la puesta en producción. Se conecta al repositorio de GitHub y a los datos del producto en línea (registros, comportamiento de los usuarios, comentarios) mediante más de 180 integraciones, servidores MCP personalizados o envíos desde una CLI local, y trabaja de forma continua para alcanzar objetivos medibles.
Cada ciclo propone vías de mejora respaldadas por los datos, detalla las soluciones y sus ventajas e inconvenientes, escribe el código en un sandbox cloud aislado y abre una pull request para su aprobación; después observa las métricas en tiempo real. Se incluyen tres ciclos de serie (ciberseguridad, latencia, accesibilidad); el de seguridad combina Gemini 4 Carbon con CodeMender, el agente de seguridad del código de Google DeepMind. No se fusiona nada sin la revisión del equipo. Stitch Loop también sirve como fuente de contexto del producto para agentes de código como Google Antigravity, a través de la CLI Stitch y MCP, y se utiliza en Slack. Solo se ha abierto una lista de espera, disponible en todo el mundo, con acceso prioritario para los suscriptores de Google AI Ultra que cumplan los requisitos.
Asistentes para el público general: ChatGPT Space para los suscriptores Plus, GIF en la aplicación Gemini, Perplexity Computer en los navegadores Chromium
ChatGPT Space se abre a los suscriptores Plus de todo el mundo
20 de noviembre — ChatGPT Space, presentado en el DevDay del 29 de septiembre y hasta ahora reservado a los planes Pro, Business y Enterprise, se está desplegando en todo el mundo para los suscriptores Plus de 18 años o más. Space sustituye a la Biblioteca en la barra lateral (páginas, diapositivas, imágenes, archivos subidos), en la web, la aplicación de escritorio, iOS y Android.
Permite crear con ChatGPT páginas interactivas y presentaciones que otras personas con acceso a Space pueden enriquecer. Las páginas y diapositivas pueden actualizarse por sí solas a partir de las aplicaciones conectadas: OpenAI cita una lista de tareas que se actualiza sola o un plan de proyecto que sigue las decisiones tomadas en Slack. Basta con mencionar a ChatGPT en un comentario para solicitar una modificación, y se puede invitar a un dot a colaborar. El uso compartido sigue siendo restringido: hace falta un permiso de lectura y una cuenta Plus, Pro, Business o Enterprise con acceso a Space; las cuentas Free no pueden abrir los contenidos compartidos, y no existe ningún enlace público.
🔗 Notas de la versión de ChatGPT
La aplicación Gemini crea GIF animados con Gemini Omni 1.2 Flash, gratis en Francia
20 de noviembre — La aplicación Gemini ya crea GIF animados (efectos fotográficos en bucle, memes) con Gemini Omni 1.2 Flash, el modelo de vídeo lanzado por Google el 5 de noviembre, para ofrecer un movimiento fluido y una calidad constante entre fotogramas, según Google. Se escribe la solicitud en el chat principal, o se abre la herramienta de imagen o vídeo, y después se elige el formato GIF en el selector de formato.
GIFs are now available to all Google AI subscribers and free of charge in the U.S., Japan, Korea, Australia, Canada, U.K., Germany, and France.
🇪🇸 Los GIF ya están disponibles para todos los suscriptores de Google AI, y de forma gratuita en Estados Unidos, Japón, Corea, Australia, Canadá, Reino Unido, Alemania y Francia. — @GeminiApp en X
Por tanto, los usuarios franceses sin suscripción tienen acceso. Google sigue los pasos de OpenAI, cuyos GIF animados en ChatGPT con Images 2.6 se trataron aquí el 5 de noviembre.
🔗 @GeminiApp en X: los GIF en Gemini
Perplexity Computer funciona directamente en los navegadores Chromium gracias a la extensión Perplexity
20 de noviembre — Perplexity Computer ya funciona directamente en los navegadores basados en Chromium gracias a la extensión Perplexity. Se le encarga una tarea desde el panel lateral de la extensión y después se sigue a Computer mientras trabaja en las pestañas y herramientas del usuario. El tweet del anuncio no precisa los planes incluidos ni la lista de navegadores compatibles.
Dos precedentes: el 5 de octubre, la aplicación Mac 26.38.0 permitía a Computer utilizar Chrome, Edge o Brave mediante una extensión, y el 30 de octubre, una extensión de Chrome conectaba las aplicaciones Mac y Windows de Computer con el navegador del usuario. Esta vez, la tarea se encarga desde el panel lateral de la extensión, dentro del navegador.
API y SDK para desarrolladores: Codex en el Agents SDK Python, Decider en la Context API de Perplexity
El Agents SDK Python de OpenAI publica una versión preliminar 1.0 que convierte a Codex en un proveedor de modelos
20 de noviembre — El Agents SDK Python de OpenAI inicia su serie 1.0 con una versión preliminar que cambia de enfoque: en lugar de un motor nativo separado, como en la versión preliminar 0.24 tratada aquí el 16 de noviembre, Codex se convierte en un proveedor de modelos que se elige en cada ejecución. Se crea un CodexProvider y se pasa al Runner mediante RunConfig(model_provider=provider); el agente se ejecuta entonces con la conexión de Codex guardada, o con una clave de API.
El paquete wheel de Python incorpora Codex Core (rust-v0.166.0, sin modificar) mediante PyO3: el SDK llama directamente al núcleo de Codex, sin ejecutar codex app-server ni pasar por JSON-RPC. Las herramientas de Python, las transferencias a un agente especialista (handoffs), la aprobación antes de ejecutar una herramienta y la salida tipada siguen disponibles, y los comandos nativos siguen el sandbox y las reglas de aprobación de Codex. Los paquetes wheel 1.0.0a1 se distribuyen únicamente mediante GitHub Releases (Linux x86-64 y ARM64, macOS 11 y posteriores en Apple silicon, Windows x64, CPython de 3.10 a 3.14). Las copias de seguridad de la versión preliminar 0.24.0-alpha.8 no son compatibles con el Runner, y la versión estable sigue siendo la 0.25.0 del 18 de noviembre.
🔗 openai-agents-python v1.0.0-alpha.1
Perplexity añade Decider a la Context API para puntuar las páginas, incluidas las inyecciones de prompt
19 de noviembre — Perplexity añade Decider, su modelo de decisión, a la Context API lanzada dos días antes (1 dólar por 1 000 URL). Se pueden plantear hasta cinco preguntas cerradas (sí o no) sobre cada página recuperada, y Decider puntúa cada respuesta de 0 a 1. El uso destacado está relacionado con la seguridad: detectar una inyección de prompt (prompt injection) en una página antes de que un agente la lea. Perplexity también cita la cualificación de clientes potenciales, la moderación y la detección de afirmaciones sobre salud sin fuente.
La API no filtra nada por sí misma: devuelve todas las páginas con sus puntuaciones, y es el código de la aplicación el que aplica un umbral. El cálculo de la puntuación se factura en tokens de entrada de la Decisions API, además del precio por URL, y puede prolongar la solicitud hasta 15 segundos. El cookbook de la documentación muestra un control ejecutado el 18 de noviembre con un umbral de 0,7:
| Página probada (cookbook del 18 de noviembre) | Puntuación de inyección | Decisión del control |
|---|---|---|
| Demostración de inyección (Greshake et al., 2023) | 0,97 | puesta en cuarentena |
| OWASP, página sobre la inyección de prompt | 0,0018 | transmitida |
| RFC 9111 | 0,0007 | transmitida |
El cookbook advierte de que una puntuación baja no convierte una página en segura: según la investigación BrowseSafe++ de Perplexity, todos los modelos probados seguían obedeciendo algunas inyecciones que ellos mismos habían señalado.
🔗 Hilo de @perplexitydevs · Documentación · Cookbook
Agentes de código: Claude Code 2.1.329, Codex CLI 0.171.0, Vibe CLI 3.1.4 y Gemini 4 Neon en Devin
Claude Code 2.1.329 indica el origen de los hooks al abrir una carpeta y agrupa las tareas programadas en /tasks
19 de noviembre — Claude Code 2.1.329 cuenta con 130 entradas, entre ellas 91 correcciones, 20 cambios y 7 incorporaciones. En materia de seguridad, el cuadro de diálogo que pregunta si se confía en una carpeta indica ahora dónde están declarados sus hooks, y tanto Claude Desktop como los demás hosts no interactivos avisan cuando no se cargan los hooks impuestos por la configuración administrada (managed settings). /tasks también enumera las tareas programadas de la sesión, las activaciones de /loop, el objetivo en curso y los forks de la conversación; la mayoría de las tareas programadas registradas por las versiones anteriores tendrán que volver a programarse.
/code-review sin especificar un objetivo revisa ahora, en la mayoría de los modelos, toda la rama respecto a la rama predeterminada, y con un número de PR lee la propia PR mediante gh pr diff. En macOS, computer use adopta reglas de seguridad más recientes que rechazan determinadas acciones. Desaparece el reintento automático añadido en la versión 2.1.326 tras un error max_tokens: detrás de una pasarela, hay que configurar CLAUDE_CODE_MAX_OUTPUT_TOKENS. Code Mode recibe 17 entradas, entre ellas la compatibilidad con los eventos y las métricas de OpenTelemetry. La versión 2.1.330 está publicada en npm desde el 20 de noviembre.
Codex CLI 0.171.0 establece GPT-6.2 Sol como predeterminado y activa el espacio de trabajo del terminal
20 de noviembre — Codex CLI 0.171.0 es la primera versión estable desde la 0.170.0 del 18 de noviembre y reúne 339 pull requests. GPT-6.2 Sol y GPT-6.2 Astra se incorporan a los catálogos de modelos, con Sol seleccionado de forma predeterminada, y los comandos /rc y /remote gestionan desde el terminal el control remoto local y muestran los códigos de emparejamiento de los dispositivos.
Varias novedades de las versiones preliminares del 14 al 17 de noviembre pasan a la versión estable: el espacio de trabajo de la TUI, activado de forma predeterminada, muestra vistas previas de documentos e imágenes y transcripciones de los subagentes junto a la conversación; codex exec --remote inicia o reanuda una sesión no interactiva en un servidor de aplicaciones existente; el compositor incorpora deshacer y rehacer; /statusline permite elegir líneas de estado proporcionadas por un servidor MCP, previa activación de una opción. Entre las correcciones, los borradores y los reintentos en cola siguen vinculados a su conversación, y la conexión MCP empresarial funciona con los proveedores de identidad que no emiten un token de actualización.
Vibe CLI 3.1.4 separa el agente de la política de aprobación y retira a los agentes el derecho a desactivar las confirmaciones
20 de noviembre — Mistral publica Vibe CLI 3.1.4, dos días después de la 3.1.3, que establecía Mistral Large 4 como modelo predeterminado. Sus 79 entradas (18 incorporaciones, 41 cambios, 18 correcciones, 2 eliminaciones) afectan principalmente a los permisos: cada sesión combina ahora dos ajustes independientes, un agente (default, lean o uno personalizado) y una política de aprobación (ask, accept-edits, smart-approve o auto-approve), elegida mediante --approval-policy o default_approval_policy.
Un agente ya no decide por sí solo qué se ejecuta sin preguntar: se ignoran sus ajustes safety, bypass_tool_permissions y permission = "always". Un proyecto ya no puede redefinir una política de aprobación en su carpeta .vibe/agents/, y tanto los forks como las sesiones hijas heredan la política original. La interfaz incorpora una «barra» de chips encima del campo de entrada (subagentes, tareas en segundo plano, pull requests, objetivo, tareas), un ajuste keep_awake impide la suspensión durante un turno, y Vibe acepta los certificados del sistema, lo que le ayuda a funcionar detrás de un proxy empresarial. Ahora solo se envían las 8 imágenes más recientes a los modelos Mistral, y se eliminan los prompts de compactación personalizados.
Devin incorpora Gemini 4 Neon, con un 46,2 % en FrontierCode 2.0 por 4,38 dólares por tarea
19 de noviembre (entrada fechada el 18) — Tras Cursor y GitHub Copilot, tratados aquí ayer, Cognition incorpora Gemini 4 Neon a Devin Desktop y Devin CLI. En FrontierCode 2.0, su benchmark que evalúa si una pull request merece fusionarse, Neon obtiene un 46,2 %, el mejor resultado de un modelo de Google según Cognition. Se sitúa a aproximadamente un punto de Claude Opus 5.5 (47,3 %) por cerca de un tercio del coste: 4,38 dólares por tarea frente a 12,82 dólares.
| Modelo evaluado en FrontierCode 2.0 | Puntuación publicada por Cognition |
|---|---|
| Claude Fable 5.2 | 50,2 % |
| Claude Opus 5.5 | 47,3 % |
| Gemini 4 Neon | 46,2 % |
| GPT-6.2 Astra | 44,2 % |
| GPT-6.2 Sol | 43,8 % |
| Gemini 4 Carbon | 42,6 % |
El coste corresponde al gasto medio por ejecución según la tarifa de catálogo de la API, con los descuentos públicos incluidos, y una solución que incumple un criterio excluyente recibe una puntuación de cero. Varias puntuaciones de este gráfico difieren de los valores publicados en semanas anteriores, sin explicación en la entrada.
🔗 Gemini 4 Neon en Devin (Cognition) · @cognition en X
Ciencia: OpenAI publica MedChemBench, un benchmark de química medicinal en el que GPT-6.2 Astra obtiene un 84,5 %
20 de noviembre — OpenAI presenta MedChemBench, un benchmark que mide la capacidad de los modelos para razonar como un químico medicinal: relacionar la estructura de una molécula con los resultados experimentales, comparar compuestos y predecir sus propiedades. Reúne 99 problemas extraídos de 117 artículos y patentes, con 761 estructuras moleculares distintas, y puntúa cuatro componentes: estructuras, razonamiento científico, selección de compuestos y predicción de propiedades.
| Modelo evaluado (nivel de razonamiento xhigh) | Crédito obtenido |
|---|---|
| GPT-6.2 Astra | 84,5 % |
| GPT-6 Astra | 83,3 % |
| GPT-6.1 Sol | 82,0 % |
| GPT-6.1 Terra | 75,1 % |
| GPT-5.6 Sol | 58,2 % |
El perfil es desigual: GPT-6 Astra obtiene el 95,4 % del crédito en estructuras, pero aproximadamente la mitad en selección de compuestos y predicción de valores numéricos. OpenAI mantiene la cautela: el benchmark se basa en datos históricos y no demuestra que los modelos puedan descubrir nuevos medicamentos, no puede descartarse una exposición previa a las publicaciones de origen, y solo se han evaluado modelos GPT. Llega después de BioBasicsBench, tratado aquí el 6 de noviembre.
🔗 Presentación de MedChemBench (OpenAI) · Artículo completo (PDF)
Vídeo y audio generativos: ElevenLabs añade a Ads Engine variantes de anuncios sin un nuevo rodaje
20 de noviembre — ElevenLabs amplía Ads Engine, su herramienta de creación publicitaria integrada en ElevenCreative y lanzada en junio. Conectada a las cuentas publicitarias de Google, Meta, LinkedIn y ahora TikTok, parte de los anuncios existentes y de sus resultados para producir variantes sin un nuevo rodaje. Identifica el gancho inicial (hook) y escribe otros nuevos a partir de los anuncios que han funcionado; los pronuncia una réplica digital de la voz del hablante original, con sincronización labial y subtítulos actualizados. Las nuevas bandas sonoras, compuestas por la API ElevenLabs Music a partir del tono y el ritmo de las imágenes, pueden utilizarse comercialmente.
Para la localización, que ya ofrecía Dubbing v2, Ads Engine ajusta ahora los labios del hablante al idioma de destino y sustituye los subtítulos incrustados por una versión traducida, con el minutaje y las fuentes de la marca. Sigue siendo posible una revisión humana antes de la difusión, incluso por parte de un profesional nativo de la localización, y la herramienta puede publicar directamente en las plataformas. El acceso se gestiona a través del equipo comercial, sin una tarifa publicada.
🔗 Variantes y localización de anuncios de vídeo en Ads Engine (ElevenLabs)
Breves
Agentes de código
- Copilot CLI 1.0.115-2 — En esta versión preliminar de 351 entradas, de las cuales 335 son correcciones, Gemini 4 Hydrogen se incorpora al selector con el esfuerzo Extra High cuando la cuenta tiene acceso, se añade compatibilidad con GPT-6.2 Astra, y
/modeltambién gestiona los modelos de proveedores personalizados; la versión estable sigue siendo la 1.0.114. 🔗 fuente - Codex CLI 0.173.0-alpha.1 y alpha.2 — Las notas de estas versiones preliminares están vacías; según los títulos de los 71 commits, el uso compartido de conexiones MCP y el descubrimiento OAuth de los servidores configurados pasan a estar activados de forma predeterminada, y los administradores podrán desactivar las actualizaciones del demonio Codex. El contenido puede cambiar antes de la versión estable. 🔗 fuente
- Gemini CLI — Primera nightly desde el 4 de noviembre (v0.71.0-nightly.20261120); en la rama principal,
gemini --resumevuelve a abrir la sesión utilizada más recientemente y no la última iniciada, y las rutas que empiezan por~\por fin se expanden en Windows. 🔗 fuente - Antigravity IDE 2.8.0 — El editor de Google inicia su backend al instante y comprueba sus actualizaciones en segundo plano, redirige automáticamente los puertos para la conexión remota, permite buscar en una conversación con el teclado y acepta certificados personalizados y proxy al conectarse. 🔗 fuente
- Qwen Code 0.28.1-preview.1 — Esta versión preliminar de 179 entradas convierte a GitHub en el tercer adaptador de canal compatible, añade WeCom, Microsoft Teams y webhooks salientes genéricos configurables desde la interfaz web, e incorpora al CLI una presentación para lectores de pantalla; la versión estable sigue siendo la v0.28.0. 🔗 fuente
- Kimi Code 2.7.1 y 2.7.2, Kimi Code Desktop 1.4.1 y 1.4.2 — Cuatro versiones correctivas al día siguiente de la 2.7.0: el esfuerzo de reflexión elegido en un borrador ya no vuelve al valor predeterminado tras el envío, y los forks ya no fallan después de restaurar una sesión redirigida durante un turno. 🔗 fuente
- CLI mistral 0.20.1 —
mistral evals execahora termina con un fallo (código 1) cuando todas las llamadas de una ejecución han fallado, por ejemplo, por un error 401, en lugar de declararla exitosa; una interrupción mediante Ctrl-C se indica como tal. 🔗 fuente - Replit — Los espacios de trabajo (Workspaces) ahora se pueden buscar y fijar, una opción que solo aparece a partir de cinco espacios. 🔗 fuente
- Devin Bot para Manim — Cognition muestra el Devin Bot que Grant Sanderson ha configurado para ayudarle con Manim, el sistema de animación open source de los vídeos de 3Blue1Brown (96,6 k estrellas, 250 000 descargas al mes); el tuit no especifica ni las tareas asignadas al bot ni sus resultados. 🔗 fuente
API y plataformas
- API Gemini — Desde el 17 de noviembre, Gemini 3.5 Transcribe, tanto en su versión clásica como en directo, modifica, reescribe y da formato mediante la voz a un dictado o a un texto existente (parámetro
source_text), y Google también menciona la traducción. Desde el 18, la API permite procesar, y pagar, solo la parte útil de los archivos enviados: rangos de páginas, pestañas, celdas, intervalos de tiempo o capas de contenido. 🔗 fuente - Conciencia del tiempo en la API Agents — Una opción experimental (
experimental={"time_awareness": True}) recuerda periódicamente la hora al modelo para que adapte su trabajo a un plazo; combinada con las herramientas asíncronas, permite a un agente plantear una pregunta y seguir investigando mientras espera la respuesta, como muestra una entrada del blog de desarrolladores de OpenAI. 🔗 fuente - Historial de conversaciones con GPT-6.2 — @OpenAIDevs pide que se dejen de modificar los mensajes anteriores en la Responses API, porque la API descarta el razonamiento posterior a la modificación. Una nueva sección Reasoning removals del panel Usage ayuda a detectarlo, y la guía asociada propone añadir en su lugar un elemento
configuration_updateoadditional_toolspara cambiar el esfuerzo o las herramientas. 🔗 fuente
Asistentes para el público general
- ChatGPT despliega una nueva aplicación móvil con una pestaña para el dot y favoritos fijados — Codex, Projects o Images se pueden fijar en la barra de pestañas; el despliegue comienza por los usuarios Pro de 18 años o más en los lugares donde hay dots, excepto el Espacio Económico Europeo (incluida la UE), Reino Unido, Suiza y Corea, y por un pequeño grupo de usuarios Plus (notas de la versión del 19 de noviembre, enlazadas más arriba).
- Teammates de Perplexity — Los suscriptores Max ya pueden crear un teammate desde cualquier tarea de Computer en la web y después cambiar su nombre, su función o su avatar en la misma conversación. 🔗 fuente
- Aplicación Mac de Perplexity — Más rápida, añade «Enviar ahora» para redirigir una tarea en curso, ⌘F para buscar en tablas, Markdown y vistas previas, y ⌘⇧T para volver a abrir una pestaña cerrada. 🔗 fuente
Vídeo y audio generativos
- Seedance 2.5 Flash en Pika — Tras Runway y HeyGen, Pika añade la variante rápida del modelo de vídeo de ByteDance para trabajos con numerosas tomas: vídeos de hasta 30 segundos en 480p o 720p, hasta 10 imágenes, 5 vídeos y 5 clips de audio como referencia; el tuit no indica ninguna tarifa. 🔗 fuente
- Avatar 6 de HeyGen — Nuevas pruebas a ciegas extraídas del informe técnico: cuando las personas filmadas, empleados de HeyGen, eligen el vídeo que más se les parece, Avatar 6 gana en el 86,5 % de los casos frente a Seedance 2.5 y en el 87,9 % frente a Wan 3.0; estas evaluaciones las realiza HeyGen. 🔗 fuente
- Qwen3 TTS en Together AI — La síntesis de voz abierta Qwen3-TTS-12Hz-1.7B (Apache 2.0) se ofrece a 20 dólares por millón de caracteres, con nueve voces ajustables mediante una instrucción en lenguaje cotidiano, diez idiomas, incluido el francés, y un primer sonido en 97 ms en el mejor de los casos. 🔗 fuente
Infraestructura e investigación
- Together Storage Accelerator — Together AI ofrece con cada clúster de GPU una caché NVMe para el almacenamiento S3 y el Hub de Hugging Face, sin cambios de código; según sus mediciones, un archivo de 2 Gio leído desde Cloudflare R2 pasa de entre 12,7 y 15,0 s a entre 0,64 y 0,72 s, y un clúster de 200 nodos solo descarga una vez desde el origen. 🔗 fuente
- CDN de Hugging Face — Hugging Face sirve cerca de un exabyte de modelos y conjuntos de datos abiertos al mes, según su cofundador Julien Chaumond, y ha construido su propia red de distribución (CDN) para las descargas de IA. 🔗 fuente
- Superfluid de basecompute — El servidor local distribuye ahora la inferencia entre máquinas Apple, AMD y NVIDIA: seis máquinas elevan el rendimiento de 112 a 534 tokens de salida por segundo para 64 usuarios simulados, y la detención de un nodo no provoca la pérdida de ninguna solicitud, según el desarrollador. 🔗 fuente
- WavLate — Este modelo abierto de interacción tardía busca sonidos mediante texto y texto mediante sonido, con un vector cada 0,31 segundos de sonido y uno por palabra; su autor anuncia un Recall@1 medio de 37,9 en AudioCaps y Clotho, el mejor de los nueve modelos abiertos comparados, y publica los pesos y los datos. 🔗 fuente
- WorldTrace — NVIDIA Research presenta una memoria para los modelos de mundo de vídeo interactivos, sin reentrenamiento (artículo aceptado en NeurIPS 2026): en LoopBench, la recuperación de escenas revisitadas mejora un 32,6 % frente a la ventana deslizante, con 3,1 Go de memoria GPU y un 27 % más de tiempo de ejecución. 🔗 fuente
- Dynamo para el aprendizaje por refuerzo — NVIDIA detalla cómo Dynamo sirve los rollouts del posentrenamiento: enrutamiento según la caché KV, transferencia diferencial de los pesos con ModelExpress y recuperación de los procesos de trabajo que fallan. Microsoft AI, Cognition (para SWE-1.7), Prime Intellect y H Company lo utilizan; H Company ahorra hasta un 20 % de tiempo por paso de entrenamiento. 🔗 fuente
- Atención dispersa — En una guía del 17 de noviembre, NVIDIA ofrece ocho reglas de diseño para la atención dispersa entrenada en sus GPU; el indexador que elige los tokens y el Top-k representan el 47 % de una capa de prefill de DeepSeek V3.2 a 128K tokens. 🔗 fuente
GitHub
- GitHub Enterprise Server 3.23 en release candidate — La detección de secretos mediante IA, en versión preliminar pública, se ejecuta en el procesador del appliance, sin GPU, sin LLM alojado ni conexión saliente, incluso en entornos aislados (air-gapped); la versión también amplía la detección de paquetes maliciosos conocidos a siete ecosistemas adicionales a npm. 🔗 fuente
- Al margen de la IA — GitHub aclara el estado de fusión en la nueva página Overview de las pull requests, GitHub Desktop 3.7.0 admite varias cuentas en un mismo host, y el panel muestra hasta 25 repositorios favoritos. 🔗 Overview · 🔗 Desktop · 🔗 favoritos
Empresa y ensayos
- Hebbia — En sus pruebas de investigación financiera de agosto y septiembre, una versión preliminar de GPT-6 Astra cita un 99,5 % de fragmentos pertinentes y cumple el 97,9 % de los requisitos de presentación, 14,4 puntos por delante de la mejor alternativa probada, que el estudio de caso publicado por OpenAI no identifica. 🔗 fuente
- El consenso silencioso — OpenAI publica en su sección La era de la inteligencia (Intelligence Age) un ensayo de Dean Ball, adaptado de una conferencia en Harvard y presentado como un reflejo de las opiniones del autor, contra la idea de que el abandono de la primacía humana sería inevitable; defiende agentes vinculados a personas, con permisos limitados y revocables. 🔗 fuente
- Enriquecimiento de datos — Una guía de Perplexity describe cómo completar y verificar fichas CRM con un modelo conectado a la web, en seis pasos; Apollo realiza 5,6 millones de enriquecimientos al mes a través de la API de Perplexity. 🔗 fuente
Qué significa
La salida a bolsa de Anthropic reúne, en una misma publicación, el capital de los mercados y el de la industria. La oferta pública aporta unos 91,6 mil millones de dólares brutos a la empresa, y la colocación privada otros 26 mil millones, suscritos al mismo precio de 83 dólares por siete grupos de los sectores de los semiconductores y la informática: AMD, Broadcom, Google, Micron, Microsoft, NVIDIA y TSMC Partners. En total, la operación se acerca a los 119,5 mil millones de dólares brutos: junto a los inversores de la oferta, siete grupos de la industria compran acciones de un laboratorio de IA que ahora cotiza en el Nasdaq.
La seguridad se gestiona cada vez más desde el propio funcionamiento de las herramientas. OpenAI vincula el razonamiento de GPT-6.2 al historial que lo generó, lo que reduce la extracción medida del 54,0 % al 0,2 %, pero obliga a los desarrolladores a dejar de reescribir sus conversaciones. Vibe CLI retira a los agentes el derecho a omitir por sí mismos las confirmaciones, Claude Code muestra de dónde proceden los hooks de una carpeta antes de confiar en ella, y Decider puntúa las páginas antes de que un agente las lea. Sakana AI, por su parte, crea un equipo dedicado a la defensa colectiva y promete no publicar material de explotación.
Los agentes pasan de escribir código a participar en la cadena de entrega. En Runway, gestionan el 38 % de las fusiones de octubre y la IA aprueba por sí sola los cambios de bajo riesgo; Stitch Loop supervisa un producto en línea y abre pull requests para alcanzar un objetivo medible. En ambos casos, una persona mantiene el control sobre lo que importa: las áreas sensibles en Runway y cada fusión en Stitch Loop. Las herramientas siguen esta evolución: el Agents SDK de Python convierte a Codex en un proveedor de modelos, y Cognition evalúa los modelos según la pregunta que plantean estas cadenas: si se debe fusionar la PR.
En cuanto a los modelos abiertos, el esfuerzo se centra en lo que se puede obtener de unos pesos más ligeros. Inkling 2 Mini recorre tres veces sus capas intermedias para igualar a Qwen3.8-27B en el AA Index con 20 Go, el superadaptador de Hugging Face reúne tres especializaciones en un solo LoRA, y Metric AI parte de Qwen3.5 para crear modelos en armenio. Las cifras siguen siendo las de sus desarrolladores, y MedChemBench recuerda las limitaciones del ejercicio: OpenAI solo evalúa sus propios modelos y no descarta que hayan visto las publicaciones de origen.
Fuentes
- Cierre de la salida a bolsa (Anthropic)
- @AnthropicAI en X: los cofundadores
- Inkling 2 Mini (Thinking Machines)
- Publicación de Hugging Face sobre Inkling 2 Mini
- Inkling-2-Mini (Hugging Face)
- Tencent Hy4 en Together AI
- Comunicado de Tencent sobre Hy4
- Aprovechar adaptadores a gran escala (Hugging Face)
- @yb2698 en X: el superadaptador
- Ayb 0.5 (Metric AI)
- OhanTTS (Metric AI)
- OhanASR (Metric AI)
- @pcuenq en X: Depth Pro 2
- Artículo de arXiv 2611.26603: Depth Pro 2
- DepthPro2-L (Hugging Face)
- Combatir la destilación adversaria (OpenAI)
- @OpenAI en X: la destilación adversaria
- @hardmaru en X: el grupo de investigación en seguridad
- Grupo de investigación en seguridad (Sakana AI)
- Construir una fábrica de software (Runway)
- Stitch Loop (Google)
- Notas de la versión de ChatGPT
- @GeminiApp en X: disponibilidad de los GIF
- @GeminiApp en X: los GIF en Gemini
- @perplexity_ai en X: Computer en Chromium
- openai-agents-python v1.0.0-alpha.1
- @perplexitydevs en X: Decider en la Context API
- Puntuar páginas con criterios (documentación de Perplexity)
- Cookbook contra la inyección (documentación de Perplexity)
- Claude Code v2.1.329
- Codex CLI 0.171.0
- Vibe CLI v3.1.4
- Gemini 4 Neon en Devin (Cognition)
- @cognition en X: Gemini 4 Neon
- Presentación de MedChemBench (OpenAI)
- Artículo completo de MedChemBench (PDF)
- Variantes y localización de anuncios de vídeo en Ads Engine (ElevenLabs)
- Copilot CLI 1.0.115-2
- Codex CLI 0.173.0-alpha.2
- Gemini CLI, PR 30389
- Changelog de Antigravity
- Qwen Code v0.28.1-preview.1
- Kimi Code 2.7.2
- CLI mistral 0.20.1
- Changelog de Replit del 20 de noviembre
- @cognition en X: Devin Bot para Manim
- Notas de la versión de la API de Gemini
- Conciencia del tiempo y entrada asíncrona para agentes personales (OpenAI)
- @OpenAIDevs en X: historial y razonamiento de GPT-6.2
- @AskPerplexity en X: teammates desde Computer
- @AskPerplexity en X: aplicación para Mac
- @pika_labs en X: Seedance 2.5 Flash
- @HeyGen en X: pruebas a ciegas de Avatar 6
- Qwen3 TTS en Together AI
- Together Storage Accelerator (Together AI)
- @julien_c en X: el CDN de Hugging Face
- Superfluid en flota (basecompute)
- WavLate (Hugging Face)
- @NVIDIAAI en X: WorldTrace
- Dynamo y los rollouts de RL (NVIDIA)
- Atención dispersa en GPU NVIDIA (NVIDIA)
- GitHub Enterprise Server 3.23 release candidate (changelog de GitHub)
- Página Overview de las pull requests (changelog de GitHub)
- GitHub Desktop y varias cuentas por host (changelog de GitHub)
- Repositorios favoritos en el panel (changelog de GitHub)
- Hebbia y GPT-6 Astra (OpenAI)
- El consenso silencioso (OpenAI)
- Enriquecimiento de datos con IA (Perplexity)