ai-powered-markdown-translatorgpt-6.1-sol을 사용해 프랑스어에서 한국어로 번역한 기사.
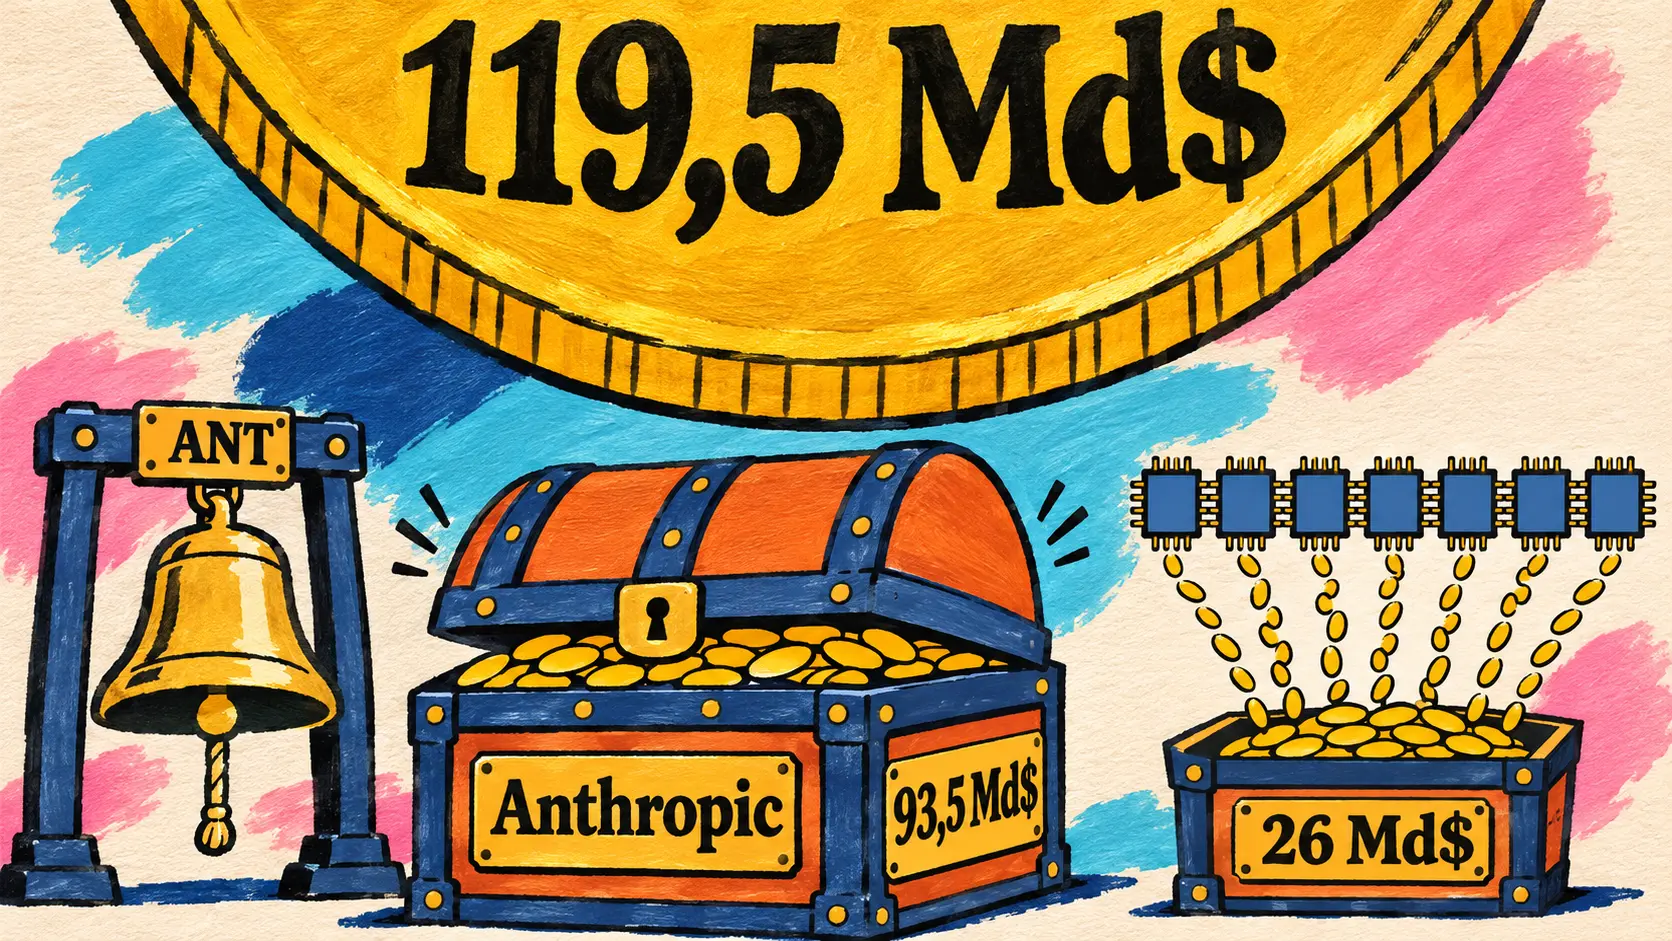
Anthropic이 기업공개를 마무리했다. 공모로 약 935억 달러를 조달했으며, 병행한 사모 투자로 NVIDIA, Google, Microsoft 등 7개 기업에서 260억 달러를 추가로 받았다. Thinking Machines는 20GB에 담기는 264억 매개변수의 공개 가중치 모델 Inkling 2 Mini를 공개했고, OpenAI는 모델의 보호된 추론을 추출하는 공격의 성공률을 54,0%에서 0,2%로 낮췄다. ChatGPT Space는 Plus 구독자에게도 제공되며, Runway에서는 코드 병합의 38%를 에이전트가 담당한다. Claude Code, Codex CLI, Vibe CLI도 각각 새 버전을 출시했다.
금융: Anthropic, 기업공개로 총 935억 달러와 사모 투자로 260억 달러 조달 완료
11월 20일 — 첫 거래일 다음 날, Anthropic은 기업공개 절차가 마무리됐다고 발표했다. 공모가는 11월 18일 주당 83달러로 확정됐다. 주관 은행들이 1억 4,700만 주의 추가 매수 선택권을 전량 행사하면서 총 1 127 000 000주의 A종 주식이 매각됐다. 수수료와 비용을 공제하기 전 총 조달액은 약 935억 달러이며, 이 가운데 약 916억 달러가 Anthropic에 돌아간다. 기존 주주들이 매각한 23 648 646주에 따른 대금은 Anthropic이 받지 않는다.
게시글은 공모가 발표 당시 언급되지 않았던 병행 사모 투자도 마무리됐다고 밝혔다. 반도체 및 컴퓨팅 분야의 7개 기업인 AMD, Broadcom, Google, Micron, Microsoft, NVIDIA, TSMC Partners에 N종 주식 313 253 007주를 동일한 주당 83달러에 매각해 약 260억 달러를 조달했다. 이 주식은 1933년 증권법에 따라 등록되지 않았다. 공모와 사모 투자를 합친 총 조달액은 수수료와 비용 공제 전 약 1,195억 달러다.
| 거래 항목 | Anthropic 발표 수치 |
|---|---|
| 매각된 A종 주식 | 1 127 000 000주, 이 가운데 147 000 000주는 주관 은행의 선택권 행사분 |
| 이 중 Anthropic 매각분 | 1 103 351 354 |
| 이 중 기존 주주 매각분 | 23 648 646 |
| 주당 가격 | 83달러 |
| 공모 총 조달액 | 약 93,5십억 달러 |
| Anthropic 수령액 | 약 91,6십억 달러 |
| 사모 투자(N종) | 313 253 007주, 약 26,0십억 달러 |
| 공모 및 사모 투자 총 조달액 | 약 119,5십억 달러 |
| 상장 | 11월 19일부터 Nasdaq Global Select Market에서 ANT로 거래 |
게시글은 상장 사실을 확인했지만 주가나 시가총액은 제시하지 않았다. Goldman Sachs와 Morgan Stanley가 거래를 주관했으며, J.P. Morgan, Citigroup, BNP Paribas, Crédit Agricole CIB, Société Générale 등 약 20개 은행이 인수단에 참여했다. 같은 날 @AnthropicAI는 공동 창업자 7명인 다리오 아모데이, 다니엘라 아모데이, 톰 브라운, 잭 클라크, 재러드 캐플런, 샘 맥캔들리시, 크리스 올라가 회사의 역사를 이야기하는 영상을 공개했다.
🔗 기업공개 완료 발표(Anthropic) · X의 @AnthropicAI: 공동 창업자들
공개 모델: Thinking Machines의 Inkling 2 Mini, Tencent Hy4, Qwen3.8-27B용 슈퍼 어댑터, Ayb 0.5, Depth Pro 2
11월 20일 — Thinking Machines Lab이 Inkling 2 Mini를 공개했다. 11월 12일 이곳에서 다룬 Inkling 2 Small(5,940억 매개변수)의 소형 모델이다. Apache 2.0 라이선스로 가중치를 공개한 이 전문가 혼합(Mixture-of-Experts) 모델은 총 264억 개의 매개변수 중 토큰당 34억 개를 활성화한다. 텍스트와 이미지를 읽으며, 컨텍스트는 100만 토큰이다. 가중치는 학습 당시의 정밀도 그대로 제공된다. 20개 레이어에는 NVFP4를, 마지막 4개 레이어에는 MXFP8을 사용하며, 변환에 따른 손실 없이 약 20GB에 담긴다. 따라서 메모리가 32GB 이상인 모든 Mac에서 Ollama로 실행할 수 있다.
Today we are releasing Inkling 2 Mini, a fast, powerful model that’s small enough to run on your laptop.
🇰🇷 오늘 노트북에서 실행할 수 있을 만큼 작으면서도 빠르고 강력한 모델인 Inkling 2 Mini를 공개합니다. — Thinking Machines Lab, Inkling 2 Mini 발표
이 모델의 특징은 아키텍처에 있다. 바로 반복형 트랜스포머(looped transformer)라는 점이다. 24개 레이어 중 가운데 12개를 세 번 통과하므로, 저장된 레이어는 24개지만 토큰당 레이어 통과 횟수는 48회이며, 이에 따라 토큰당 가중치 활성화 수는 54억 개가 된다. 연구소는 학습 도중 전문가의 3분의 2를 제거해 384개에서 128개로 줄인 뒤, 더 큰 내부 Inkling 모델에서 증류한 1조 토큰으로 모델을 복구했다. 연구소에 따르면, 손실이 같을 때 반복 구조가 없는 모델은 학습 연산량이 7,5% 적게 들지만 추론 연산량은 140% 더 많이 든다.
| 평가 항목(Thinking Machines 표) | Inkling 2 Mini | Qwen3.8-27B | Nemotron 3.5 Super VL |
|---|---|---|---|
| 토큰당 가중치 활성화 수 / 총 매개변수 수 | 5,4B / 26,4B | 27,0B / 27,0B | 12,0B / 124,5B |
| AA Index v5.0 | 20,1 | 20,1 | 13,6 |
| DeepSWE v1.1 | 48,2 % | 42,2 % | 24,7 % |
| SWE-bench Pro v2 Hard | 77,9 % | 73,8 % | 44,1 % |
| Terminal-Bench 2.1 (pi) | 71,6 % | 73,0 % | 60,7 % |
| BrowseComp | 79,0 % | 61,6 % | 78,9 % |
| MCP Atlas | 82,7 % | 77,3 % | 67,7 % |
Thinking Machines에 따르면, 이 모델은 1,000억 매개변수 미만 공개 모델 중 DeepSWE v1.1과 Vals Index v2.2(46,5%)에서 선두를 차지한다. Terminal-Bench 2.1에서는 Qwen3.8-27B에 뒤처지며, Thinking Machines는 여러 차례 주고받는 대화(MultiChallenge 50,0%)나 여러 제약이 있는 지시 이행(ComplexConstraints v1.1 33,4%)에서는 최고의 소형 모델이 아니라고 인정한다. 그래프 범례에는 모델마다 평가 설정이 다르다고 명시돼 있다. 사전 접근 권한을 받은 스탠퍼드 연구진은 DGX Spark에서 줄당 지능을 0,703으로 측정했으며, Qwen3.6-35B-A3B는 0,430이었다.
연구소는 이 모델을 사고 과정(chain of thought) 감시 연구에도 활용한다. 반복형 모델은 추론을 글로 남기지 않고도 더 많은 연산을 수행하므로, 감시 모델이 이를 포착하지 못할 수 있다. 함께 공개된 가변 통과 횟수 버전에서는 통과 횟수를 1회에서 3회로 늘리면, 서면 추론 없이 해결할 수 있는 과제가 사람의 작업 시간 기준 16초에서 37초로 늘어난다. 5회 통과할 때 추론 길이는 절반 수준으로 줄어들지만(GPQA Diamond에서 평균 3 703토큰 대비 1 661토큰), 가독성은 유지된다. Thinking Machines는 반복 횟수가 늘어도 에이전트의 방해 행위가 증가하지 않았다고 밝혔다. 모델은 Tinker, Ollama, SGLang, vLLM, llama.cpp, MLX, Transformers에서 사용할 수 있으며, Unsloth는 GGUF 버전을 제공한다.
🔗 Inkling 2 Mini(Thinking Machines) · Hugging Face 게시글 · Hugging Face의 가중치
Together AI, 7,700억 매개변수의 전문가 혼합 모델 Tencent Hy4를 입력 100만 토큰당 0,83달러에 제공
11월 19일 — Together AI가 서버리스 추론 서비스에 Tencent Hy4를 추가했다. 100만 토큰의 컨텍스트, 도구 호출, JSON 출력을 지원한다. 서비스 제공업체에 따르면 Tencent의 주력 모델인 Hy4는 총 7,700억 개의 매개변수 중 토큰당 490억 개를 활성화하는 전문가 혼합 모델이다. Hy4 Preview의 후속 모델로 컴퓨터 사용 기능을 추가했으며, Hy 계열 최초로 이미지를 읽을 수 있다.
| 100만 토큰당 요금 | Together AI | Tencent(11월 4일 발표) |
|---|---|---|
| 입력 | 0,83달러 | 약 0,90달러 |
| 캐시된 입력 | 0,042달러 | 약 0,045달러 |
| 출력 | 2,50달러 | 약 2,70달러 |
Tencent는 11월 4일 Hy4를 출시하면서 최고의 오픈 소스 모델 중 하나라고 소개하고, 며칠 내로 가중치를 공개하겠다고 약속했다. tencent/Hy4 저장소는 Hugging Face에 있으며, 라이선스 유형은 ‘other’다. 발표문은 전문가 213명이 과제 579개를 평가한 금융 분야 블라인드 평가에서 Hy4가 3,04점을 받아 DeepSeek-V4.1-Flash-1017(2,97점)을 앞섰고, 내부 환각 비율은 12,95%에서 7,2%로 낮아졌다고 밝혔다.
🔗 Together AI의 Tencent Hy4 · Tencent의 11월 4일 발표문
Hugging Face, 하네스 어댑터 제작법과 Qwen3.8-27B용 단일 슈퍼 어댑터 공개
11월 20일 — 어제 이곳에서 다룬 Hermes 어댑터를 포함해 사흘간 이어진 공개 끝에, Hugging Face가 하네스 어댑터의 전체 제작법을 공개했다. Qwen3.8-27B를 기반으로 에이전트 하네스(pi, Hermes Agent, OpenCode) 안에서 강화 학습으로 LoRA를 훈련하는 방식이다. 새롭게 선보인 것은 슈퍼 어댑터다. 랭크 32인 LoRA 3개를 랭크 96인 단일 LoRA로 이어 붙여, 세 하네스 모두에서 작동하도록 했다. 각 업데이트가 거의 직교하므로(코사인 유사도 0,01~0,02), 결합된 어댑터는 세 업데이트를 정확히 모두 적용한다.
| SWE-bench Pro(어려운 과제 51개), 추론 사용 | 기본 모델 | 슈퍼 어댑터 적용 |
|---|---|---|
| Hermes Agent 하네스 | 45 % | 61 % |
| OpenCode 하네스 | 47 % | 67 % |
| pi 하네스 | 74 % | 74 % |
팀의 연속 게시물에 따르면, 추론을 사용할 때 하네스와 벤치마크의 6개 조합 평균은 55,5%에서 63,5%로 상승했고, 도구 호출은 1948% 줄었다. 게시글에 따르면, 추론을 사용하지 않을 때 슈퍼 어댑터는 SWE-bench Pro에서 618%포인트 향상된 성능을 보였으며, 도구 호출은 53~73% 줄었다. 하네스마다 기본 설정이 달라 서로 다른 하네스의 점수는 직접 비교할 수 없다. 학습에는 598단계와 1억 6,700만 토큰이 필요했다. safeagents 보호 장치는 도구 호출 130만 건을 검사해 647건을 차단했다. 과제, 어댑터, GGUF, 평가 실행 경로가 공개됐다.
🔗 대규모 하네스 어댑터(Hugging Face) · X의 @yb2698
Metric AI, 아르메니아어용 공개 텍스트·음성 모델 Ayb 0.5, OhanTTS, OhanASR 공개
11월 20일 — 아르메니아의 Metric AI 팀이 자국 언어를 위한 모델 3개 계열을 같은 날 공개했다. Ayb 0.5는 Qwen3.5를 기반으로 토크나이저 확장부터 후속 학습까지 아르메니아어에 맞게 조정한 언어 모델 3종(0,8B, 4B, 9B)으로 구성된다. Ayb-9B는 여러 차례 주고받는 대화, 도구 호출, 이미지 처리를 지원한다. OhanTTS-v0.1은 아르메니아어와 프랑스어를 포함한 8개 언어로 음성을 합성하며, 3~10초의 음성으로 목소리를 복제한다. 2B 규모의 음성 인식 모델인 OhanASR-v0.1은 아르메니아어 음성 820시간으로 미세 조정됐다.
| Metric AI 모델 | 개발진이 공개한 결과 |
|---|---|
| Ayb-9B | ArmBench 종합 3위(0,6164) |
| OhanTTS-v0.1, 아르메니아어 61시간 | WER 14,70 %, GB10에서 첫 음성 생성까지 331 ms |
| OhanASR-v0.1 | ArmBench-ASR에서 WER 16,12 %(2위), CER 3,49 %(1위) |
Ayb-9B 가중치는 비상업적 라이선스(CC BY-NC 4.0)로 제공되며, 수동 승인을 거쳐 접근할 수 있다.
🔗 Ayb 0.5(Metric AI) · OhanTTS · OhanASR
Apple, 사진과 동영상에서 미터 단위 깊이를 추정하는 Depth Pro 2 공개
11월 19일 — Apple이 사진과 동영상을 원래 해상도로 처리해 미터 단위 깊이를 추정하는 모델 계열인 Depth Pro 2를 공개했다. 논문 초록에 따르면 기존 방식은 프레임 간 일관성과 선명한 윤곽 중 하나를 선택해야 했지만, Depth Pro 2는 단일 신경망으로 둘 다 달성하는 것을 목표로 한다. 가중치는 Hugging Face에서 4가지 크기(S, B, L, H)로 제공된다. Core ML 버전과 공통 초점 거리 추정기도 함께 제공되며, 이 추정기는 EXIF 초점 거리 정보가 없을 때 유용하다.
| DepthPro2-L 처리 해상도(334M, B200에서 실행) | 초당 프레임 수 |
|---|---|
| VGA | 150,1 |
| 720p | 33,7 |
| 1080p | 9,1 |
| 4K | 0,7 |
가중치는 비상업적 연구용으로만 사용할 수 있으며(Apple Machine Learning Research Model 라이선스), 코드는 GitHub에 있다. Hugging Face의 페드로 쿠엔카는 11월 20일 온라인 시연과 함께 출시 소식을 전했다.
🔗 X의 @pcuenq · arXiv 논문 2611.26603 · DepthPro2-L(Hugging Face)
모델 보안: 적대적 증류에 대응하는 OpenAI, Security Research Group을 신설한 Sakana AI
OpenAI, 적대적 증류 대응 방식을 공개하고 보호된 추론 추출률을 54,0 %에서 0,2 %로 낮춰
11월 20일 — OpenAI가 적대적 증류(adversarial distillation)에 관한 글을 공개했다. 최첨단 모델의 출력을 무단으로 이용해, 원래 모델이라면 거부했을 공격 등에 쓰이도록 동일한 안전장치 없이 배포되는 다른 모델을 훈련하는 행위를 말한다. 글은 우선 답변 전에 생성되는 사고의 연쇄인 보호된 추론에 초점을 맞춘다. 내부 연구에 따르면 학생 모델은 대체로 추론 요약보다 원본 추론 기록으로 학습할 때 성능이 더 많이 향상된다.
| 측정한 공격 유형 (적응형 평가, 공격 모델 6종) | GPT-6 Astra, 기존 안전장치 | GPT-6.2 Astra, 갱신된 안전장치 |
|---|---|---|
| 이전 요청의 추론 | 54,0 % | 0,2 % |
| 현재 요청의 추론 | 22,9 % | 0,9 % |
방어에는 적대적 훈련, 입력 및 출력 분류기(도구 호출 인수 포함), API 통제와 조사를 함께 활용하며, 매주 수천 개에서 수만 개의 계정을 동원한 활동에 제재를 가한다. GPT-6.2 Astra와 Sol에서는 보호된 추론이 이를 생성한 대화 기록에 연결된다. 이전 메시지를 다시 작성하면 API가 해당 추론을 폐기하며, 구형 모델 계열은 더 이상 이를 읽을 수 없다. OpenAI는 지난 2월 DeepSeek이 미국 모델을 증류하려 한다는 정황을 의회에 보고했고, 이어 9월에는 한 활동의 주체를 Moonshot AI와 연관된 인물들로 지목했다고 상기시켰다. 또한 Chip Security Act, AI OVERWATCH Act, MATCH Act를 지지한다고 밝혔다.
🔗 적대적 증류에 맞서기 (OpenAI) · X의 @OpenAI
Sakana AI, 공동 사이버 방어를 위한 독립 조직 Security Research Group 설립
11월 20일 — Sakana AI가 도쿄에 기반을 둔 독립 연구 개발 조직 Security Research Group을 출범시켰다. 상업 부문과 분리되어 공익을 추구하는 조직이다.
Excited to announce the Sakana AI Security Research Group, an independent, public-interest R&D team in Tokyo co-led by Akihiro Umegai and me.
🇰🇷 우메가이 아키히로와 제가 공동으로 이끄는, 도쿄 소재의 독립적이고 공익을 추구하는 연구 개발 조직 Sakana AI Security Research Group을 기쁜 마음으로 소개합니다. — X의 @hardmaru
데이비드 하는 Sakana AI의 공동 창업자이자 최고경영자다. 이 조직은 설계 단계부터의 예방, 여러 조직에 분산된 에이전트를 통한 공동 방어, 그리고 방어 에이전트 자체의 보안 확보라는 세 가지 축을 중심으로 활동한다. 방어 에이전트의 권한은 맡은 작업으로 제한하고, 행동은 추적 가능하도록 기록한다. 출발점은 Digital Red Queen, ShinkaEvolve, Fugu-Cyber 같은 자체 연구다. Sakana AI는 Fugu-Cyber가 CyberGym에서 86,9 %, CTI-REALM에서 72,1 %를 기록했다고 밝혔지만, 글의 주석은 Fugu-Cyber 페이지에 기준 점수나 평가 절차가 제시되어 있지 않다고 명시한다. 백서, 벤치마크, 방어 지침을 공개하되 악용 자료는 공개하지 않으며, 발견한 취약점은 조율된 공개 절차를 거친다. Sakana AI는 NIST에 따르면 CVE 신청이 2020년부터 2025년 사이 263 % 증가했다고 덧붙였다.
소프트웨어 배포에 연결된 에이전트: Runway의 공장, Google Labs의 Stitch Loop
Runway, 소프트웨어 배포 과정을 에이전트에 맡겨… 10월 병합의 38 % 주도
11월 20일 — Runway가 엔지니어링 블로그에 ‘소프트웨어 공장’(software factory)의 성과 수치를 공개했다. 코드 작성부터 병합 조율까지 일곱 단계를 하나씩 에이전트에 맡기는 방식이다. 클라우드 에이전트는 10월에 병합된 pull request의 38 %를 주도했으며, 11월 상반기에 병합된 이러한 PR 100건 중 78건에는 사람이 작성한 commit이 전혀 없었다.
| 소프트웨어 공장 지표 | 시작 시점 | 최근 측정치 |
|---|---|---|
| 클라우드 에이전트가 주도한 병합 | 0,1 % (6월) | 38 % (10월) |
| 첫 승인까지의 대기 시간 중앙값 | 2,3 h (9월) | 약 5 min (11월 중순) |
| 주간 평균 병합 건수 | 929 (9월) | 2 235 (10월 중순 이후) |
10월 중순부터 AI는 위험도가 낮은 PR을 단독으로 승인하며, 저장소가 허용하면 중간 위험도 PR도 승인한다. 위험도가 높은 PR은 사람이 담당하며, 마이그레이션, CI 및 배포 설정, 비밀 정보, 인증은 항상 코드 소유자가 승인한다. 9월과 10월에는 AI가 승인한 PR 977건 중 15건에 사람이 이의를 제기했다. AI가 단독 승인한 병합의 되돌리기 비율은 0,10 %로, 사람이 승인한 경우의 약 200건 중 1건과 비교된다. 에이전트는 사용자처럼 App Studio를 시험하기도 하며(나흘 동안 버그 86건 확인), 한 조정 에이전트는 2주 동안 작업 14 000건 이상을 배분했다. 모두 내부 도구이며, 판매 제품이나 요금은 없다.
Google Labs, 운영 중인 애플리케이션을 지속적으로 개선하는 제품 에이전트 Stitch Loop 공개
11월 18일 — Google Labs가 코드 에이전트의 작업이 끝나는 지점, 즉 운영 배포 이후부터 이어서 활동하는 장기 실행 제품 에이전트 Stitch Loop를 소개했다. 180개 이상의 연동, 맞춤형 MCP 서버 또는 로컬 CLI를 통한 전송으로 GitHub 저장소와 운영 중인 제품의 데이터(로그, 사용자 행동, 의견)에 연결되며, 측정 가능한 목표를 향해 지속적으로 작업한다.
각 반복 주기에서는 데이터에 근거한 개선 방향을 제안하고, 해결책과 그에 따른 절충 사항을 상세히 설명한 뒤, 격리된 클라우드 샌드박스에서 코드를 작성하고 승인을 받을 pull request를 연다. 이후 실시간 지표를 관찰한다. 사이버 보안, 지연 시간, 접근성의 세 가지 반복 작업이 기본 제공된다. 보안 작업은 Gemini 4 Carbon과 Google DeepMind의 코드 보안 에이전트 CodeMender를 함께 사용한다. 팀의 검토 없이는 아무것도 병합되지 않는다. Stitch Loop는 Stitch CLI와 MCP를 통해 Google Antigravity 같은 코드 에이전트에 제품 맥락을 제공하는 역할도 하며, Slack에서도 사용할 수 있다. 현재는 전 세계에서 대기 명단 등록만 가능하며, 자격 요건을 충족하는 Google AI Ultra 구독자에게 우선 이용 권한이 제공된다.
일반 사용자용 어시스턴트: Plus 구독자를 위한 ChatGPT Space, Gemini 앱의 GIF, Chromium 브라우저의 Perplexity Computer
ChatGPT Space, 전 세계 Plus 구독자에게 개방
11월 20일 — 9월 29일 DevDay에서 소개되고 지금까지 Pro, Business, Enterprise 요금제에만 제공되던 ChatGPT Space가 전 세계 18세 이상 Plus 구독자에게 순차적으로 제공된다. 웹, 데스크톱 앱, iOS, Android에서 Space가 사이드바의 라이브러리(페이지, 슬라이드, 이미지, 업로드한 파일)를 대체한다.
이곳에서 ChatGPT와 함께 대화형 페이지와 프레젠테이션을 만들 수 있으며, Space 이용 권한이 있는 다른 사람도 내용을 보완할 수 있다. 페이지와 슬라이드는 연결된 앱의 정보를 바탕으로 스스로 갱신될 수 있다. OpenAI는 자동으로 갱신되는 할 일 목록이나 Slack에서 내린 결정을 반영하는 프로젝트 계획을 예로 들었다. 댓글에서 ChatGPT를 언급하기만 하면 수정을 요청할 수 있고, dot을 협업에 초대할 수도 있다. 공유는 제한적으로 이루어진다. 열람 권한과 함께 Space를 이용할 수 있는 Plus, Pro, Business 또는 Enterprise 계정이 필요하다. Free 계정으로는 공유된 콘텐츠를 열 수 없으며, 공개 링크도 제공되지 않는다.
Gemini 앱, Gemini Omni 1.2 Flash로 움직이는 GIF 생성… 프랑스에서도 무료 제공
11월 20일 — Gemini 앱에서 이제 Google이 11월 5일 출시한 동영상 모델 Gemini Omni 1.2 Flash로 움직이는 GIF(반복되는 사진 효과, 밈)를 만들 수 있다. Google에 따르면 움직임이 매끄럽고 프레임마다 품질이 일정하게 유지된다. 기본 채팅창에 요청을 입력하거나 이미지 또는 동영상 도구를 연 다음, 형식 선택기에서 GIF를 선택하면 된다.
GIFs are now available to all Google AI subscribers and free of charge in the U.S., Japan, Korea, Australia, Canada, U.K., Germany, and France.
🇰🇷 이제 모든 Google AI 구독자가 GIF를 이용할 수 있으며, 미국, 일본, 한국, 호주, 캐나다, 영국, 독일, 프랑스에서는 무료로 이용할 수 있습니다. — X의 @GeminiApp
따라서 프랑스 사용자는 구독하지 않아도 이용할 수 있다. Google도 OpenAI의 뒤를 따르는 것으로, ChatGPT에서 Images 2.6으로 만드는 움직이는 GIF는 이곳에서 11월 5일 다뤘다.
Perplexity Computer, Perplexity 확장 프로그램으로 Chromium 브라우저에서 직접 작동
11월 20일 — 이제 Perplexity 확장 프로그램을 통해 Chromium 기반 브라우저에서 Perplexity Computer를 직접 사용할 수 있다. 확장 프로그램의 측면 패널에서 작업을 맡긴 뒤, Computer가 사용자의 탭과 도구에서 작업하는 모습을 지켜볼 수 있다. 발표 게시물에는 해당 요금제나 지원 브라우저 목록이 명시되지 않았다.
앞서 두 차례 비슷한 기능이 나왔다. 10월 5일에는 Mac 앱 26.38.0에서 확장 프로그램을 통해 Computer가 Chrome, Edge, Brave를 사용할 수 있게 되었고, 10월 30일에는 Chrome 확장 프로그램이 Computer의 Mac 및 Windows 앱을 사용자의 브라우저에 연결했다. 이번에는 브라우저 안에 있는 확장 프로그램의 측면 패널에서 작업을 맡긴다.
개발자용 API와 SDK: Agents SDK Python의 Codex, Perplexity Context API의 Decider
OpenAI Agents SDK Python, Codex를 모델 제공자로 사용하는 1.0 사전 공개 버전 출시
11월 20일 — OpenAI Agents SDK Python이 접근 방식을 바꾼 사전 공개 버전으로 1.0 계열을 시작했다. 이곳에서 11월 16일 다룬 0.24 사전 공개 버전처럼 별도의 네이티브 엔진을 사용하는 대신, 실행할 때마다 Codex를 모델 제공자로 선택한다. CodexProvider을 만들고 RunConfig(model_provider=provider)을 통해 Runner에 전달하면, 에이전트는 저장된 Codex 로그인 정보나 API 키로 실행된다.
Python wheel에는 PyO3를 통해 Codex Core(rust-v0.166.0, 수정 없음)가 포함된다. SDK가 codex app-server을 실행하거나 JSON-RPC를 거치지 않고 Codex의 핵심 부분을 직접 호출한다. Python 도구, 전문 에이전트로의 작업 인계(handoffs), 도구 실행 전 승인, 자료형이 지정된 출력은 계속 사용할 수 있으며, 네이티브 명령은 Codex의 샌드박스와 승인 규칙을 따른다. 1.0.0a1 wheel은 GitHub Releases에서만 배포된다(Linux x86-64 및 ARM64, Apple silicon 기반 macOS 11 이상, Windows x64, CPython 3.10부터 3.14). 사전 공개 버전 0.24.0-alpha.8의 저장 데이터는 Runner와 호환되지 않으며, 안정 버전은 여전히 11월 18일의 0.25.0이다.
🔗 openai-agents-python v1.0.0-alpha.1
Perplexity, Context API에 Decider를 추가해 프롬프트 주입을 포함한 페이지 평가 지원
11월 19일 — Perplexity가 이틀 전 출시한 Context API(URL 1 000개당 1달러)에 의사결정 모델 Decider를 추가했다. 가져온 페이지마다 예 또는 아니요로 답하는 질문을 최대 다섯 개까지 할 수 있으며, Decider는 각 답변에 0부터 1까지의 점수를 매긴다. 대표적인 활용 분야는 보안으로, 에이전트가 페이지를 읽기 전에 프롬프트 주입(prompt injection)을 탐지하는 것이다. Perplexity는 잠재 고객 평가, 콘텐츠 검토, 출처 없는 건강 관련 주장 탐지도 예로 들었다.
API 자체는 아무것도 걸러내지 않는다. 모든 페이지를 점수와 함께 반환하며, 임계값을 적용하는 것은 애플리케이션 코드의 몫이다. 점수 산정에는 URL당 요금 외에 Decisions API의 입력 토큰 요금이 부과되며, 요청 처리 시간이 최대 15초 늘어날 수 있다. 문서의 쿡북에는 11월 18일 임계값 0,7로 실행한 검사가 제시되어 있다.
| 시험한 페이지 (11월 18일 쿡북) | 주입 점수 | 검사 판정 |
|---|---|---|
| 주입 시연 (그레샤케 외, 2023) | 0,97 | 격리 |
| OWASP의 프롬프트 주입 관련 페이지 | 0,0018 | 전달 |
| RFC 9111 | 0,0007 | 전달 |
쿡북은 점수가 낮다고 해서 페이지가 안전해지는 것은 아니라고 경고한다. Perplexity의 BrowseSafe++ 연구에 따르면, 시험한 모든 모델은 스스로 탐지한 주입 중 일부를 여전히 따랐다.
🔗 @perplexitydevs의 게시물 모음 · 문서 · 쿡북
코드 에이전트: Claude Code 2.1.329, Codex CLI 0.171.0, Vibe CLI 3.1.4와 Devin의 Gemini 4 Neon
Claude Code 2.1.329, 폴더를 열 때 hooks의 출처를 표시하고 예약 작업을 /tasks로 통합
11월 19일 — Claude Code 2.1.329에는 수정 91건, 변경 20건, 추가 7건을 포함해 130개 항목이 담겼다. 보안 측면에서는 폴더를 신뢰할지 묻는 대화상자에 이제 해당 폴더의 hooks가 선언된 위치가 표시된다. 또한 Claude Desktop을 비롯한 비대화형 호스트는 관리 설정(managed settings)으로 강제된 hooks를 불러오지 못하면 경고한다. /tasks에는 세션의 예약 작업, /loop의 재개 일정, 진행 중인 목표와 대화의 fork도 표시된다. 이전 버전에서 등록한 예약 작업 대부분은 다시 예약해야 한다.
이제 대부분의 모델에서 /code-review을 대상 없이 실행하면 기본 브랜치와 비교해 전체 브랜치를 검토하며, PR 번호를 지정하면 gh pr diff을 통해 해당 PR 자체를 읽는다. macOS의 computer use에는 더 최근의 보안 규칙이 적용되어 일부 작업이 거부된다. max_tokens 오류 이후 자동으로 재시도하도록 2.1.326에서 추가된 기능은 제거된다. 게이트웨이를 사용하는 환경에서는 CLAUDE_CODE_MAX_OUTPUT_TOKENS을 설정해야 한다. Code Mode에는 OpenTelemetry 이벤트 및 지표 호환성을 포함해 17개 항목이 반영되었다. 2.1.330은 11월 20일부터 npm에 게시되어 있다.
Codex CLI 0.171.0, GPT-6.2 Sol을 기본값으로 지정하고 터미널 작업 공간 활성화
11월 20일 — Codex CLI 0.171.0은 11월 18일의 0.170.0 이후 첫 안정 버전이며, pull request 339건을 포함한다. GPT-6.2 Sol과 GPT-6.2 Astra가 모델 목록에 추가되고 Sol이 기본값으로 선택된다. /rc과 /remote 명령으로 터미널에서 로컬 원격 제어를 관리하고 기기 페어링 코드를 표시할 수 있다.
11월 14일부터 17일까지의 사전 공개 버전에서 선보인 여러 기능이 안정 버전에 포함된다. 기본으로 활성화되는 TUI 작업 공간은 대화 옆에 문서와 이미지 미리보기, 하위 에이전트의 대화 기록을 표시한다. codex exec --remote은 기존 애플리케이션 서버에서 비대화형 세션을 시작하거나 재개한다. 입력창에는 실행 취소와 다시 실행이 추가된다. 옵션을 활성화하면 /statusline으로 MCP 서버가 제공하는 상태 표시줄을 선택할 수 있다. 수정 사항으로는 초안과 대기열에 있는 재시도가 해당 대화에 계속 연결되도록 한 점, 갱신 토큰을 발급하지 않는 인증 제공자와도 기업용 MCP 로그인이 작동하도록 한 점이 있다.
Vibe CLI 3.1.4, 에이전트와 승인 정책을 분리하고 에이전트의 확인 절차 해제 권한을 없애다
11월 20일 — Mistral이 Mistral Large 4를 기본 모델로 지정한 3.1.3 출시 이틀 만에 Vibe CLI 3.1.4를 공개했다. 변경 항목 79개(추가 18개, 변경 41개, 수정 18개, 삭제 2개)는 주로 권한에 관한 것이다. 이제 각 세션은 서로 독립적인 두 설정, 즉 에이전트(default, lean 또는 사용자 지정)와 승인 정책(ask, accept-edits, smart-approve 또는 auto-approve)을 조합하며, 승인 정책은 --approval-policy 또는 default_approval_policy로 선택한다.
이제 에이전트가 확인 없이 실행할 작업을 단독으로 결정할 수 없다. 에이전트의 safety, bypass_tool_permissions, permission = "always" 설정은 무시된다. 프로젝트는 더 이상 .vibe/agents/ 폴더에서 승인 정책을 재정의할 수 없으며, 분기된 세션과 하위 세션은 원래 정책을 상속한다. 인터페이스에는 입력창 위에 칩을 나열한 ‘레일’이 추가됐고(하위 에이전트, 백그라운드 작업, 풀 리퀘스트, 목표, 할 일), keep_awake 설정은 한 차례 작업하는 동안 절전 모드 진입을 막는다. 또한 Vibe가 시스템 인증서를 지원해 기업 프록시 환경에서 작동하기 쉬워졌다. 이제 Mistral 모델에는 가장 최근 이미지 8개만 전송되며, 사용자 지정 압축 프롬프트는 삭제됐다.
Devin, Gemini 4 Neon 제공 시작… FrontierCode 2.0에서 작업당 4,38달러로 46,2 % 기록
11월 19일(게시물 날짜는 18일) — 어제 여기서 다룬 Cursor와 GitHub Copilot에 이어, Cognition이 Devin Desktop과 Devin CLI에서 Gemini 4 Neon을 제공하기 시작했다. 풀 리퀘스트를 병합할 만한지 평가하는 자사 벤치마크 FrontierCode 2.0에서 Neon은 46,2 %를 기록했다. Cognition에 따르면 Google 모델 중 최고 성적이다. Claude Opus 5.5(47,3 %)와 약 1%포인트 차이이며, 비용은 약 3분의 1이다. 작업당 12,82달러인 Opus에 비해 Neon은 4,38달러다.
| FrontierCode 2.0 평가 모델 | Cognition이 공개한 점수 |
|---|---|
| Claude Fable 5.2 | 50,2 % |
| Claude Opus 5.5 | 47,3 % |
| Gemini 4 Neon | 46,2 % |
| GPT-6.2 Astra | 44,2 % |
| GPT-6.2 Sol | 43,8 % |
| Gemini 4 Carbon | 42,6 % |
비용은 공개 할인을 포함한 API 정가 기준 실행당 평균 지출액이며, 필수 통과 기준을 충족하지 못한 해결책은 0점을 받는다. 이 그래프의 여러 점수가 이전 몇 주 동안 공개된 수치와 다르지만, 게시물에는 설명이 없다.
🔗 Devin의 Gemini 4 Neon (Cognition) · X의 @cognition
과학: OpenAI, 의약화학 벤치마크 MedChemBench 공개… GPT-6.2 Astra 84,5 % 기록
11월 20일 — OpenAI가 모델이 의약화학자처럼 추론하는 능력을 측정하는 벤치마크 MedChemBench를 소개했다. 분자 구조와 실험 결과를 연결하고, 화합물을 비교하며, 특성을 예측하는 능력을 평가한다. 논문과 특허 117편에서 추출한 문제 99개와 서로 다른 분자 구조 761개로 구성되며, 구조, 과학적 추론, 화합물 선택, 특성 예측의 네 요소를 채점한다.
| 평가 모델(추론 수준 xhigh) | 획득 점수 |
|---|---|
| GPT-6.2 Astra | 84,5 % |
| GPT-6 Astra | 83,3 % |
| GPT-6.1 Sol | 82,0 % |
| GPT-6.1 Terra | 75,1 % |
| GPT-5.6 Sol | 58,2 % |
영역별 성적은 고르지 않다. GPT-6 Astra는 구조 영역에서 배점의 95,4 %를 얻었지만, 화합물 선택과 수치 예측에서는 약 절반을 얻었다. OpenAI는 신중한 입장을 유지한다. 이 벤치마크는 과거 데이터를 다루므로 모델이 신약을 발견할 수 있음을 입증하지 않으며, 원본 출판물을 사전에 접했을 가능성을 배제할 수 없고, 평가 대상도 GPT 모델뿐이다. 이는 11월 6일 여기서 다룬 BioBasicsBench의 후속 벤치마크다.
🔗 MedChemBench 소개 (OpenAI) · 논문 전문 (PDF)
생성형 영상 및 오디오: ElevenLabs, 추가 촬영 없이 광고 변형본을 만드는 기능을 Ads Engine에 추가
11월 20일 — ElevenLabs가 6월에 출시한 ElevenCreative 통합 광고 제작 도구 Ads Engine을 확장했다. Google, Meta, LinkedIn에 이어 이제 TikTok 광고 계정에도 연결되며, 기존 광고와 성과를 바탕으로 추가 촬영 없이 변형본을 제작한다. 시선을 끄는 도입부(후크)를 찾아내고 성과가 좋았던 광고를 참고해 새 도입부를 작성한다. 이를 원래 화자의 목소리를 디지털로 복제한 음성으로 읽어 주며, 입 모양을 동기화하고 자막도 갱신한다. 영상의 분위기와 리듬에 맞춰 ElevenLabs Music API가 작곡한 새 배경음악은 상업적으로 이용할 수 있다.
이미 Dubbing v2가 담당하던 현지화 기능에서는 이제 Ads Engine이 화자의 입 모양을 대상 언어에 맞추고, 영상에 삽입된 자막을 브랜드의 타이밍과 글꼴에 맞춘 번역본으로 교체한다. 배포 전에는 대상 언어가 모국어인 현지화 전문가를 포함해 사람이 검토할 수 있으며, 도구에서 플랫폼으로 바로 게시할 수도 있다. 이용하려면 영업팀에 문의해야 하며, 가격은 공개되지 않았다.
🔗 Ads Engine의 영상 광고 변형 및 현지화 (ElevenLabs)
단신
코딩 에이전트
- Copilot CLI 1.0.115-2 — 수정 335개를 포함해 변경 항목이 351개인 이번 사전 출시 버전에서는 이용 권한이 있는 계정의 모델 선택기에 Gemini 4 Hydrogen과 Extra High 추론 수준이 추가되고, GPT-6.2 Astra를 지원하며,
/model가 사용자 지정 공급자의 모델도 처리한다. 안정 버전은 여전히 1.0.114다. 🔗 출처 - Codex CLI 0.173.0-alpha.1 및 alpha.2 — 이 사전 출시 버전들의 릴리스 노트는 비어 있다. 커밋 71개의 제목에 따르면 MCP 연결 공유와 설정된 서버의 OAuth 탐색이 기본 활성화되고, 관리자는 Codex 데몬 업데이트를 비활성화할 수 있게 된다. 안정 버전 출시 전까지 내용은 바뀔 수 있다. 🔗 출처
- Gemini CLI — 11월 4일 이후 첫 야간 빌드(v0.71.0-nightly.20261120)다. 주 브랜치에서는
gemini --resume가 마지막으로 시작한 세션이 아니라 가장 최근에 사용한 세션을 다시 열고, Windows에서도 드디어~\로 시작하는 경로가 확장된다. 🔗 출처 - Antigravity IDE 2.8.0 — Google의 편집기가 백엔드를 즉시 시작하고 백그라운드에서 업데이트를 확인한다. 원격 연결을 위해 포트를 자동으로 전달하고, 키보드로 대화 내용을 검색하며, 연결 시 사용자 지정 인증서와 프록시를 지원한다. 🔗 출처
- Qwen Code 0.28.1-preview.1 — 변경 항목이 179개인 이번 사전 출시 버전은 GitHub를 세 번째 지원 채널 어댑터로 추가한다. 웹 인터페이스에서 설정할 수 있는 WeCom, Microsoft Teams, 범용 발신 웹훅을 추가하고, CLI에 화면 낭독기용 표시 방식을 도입한다. 안정 버전은 여전히 v0.28.0이다. 🔗 출처
- Kimi Code 2.7.1 및 2.7.2, Kimi Code Desktop 1.4.1 및 1.4.2 — 2.7.0 출시 다음 날 나온 네 가지 수정 버전이다. 초안에서 선택한 추론 수준이 전송 후 기본값으로 되돌아가지 않으며, 작업 도중 방향을 바꾼 세션을 복원한 뒤에도 세션 분기가 실패하지 않는다. 🔗 출처
- CLI mistral 0.20.1 — 이제
mistral evals exec는 401 오류 등의 이유로 실행 내 모든 호출이 실패하면 성공으로 처리하는 대신 실패 상태(코드 1)로 종료한다. Ctrl-C로 중단한 경우에도 해당 사실을 표시한다. 🔗 출처 - Replit — 이제 작업 공간(Workspaces)을 검색하고 고정할 수 있다. 이 옵션은 작업 공간이 5개 이상일 때만 나타난다. 🔗 출처
- Manim용 Devin Bot — Cognition이 그랜트 샌더슨이 Manim 작업을 돕도록 설정한 Devin Bot을 소개했다. Manim은 3Blue1Brown 영상에 쓰이는 오픈 소스 애니메이션 시스템으로, 별 96,6 k개와 월 다운로드 250 000회를 기록한다. 게시물에는 봇에 맡긴 작업이나 그 성과가 구체적으로 나와 있지 않다. 🔗 출처
API 및 플랫폼
- Gemini API — 11월 17일부터 Gemini 3.5 Transcribe는 일반 버전과 실시간 버전 모두에서 음성으로 받아쓰기 내용이나 기존 텍스트를 수정하고, 다시 쓰고, 서식을 지정할 수 있다(
source_text매개변수). Google은 번역도 언급했다. 18일부터는 전송한 파일의 필요한 부분만 처리하고 그 부분에 대해서만 비용을 낼 수 있다. 페이지 범위, 탭, 셀, 시간 구간, 콘텐츠 계층을 지정할 수 있다. 🔗 출처 - Agents API의 시간 인식 — 실험적 옵션(
experimental={"time_awareness": True})이 모델에 현재 시간을 주기적으로 알려 줘 마감 시각에 맞춰 작업하게 한다. 비동기 도구와 함께 사용하면 에이전트가 질문을 한 뒤 답변을 기다리는 동안 계속 조사할 수 있으며, OpenAI 개발자 블로그 게시물에서 이를 보여 준다. 🔗 출처 - GPT-6.2의 대화 기록 — @OpenAIDevs는 Responses API에서 이전 메시지를 수정하지 말라고 요청했다. API가 수정 지점 이후의 추론을 폐기하기 때문이다. Usage 대시보드의 새로운 ‘추론 제거’ 섹션에서 이를 확인할 수 있으며, 관련 가이드는 추론 수준이나 도구를 바꾸려면 대신
configuration_update또는additional_tools항목을 추가하라고 제안한다. 🔗 출처
일반 사용자용 도우미
- ChatGPT, dot 탭과 고정 즐겨찾기를 갖춘 새 모바일 앱 배포 — Codex, Projects, Images를 탭 표시줄에 고정할 수 있다. 배포는 dot이 제공되는 지역의 만 18세 이상 Pro 이용자와 소수의 Plus 이용자부터 시작하며, 유럽 경제 지역(유럽 연합 포함), 영국, 스위스, 한국은 제외된다(위에 링크한 11월 19일 릴리스 노트).
- Perplexity의 Teammates — 이제 Max 구독자는 웹의 모든 Computer 작업에서 팀원을 만들고, 같은 대화에서 이름, 역할, 아바타를 바꿀 수 있다. 🔗 출처
- Perplexity Mac 앱 — 속도가 빨라졌으며, 진행 중인 작업의 방향을 바꾸는 ‘지금 보내기’, 표와 Markdown 및 미리보기에서 검색하는 ⌘F, 닫은 탭을 다시 여는 ⌘⇧T가 추가됐다. 🔗 출처
생성형 영상 및 오디오
- Pika의 Seedance 2.5 Flash — Runway와 HeyGen에 이어 Pika가 여러 번의 시도가 필요한 작업을 위해 ByteDance 영상 모델의 빠른 변형을 추가했다. 480p 또는 720p로 최대 30초 영상을 만들 수 있고, 참조 자료로 이미지 최대 10개, 영상 5개, 오디오 클립 5개를 사용할 수 있다. 게시물에는 가격이 나와 있지 않다. 🔗 출처
- HeyGen의 Avatar 6 — 기술 보고서에서 가져온 새로운 블라인드 평가 결과다. 촬영 대상인 HeyGen 직원들이 자신과 가장 닮은 영상을 선택했을 때 Avatar 6는 Seedance 2.5를 상대로 86,5 %, Wan 3.0을 상대로 87,9 %의 선택률로 앞섰다. 이 평가는 HeyGen이 진행했다. 🔗 출처
- Together AI의 Qwen3 TTS — 공개 음성 합성 모델 Qwen3-TTS-12Hz-1.7B(Apache 2.0)를 100만 자당 20달러에 제공한다. 일상 언어 지시로 조절할 수 있는 목소리 9개와 프랑스어를 포함한 10개 언어를 지원하며, 최적 조건에서는 첫 소리가 97 ms 만에 나온다. 🔗 출처
인프라 및 연구
- Together Storage Accelerator — Together AI가 모든 GPU 클러스터에 S3 스토리지와 Hugging Face Hub용 NVMe 캐시를 제공하며, 코드 변경은 필요 없다. 자체 측정에 따르면 Cloudflare R2에서 2 GiB 파일을 읽는 시간이 12,7
15,0초에서 0,640,72초로 줄고, 노드 200개로 구성된 클러스터도 원본에서 한 번만 다운로드한다. 🔗 출처 - Hugging Face의 CDN — 공동 창업자 줄리앙 쇼몽에 따르면 Hugging Face는 매달 약 1엑사바이트의 공개 모델과 데이터셋을 제공하며, AI 다운로드를 위한 자체 콘텐츠 전송망(CDN)을 구축했다. 🔗 출처
- basecompute의 Superfluid — 이제 로컬 서버가 Apple, AMD, NVIDIA 기기에 추론을 분산한다. 개발사에 따르면 모의 사용자 64명을 대상으로 기기 6대가 초당 출력 토큰 처리량을 112개에서 534개로 높였으며, 노드 하나를 종료해도 요청이 하나도 유실되지 않는다. 🔗 출처
- WavLate — 후기 상호작용 방식의 이 공개 모델은 텍스트로 소리를, 소리로 텍스트를 검색하며, 소리 0,31초마다 벡터 하나를, 단어마다 벡터 하나를 사용한다. 개발자는 AudioCaps와 Clotho에서 평균 Recall@1 37,9를 기록해 비교한 공개 모델 9개 중 최고 성적을 냈다고 밝혔으며, 가중치와 데이터를 공개했다. 🔗 출처
- WorldTrace — NVIDIA Research가 재훈련 없이 대화형 영상 월드 모델에 적용할 수 있는 메모리를 소개했다(NeurIPS 2026 채택 논문). LoopBench에서 슬라이딩 윈도 대비 재방문 장면의 회상 성능이 32,6 % 향상됐으며, GPU 메모리 3,1 GB와 실행 시간 27 %가 추가로 필요하다. 🔗 출처
- 강화 학습용 Dynamo — NVIDIA가 Dynamo의 사후 학습 롤아웃 제공 방식을 설명했다. KV 캐시에 따른 라우팅, ModelExpress를 이용한 가중치 차분 전송, 실패한 작업 프로세스 복구가 포함된다. Microsoft AI, Cognition(SWE-1.7용), Prime Intellect, H Company가 사용하며, H Company는 학습 단계당 시간을 최대 20 % 절감했다. 🔗 출처
- 희소 어텐션 — NVIDIA가 11월 17일 가이드에서 자사 GPU로 학습하는 희소 어텐션의 설계 규칙 8가지를 제시했다. 토큰을 선택하는 인덱서와 Top-k가 128K 토큰에서 DeepSeek V3.2의 프리필 계층 하나에 드는 처리 비용의 47 %를 차지한다. 🔗 출처
GitHub
- GitHub Enterprise Server 3.23 출시 후보 버전 — 공개 사전 제공 중인 AI 비밀 정보 탐지 기능이 GPU, 호스팅된 LLM, 외부로 나가는 연결 없이 어플라이언스의 프로세서에서 실행되며, 망 분리(air-gapped) 환경에서도 작동한다. 이번 버전은 알려진 악성 패키지 탐지도 기존 npm 외에 생태계 7개를 추가로 지원한다. 🔗 출처
- AI 외 소식 — GitHub가 풀 리퀘스트의 새 개요 페이지에서 병합 상태를 더 명확히 표시하고, GitHub Desktop 3.7.0은 같은 호스트의 여러 계정을 지원하며, 대시보드에는 즐겨찾는 저장소를 최대 25개까지 표시한다. 🔗 개요 · 🔗 Desktop · 🔗 즐겨찾기
기업 및 에세이
- Hebbia — 8월과 9월에 진행한 금융 조사 테스트에서 GPT-6 Astra 사전 출시 버전은 인용 발췌문의 99,5 %가 관련성이 있었고, 표현 형식 요구 사항의 97,9 %를 충족했다. 이는 테스트한 대안 중 가장 좋은 모델보다 14,4%포인트 높은 수치이며, OpenAI가 공개한 사례 연구는 그 대안 모델의 이름을 밝히지 않았다. 🔗 출처
- 침묵의 합의 — OpenAI가 ‘지능의 시대’(지능의 시대) 섹션에 딘 볼의 에세이를 공개했다. 하버드 강연을 바탕으로 각색했으며 저자 개인의 견해를 반영한다고 명시한 이 글은, 인간의 우위를 포기하는 것이 불가피하다는 생각에 반대한다. 저자는 사람에게 귀속되고 권한이 제한적이며 철회 가능한 에이전트를 옹호한다. 🔗 출처
- 데이터 보강 — Perplexity 가이드가 웹에 연결된 모델로 CRM 기록을 보완하고 검증하는 방법을 6단계로 설명한다. 가이드에 따르면 Apollo는 Perplexity API로 매달 데이터 보강 5,6백만 건을 처리한다. 🔗 출처
이것이 의미하는 바
Anthropic의 기업공개 소식에는 자본시장의 자금과 산업계의 자금이 함께 등장한다. 공모를 통해 회사에 약 916억 달러의 총액이 유입되고, 사모 발행으로 260억 달러가 추가된다. 사모 발행에는 반도체 및 컴퓨팅 분야의 일곱 그룹인 AMD, Broadcom, Google, Micron, Microsoft, NVIDIA, TSMC Partners가 동일한 주당 83달러에 참여한다. 전체 조달 총액은 약 1,195억 달러에 이른다. 공모 투자자들과 함께 산업계의 일곱 그룹이 이제 Nasdaq에 상장된 인공지능 연구소의 주식을 사들이는 것이다.
보안은 점점 더 도구 자체의 작동 방식에 내장되고 있다. OpenAI는 GPT-6.2의 추론을 해당 추론을 생성한 대화 기록에 결부해 측정된 추출률을 54.0 %에서 0.2 %로 낮추지만, 개발자에게 더 이상 대화 기록을 다시 작성하지 않아야 한다는 제약을 부과한다. Vibe CLI는 에이전트가 확인 절차를 스스로 해제할 권한을 없애고, Claude Code는 폴더를 신뢰하기 전에 그 안의 hooks가 어디에서 왔는지 보여 주며, Decider는 에이전트가 페이지를 읽기 전에 점수를 매긴다. 한편 Sakana AI는 집단 방어 전담팀을 만들며, 취약점 악용 자료를 공개하지 않겠다고 약속한다.
에이전트는 코드 작성을 넘어 소프트웨어 배포 과정으로 진입하고 있다. Runway에서는 에이전트가 10월 병합의 38 %를 주도하고, 인공지능이 위험도가 낮은 변경 사항을 단독으로 승인한다. Stitch Loop는 운영 중인 제품을 모니터링하며 측정 가능한 목표를 달성하기 위해 pull requests를 생성한다. 두 경우 모두 중요한 부분의 통제권은 사람이 유지한다. Runway에서는 민감한 영역을, Stitch Loop에서는 모든 병합을 사람이 통제한다. 도구도 이에 발맞춘다. Python용 Agents SDK는 Codex를 모델 제공자로 사용할 수 있게 하고, Cognition은 이러한 과정에서 제기되는 질문, 즉 해당 PR을 병합해야 하는지를 기준으로 모델을 평가한다.
개방형 모델 분야에서는 더 가벼운 가중치에서 무엇을 끌어낼 수 있는지에 노력이 집중된다. Inkling 2 Mini는 중간층을 세 차례 통과해 20 GB로 AA Index에서 Qwen3.8-27B와 동등한 성능을 내고, Hugging Face의 슈퍼 어댑터는 하나의 LoRA에 세 가지 전문화 기능을 담으며, Metric AI는 Qwen3.5를 바탕으로 아르메니아어 모델을 구축한다. 수치는 여전히 개발사들이 제시한 것이며, MedChemBench는 이러한 평가의 한계를 상기시킨다. OpenAI는 여기서 자사 모델만 평가하며, 모델들이 원본 논문을 이미 보았을 가능성도 배제하지 않는다.
출처
- 기업공개 완료 (Anthropic)
- X의 @AnthropicAI: 공동 창업자들
- Inkling 2 Mini (Thinking Machines)
- Inkling 2 Mini에 관한 Hugging Face 게시글
- Inkling-2-Mini (Hugging Face)
- Together AI의 Tencent Hy4
- Hy4에 관한 Tencent 발표문
- 대규모 어댑터 활용 (Hugging Face)
- X의 @yb2698: 슈퍼 어댑터
- Ayb 0.5 (Metric AI)
- OhanTTS (Metric AI)
- OhanASR (Metric AI)
- X의 @pcuenq: Depth Pro 2
- arXiv 논문 2611.26603: Depth Pro 2
- DepthPro2-L (Hugging Face)
- 적대적 증류 대응 (OpenAI)
- X의 @OpenAI: 적대적 증류
- X의 @hardmaru: 보안 연구 그룹
- 보안 연구 그룹 (Sakana AI)
- 소프트웨어 공장 구축 (Runway)
- Stitch Loop (Google)
- ChatGPT 릴리스 노트
- X의 @GeminiApp: GIF 지원 여부
- X의 @GeminiApp: Gemini의 GIF
- X의 @perplexity_ai: Chromium의 Computer
- openai-agents-python v1.0.0-alpha.1
- X의 @perplexitydevs: Context API의 Decider
- 기준에 따른 페이지 점수 평가 (Perplexity 문서)
- 인젝션 방어 실습 안내서 (Perplexity 문서)
- Claude Code v2.1.329
- Codex CLI 0.171.0
- Vibe CLI v3.1.4
- Devin의 Gemini 4 Neon (Cognition)
- X의 @cognition: Gemini 4 Neon
- MedChemBench 소개 (OpenAI)
- MedChemBench 논문 전문 (PDF)
- Ads Engine의 동영상 광고 변형 및 현지화 (ElevenLabs)
- Copilot CLI 1.0.115-2
- Codex CLI 0.173.0-alpha.2
- Gemini CLI, PR 30389
- Antigravity 변경 이력
- Qwen Code v0.28.1-preview.1
- Kimi Code 2.7.2
- mistral CLI 0.20.1
- 11월 20일 Replit 변경 이력
- X의 @cognition: Manim용 Devin Bot
- Gemini API 릴리스 노트
- 개인용 에이전트의 시간 인식과 비동기 입력 (OpenAI)
- X의 @OpenAIDevs: GPT-6.2의 대화 기록과 추론
- X의 @AskPerplexity: Computer에서 팀원 활용
- X의 @AskPerplexity: Mac 앱
- X의 @pika_labs: Seedance 2.5 Flash
- X의 @HeyGen: Avatar 6 블라인드 테스트
- Together AI의 Qwen3 TTS
- Together Storage Accelerator (Together AI)
- X의 @julien_c: Hugging Face의 CDN
- 여러 장비에서 운영하는 Superfluid (basecompute)
- WavLate (Hugging Face)
- X의 @NVIDIAAI: WorldTrace
- Dynamo와 RL rollouts (NVIDIA)
- NVIDIA GPU의 희소 어텐션 (NVIDIA)
- GitHub Enterprise Server 3.23 출시 후보 (GitHub 변경 이력)
- pull requests 개요 페이지 (GitHub 변경 이력)
- GitHub Desktop의 호스트별 다중 계정 지원 (GitHub 변경 이력)
- 대시보드의 즐겨찾는 저장소 (GitHub 변경 이력)
- Hebbia와 GPT-6 Astra (OpenAI)
- 침묵의 합의 (OpenAI)
- 인공지능 데이터 보강 (Perplexity)