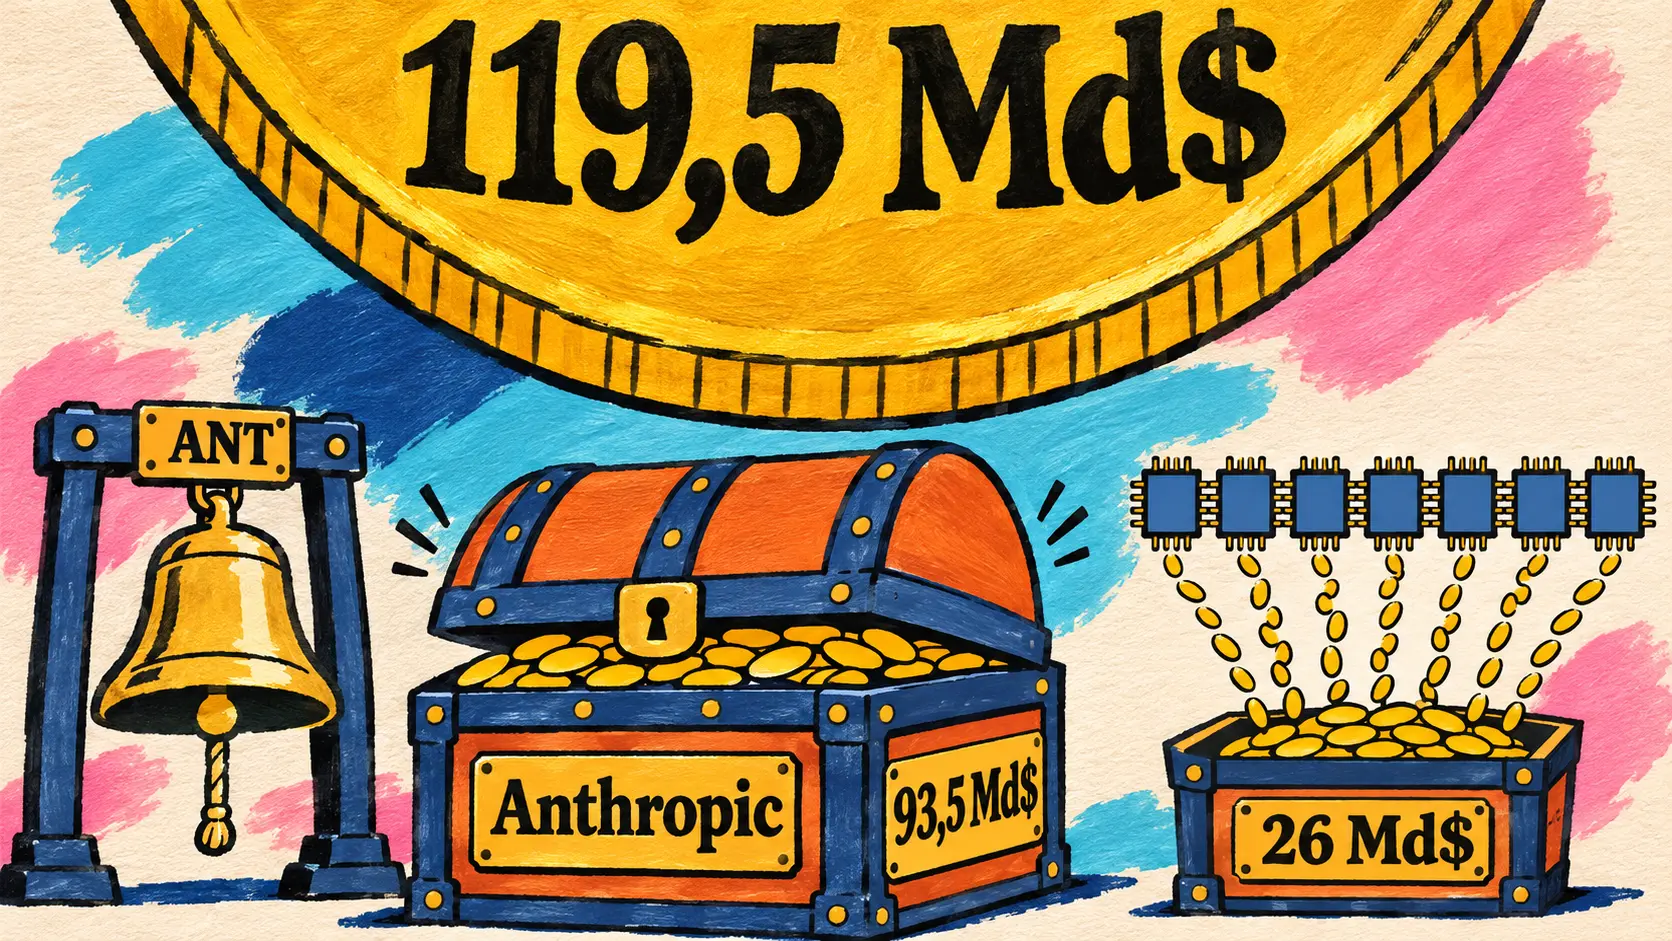
Anthropic clôture son introduction en bourse : environ 93,5 milliards de dollars bruts pour l’offre, et 26 milliards de plus versés par sept groupes, dont NVIDIA, Google et Microsoft, dans un placement privé mené en parallèle. Thinking Machines publie Inkling 2 Mini, un modèle à poids ouverts de 26,4 milliards de paramètres qui tient en 20 Go, et OpenAI ramène de 54,0 % à 0,2 % le taux de réussite des attaques qui extraient le raisonnement protégé de ses modèles. ChatGPT Space s’ouvre aux abonnés Plus, Runway confie à des agents 38 % de ses fusions de code, et Claude Code, Codex CLI et Vibe CLI publient chacun une nouvelle version.
Finance : Anthropic clôture son introduction en bourse, avec 93,5 milliards de dollars bruts et un placement privé de 26 milliards
20 novembre — Au lendemain de ses premières cotations, Anthropic annonce la clôture de son introduction en bourse, dont le prix avait été fixé le 18 novembre à 83 dollars par action. Les banques ont exercé en entier leur option sur 147 millions d’actions supplémentaires : au total, 1 127 000 000 actions de classe A ont été vendues. Le produit brut atteint environ 93,5 milliards de dollars avant commissions et frais, dont environ 91,6 milliards pour Anthropic, qui ne touche rien sur les 23 648 646 actions cédées par des actionnaires existants.
Le billet fait aussi état d’un placement privé mené en parallèle et clôturé lui aussi, dont l’annonce du prix ne parlait pas : 313 253 007 actions d’une classe N, vendues au même prix de 83 dollars à sept groupes des semi-conducteurs et de l’informatique (AMD, Broadcom, Google, Micron, Microsoft, NVIDIA et TSMC Partners), pour environ 26,0 milliards de dollars. Ces actions ne sont pas enregistrées au titre du Securities Act de 1933. En additionnant l’offre publique et ce placement, le montant brut approche 119,5 milliards de dollars, avant commissions et frais.
| Élément de l’opération | Valeur annoncée par Anthropic |
|---|---|
| Actions de classe A vendues | 1 127 000 000, dont 147 000 000 au titre de l’option des banques |
| dont vendues par Anthropic | 1 103 351 354 |
| dont actionnaires existants | 23 648 646 |
| Prix par action | 83 dollars |
| Produit brut de l’offre | environ 93,5 milliards de dollars |
| Part reçue par Anthropic | environ 91,6 milliards de dollars |
| Placement privé (classe N) | 313 253 007 actions, environ 26,0 milliards de dollars |
| Total brut, offre et placement | environ 119,5 milliards de dollars |
| Cotation | depuis le 19 novembre, Nasdaq Global Select Market, symbole ANT |
Le billet confirme la cotation, sans donner de cours ni de capitalisation. Goldman Sachs et Morgan Stanley ont mené l’opération, avec un syndicat d’une vingtaine de banques, dont J.P. Morgan, Citigroup, BNP Paribas, Crédit Agricole CIB et Société Générale. Le même jour, @AnthropicAI a publié une vidéo où les sept cofondateurs, Dario Amodei, Daniela Amodei, Tom Brown, Jack Clark, Jared Kaplan, Sam McCandlish et Chris Olah, racontent l’histoire de l’entreprise.
🔗 Clôture de l’introduction en bourse (Anthropic) · @AnthropicAI sur X : les cofondateurs
Modèles ouverts : Inkling 2 Mini de Thinking Machines, Tencent Hy4, un super-adaptateur pour Qwen3.8-27B, Ayb 0.5 et Depth Pro 2
20 novembre — Thinking Machines Lab publie Inkling 2 Mini, le petit frère d’Inkling 2 Small (594 milliards de paramètres, traité ici le 12 novembre). Ce mélange d’experts (Mixture-of-Experts) à poids ouverts, sous licence Apache 2.0, compte 26,4 milliards de paramètres, dont 3,4 milliards actifs par token. Il lit texte et images, avec un contexte d’un million de tokens. Ses poids sont livrés dans la précision de l’entraînement, NVFP4 pour vingt couches et MXFP8 pour les quatre dernières, soit environ 20 Go sans perte de conversion : il tourne avec Ollama sur tout Mac d’au moins 32 Go.
Today we are releasing Inkling 2 Mini, a fast, powerful model that’s small enough to run on your laptop.
🇫🇷 Nous publions aujourd’hui Inkling 2 Mini, un modèle rapide et puissant, assez petit pour tourner sur votre ordinateur portable. — Thinking Machines Lab, annonce d’Inkling 2 Mini
Sa particularité est architecturale : c’est un transformeur en boucle (looped transformer). Sur ses 24 couches, les 12 du milieu sont parcourues trois fois, soit 48 passages de couche par token pour 24 couches stockées, d’où 5,4 milliards d’activations de poids par token. En cours d’entraînement, le laboratoire a aussi élagué les deux tiers des experts (de 384 à 128), puis réparé le modèle avec 1 000 milliards de tokens distillés d’un modèle Inkling interne plus grand. Selon lui, à perte égale, un modèle sans boucle coûterait 7,5 % de calcul d’entraînement en moins, mais 140 % de calcul d’inférence en plus.
| Banc (tableau de Thinking Machines) | Inkling 2 Mini | Qwen3.8-27B | Nemotron 3.5 Super VL |
|---|---|---|---|
| Activations de poids par token / paramètres totaux | 5,4B / 26,4B | 27,0B / 27,0B | 12,0B / 124,5B |
| AA Index v5.0 | 20,1 | 20,1 | 13,6 |
| DeepSWE v1.1 | 48,2 % | 42,2 % | 24,7 % |
| SWE-bench Pro v2 Hard | 77,9 % | 73,8 % | 44,1 % |
| Terminal-Bench 2.1 (pi) | 71,6 % | 73,0 % | 60,7 % |
| BrowseComp | 79,0 % | 61,6 % | 78,9 % |
| MCP Atlas | 82,7 % | 77,3 % | 67,7 % |
Selon Thinking Machines, le modèle mène les modèles ouverts de moins de 100 milliards de paramètres sur DeepSWE v1.1 et sur le Vals Index v2.2 (46,5 %). Il reste derrière Qwen3.8-27B sur Terminal-Bench 2.1, et Thinking Machines reconnaît qu’il n’est pas le meilleur petit modèle en conversation multitour (50,0 % sur MultiChallenge) ni sur les consignes à contraintes multiples (33,4 % sur ComplexConstraints v1.1) ; la légende du graphique précise que les configurations d’évaluation varient d’un modèle à l’autre. Des chercheurs de Stanford, en accès anticipé, ont mesuré 0,703 d’intelligence par joule sur DGX Spark, contre 0,430 pour Qwen3.6-35B-A3B.
Le laboratoire en fait aussi un objet de recherche sur la surveillance de la chaîne de pensée (chain of thought) : un modèle bouclé calcule davantage sans l’écrire, ce qui pourrait échapper à un moniteur. Sur une variante à nombre de passes variable, publiée elle aussi, la tâche résolue sans raisonnement écrit passe de 16 à 37 secondes de travail humain entre une et trois passes. À cinq passes, le raisonnement est deux fois plus court (1 661 contre 3 703 tokens en moyenne sur GPQA Diamond) et reste aussi lisible ; Thinking Machines n’observe pas de hausse du sabotage agentique avec le nombre de boucles. Le modèle est disponible sur Tinker, Ollama, SGLang, vLLM, llama.cpp, MLX et Transformers, avec des versions GGUF chez Unsloth.
🔗 Inkling 2 Mini (Thinking Machines) · Billet de Hugging Face · Poids sur Hugging Face
Together AI sert Tencent Hy4, un mélange d’experts de 770 milliards de paramètres, à 0,83 dollar le million de tokens en entrée
19 novembre — Together AI ajoute Tencent Hy4 à son offre d’inférence sans serveur, avec un contexte d’un million de tokens, les appels d’outils et la sortie JSON. Selon l’hébergeur, le modèle phare de Tencent est un mélange d’experts de 770 milliards de paramètres, dont 49 milliards actifs par token ; il succède à Hy4 Preview, ajoute l’utilisation d’ordinateur et devient le premier de la famille Hy à lire des images.
| Tarif par million de tokens | Together AI | Tencent (communiqué du 4 novembre) |
|---|---|---|
| Entrée | 0,83 dollar | environ 0,90 dollar |
| Entrée en cache | 0,042 dollar | environ 0,045 dollar |
| Sortie | 2,50 dollars | environ 2,70 dollars |
Tencent avait lancé Hy4 le 4 novembre, en le présentant parmi les meilleurs modèles open source et en promettant les poids sous quelques jours ; le dépôt tencent/Hy4 est sur Hugging Face, sous une licence de type « other ». Son communiqué citait une évaluation financière en aveugle (213 professionnels, 579 tâches) où Hy4 obtenait 3,04, devant DeepSeek-V4.1-Flash-1017 (2,97), et un taux d’hallucination interne ramené de 12,95 % à 7,2 %.
🔗 Tencent Hy4 sur Together AI · Communiqué de Tencent du 4 novembre
Hugging Face publie la recette de ses harness adapters et un super-adaptateur unique pour Qwen3.8-27B
20 novembre — Après trois jours de publications, dont l’adaptateur Hermes traité ici hier, Hugging Face livre la recette complète de ses harness adapters : des LoRA entraînés par apprentissage par renforcement à l’intérieur d’un harnais d’agent (pi, Hermes Agent ou OpenCode), au-dessus de Qwen3.8-27B. La nouveauté est un super-adaptateur : les trois LoRA de rang 32 sont concaténés en un seul LoRA de rang 96, qui fonctionne dans les trois harnais. Leurs mises à jour étant quasi orthogonales (cosinus de 0,01 à 0,02), l’assemblage applique exactement les trois.
| SWE-bench Pro (51 tâches difficiles), avec réflexion | Modèle de base | Avec le super-adaptateur |
|---|---|---|
| Harnais Hermes Agent | 45 % | 61 % |
| Harnais OpenCode | 47 % | 67 % |
| Harnais pi | 74 % | 74 % |
Avec réflexion, la moyenne des six paires harnais-banc passe de 55,5 à 63,5 %, avec 19 à 48 % d’appels d’outils en moins, selon le fil de l’équipe ; sans réflexion, le super-adaptateur gagne 6 à 18 points sur SWE-bench Pro, avec 53 à 73 % d’appels d’outils en moins, selon le billet. Les scores ne se comparent pas d’un harnais à l’autre, leurs réglages par défaut différant. L’entraînement a demandé 598 étapes et 167 millions de tokens ; la garde safeagents a contrôlé 1,3 million d’appels d’outils et en a bloqué 647. Tâches, adaptateurs, GGUF et trajectoires d’évaluation sont publiés.
🔗 Harness adapters at scale (Hugging Face) · @yb2698 sur X
Metric AI publie Ayb 0.5, OhanTTS et OhanASR, des modèles ouverts de texte et de voix pour l’arménien
20 novembre — L’équipe arménienne Metric AI publie le même jour trois familles de modèles pour sa langue. Ayb 0.5 réunit trois modèles de langage (0,8B, 4B et 9B) construits sur Qwen3.5 et adaptés à l’arménien, du tokenizer étendu au post-entraînement ; Ayb-9B gère le dialogue multitour, l’appel d’outils et les images. OhanTTS-v0.1 synthétise la voix en huit langues, dont l’arménien et le français, et clone une voix à partir de 3 à 10 secondes d’audio. OhanASR-v0.1, modèle de reconnaissance vocale de 2B, est affiné sur 820 heures d’arménien.
| Modèle de Metric AI | Résultat publié par les auteurs |
|---|---|
| Ayb-9B | 3e d’ArmBench au général (0,6164) |
| OhanTTS-v0.1, 61 heures d’arménien | 14,70 % de WER, premier son en 331 ms sur une GB10 |
| OhanASR-v0.1 | 16,12 % de WER (2e) et 3,49 % de CER (1er) sur ArmBench-ASR |
Les poids d’Ayb-9B sont sous licence non commerciale (CC BY-NC 4.0) et accessibles après validation manuelle.
🔗 Ayb 0.5 (Metric AI) · OhanTTS · OhanASR
Apple publie Depth Pro 2, qui estime la profondeur en mètres sur les photos et les vidéos
19 novembre — Apple publie Depth Pro 2, une famille de modèles qui estiment la profondeur en mètres, sur des photos comme sur des vidéos, en résolution native. Selon le résumé de l’article, les méthodes existantes devaient choisir entre la cohérence d’une image à l’autre et la netteté des contours ; Depth Pro 2 vise les deux avec un seul réseau. Les poids sont sur Hugging Face en quatre tailles (S, B, L, H), avec une version Core ML et un estimateur de focale commun, utile quand la focale EXIF manque.
| Résolution traitée par DepthPro2-L (334M, sur B200) | Images par seconde |
|---|---|
| VGA | 150,1 |
| 720p | 33,7 |
| 1080p | 9,1 |
| 4K | 0,7 |
Les poids sont réservés à la recherche non commerciale (licence Apple Machine Learning Research Model), et le code est sur GitHub. La sortie a été signalée le 20 novembre par Pedro Cuenca, de Hugging Face, avec une démonstration en ligne.
🔗 @pcuenq sur X · Article arXiv 2611.26603 · DepthPro2-L (Hugging Face)
Sécurité des modèles : OpenAI contre la distillation adverse, Sakana AI crée son Security Research Group
OpenAI détaille sa lutte contre la distillation adverse et ramène de 54,0 % à 0,2 % l’extraction du raisonnement protégé
20 novembre — OpenAI publie un billet sur la distillation adverse (adversarial distillation) : l’usage non autorisé des sorties d’un modèle de pointe pour en entraîner un autre, déployé sans les mêmes garde-fous, par exemple pour des attaques que le modèle d’origine aurait refusées. Le billet vise d’abord le raisonnement protégé, la chaîne de pensée produite avant la réponse : selon une étude interne, un modèle élève progresse généralement davantage avec les traces de raisonnement exactes qu’avec leurs résumés.
| Attaque mesurée (évaluation adaptative, six modèles attaquants) | GPT-6 Astra, garde-fous d’origine | GPT-6.2 Astra, garde-fous mis à jour |
|---|---|---|
| Raisonnement d’une requête antérieure | 54,0 % | 0,2 % |
| Raisonnement de la requête courante | 22,9 % | 0,9 % |
La défense combine entraînement adverse, classifieurs d’entrée et de sortie (arguments d’appels d’outils compris), contrôles de l’API et enquêtes, avec des sanctions chaque semaine contre des campagnes de quelques milliers à quelques dizaines de milliers de comptes. Avec GPT-6.2 Astra et Sol, le raisonnement protégé est lié à l’historique qui l’a produit : l’API l’abandonne si un message antérieur est réécrit, et les familles de modèles plus anciennes ne peuvent plus le lire. OpenAI rappelle avoir signalé au Congrès, en février, une activité indiquant que DeepSeek tentait de distiller des modèles américains, puis attribué en septembre une campagne à des individus associés à Moonshot AI ; il dit soutenir le Chip Security Act, l’AI OVERWATCH Act et le MATCH Act.
🔗 Combatting adversarial distillation (OpenAI) · @OpenAI sur X
Sakana AI crée son Security Research Group, une équipe indépendante pour la cyberdéfense collective
20 novembre — Sakana AI lance son Security Research Group, une équipe de R&D indépendante installée à Tokyo, séparée de son activité commerciale et tournée vers l’intérêt public.
Excited to announce the Sakana AI Security Research Group, an independent, public-interest R&D team in Tokyo co-led by Akihiro Umegai and me.
🇫🇷 Ravi d’annoncer le Sakana AI Security Research Group, une équipe de R&D indépendante et d’intérêt public, à Tokyo, codirigée par Akihiro Umegai et moi. — @hardmaru sur X
David Ha est cofondateur et directeur général de Sakana AI. L’équipe travaillera sur trois axes : la prévention dès la conception, la défense collective par des agents répartis entre organisations, et la sécurisation des agents défenseurs eux-mêmes, dont l’autorité sera limitée à leur tâche et les actions tracées. Elle part de travaux maison comme Digital Red Queen, ShinkaEvolve et Fugu-Cyber, pour lequel Sakana AI annonce 86,9 % sur CyberGym et 72,1 % sur CTI-REALM ; une note du billet précise que la page de Fugu-Cyber ne donne ni scores de référence ni protocole d’évaluation. Elle publiera livres blancs, bancs d’essai et guides défensifs, mais pas de matériel d’exploitation, et les failles trouvées passeront par la divulgation coordonnée. Sakana AI rappelle que les demandes de CVE ont augmenté de 263 % entre 2020 et 2025, selon le NIST.
🔗 Security Research Group (Sakana AI)
Agents branchés sur la livraison logicielle : l’usine de Runway, Stitch Loop de Google Labs
Runway confie sa chaîne de livraison logicielle à des agents, qui ont piloté 38 % de ses fusions d’octobre
20 novembre — Runway publie sur son blog d’ingénierie le bilan chiffré de son « usine logicielle » (software factory) : sept étapes, de l’écriture du code à la coordination des fusions, confiées une à une à des agents. Les agents cloud ont piloté 38 % des pull requests fusionnées en octobre, et sur 100 de ces PR fusionnées dans la première moitié de novembre, 78 ne contenaient aucun commit humain.
| Indicateur de l’usine logicielle | Point de départ | Dernière mesure |
|---|---|---|
| Fusions pilotées par des agents cloud | 0,1 % (juin) | 38 % (octobre) |
| Attente médiane d’une première approbation | 2,3 h (septembre) | environ 5 min (mi-novembre) |
| Fusions hebdomadaires moyennes | 929 (septembre) | 2 235 (depuis mi-octobre) |
Depuis la mi-octobre, l’IA approuve seule les PR classées à risque faible, et à risque moyen si le dépôt l’autorise ; le risque élevé revient à une personne, et les propriétaires du code signent toujours les migrations, la configuration CI et de déploiement, les secrets et l’authentification. En septembre et octobre, une personne a contesté 15 des 977 PR approuvées par l’IA, et les fusions approuvées par l’IA seule ont un taux de retour arrière de 0,10 %, contre environ 1 sur 200 pour les approbations humaines. Des agents testent aussi App Studio comme un utilisateur (86 bogues confirmés en quatre jours), et un coordinateur a distribué plus de 14 000 tâches en deux semaines. Il s’agit d’outils internes, sans produit ni tarif.
🔗 Building a Software Factory (Runway)
Google Labs lance Stitch Loop, un agent produit qui améliore en continu une application en ligne
18 novembre — Google Labs présente Stitch Loop, un agent produit de longue durée qui reprend là où un agent de code s’arrête : après la mise en production. Il se branche sur le dépôt GitHub et sur les données du produit en ligne (journaux, comportement des utilisateurs, retours) par plus de 180 intégrations, des serveurs MCP personnalisés ou des envois depuis une CLI locale, et travaille en continu vers des objectifs mesurables.
Chaque boucle propose des pistes appuyées sur les données, détaille les solutions et leurs compromis, écrit le code dans un bac à sable cloud isolé et ouvre une pull request à approuver, puis observe les métriques en direct. Trois boucles sont fournies d’office (cybersécurité, latence, accessibilité) ; celle de sécurité associe Gemini 4 Carbon à CodeMender, l’agent de sécurité du code de Google DeepMind. Rien n’est fusionné sans relecture de l’équipe. Stitch Loop sert aussi de source de contexte produit à des agents de code comme Google Antigravity, par la CLI Stitch et MCP, et s’utilise dans Slack. Seule une liste d’attente est ouverte, dans le monde entier, avec un accès prioritaire pour les abonnés Google AI Ultra éligibles.
Assistants grand public : ChatGPT Space pour les abonnés Plus, des GIF dans l’application Gemini, Perplexity Computer dans les navigateurs Chromium
ChatGPT Space s’ouvre aux abonnés Plus du monde entier
20 novembre — ChatGPT Space, présenté au DevDay du 29 septembre et jusqu’ici réservé aux forfaits Pro, Business et Enterprise, se déploie dans le monde entier pour les abonnés Plus de 18 ans et plus. Space remplace la Bibliothèque dans la barre latérale (pages, diapositives, images, fichiers téléversés), sur le web, l’application de bureau, iOS et Android.
On y crée avec ChatGPT des pages interactives et des présentations, que d’autres personnes ayant accès à Space peuvent enrichir. Pages et diapositives peuvent se mettre à jour d’elles-mêmes depuis les applications connectées : OpenAI cite une liste de tâches qui s’actualise seule ou un plan de projet qui suit les décisions prises dans Slack. Une mention de ChatGPT dans un commentaire suffit pour demander une modification, et un dot peut être invité à collaborer. Le partage reste fermé : il faut une permission de lecture et un compte Plus, Pro, Business ou Enterprise avec accès à Space ; les comptes Free n’ouvrent pas les contenus partagés, et il n’existe pas de lien public.
L’application Gemini crée des GIF animés avec Gemini Omni 1.2 Flash, gratuitement en France
20 novembre — L’application Gemini crée désormais des GIF animés (effets photo en boucle, mèmes) avec Gemini Omni 1.2 Flash, le modèle vidéo lancé par Google le 5 novembre, pour un mouvement fluide et une qualité constante d’une image à l’autre, selon Google. On écrit sa demande dans le chat principal, ou l’on ouvre l’outil image ou vidéo, puis on choisit le format GIF dans le sélecteur de format.
GIFs are now available to all Google AI subscribers and free of charge in the U.S., Japan, Korea, Australia, Canada, U.K., Germany, and France.
🇫🇷 Les GIF sont désormais disponibles pour tous les abonnés Google AI, et gratuitement aux États-Unis, au Japon, en Corée, en Australie, au Canada, au Royaume-Uni, en Allemagne et en France. — @GeminiApp sur X
Les utilisateurs français sans abonnement y ont donc accès. Google suit OpenAI, dont les GIF animés dans ChatGPT avec Images 2.6 ont été traités ici le 5 novembre.
🔗 @GeminiApp sur X : les GIF dans Gemini
Perplexity Computer fonctionne directement dans les navigateurs Chromium grâce à l’extension Perplexity
20 novembre — Perplexity Computer fonctionne désormais directement dans les navigateurs basés sur Chromium, grâce à l’extension Perplexity. On confie une tâche depuis le panneau latéral de l’extension, puis on suit Computer pendant qu’il travaille dans les onglets et les outils de l’utilisateur. Le tweet d’annonce ne précise ni les forfaits concernés ni la liste des navigateurs pris en charge.
Deux précédents : le 5 octobre, l’application Mac 26.38.0 laissait Computer utiliser Chrome, Edge ou Brave grâce à une extension, et le 30 octobre, une extension Chrome reliait les applications Mac et Windows de Computer au navigateur de l’utilisateur. Cette fois, la tâche est confiée depuis le panneau latéral de l’extension, dans le navigateur.
API et SDK pour développeurs : Codex dans l’Agents SDK Python, Decider dans la Context API de Perplexity
L’Agents SDK Python d’OpenAI publie une préversion 1.0 qui fait de Codex un fournisseur de modèle
20 novembre — L’Agents SDK Python d’OpenAI ouvre sa série 1.0 par une préversion qui change d’approche : plutôt qu’un moteur natif séparé, comme dans la préversion 0.24 traitée ici le 16 novembre, Codex devient un fournisseur de modèle que l’on choisit à chaque exécution. On crée un CodexProvider et on le passe au Runner par RunConfig(model_provider=provider) ; l’agent tourne alors avec la connexion Codex enregistrée, ou avec une clé d’API.
La roue Python embarque Codex Core (rust-v0.166.0, non modifié) via PyO3 : le SDK appelle directement le cœur de Codex, sans lancer codex app-server ni passer par JSON-RPC. Les outils Python, les transferts vers un agent spécialiste (handoffs), l’approbation avant un outil et la sortie typée restent disponibles, et les commandes natives suivent le bac à sable et les règles d’approbation de Codex. Les roues 1.0.0a1 sont diffusées uniquement par GitHub Releases (Linux x86-64 et ARM64, macOS 11 et plus sur Apple silicon, Windows x64, CPython 3.10 à 3.14). Les sauvegardes de la préversion 0.24.0-alpha.8 ne sont pas compatibles avec le Runner, et la stable reste la 0.25.0 du 18 novembre.
🔗 openai-agents-python v1.0.0-alpha.1
Perplexity ajoute Decider à la Context API pour noter les pages, injections de prompt comprises
19 novembre — Perplexity ajoute Decider, son modèle de décision, à la Context API lancée deux jours plus tôt (1 dollar pour 1 000 URL). On peut poser jusqu’à cinq questions fermées (oui ou non) sur chaque page récupérée, et Decider note chaque réponse de 0 à 1. L’usage mis en avant touche à la sécurité : repérer une injection de prompt (prompt injection) dans une page avant qu’un agent ne la lise. Perplexity cite aussi la qualification de prospects, la modération et le repérage d’allégations de santé sans source.
L’API ne filtre rien elle-même : elle renvoie toutes les pages avec leurs scores, et c’est le code de l’application qui applique un seuil. Le score est facturé en tokens d’entrée de la Decisions API, en plus du prix par URL, et peut allonger la requête de 15 secondes au plus. Le cookbook de la documentation montre un contrôle exécuté le 18 novembre avec un seuil de 0,7 :
| Page testée (cookbook du 18 novembre) | Score d’injection | Décision du contrôle |
|---|---|---|
| Démonstration d’injection (Greshake et al., 2023) | 0,97 | mise en quarantaine |
| OWASP, page sur l’injection de prompt | 0,0018 | transmise |
| RFC 9111 | 0,0007 | transmise |
Le cookbook prévient qu’un score bas ne rend pas une page sûre : selon la recherche BrowseSafe++ de Perplexity, chaque modèle testé suivait encore certaines injections qu’il avait lui-même signalées.
🔗 Fil de @perplexitydevs · Documentation · Cookbook
Agents de code : Claude Code 2.1.329, Codex CLI 0.171.0, Vibe CLI 3.1.4 et Gemini 4 Neon dans Devin
Claude Code 2.1.329 signale l’origine des hooks à l’ouverture d’un dossier et regroupe les tâches planifiées dans /tasks
19 novembre — Claude Code 2.1.329 compte 130 entrées, dont 91 correctifs, 20 changements et 7 ajouts. Côté sécurité, la boîte de dialogue qui demande si l’on fait confiance à un dossier indique désormais où ses hooks sont déclarés, et Claude Desktop comme les autres hôtes non interactifs avertissent quand les hooks imposés par les réglages gérés (managed settings) ne se chargent pas. /tasks liste aussi les tâches planifiées de la session, les réveils de /loop, l’objectif en cours et les forks de la conversation ; la plupart des tâches planifiées enregistrées par les versions précédentes devront être replanifiées.
/code-review sans cible relit désormais, sur la plupart des modèles, toute la branche par rapport à la branche par défaut, et avec un numéro de PR il lit la PR elle-même par gh pr diff. Sur macOS, computer use passe à des règles de sécurité plus récentes, qui refusent certaines actions. La relance automatique ajoutée en 2.1.326 après une erreur max_tokens disparaît : derrière une passerelle, il faut régler CLAUDE_CODE_MAX_OUTPUT_TOKENS. Code Mode reçoit 17 entrées, dont la compatibilité avec les événements et métriques OpenTelemetry. La 2.1.330 est publiée sur npm depuis le 20 novembre.
Codex CLI 0.171.0 met GPT-6.2 Sol par défaut et active l’espace de travail du terminal
20 novembre — Codex CLI 0.171.0 est la première version stable depuis la 0.170.0 du 18 novembre et regroupe 339 pull requests. GPT-6.2 Sol et GPT-6.2 Astra entrent dans les catalogues de modèles, Sol étant sélectionné par défaut, et les commandes /rc et /remote gèrent depuis le terminal le contrôle à distance local et affichent les codes d’appairage des appareils.
Plusieurs nouveautés des préversions du 14 au 17 novembre passent en stable : l’espace de travail du TUI, activé par défaut, affiche aperçus de documents et d’images et transcriptions des sous-agents à côté de la conversation ; codex exec --remote lance ou reprend une session non interactive sur un serveur d’application existant ; le compositeur gagne annuler et rétablir ; /statusline choisit des lignes d’état fournies par un serveur MCP, derrière une option. Parmi les correctifs, brouillons et relances en file restent attachés à leur conversation, et la connexion MCP d’entreprise fonctionne avec les fournisseurs d’identité qui ne délivrent pas de jeton de rafraîchissement.
Vibe CLI 3.1.4 sépare l’agent de la politique d’approbation et retire aux agents le droit de lever les confirmations
20 novembre — Mistral publie Vibe CLI 3.1.4, deux jours après la 3.1.3 qui faisait de Mistral Large 4 le modèle par défaut. Ses 79 entrées (18 ajouts, 41 changements, 18 correctifs, 2 retraits) touchent d’abord les permissions : chaque session combine désormais deux réglages indépendants, un agent (default, lean ou personnalisé) et une politique d’approbation (ask, accept-edits, smart-approve ou auto-approve), choisie par --approval-policy ou default_approval_policy.
Un agent ne décide plus seul de ce qui s’exécute sans demander : ses réglages safety, bypass_tool_permissions et permission = "always" sont ignorés. Un projet ne peut plus redéfinir une politique d’approbation dans son dossier .vibe/agents/, et les forks comme les sessions filles héritent de la politique d’origine. L’interface gagne un « rail » de puces au-dessus de la saisie (sous-agents, tâches de fond, pull requests, objectif, tâches), un réglage keep_awake empêche la mise en veille pendant un tour, et Vibe accepte les certificats du système, ce qui l’aide à fonctionner derrière un proxy d’entreprise. Seules les 8 images les plus récentes sont désormais envoyées aux modèles Mistral, et les prompts de compaction personnalisés sont retirés.
Devin ouvre Gemini 4 Neon, à 46,2 % sur FrontierCode 2.0 pour 4,38 dollars par tâche
19 novembre (billet daté du 18) — Après Cursor et GitHub Copilot, traités ici hier, Cognition ouvre Gemini 4 Neon dans Devin Desktop et Devin CLI. Sur FrontierCode 2.0, son benchmark qui juge si une pull request mérite d’être fusionnée, Neon obtient 46,2 %, le meilleur résultat d’un modèle Google selon Cognition. Il se place à environ un point de Claude Opus 5.5 (47,3 %) pour environ un tiers du coût : 4,38 dollars par tâche contre 12,82 dollars.
| Modèle évalué sur FrontierCode 2.0 | Score publié par Cognition |
|---|---|
| Claude Fable 5.2 | 50,2 % |
| Claude Opus 5.5 | 47,3 % |
| Gemini 4 Neon | 46,2 % |
| GPT-6.2 Astra | 44,2 % |
| GPT-6.2 Sol | 43,8 % |
| Gemini 4 Carbon | 42,6 % |
Le coût correspond à la dépense moyenne par exécution au tarif catalogue de l’API, remises publiques incluses, et une solution qui échoue à un critère bloquant reçoit un score nul. Plusieurs scores de ce graphique diffèrent de valeurs publiées les semaines précédentes, sans explication dans le billet.
🔗 Gemini 4 Neon dans Devin (Cognition) · @cognition sur X
Science : OpenAI publie MedChemBench, un benchmark de chimie médicinale où GPT-6.2 Astra obtient 84,5 %
20 novembre — OpenAI présente MedChemBench, un benchmark qui mesure la capacité des modèles à raisonner comme un chimiste médicinal : relier la structure d’une molécule aux résultats expérimentaux, comparer des composés, prédire leurs propriétés. Il réunit 99 problèmes tirés de 117 articles et brevets, avec 761 structures moléculaires distinctes, et note quatre composantes : structures, raisonnement scientifique, sélection de composés et prédiction de propriétés.
| Modèle évalué (niveau de raisonnement xhigh) | Crédit obtenu |
|---|---|
| GPT-6.2 Astra | 84,5 % |
| GPT-6 Astra | 83,3 % |
| GPT-6.1 Sol | 82,0 % |
| GPT-6.1 Terra | 75,1 % |
| GPT-5.6 Sol | 58,2 % |
Le profil est inégal : GPT-6 Astra obtient 95,4 % du crédit sur les structures, mais environ la moitié sur la sélection de composés et la prédiction de valeurs numériques. OpenAI reste prudent : le benchmark porte sur des données historiques et n’établit pas que les modèles peuvent découvrir de nouveaux médicaments, une exposition préalable aux publications sources ne peut être exclue, et seuls des modèles GPT ont été évalués. Il fait suite à BioBasicsBench, traité ici le 6 novembre.
🔗 Introducing MedChemBench (OpenAI) · Article complet (PDF)
Vidéo et audio génératifs : ElevenLabs ajoute à Ads Engine des variantes de publicités sans nouveau tournage
20 novembre — ElevenLabs enrichit Ads Engine, son outil de création publicitaire intégré à ElevenCreative et lancé en juin. Branché aux comptes publicitaires Google, Meta, LinkedIn et désormais TikTok, il part des publicités existantes et de leurs résultats pour en produire des variantes sans nouveau tournage. Il repère l’accroche d’ouverture (hook) et en écrit de nouvelles d’après les publicités qui ont marché ; elles sont dites par une réplique numérique de la voix de l’orateur d’origine, avec synchronisation labiale et sous-titres mis à jour. De nouvelles bandes-son, composées par l’API ElevenLabs Music d’après le ton et le rythme des images, sont utilisables commercialement.
Pour la localisation, déjà assurée par Dubbing v2, Ads Engine recale désormais les lèvres de l’orateur sur la langue cible et remplace les sous-titres incrustés par une version traduite, au minutage et aux polices de la marque. Une relecture humaine reste possible avant diffusion, y compris par un professionnel natif de la localisation, et l’outil peut publier directement sur les plateformes. L’accès passe par l’équipe commerciale, sans tarif publié.
🔗 Variantes et localisation des publicités vidéo dans Ads Engine (ElevenLabs)
Brèves
Agents de code
- Copilot CLI 1.0.115-2 — Dans cette préversion de 351 entrées, dont 335 correctifs, Gemini 4 Hydrogen entre dans le sélecteur avec l’effort Extra High quand le compte y a accès, GPT-6.2 Astra est pris en charge, et
/modelgère aussi les modèles de fournisseurs personnalisés ; la stable reste la 1.0.114. 🔗 source - Codex CLI 0.173.0-alpha.1 et alpha.2 — Les notes de ces préversions sont vides ; d’après les titres des 71 commits, le partage des connexions MCP et la découverte OAuth des serveurs configurés passent en activation par défaut, et les administrateurs pourront désactiver les mises à jour du démon Codex. Le contenu peut changer avant la stable. 🔗 source
- Gemini CLI — Première nightly depuis le 4 novembre (v0.71.0-nightly.20261120) ; sur la branche principale,
gemini --resumerouvre la session la plus récemment utilisée et non la dernière démarrée, et les chemins commençant par~\sont enfin développés sous Windows. 🔗 source - Antigravity IDE 2.8.0 — L’éditeur de Google démarre son backend instantanément et vérifie ses mises à jour en arrière-plan, redirige automatiquement les ports pour la connexion à distance, cherche dans une conversation au clavier et accepte certificats personnalisés et proxy à la connexion. 🔗 source
- Qwen Code 0.28.1-preview.1 — Cette préversion de 179 entrées fait de GitHub le troisième adaptateur de canal géré, ajoute WeCom, Microsoft Teams et des webhooks sortants génériques configurables depuis l’interface web, et apporte au CLI une présentation pour lecteur d’écran ; la stable reste la v0.28.0. 🔗 source
- Kimi Code 2.7.1 et 2.7.2, Kimi Code Desktop 1.4.1 et 1.4.2 — Quatre versions correctives au lendemain de la 2.7.0 : l’effort de réflexion choisi dans un brouillon ne revient plus au défaut après l’envoi, et les forks n’échouent plus après la restauration d’une session réorientée en cours de tour. 🔗 source
- CLI mistral 0.20.1 —
mistral evals execsort désormais en échec (code 1) quand tous les appels d’une exécution ont échoué, par exemple sur une erreur 401, au lieu de la déclarer réussie ; une interruption par Ctrl-C est signalée comme telle. 🔗 source - Replit — Les espaces de travail (Workspaces) se recherchent et s’épinglent désormais, une option qui n’apparaît qu’à partir de cinq espaces. 🔗 source
- Devin Bot pour Manim — Cognition montre le Devin Bot que Grant Sanderson a mis en place pour l’aider sur Manim, le système d’animation open source des vidéos de 3Blue1Brown (96,6 k étoiles, 250 000 téléchargements par mois) ; le tweet ne précise ni les tâches confiées au bot ni ses résultats. 🔗 source
API et plateformes
- API Gemini — Depuis le 17 novembre, Gemini 3.5 Transcribe, en version classique comme en direct, modifie, réécrit et met en forme à la voix une dictée ou un texte existant (paramètre
source_text), et Google cite aussi la traduction. Depuis le 18, l’API permet de ne traiter, et de ne payer, que la partie utile des fichiers envoyés : plages de pages, onglets, cellules, intervalles de temps ou couches de contenu. 🔗 source - Conscience du temps dans l’API Agents — Une option expérimentale (
experimental={"time_awareness": True}) rappelle régulièrement l’heure au modèle pour qu’il adapte son travail à une échéance ; combinée aux outils asynchrones, elle permet à un agent de poser une question et de continuer à chercher en attendant la réponse, comme le montre un billet du blog développeurs d’OpenAI. 🔗 source - Historique des conversations avec GPT-6.2 — @OpenAIDevs demande de ne plus modifier les messages antérieurs dans la Responses API, car l’API abandonne le raisonnement qui suit la modification. Une nouvelle section Reasoning removals du tableau de bord Usage aide à le repérer, et le guide associé propose d’ajouter plutôt un élément
configuration_updateouadditional_toolspour changer l’effort ou les outils. 🔗 source
Assistants grand public
- ChatGPT déploie une nouvelle application mobile avec un onglet pour le dot et des favoris épinglés — Codex, Projects ou Images s’épinglent dans la barre d’onglets ; le déploiement commence par les Pro de 18 ans et plus là où les dots existent, hors Espace économique européen (UE comprise), Royaume-Uni, Suisse et Corée, et par un petit groupe de Plus (notes de version du 19 novembre, en lien plus haut).
- Teammates de Perplexity — Les abonnés Max peuvent désormais créer un teammate depuis n’importe quelle tâche Computer sur le web, puis changer son nom, son rôle ou son avatar dans la même conversation. 🔗 source
- Application Mac de Perplexity — Plus rapide, elle ajoute « Send now » pour réorienter une tâche en cours, ⌘F pour chercher dans les tableaux, le Markdown et les aperçus, et ⌘⇧T pour rouvrir un onglet fermé. 🔗 source
Vidéo et audio génératifs
- Seedance 2.5 Flash sur Pika — Après Runway et HeyGen, Pika ajoute la variante rapide du modèle vidéo de ByteDance pour les travaux à nombreuses prises : vidéos jusqu’à 30 secondes en 480p ou 720p, jusqu’à 10 images, 5 vidéos et 5 clips audio en référence ; le tweet ne donne pas de tarif. 🔗 source
- Avatar 6 de HeyGen — Nouveaux tests à l’aveugle tirés du rapport technique : quand les personnes filmées, des salariés de HeyGen, choisissent la vidéo qui leur ressemble le plus, Avatar 6 l’emporte à 86,5 % face à Seedance 2.5 et à 87,9 % face à Wan 3.0 ; ces évaluations sont menées par HeyGen. 🔗 source
- Qwen3 TTS chez Together AI — La synthèse vocale ouverte Qwen3-TTS-12Hz-1.7B (Apache 2.0) est servie à 20 dollars le million de caractères, avec neuf voix réglables par une consigne en langage courant, dix langues dont le français et un premier son en 97 ms au mieux. 🔗 source
Infrastructure et recherche
- Together Storage Accelerator — Together AI offre avec chaque grappe GPU un cache NVMe pour le stockage S3 et le Hub Hugging Face, sans changement de code ; selon ses mesures, un fichier de 2 Gio lu depuis Cloudflare R2 passe de 12,7 à 15,0 s à 0,64 à 0,72 s, et une grappe de 200 nœuds ne télécharge qu’une fois depuis l’origine. 🔗 source
- CDN de Hugging Face — Hugging Face sert près d’un exaoctet de modèles et de jeux de données ouverts par mois, selon son cofondateur Julien Chaumond, et a construit son propre réseau de distribution (CDN) pour les téléchargements d’IA. 🔗 source
- Superfluid de basecompute — Le serveur local répartit désormais l’inférence entre machines Apple, AMD et NVIDIA : six machines portent le débit de 112 à 534 tokens de sortie par seconde pour 64 utilisateurs simulés, et l’arrêt d’un nœud ne fait perdre aucune requête, selon l’éditeur. 🔗 source
- WavLate — Ce modèle ouvert d’interaction tardive cherche des sons par le texte et du texte par le son, avec un vecteur toutes les 0,31 seconde de son et un par mot ; son auteur annonce un Recall@1 moyen de 37,9 sur AudioCaps et Clotho, le meilleur des neuf modèles ouverts comparés, et publie poids et données. 🔗 source
- WorldTrace — NVIDIA Research présente une mémoire pour les modèles du monde vidéo interactifs, sans réentraînement (article accepté à NeurIPS 2026) : sur LoopBench, le rappel des scènes revisitées progresse de 32,6 % face à la fenêtre glissante, pour 3,1 Go de mémoire GPU et 27 % de temps d’exécution en plus. 🔗 source
- Dynamo pour l’apprentissage par renforcement — NVIDIA détaille comment Dynamo sert les rollouts du post-entraînement : routage selon le cache KV, transfert différentiel des poids avec ModelExpress, reprise des processus de travail défaillants. Microsoft AI, Cognition (pour SWE-1.7), Prime Intellect et H Company l’utilisent ; H Company gagne jusqu’à 20 % de temps par étape d’entraînement. 🔗 source
- Attention éparse — Dans un guide du 17 novembre, NVIDIA donne huit règles de conception pour l’attention éparse entraînée sur ses GPU ; l’indexeur qui choisit les tokens et le Top-k pèsent 47 % d’une couche de prefill de DeepSeek V3.2 à 128K tokens. 🔗 source
GitHub
- GitHub Enterprise Server 3.23 en release candidate — La détection de secrets par IA, en préversion publique, tourne sur le processeur de l’appliance, sans GPU, sans LLM hébergé ni connexion sortante, y compris en environnement isolé (air-gapped) ; la version étend aussi la détection de paquets malveillants connus à sept écosystèmes de plus que npm. 🔗 source
- Hors IA — GitHub clarifie l’état de fusion dans la nouvelle page Overview des pull requests, GitHub Desktop 3.7.0 accepte plusieurs comptes sur un même hôte, et le tableau de bord affiche jusqu’à 25 dépôts favoris. 🔗 Overview · 🔗 Desktop · 🔗 favoris
Entreprise et essais
- Hebbia — Dans ses tests de recherche financière d’août et septembre, une préversion de GPT-6 Astra cite 99,5 % d’extraits pertinents et respecte 97,9 % des exigences de présentation, 14,4 points devant la meilleure alternative testée, que l’étude de cas publiée par OpenAI ne nomme pas. 🔗 source
- The Silent Consensus — OpenAI publie dans sa rubrique L’ère de l’intelligence (Intelligence Age) un essai de Dean Ball, adapté d’une conférence à Harvard et présenté comme reflétant les vues de l’auteur, contre l’idée que l’abandon de la primauté humaine serait inévitable ; il plaide pour des agents rattachés à des personnes, aux permissions limitées et révocables. 🔗 source
- Enrichissement de données — Un guide de Perplexity décrit comment compléter et vérifier des fiches CRM avec un modèle relié au web, en six étapes ; Apollo y fait passer 5,6 millions d’enrichissements par mois par l’API de Perplexity. 🔗 source
Ce que ça signifie
L’introduction en bourse d’Anthropic réunit, dans un même billet, l’argent des marchés et celui de l’industrie. L’offre publique apporte environ 91,6 milliards de dollars bruts à l’entreprise, et le placement privé 26 milliards de plus, souscrits au même prix de 83 dollars par sept groupes des semi-conducteurs et de l’informatique : AMD, Broadcom, Google, Micron, Microsoft, NVIDIA et TSMC Partners. Au total, l’opération approche 119,5 milliards de dollars bruts : à côté des investisseurs de l’offre, sept groupes de l’industrie achètent des actions d’un laboratoire d’IA désormais coté au Nasdaq.
La sécurité se règle de plus en plus dans la mécanique même des outils. OpenAI attache le raisonnement de GPT-6.2 à l’historique qui l’a produit, ce qui fait tomber l’extraction mesurée de 54,0 % à 0,2 %, mais impose aux développeurs de ne plus réécrire leurs conversations. Vibe CLI retire aux agents le droit de lever eux-mêmes les confirmations, Claude Code montre d’où viennent les hooks d’un dossier avant qu’on lui fasse confiance, et Decider note les pages avant qu’un agent ne les lise. Sakana AI crée de son côté une équipe dédiée à la défense collective, en promettant de ne pas publier de matériel d’exploitation.
Les agents sortent de l’écriture du code pour entrer dans la chaîne de livraison. Chez Runway, ils pilotent 38 % des fusions d’octobre et l’IA approuve seule les changements à faible risque ; Stitch Loop surveille un produit en ligne et ouvre des pull requests pour atteindre un objectif mesuré. Dans les deux cas, une personne garde la main sur ce qui compte : les zones sensibles chez Runway, chaque fusion chez Stitch Loop. L’outillage suit : l’Agents SDK Python fait de Codex un fournisseur de modèle, et Cognition évalue les modèles sur la question que posent ces chaînes, à savoir s’il faut fusionner la PR.
Côté modèles ouverts, l’effort porte sur ce que l’on tire de poids plus légers. Inkling 2 Mini parcourt trois fois ses couches du milieu pour égaler Qwen3.8-27B à l’AA Index en 20 Go, le super-adaptateur de Hugging Face fait tenir trois spécialisations dans un seul LoRA, et Metric AI part de Qwen3.5 pour bâtir des modèles arméniens. Les chiffres restent ceux des éditeurs, et MedChemBench rappelle les limites de l’exercice : OpenAI n’y évalue que ses propres modèles et n’exclut pas qu’ils aient vu les publications sources.
Sources
- Clôture de l’introduction en bourse (Anthropic)
- @AnthropicAI sur X : les cofondateurs
- Inkling 2 Mini (Thinking Machines)
- Billet de Hugging Face sur Inkling 2 Mini
- Inkling-2-Mini (Hugging Face)
- Tencent Hy4 sur Together AI
- Communiqué de Tencent sur Hy4
- Harness adapters at scale (Hugging Face)
- @yb2698 sur X : le super-adaptateur
- Ayb 0.5 (Metric AI)
- OhanTTS (Metric AI)
- OhanASR (Metric AI)
- @pcuenq sur X : Depth Pro 2
- Article arXiv 2611.26603 : Depth Pro 2
- DepthPro2-L (Hugging Face)
- Combatting adversarial distillation (OpenAI)
- @OpenAI sur X : la distillation adverse
- @hardmaru sur X : le Security Research Group
- Security Research Group (Sakana AI)
- Building a Software Factory (Runway)
- Stitch Loop (Google)
- Notes de version de ChatGPT
- @GeminiApp sur X : disponibilité des GIF
- @GeminiApp sur X : les GIF dans Gemini
- @perplexity_ai sur X : Computer dans Chromium
- openai-agents-python v1.0.0-alpha.1
- @perplexitydevs sur X : Decider dans la Context API
- Score pages with criteria (documentation Perplexity)
- Cookbook anti-injection (documentation Perplexity)
- Claude Code v2.1.329
- Codex CLI 0.171.0
- Vibe CLI v3.1.4
- Gemini 4 Neon dans Devin (Cognition)
- @cognition sur X : Gemini 4 Neon
- Introducing MedChemBench (OpenAI)
- Article complet de MedChemBench (PDF)
- Variantes et localisation des publicités vidéo dans Ads Engine (ElevenLabs)
- Copilot CLI 1.0.115-2
- Codex CLI 0.173.0-alpha.2
- Gemini CLI, PR 30389
- Changelog d’Antigravity
- Qwen Code v0.28.1-preview.1
- Kimi Code 2.7.2
- CLI mistral 0.20.1
- Changelog de Replit du 20 novembre
- @cognition sur X : Devin Bot pour Manim
- Notes de version de l’API Gemini
- Time awareness and async input for personal agents (OpenAI)
- @OpenAIDevs sur X : historique et raisonnement de GPT-6.2
- @AskPerplexity sur X : teammates depuis Computer
- @AskPerplexity sur X : application Mac
- @pika_labs sur X : Seedance 2.5 Flash
- @HeyGen sur X : tests à l’aveugle d’Avatar 6
- Qwen3 TTS sur Together AI
- Together Storage Accelerator (Together AI)
- @julien_c sur X : le CDN de Hugging Face
- Superfluid en flotte (basecompute)
- WavLate (Hugging Face)
- @NVIDIAAI sur X : WorldTrace
- Dynamo et les rollouts de RL (NVIDIA)
- Attention éparse sur GPU NVIDIA (NVIDIA)
- GitHub Enterprise Server 3.23 release candidate (changelog GitHub)
- Page Overview des pull requests (changelog GitHub)
- GitHub Desktop et plusieurs comptes par hôte (changelog GitHub)
- Dépôts favoris sur le tableau de bord (changelog GitHub)
- Hebbia et GPT-6 Astra (OpenAI)
- The Silent Consensus (OpenAI)
- AI data enrichment (Perplexity)