ai-powered-markdown-translator本文由 gpt-6.1-sol 从法语翻译成中文。
Anthropic 完成首次公开募股:公开发行募集总额约为 935 亿美元,另有 NVIDIA、Google 和 Microsoft 等七家企业集团通过同步进行的私募投入 260 亿美元。Thinking Machines 发布 Inkling 2 Mini,这款开放权重模型拥有 264 亿参数,仅需 20 Go 内存即可运行;OpenAI 则将提取模型受保护推理过程的攻击成功率从 54,0 % 降至 0,2 %。ChatGPT Space 向 Plus 订阅用户开放,Runway 的代码合并中有 38 % 交由智能体完成,Claude Code、Codex CLI 和 Vibe CLI 也各自发布了新版本。
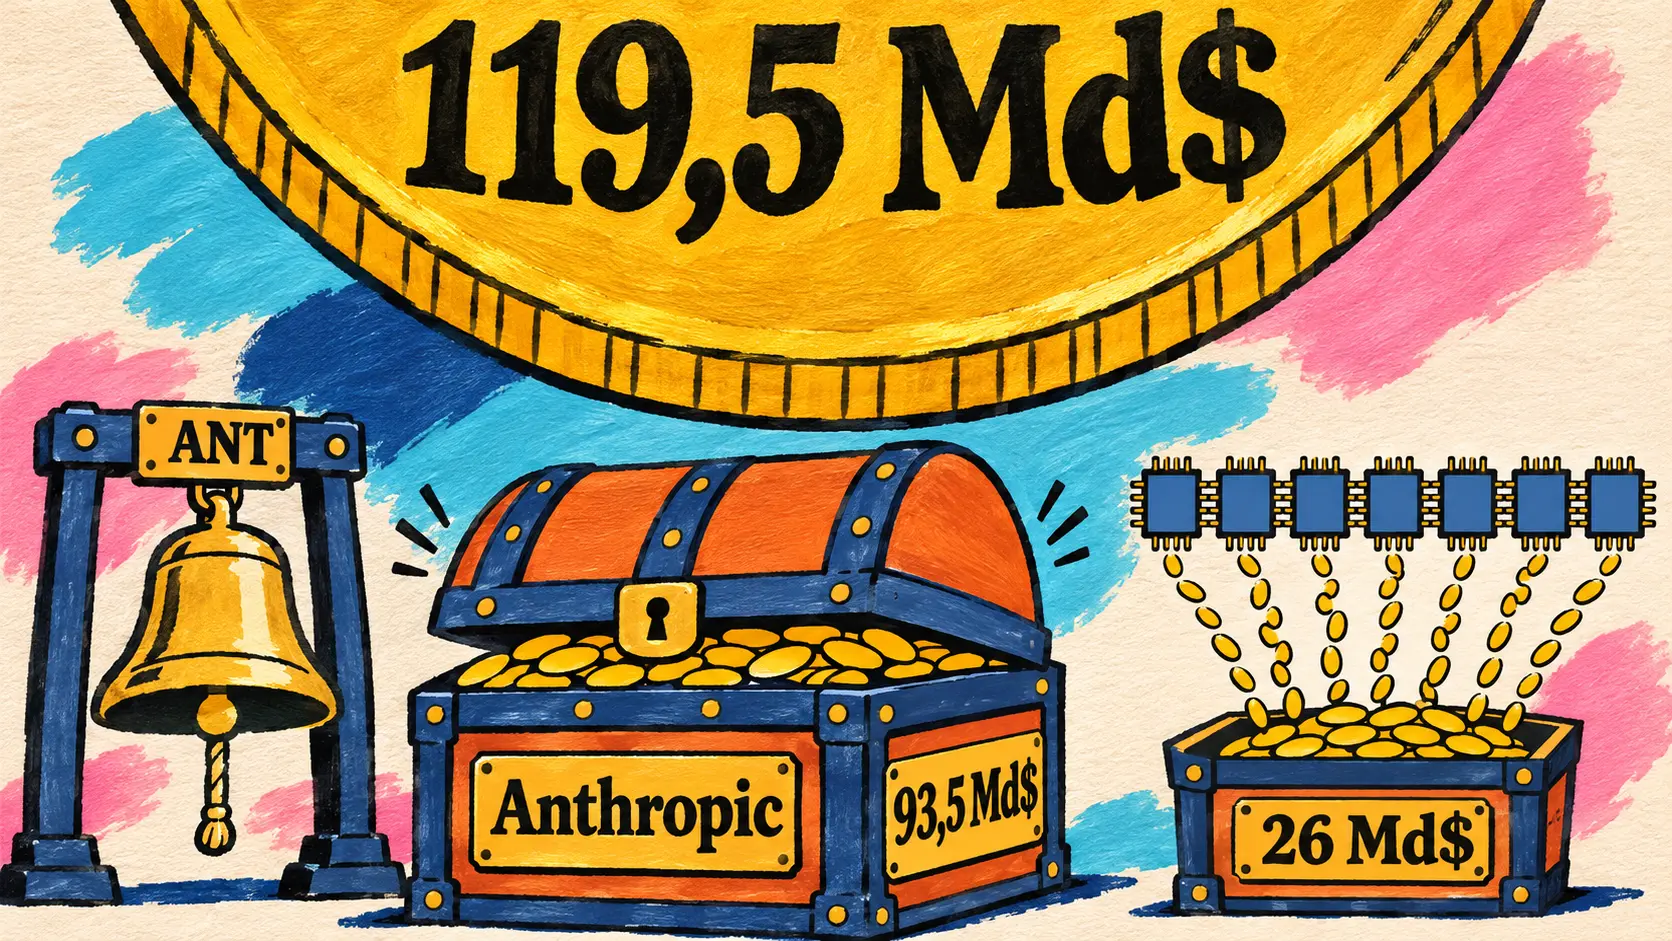
融资:Anthropic 完成首次公开募股,募集总额 935 亿美元,另获 260 亿美元私募融资
11 月 20 日 — 首次上市交易次日,Anthropic 宣布完成首次公开募股,其发行价已于 11 月 18 日确定为每股 83 美元。承销银行全额行使了额外购买 1.47 亿股的选择权:最终共售出 1 127 000 000 股 A 类股票。扣除佣金和费用前,募集总额约为 935 亿美元,其中 Anthropic 获得约 916 亿美元;现有股东出售的 23 648 646 股股票所得不归 Anthropic 所有。
公告还披露了一项同步进行且同样已经完成的私募,此前的定价公告并未提及:七家半导体和计算机行业企业集团(AMD、Broadcom、Google、Micron、Microsoft、NVIDIA 和 TSMC Partners)以同样的每股 83 美元价格,购入 313 253 007 股 N 类股票,总额约为 260 亿美元。这些股票未根据《1933 年证券法》注册。将公开发行与此次私募相加,扣除佣金和费用前的募集总额接近 1195 亿美元。
| 交易项目 | Anthropic 公布的数值 |
|---|---|
| 售出的 A 类股票 | 1 127 000 000,其中 147 000 000 股来自承销银行的选择权 |
| 其中由 Anthropic 出售 | 1 103 351 354 |
| 其中由现有股东出售 | 23 648 646 |
| 每股价格 | 83 美元 |
| 公开发行募集总额 | 约 93,5 十亿美元 |
| Anthropic 获得的部分 | 约 91,6 十亿美元 |
| 私募(N 类) | 313 253 007 股,约 26,0 十亿美元 |
| 公开发行与私募募集总额 | 约 119,5 十亿美元 |
| 上市交易 | 自 11 月 19 日起于 Nasdaq Global Select Market 交易,股票代码 ANT |
公告确认了上市交易情况,但未披露股价或市值。Goldman Sachs 和 Morgan Stanley 牵头此次发行,承销团包括约二十家银行,其中有 J.P. Morgan、Citigroup、BNP Paribas、Crédit Agricole CIB 和 Société Générale。同日,@AnthropicAI 发布了一段视频,七位联合创始人达里奥·阿莫代伊、达妮埃拉·阿莫代伊、汤姆·布朗、杰克·克拉克、贾里德·卡普兰、山姆·麦坎德利什和克里斯·奥拉在其中讲述了公司的发展历程。
🔗 首次公开募股完成公告(Anthropic) · @AnthropicAI 在 X 上发布的联合创始人视频
开放模型:Thinking Machines 的 Inkling 2 Mini、Tencent Hy4、Qwen3.8-27B 的超级适配器、Ayb 0.5 和 Depth Pro 2
11 月 20 日 — Thinking Machines Lab 发布 Inkling 2 Mini,它是 Inkling 2 Small 的小型版本(后者拥有 5940 亿参数,本站已于 11 月 12 日报道)。这款采用 Apache 2.0 许可证的开放权重混合专家模型(Mixture-of-Experts)共有 264 亿参数,每个 token 激活其中 34 亿参数。它支持读取文本和图像,上下文长度为一百万 token。权重以训练时的精度发布:前二十层使用 NVFP4,最后四层使用 MXFP8,总计约 20 Go,且无精度转换损失;任何内存至少为 32 Go 的 Mac 都可通过 Ollama 运行它。
Today we are releasing Inkling 2 Mini, a fast, powerful model that’s small enough to run on your laptop.
🇨🇳 我们今天发布 Inkling 2 Mini,这款模型速度快、能力强,体积小到足以在您的笔记本电脑上运行。 — Thinking Machines Lab,Inkling 2 Mini 发布公告
它的独特之处在于架构:这是一款循环变换器(looped transformer)。在总共 24 层中,中间 12 层会执行三遍,因此只存储 24 层,却能让每个 token 经历 48 次层计算,每个 token 的权重激活量达到 54 亿。训练过程中,实验室还裁剪了三分之二的专家(从 384 个降至 128 个),再使用从更大规模的内部 Inkling 模型中蒸馏出的 1 万亿 token 修复模型。据实验室称,在相同损失下,无循环模型所需的训练计算量会减少 7,5 %,但推理计算量会增加 140 %。
| 基准测试(Thinking Machines 表格) | Inkling 2 Mini | Qwen3.8-27B | Nemotron 3.5 Super VL |
|---|---|---|---|
| 每个 token 的权重激活量 / 总参数量 | 5,4B / 26,4B | 27,0B / 27,0B | 12,0B / 124,5B |
| AA Index v5.0 | 20,1 | 20,1 | 13,6 |
| DeepSWE v1.1 | 48,2 % | 42,2 % | 24,7 % |
| SWE-bench Pro v2 Hard | 77,9 % | 73,8 % | 44,1 % |
| Terminal-Bench 2.1 (pi) | 71,6 % | 73,0 % | 60,7 % |
| BrowseComp | 79,0 % | 61,6 % | 78,9 % |
| MCP Atlas | 82,7 % | 77,3 % | 67,7 % |
据 Thinking Machines 称,该模型在 DeepSWE v1.1 和 Vals Index v2.2(46,5 %)上领先所有参数量低于 1000 亿的开放模型。在 Terminal-Bench 2.1 上,它仍落后于 Qwen3.8-27B;Thinking Machines 也承认,它在多轮对话(MultiChallenge 上为 50,0 %)和多重约束指令(ComplexConstraints v1.1 上为 33,4 %)方面并非表现最好的小模型;图表说明还指出,各模型的评估配置有所不同。获得提前访问权限的斯坦福大学研究人员在 DGX Spark 上测得其每焦耳智能得分为 0,703,而 Qwen3.6-35B-A3B 为 0,430。
实验室也将其用于研究思维链(chain of thought)监控:循环模型可以在不写出过程的情况下进行更多计算,这可能逃过监控模型的检测。在同样公开的可变循环次数版本上,从一次循环增加到三次循环时,模型无需书面推理即可解决的任务,其对应的人类工作时长从 16 秒增加到 37 秒。循环五次时,推理文本缩短约一半(GPQA Diamond 上平均为 1 661 个 token,而非 3 703 个),且保持同样的可读性;Thinking Machines 未观察到智能体破坏行为随循环次数增加而上升。该模型已可通过 Tinker、Ollama、SGLang、vLLM、llama.cpp、MLX 和 Transformers 使用,Unsloth 还提供 GGUF 版本。
🔗 Inkling 2 Mini(Thinking Machines) · Hugging Face 博文 · Hugging Face 上的权重
Together AI 提供 Tencent Hy4 推理服务:7700 亿参数混合专家模型,输入价格为每百万 token 0.83 美元
11 月 19 日 — Together AI 将 Tencent Hy4 加入其无服务器推理服务,支持一百万 token 上下文、工具调用和 JSON 输出。据该服务商称,Tencent 这款旗舰混合专家模型共有 7700 亿参数,每个 token 激活 490 亿参数;它接替 Hy4 Preview,新增计算机操作能力,并成为 Hy 系列首款支持读取图像的模型。
| 每百万 token 价格 | Together AI | Tencent(11 月 4 日公告) |
|---|---|---|
| 输入 | 0,83 美元 | 约 0,90 美元 |
| 缓存输入 | 0,042 美元 | 约 0,045 美元 |
| 输出 | 2,50 美元 | 约 2,70 美元 |
Tencent 已于 11 月 4 日推出 Hy4,将其定位为表现最好的开源模型之一,并承诺在几天内发布权重;tencent/Hy4 仓库已上线 Hugging Face,许可证类型为“other”。其公告提到一项金融领域盲测(213 名专业人士、579 项任务),其中 Hy4 得分为 3,04,领先 DeepSeek-V4.1-Flash-1017(2,97);内部测得的幻觉率也从 12,95 % 降至 7,2 %。
🔗 Together AI 上的 Tencent Hy4 · Tencent 11 月 4 日公告
Hugging Face 公布执行框架适配器的完整方案,以及 Qwen3.8-27B 的单一超级适配器
11 月 20 日 — 经过连续三天的发布,包括本站昨天报道的 Hermes 适配器,Hugging Face 公布了执行框架适配器的完整方案:在 Qwen3.8-27B 之上,置于智能体执行框架(pi、Hermes Agent 或 OpenCode)中,通过强化学习训练 LoRA。此次新推出的是一个超级适配器:将三个秩为 32 的 LoRA 拼接为一个秩为 96 的 LoRA,可在全部三个框架中运行。由于它们的更新方向近乎正交(余弦相似度为 0,01 至 0,02),组合后能够完整应用三者的更新。
| SWE-bench Pro(51 项困难任务),启用思考 | 基础模型 | 使用超级适配器 |
|---|---|---|
| Hermes Agent 执行框架 | 45 % | 61 % |
| OpenCode 执行框架 | 47 % | 67 % |
| pi 执行框架 | 74 % | 74 % |
据团队发布的系列帖子,启用思考时,六组框架与基准测试组合的平均得分从 55,5 % 提升至 63,5 %,工具调用减少 19 % 至 48 %;据博文介绍,关闭思考时,超级适配器在 SWE-bench Pro 上提升 6 至 18 个百分点,工具调用减少 53 % 至 73 %。由于各框架的默认设置不同,不能跨框架直接比较分数。训练共进行了 598 步,使用 1.67 亿 token;safeagents 防护机制检查了 130 万次工具调用,并拦截其中 647 次。任务、适配器、GGUF 和评估轨迹均已公开。
🔗 大规模执行框架适配器(Hugging Face) · @yb2698 在 X 上的帖子
Metric AI 发布 Ayb 0.5、OhanTTS 和 OhanASR,为亚美尼亚语提供开放文本与语音模型
11 月 20 日 — 亚美尼亚团队 Metric AI 同日发布了面向本国语言的三组模型。Ayb 0.5 包含基于 Qwen3.5 构建的三款语言模型(0,8B、4B 和 9B),从扩展 tokenizer 到后训练均针对亚美尼亚语进行了适配;Ayb-9B 支持多轮对话、工具调用和图像。OhanTTS-v0.1 可合成包括亚美尼亚语和法语在内的八种语言的语音,并能根据 3 至 10 秒的音频克隆声音。OhanASR-v0.1 是一款 2B 语音识别模型,使用 820 小时的亚美尼亚语音频进行微调。
| Metric AI 模型 | 作者公布的结果 |
|---|---|
| Ayb-9B | ArmBench 总榜第 3 名(0,6164) |
| OhanTTS-v0.1,61 小时亚美尼亚语 | WER 为 14,70 %,在一块 GB10 上首段音频延迟为 331 ms |
| OhanASR-v0.1 | ArmBench-ASR 上 WER 为 16,12 %(第 2 名),CER 为 3,49 %(第 1 名) |
Ayb-9B 的权重采用非商业许可证(CC BY-NC 4.0),须经人工审核后方可访问。
🔗 Ayb 0.5(Metric AI) · OhanTTS · OhanASR
Apple 发布 Depth Pro 2,可从照片和视频中估计以米为单位的深度
11 月 19 日 — Apple 发布 Depth Pro 2,这组模型可在原生分辨率下,从照片和视频中估计以米为单位的深度。论文摘要指出,现有方法需要在帧间一致性与边缘清晰度之间取舍;Depth Pro 2 旨在通过单个网络兼顾两者。权重已在 Hugging Face 上以四种规模(S、B、L、H)发布,并提供 Core ML 版本及通用焦距估计器,后者可在缺少 EXIF 焦距信息时发挥作用。
| DepthPro2-L 处理的分辨率(334M,运行于 B200) | 每秒帧数 |
|---|---|
| VGA | 150,1 |
| 720p | 33,7 |
| 1080p | 9,1 |
| 4K | 0,7 |
权重仅限非商业研究使用(Apple Machine Learning Research Model 许可证),代码已发布于 GitHub。Hugging Face 的佩德罗·昆卡于 11 月 20 日介绍了此次发布,并提供了在线演示。
🔗 @pcuenq 在 X 上的帖子 · arXiv 论文 2611.26603 · DepthPro2-L(Hugging Face)
模型安全:OpenAI 对抗恶意蒸馏,Sakana AI 成立安全研究团队
OpenAI 详解如何打击对抗性蒸馏,将受保护推理的提取率从 54,0 % 降至 0,2 %
11月20日 — OpenAI 发文介绍对抗性蒸馏(adversarial distillation):未经授权,使用前沿模型的输出来训练另一个模型,后者在部署时不采用同样的安全防护,例如用于实施原模型本会拒绝的攻击。文章首先关注受保护的推理,即模型在回答前生成的思维链:根据一项内部研究,相比使用推理摘要,学生模型使用原始推理轨迹通常能获得更大的提升。
| 测量的攻击(自适应评估,六个攻击模型) | GPT-6 Astra,原有安全防护 | GPT-6.2 Astra,更新后的安全防护 |
|---|---|---|
| 先前请求的推理 | 54,0 % | 0,2 % |
| 当前请求的推理 | 22,9 % | 0,9 % |
防御措施结合了对抗训练、输入和输出分类器(包括工具调用参数)、API 管控及调查,每周都会对涉及数千至数万个账户的攻击活动采取处罚措施。在 GPT-6.2 Astra 和 Sol 中,受保护的推理与产生它的历史记录绑定:如果先前的消息被改写,API 就会丢弃该推理,较旧的模型系列也无法再读取它。OpenAI 提醒称,曾在2月向国会报告一些活动,表明 DeepSeek 正尝试蒸馏美国模型,随后在9月将一场活动归因于与 Moonshot AI 有关联的人员;公司表示支持《芯片安全法案》《人工智能监督法案》和《MATCH 法案》。
🔗 打击对抗性蒸馏(OpenAI) · @OpenAI 在 X 上
Sakana AI 成立 Security Research Group,以独立团队推动集体网络防御
11月20日 — Sakana AI 推出 Security Research Group,这是一支设在东京的独立研发团队,与其商业业务分开,以公共利益为导向。
Excited to announce the Sakana AI Security Research Group, an independent, public-interest R&D team in Tokyo co-led by Akihiro Umegai and me.
🇨🇳 很高兴宣布成立 Sakana AI Security Research Group,这是一支设在东京、以公共利益为导向的独立研发团队,由梅盖明宏和我共同领导。 — @hardmaru 在 X 上
大卫·哈是 Sakana AI 的联合创始人兼首席执行官。团队将围绕三个方向开展工作:从设计之初进行预防,通过分布在不同组织中的智能体开展集体防御,以及保障防御智能体自身的安全,将其权限限定在任务所需范围内,并记录其行动。团队以 Digital Red Queen、ShinkaEvolve 和 Fugu-Cyber 等内部研究为基础;Sakana AI 宣布,Fugu-Cyber 在 CyberGym 和 CTI-REALM 上的得分分别为 86,9 % 和 72,1 %,但文章的一则注释指出,Fugu-Cyber 页面并未提供基准分数或评估流程。团队将发布白皮书、基准测试和防御指南,但不发布漏洞利用材料,发现的漏洞则通过协调披露流程处理。Sakana AI 援引 NIST 数据指出,2020 年至 2025 年间,CVE 申请数量增长了 263 %。
🔗 Security Research Group(Sakana AI)
接入软件交付流程的智能体:Runway 的工厂与 Google Labs 的 Stitch Loop
Runway 将软件交付链交给智能体,10月 38 % 的合并由其主导
11月20日 — Runway 在工程博客上公布了其“软件工厂”(software factory)的量化成果:从编写代码到协调合并,七个环节逐一交由智能体负责。10月合并的拉取请求中,38 % 由云端智能体主导;11月上半月合并的 100 个此类 PR 中,有 78 个不包含任何人工提交。
| 软件工厂指标 | 起始值 | 最新测量值 |
|---|---|---|
| 云端智能体主导的合并 | 0,1 %(6月) | 38 %(10月) |
| 等待首次批准的中位时长 | 2,3 h(9月) | 约 5 min(11月中旬) |
| 平均每周合并数 | 929(9月) | 2 235(自10月中旬起) |
自10月中旬起,人工智能可独立批准被归为低风险的 PR;如果代码仓库允许,也可批准中等风险的 PR。高风险 PR 则由人工处理,迁移、CI 和部署配置、密钥及身份验证仍须由代码所有者签署批准。9月和10月,人工智能批准的 977 个 PR 中,有 15 个受到人工质疑;仅由人工智能批准的合并,其回滚率为 0,10 %,而人工批准的合并约每 200 次有 1 次回滚。智能体也会像用户一样测试 App Studio,四天内确认了 86 个缺陷;一个协调智能体则在两周内分配了超过 14 000 项任务。这些都是内部工具,没有对外产品或定价。
Google Labs 推出 Stitch Loop,以产品智能体持续改进已上线应用
11月18日 — Google Labs 介绍了 Stitch Loop,这是一款长期运行的产品智能体,在代码智能体完成工作后接手,也就是从产品上线后开始。它通过超过 180 种集成、自定义 MCP 服务器或本地 CLI 上传,连接 GitHub 代码仓库与线上产品数据(日志、用户行为、反馈),持续朝着可衡量的目标工作。
每轮循环都会基于数据提出方向,详细说明解决方案及其取舍,在隔离的云端沙箱中编写代码,并创建一个待批准的拉取请求,然后观察实时指标。默认提供三种循环:网络安全、延迟和无障碍;安全循环将 Gemini 4 Carbon 与 Google DeepMind 的代码安全智能体 CodeMender 结合使用。所有合并都须经过团队审查。Stitch Loop 还通过 Stitch CLI 和 MCP,为 Google Antigravity 等代码智能体提供产品上下文,也可在 Slack 中使用。目前仅在全球开放候补名单,符合条件的 Google AI Ultra 订阅用户可优先获得访问权限。
面向大众的助手:ChatGPT Space 向 Plus 订阅用户开放,Gemini 应用加入 GIF,Perplexity Computer 进入 Chromium 浏览器
ChatGPT Space 向全球 Plus 订阅用户开放
11月20日 — ChatGPT Space 于9月29日的 DevDay 上亮相,此前仅面向 Pro、Business 和 Enterprise 套餐,如今开始向全球年满 18 岁的 Plus 订阅用户推出。Space 在侧边栏中取代资料库,收纳页面、幻灯片、图片和上传的文件,覆盖网页版、桌面应用、iOS 和 Android。
用户可以与 ChatGPT 一起创建交互式页面和演示文稿,其他拥有 Space 访问权限的人也可以进一步完善这些内容。页面和幻灯片可根据已连接应用中的信息自行更新:OpenAI 举例提到,任务清单可以自动刷新,项目计划也能跟进 Slack 中作出的决定。在评论中提及 ChatGPT 即可请求修改,也可以邀请一个 dot 参与协作。分享仍受权限限制:查看者须拥有读取权限,以及已开通 Space 的 Plus、Pro、Business 或 Enterprise 账户;Free 账户无法打开共享内容,也没有公开链接。
Gemini 应用通过 Gemini Omni 1.2 Flash 生成动态 GIF,在法国免费开放
11月20日 — Gemini 应用现在可以使用 Gemini Omni 1.2 Flash 创建动态 GIF,包括循环照片特效和表情包。该视频模型由 Google 于11月5日推出,据 Google 表示,它能实现流畅运动,并保持帧间质量一致。用户可以在主聊天中输入需求,也可以打开图片或视频工具,然后在格式选择器中选择 GIF 格式。
GIFs are now available to all Google AI subscribers and free of charge in the U.S., Japan, Korea, Australia, Canada, U.K., Germany, and France.
🇨🇳 GIF 现已向所有 Google AI 订阅用户开放,并在美国、日本、韩国、澳大利亚、加拿大、英国、德国和法国免费提供。 — @GeminiApp 在 X 上
因此,法国未订阅的用户也可以使用。Google 紧随 OpenAI 推出这一功能;本站已于11月5日报道过 ChatGPT 通过 Images 2.6 生成动态 GIF 的功能。
🔗 @GeminiApp 在 X 上:Gemini 中的 GIF
Perplexity Computer 通过 Perplexity 扩展直接在 Chromium 浏览器中运行
11月20日 — Perplexity Computer 现在可以通过 Perplexity 扩展,直接在基于 Chromium 的浏览器中运行。用户从扩展的侧边栏下达任务,随后便可查看 Computer 在用户的标签页和工具中工作的过程。公告推文没有说明适用的套餐,也未列出受支持的浏览器。
此前已有两次相关更新:10月5日,Mac 应用 26.38.0 通过扩展让 Computer 能够使用 Chrome、Edge 或 Brave;10月30日,一款 Chrome 扩展将 Computer 的 Mac 和 Windows 应用连接到用户的浏览器。这一次,用户直接在浏览器内,从扩展侧边栏下达任务。
面向开发者的 API 和 SDK:Codex 加入 Python Agents SDK,Decider 接入 Perplexity Context API
OpenAI Python Agents SDK 发布 1.0 预览版,将 Codex 作为模型提供方
11月20日 — OpenAI Python Agents SDK 以一个预览版开启 1.0 系列,并改变了实现方式:与本站11月16日报道的 0.24 预览版所采用的独立原生引擎不同,Codex 现在成为每次运行时可选择的模型提供方。用户创建一个 CodexProvider,并通过 RunConfig(model_provider=provider) 将其传给 Runner;智能体随后便使用已保存的 Codex 登录连接或 API 密钥运行。
Python wheel 包通过 PyO3 内置了 Codex Core(rust-v0.166.0,未经修改):SDK 直接调用 Codex 核心,无须启动 codex app-server,也无须经过 JSON-RPC。Python 工具、向专门智能体移交任务(handoffs)、工具执行前审批和类型化输出仍然可用,原生命令则遵循 Codex 的沙箱和审批规则。1.0.0a1 wheel 包仅通过 GitHub Releases 分发,支持 Linux x86-64 和 ARM64、运行 macOS 11 及以上版本的 Apple silicon 设备、Windows x64,以及 CPython 3.10 至 3.14。0.24.0-alpha.8 预览版的存档与 Runner 不兼容,稳定版仍为11月18日发布的 0.25.0。
🔗 openai-agents-python v1.0.0-alpha.1
Perplexity 为 Context API 加入 Decider,对网页评分并识别提示注入
11月19日 — Perplexity 将其决策模型 Decider 加入两天前推出的 Context API,后者的价格为每 1 000 个 URL 收费 1 美元。用户可对每个获取的页面提出最多五个封闭式问题,答案为“是”或“否”,Decider 会对每项回答给出 0 至 1 的评分。重点展示的用途与安全有关:在智能体阅读页面前,识别其中的提示注入(prompt injection)。Perplexity 还提到潜在客户筛选、内容审核和识别无来源的健康主张等用途。
API 本身不会过滤任何内容:它会返回所有页面及其评分,由应用代码设置并执行阈值。评分按 Decisions API 的输入词元计费,费用叠加在按 URL 收取的费用之上,并可能使请求耗时最多增加 15 秒。文档中的实用指南展示了一次11月18日执行的检查,阈值设为 0,7:
| 测试页面(11月18日实用指南) | 注入评分 | 检查决定 |
|---|---|---|
| 注入演示(格雷沙克等,2023) | 0,97 | 隔离 |
| OWASP 关于提示注入的页面 | 0,0018 | 放行 |
| RFC 9111 | 0,0007 | 放行 |
实用指南提醒,低分并不意味着页面安全:根据 Perplexity 的 BrowseSafe++ 研究,每个受测模型仍会执行某些被其自身标记出的注入指令。
🔗 @perplexitydevs 的帖子串 · 文档 · 实用指南
代码智能体:Claude Code 2.1.329、Codex CLI 0.171.0、Vibe CLI 3.1.4,以及 Devin 中的 Gemini 4 Neon
Claude Code 2.1.329 在打开文件夹时显示钩子来源,并将计划任务集中到 /tasks
11月19日 — Claude Code 2.1.329 包含 130 条更新,其中有 91 项修复、20 项变更和 7 项新增功能。安全方面,询问是否信任文件夹的对话框现在会显示其中钩子的声明位置;当托管设置(managed settings)强制要求的钩子未能加载时,Claude Desktop 和其他非交互式宿主也会发出警告。/tasks 还会列出会话的计划任务、/loop 的唤醒任务、当前目标和对话分支;旧版本保存的大多数计划任务需要重新安排。
在大多数模型上,不指定目标的 /code-review 现在会对照默认分支审查整个分支;如果指定 PR 编号,则会通过 gh pr diff 读取 PR 本身。在 macOS 上,计算机操作功能改用更新的安全规则,会拒绝某些操作。2.1.326 中新增的 max_tokens 错误后自动重试功能被移除:通过网关使用时,需要设置 CLAUDE_CODE_MAX_OUTPUT_TOKENS。Code Mode 有 17 条更新,其中包括支持 OpenTelemetry 事件和指标。2.1.330 已于11月20日在 npm 发布。
Codex CLI 0.171.0 默认使用 GPT-6.2 Sol,并启用终端工作区
11月20日 — Codex CLI 0.171.0 是11月18日发布 0.170.0 后的首个稳定版,汇集了 339 个拉取请求。GPT-6.2 Sol 和 GPT-6.2 Astra 加入模型目录,其中 Sol 被设为默认模型;/rc 和 /remote 命令可在终端中管理本地远程控制,并显示设备配对码。
11月14日至17日预览版中的多项新功能进入稳定版:TUI 工作区默认启用,可在对话旁显示文档和图片预览,以及子智能体的对话记录;codex exec --remote 可在现有应用服务器上启动或恢复非交互式会话;输入编辑器新增撤销和重做功能;/statusline 可选择 MCP 服务器提供的状态行,该功能须通过选项启用。修复方面,草稿和队列中的重试会保持与所属对话关联,企业 MCP 连接也能使用不签发刷新令牌的身份提供方。
Vibe CLI 3.1.4 将智能体与审批策略分离,并取消智能体免除确认的权限
11 月 20 日 — Mistral 发布 Vibe CLI 3.1.4,距离将 Mistral Large 4 设为默认模型的 3.1.3 发布仅两天。此次更新的 79 条记录(18 项新增、41 项变更、18 项修复、2 项移除)首先涉及权限:每个会话现在组合使用两项独立设置,即智能体(default、lean 或自定义智能体)和审批策略(ask、accept-edits、smart-approve 或 auto-approve),后者通过 --approval-policy 或 default_approval_policy 选择。
智能体不再能自行决定哪些操作无需询问即可执行:其 safety、bypass_tool_permissions 和 permission = "always" 设置将被忽略。项目也不能再通过其 .vibe/agents/ 文件夹重新定义审批策略,派生会话和子会话都会继承原始策略。界面在输入框上方增加了一排标签(子智能体、后台任务、拉取请求、目标、任务),keep_awake 设置可防止设备在一轮运行期间进入睡眠,Vibe 还支持系统证书,有助于其在企业代理服务器后运行。现在只向 Mistral 模型发送最近的 8 张图片,并移除了自定义压缩提示词。
Devin 开放 Gemini 4 Neon:在 FrontierCode 2.0 上得分 46,2 %,每项任务费用 4,38 美元
11 月 19 日(博文标注日期为 18 日)— 继昨天在此报道的 Cursor 和 GitHub Copilot 之后,Cognition 在 Devin Desktop 和 Devin CLI 中开放 Gemini 4 Neon。在用于判断拉取请求是否值得合并的自有基准 FrontierCode 2.0 上,Neon 获得 46,2 % 的成绩,Cognition 称这是 Google 模型的最佳表现。它与 Claude Opus 5.5(47,3 %)相差约一个百分点,成本则约为后者的三分之一:每项任务 4,38 美元,而后者为 12,82 美元。
| 在 FrontierCode 2.0 上评测的模型 | Cognition 公布的得分 |
|---|---|
| Claude Fable 5.2 | 50,2 % |
| Claude Opus 5.5 | 47,3 % |
| Gemini 4 Neon | 46,2 % |
| GPT-6.2 Astra | 44,2 % |
| GPT-6.2 Sol | 43,8 % |
| Gemini 4 Carbon | 42,6 % |
成本指按 API 标价计算、包含公开折扣的每次运行平均费用;如果解决方案未满足任何一项硬性标准,得分即为零。图表中的多项得分与此前几周公布的数值不同,博文未作解释。
🔗 Devin 中的 Gemini 4 Neon(Cognition) · @cognition 在 X 上
科学:OpenAI 发布 MedChemBench,GPT-6.2 Astra 在这项药物化学基准中获得 84,5 %
11 月 20 日 — OpenAI 介绍了 MedChemBench,这项基准衡量模型能否像药物化学家一样推理:将分子结构与实验结果联系起来、比较化合物、预测其性质。它汇集了来自 117 篇论文和专利的 99 道问题,涉及 761 种不同的分子结构,并对四个部分评分:结构、科学推理、化合物选择和性质预测。
| 评测模型(推理级别为 xhigh) | 得分比例 |
|---|---|
| GPT-6.2 Astra | 84,5 % |
| GPT-6 Astra | 83,3 % |
| GPT-6.1 Sol | 82,0 % |
| GPT-6.1 Terra | 75,1 % |
| GPT-5.6 Sol | 58,2 % |
各项表现并不均衡:GPT-6 Astra 在结构部分获得 95,4 % 的分数,但在化合物选择和数值预测方面仅获得约一半分数。OpenAI 保持谨慎:该基准使用历史数据,不能证明模型能够发现新药,也无法排除模型此前接触过来源文献的可能性,而且仅评测了 GPT 模型。这项基准继承了 11 月 6 日在此报道的 BioBasicsBench。
🔗 MedChemBench 介绍(OpenAI) · 完整论文(PDF)
生成式视频与音频:ElevenLabs 为 Ads Engine 增加无需重新拍摄的广告变体
11 月 20 日 — ElevenLabs 为 Ads Engine 增添功能。这款广告创作工具集成于 ElevenCreative,于 6 月推出。它连接 Google、Meta、LinkedIn 以及新加入的 TikTok 广告账户,根据现有广告及其投放结果生成变体,无需重新拍摄。它会识别开场的吸引点(钩子),并参考表现良好的广告撰写新的开场文案;这些文案由原说话者声音的数字复制版朗读,同时更新口型同步和字幕。新配乐由 ElevenLabs Music API 根据画面的基调和节奏创作,可用于商业用途。
在本已由 Dubbing v2 提供的本地化功能中,Ads Engine 现在还会根据目标语言重新调整说话者的口型,并将内嵌字幕替换为译文,同时遵循品牌的字幕时间安排和字体。发布前仍可进行人工审校,包括由以目标语言为母语的本地化专业人员审校;工具也能直接向平台发布内容。使用该工具需要联系销售团队,尚未公布价格。
🔗 Ads Engine 中的视频广告变体与本地化(ElevenLabs)
简讯
代码智能体
- Copilot CLI 1.0.115-2 — 这个预览版包含 351 条记录,其中 335 项为修复;拥有访问权限的账户可在模型选择器中选择 Gemini 4 Hydrogen,并使用“超高”推理强度;它还支持 GPT-6.2 Astra,
/model也可处理自定义供应商的模型;稳定版仍为 1.0.114。🔗 来源 - Codex CLI 0.173.0-alpha.1 和 alpha.2 — 这两个预览版的发行说明为空;根据 71 次提交的标题,MCP 连接共享和已配置服务器的 OAuth 发现功能将默认启用,管理员也将能够禁用 Codex 守护进程的更新。稳定版发布前,内容仍可能变化。🔗 来源
- Gemini CLI — 自 11 月 4 日以来的首个每日构建版(v0.71.0-nightly.20261120);在主分支上,
gemini --resume会重新打开最近使用的会话,而非最后启动的会话,以~\开头的路径也终于能在 Windows 下展开。🔗 来源 - Antigravity IDE 2.8.0 — Google 的这款编辑器可即时启动后端,并在后台检查更新;它会为远程连接自动转发端口,支持通过键盘在对话中搜索,并在连接时支持自定义证书和代理服务器。🔗 来源
- Qwen Code 0.28.1-preview.1 — 这个包含 179 条记录的预览版将 GitHub 加入为第三个受支持的渠道适配器,新增 WeCom、Microsoft Teams 和可从网页界面配置的通用出站网络钩子,并为 CLI 提供适合屏幕阅读器的呈现方式;稳定版仍为 v0.28.0。🔗 来源
- Kimi Code 2.7.1 和 2.7.2,Kimi Code Desktop 1.4.1 和 1.4.2 — 在 2.7.0 发布次日推出的四个修复版本:草稿中选定的思考强度在发送后不再恢复默认值;恢复曾在一轮运行中被调整方向的会话后,派生会话也不再失败。🔗 来源
- mistral CLI 0.20.1 — 当一次运行中的所有调用均失败时,例如遇到 401 错误,
mistral evals exec现在会以失败状态退出(代码 1),不再将其报告为成功;通过 Ctrl-C 中断也会被明确标记为中断。🔗 来源 - Replit — 工作区(Workspaces)现在可以搜索和固定,此选项仅在拥有至少五个工作区时出现。🔗 来源
- 用于 Manim 的 Devin Bot — Cognition 展示了格兰特·桑德森部署的 Devin Bot,用于协助他开发 Manim。Manim 是 3Blue1Brown 视频所用的开源动画系统,拥有 96,6 k 个星标、每月 250 000 次下载;该帖文没有说明交给机器人的具体任务及其成果。🔗 来源
API 与平台
- Gemini API — 自 11 月 17 日起,Gemini 3.5 Transcribe 的常规版和实时版都支持通过语音修改、重写和排版口述内容或现有文本(参数
source_text),Google 还提到了翻译功能。自 18 日起,API 允许仅处理上传文件中的有效部分,并只为这些部分付费:页面范围、工作表、单元格、时间区间或内容层。🔗 来源 - Agents API 中的时间感知 — 一项实验性选项(
experimental={"time_awareness": True})会定期向模型提醒当前时间,使其根据截止时间调整工作;结合异步工具,智能体可以提出问题,并在等待答复时继续搜索,OpenAI 开发者博客的一篇文章展示了这一用法。🔗 来源 - GPT-6.2 的对话历史 — @OpenAIDevs 建议停止修改 Responses API 中此前的消息,因为 API 会丢弃修改位置之后的推理。用量仪表板新增的“推理移除”部分有助于发现这种情况,相关指南建议改为添加
configuration_update或additional_tools元素来调整推理强度或工具。🔗 来源
面向大众的助手
- ChatGPT 推出新版移动应用,增加 dot 标签页和固定收藏项 — Codex、Projects 或 Images 可固定到标签栏;首批推送面向已提供 dot 的地区中年满 18 岁的 Pro 用户,以及一小部分 Plus 用户,不包括欧洲经济区(含欧盟)、英国、瑞士和韩国(11 月 19 日的发行说明,链接见上文)。
- Perplexity 的 Teammates — Max 订阅用户现在可以从网页端的任意 Computer 任务创建一个队友,随后在同一对话中修改其名称、角色或头像。🔗 来源
- Perplexity 的 Mac 应用 — 运行速度更快,新增“立即发送”功能,可调整正在执行的任务方向;支持用 ⌘F 在表格、Markdown 和预览中搜索,以及用 ⌘⇧T 重新打开已关闭的标签页。🔗 来源
生成式视频与音频
- Pika 上的 Seedance 2.5 Flash — 继 Runway 和 HeyGen 之后,Pika 也加入了 ByteDance 视频模型的快速版本,适合需要大量尝试的创作:支持最长 30 秒的 480p 或 720p 视频,最多可参考 10 张图片、5 段视频和 5 段音频;帖文未提供价格。🔗 来源
- HeyGen 的 Avatar 6 — 技术报告公布了新的盲测结果:当被拍摄者,即 HeyGen 员工,选择最像自己的视频时,Avatar 6 面对 Seedance 2.5 的胜率为 86,5 %,面对 Wan 3.0 的胜率为 87,9 %;这些评测由 HeyGen 开展。🔗 来源
- Together AI 上的 Qwen3 TTS — 开放式语音合成模型 Qwen3-TTS-12Hz-1.7B(Apache 2.0)以每百万字符 20 美元的价格提供服务,包含九种可通过自然语言指令调节的声音,支持包括法语在内的十种语言,最快可在 97 ms 内输出首段声音。🔗 来源
基础设施与研究
- Together Storage Accelerator — Together AI 为每个 GPU 集群提供面向 S3 存储和 Hugging Face Hub 的 NVMe 缓存,无需修改代码;根据其测量,从 Cloudflare R2 读取一个 2 Gio 文件的耗时从 12,7 至 15,0 s 降至 0,64 至 0,72 s,且由 200 个节点组成的集群只需从源站下载一次。🔗 来源
- Hugging Face 的 CDN — 据联合创始人朱利安·肖蒙介绍,Hugging Face 每月分发近一艾字节的开放模型和数据集,并为人工智能下载服务构建了自己的内容分发网络(CDN)。🔗 来源
- basecompute 的 Superfluid — 这款本地服务器现在能够在 Apple、AMD 和 NVIDIA 机器之间分配推理任务:据开发商称,在模拟 64 名用户的测试中,六台机器将输出吞吐量从每秒 112 个词元提高到 534 个,关闭一个节点也不会丢失任何请求。🔗 来源
- WavLate — 这款开放的后期交互模型能够通过文本搜索声音,也能通过声音搜索文本,每 0,31 秒音频和每个词各生成一个向量;作者称其在 AudioCaps 和 Clotho 上的平均 Recall@1 为 37,9,是所比较的九个开放模型中表现最好的,并公开了权重和数据。🔗 来源
- WorldTrace — NVIDIA Research 介绍了一种用于交互式视频世界模型的记忆机制,无需重新训练(论文已被 NeurIPS 2026 接收):在 LoopBench 上,对重访场景的召回率比滑动窗口提高 32,6 %,代价是占用 3,1 Go 的 GPU 内存,并增加 27 % 的运行时间。🔗 来源
- 用于强化学习的 Dynamo — NVIDIA 详细介绍了 Dynamo 如何支持后训练中的轨迹生成:根据 KV 缓存路由、使用 ModelExpress 差分传输权重、恢复失效的工作进程。Microsoft AI、Cognition(用于 SWE-1.7)、Prime Intellect 和 H Company 均在使用;H Company 每个训练步骤的耗时最多减少 20 %。🔗 来源
- 稀疏注意力 — 在 11 月 17 日的一份指南中,NVIDIA 给出了在其 GPU 上训练稀疏注意力的八条设计规则;在 128K 词元长度下,选择词元的索引器和 Top-k 操作占 DeepSeek V3.2 一个预填充层耗时的 47 %。🔗 来源
GitHub
- GitHub Enterprise Server 3.23 候选发布版 — 处于公开预览阶段的人工智能机密信息检测功能在设备处理器上运行,无需 GPU、托管的大语言模型或出站连接,也能用于物理隔离环境(网络隔离);该版本还将已知恶意软件包检测从 npm 扩展至另外七个生态系统。🔗 来源
- 人工智能以外的更新 — GitHub 在新版拉取请求概览页面中更清晰地呈现合并状态,GitHub Desktop 3.7.0 支持在同一主机上使用多个账户,仪表板最多显示 25 个收藏仓库。🔗 概览 · 🔗 Desktop · 🔗 收藏
企业与随笔
- Hebbia — 在其 8 月和 9 月的金融研究测试中,GPT-6 Astra 的一个预览版所引用的摘录中有 99,5 % 具有相关性,对呈现要求的遵守率达到 97,9 %,比所测试的最佳替代模型高出 14,4 个百分点;OpenAI 发布的案例研究没有透露该替代模型的名称。🔗 来源
- 无声的共识 — OpenAI 在其“智能时代”(智能时代)栏目中发表了迪恩·鲍尔的一篇随笔,改编自他在哈佛的一场演讲,并注明仅反映作者观点。文章反对“放弃人类的主导地位不可避免”这一观点,主张让智能体归属于具体的人,其权限应受到限制且可随时撤销。🔗 来源
- 数据补全 — Perplexity 的一份指南分六步介绍了如何使用联网模型补全和核验 CRM 记录;Apollo 每月通过 Perplexity API 完成 5,6 百万次数据补全。🔗 来源
这意味着什么
Anthropic 的上市公告在同一篇文章中汇集了资本市场和产业界的资金。公开发行为公司带来约916亿美元的募资总额,私募配售则再带来260亿美元,由七家半导体和计算机行业集团以同样每股83美元的价格认购:AMD、Broadcom、Google、Micron、Microsoft、NVIDIA 和 TSMC Partners。此次交易的募资总额接近1195亿美元:除参与公开发行的投资者外,七家产业集团也买入了这家现已在 Nasdaq 上市的人工智能实验室的股票。
安全措施越来越多地融入工具本身的运作机制。OpenAI 将 GPT-6.2 的推理与产生该推理的历史记录绑定,使实测提取率从54.0%降至0.2%,但也要求开发者不再改写对话。Vibe CLI 取消了智能体自行解除确认要求的权限,Claude Code 会在用户信任某个文件夹之前展示其中 hooks 的来源,而 Decider 则在智能体读取页面之前对其评分。Sakana AI 也成立了专门负责集体防御的团队,并承诺不发布漏洞利用材料。
智能体正从编写代码走向整个交付流程。在 Runway,智能体主导了10月份38%的合并,人工智能会独立批准低风险变更;Stitch Loop 则监控线上产品,并为实现可衡量的目标而创建 pull requests。在这两种情况下,关键环节仍由人掌控:Runway 的敏感区域,以及 Stitch Loop 的每一次合并。工具也随之跟进:Python 版 Agents SDK 将 Codex 纳入模型提供方,Cognition 则围绕这些流程的核心问题评估模型,即是否应该合并这条 PR。
在开放模型方面,重点是从更轻量的权重中挖掘能力。Inkling 2 Mini 将中间层重复运行三次,以20 GB 的规模在 AA Index 上追平 Qwen3.8-27B;Hugging Face 的超级适配器将三种专长整合进一个 LoRA;Metric AI 则以 Qwen3.5 为基础构建亚美尼亚语模型。这些数字仍来自各开发商,而 MedChemBench 提醒人们注意此类评估的局限:OpenAI 在其中只评估了自家模型,也不排除这些模型曾接触过作为来源的论文。
来源
- 首次公开募股完成(Anthropic)
- X 上的 @AnthropicAI:联合创始人
- Inkling 2 Mini(Thinking Machines)
- Hugging Face 关于 Inkling 2 Mini 的博文
- Inkling-2-Mini(Hugging Face)
- Together AI 上的 Tencent Hy4
- Tencent 关于 Hy4 的公告
- 大规模使用适配器(Hugging Face)
- X 上的 @yb2698:超级适配器
- Ayb 0.5(Metric AI)
- OhanTTS(Metric AI)
- OhanASR(Metric AI)
- X 上的 @pcuenq:Depth Pro 2
- arXiv 论文 2611.26603:Depth Pro 2
- DepthPro2-L(Hugging Face)
- 应对对抗性蒸馏(OpenAI)
- X 上的 @OpenAI:对抗性蒸馏
- X 上的 @hardmaru:安全研究团队
- 安全研究团队(Sakana AI)
- 构建软件工厂(Runway)
- Stitch Loop(Google)
- ChatGPT 版本说明
- X 上的 @GeminiApp:GIF 的可用情况
- X 上的 @GeminiApp:Gemini 中的 GIF
- X 上的 @perplexity_ai:Chromium 中的 Computer
- openai-agents-python v1.0.0-alpha.1
- X 上的 @perplexitydevs:Context API 中的 Decider
- 根据标准为页面评分(Perplexity 文档)
- 防注入实用指南(Perplexity 文档)
- Claude Code v2.1.329
- Codex CLI 0.171.0
- Vibe CLI v3.1.4
- Devin 中的 Gemini 4 Neon(Cognition)
- X 上的 @cognition:Gemini 4 Neon
- MedChemBench 介绍(OpenAI)
- MedChemBench 完整论文(PDF)
- Ads Engine 中的视频广告变体与本地化(ElevenLabs)
- Copilot CLI 1.0.115-2
- Codex CLI 0.173.0-alpha.2
- Gemini CLI,PR 30389
- Antigravity 更新日志
- Qwen Code v0.28.1-preview.1
- Kimi Code 2.7.2
- mistral CLI 0.20.1
- Replit 11月20日更新日志
- X 上的 @cognition:用于 Manim 的 Devin Bot
- Gemini API 版本说明
- 个人智能体的时间感知与异步输入(OpenAI)
- X 上的 @OpenAIDevs:GPT-6.2 的历史记录与推理
- X 上的 @AskPerplexity:通过 Computer 使用 teammates
- X 上的 @AskPerplexity:Mac 应用
- X 上的 @pika_labs:Seedance 2.5 Flash
- X 上的 @HeyGen:Avatar 6 盲测
- Together AI 上的 Qwen3 TTS
- Together Storage Accelerator(Together AI)
- X 上的 @julien_c:Hugging Face 的 CDN
- 机群中的 Superfluid(basecompute)
- WavLate(Hugging Face)
- X 上的 @NVIDIAAI:WorldTrace
- Dynamo 与 RL 的 rollouts(NVIDIA)
- NVIDIA GPU 上的稀疏注意力(NVIDIA)
- GitHub Enterprise Server 3.23 候选发布版(GitHub 更新日志)
- pull requests 概览页面(GitHub 更新日志)
- GitHub Desktop 与同一主机上的多个账户(GitHub 更新日志)
- 仪表板上的收藏仓库(GitHub 更新日志)
- Hebbia 与 GPT-6 Astra(OpenAI)
- 无声的共识(OpenAI)
- AI 数据增强(Perplexity)