ai-powered-markdown-translatorgpt-6.1-solを使用してフランス語から日本語に翻訳された記事。
Anthropicが新規株式公開を完了した。公募・売出しによる総調達額は約935億ドルで、並行して実施した私募では、NVIDIA、Google、Microsoftを含む7グループがさらに260億ドルを出資した。Thinking Machinesは、パラメータ数264億、必要メモリ20 GBの重み公開モデルInkling 2 Miniを公開。OpenAIは、モデルの保護された推論を抽出する攻撃の成功率を54.0%から0.2%に引き下げた。ChatGPT SpaceはPlus加入者にも開放され、Runwayはコードのマージの38%をエージェントに任せている。Claude Code、Codex CLI、Vibe CLIも、それぞれ新バージョンを公開した。
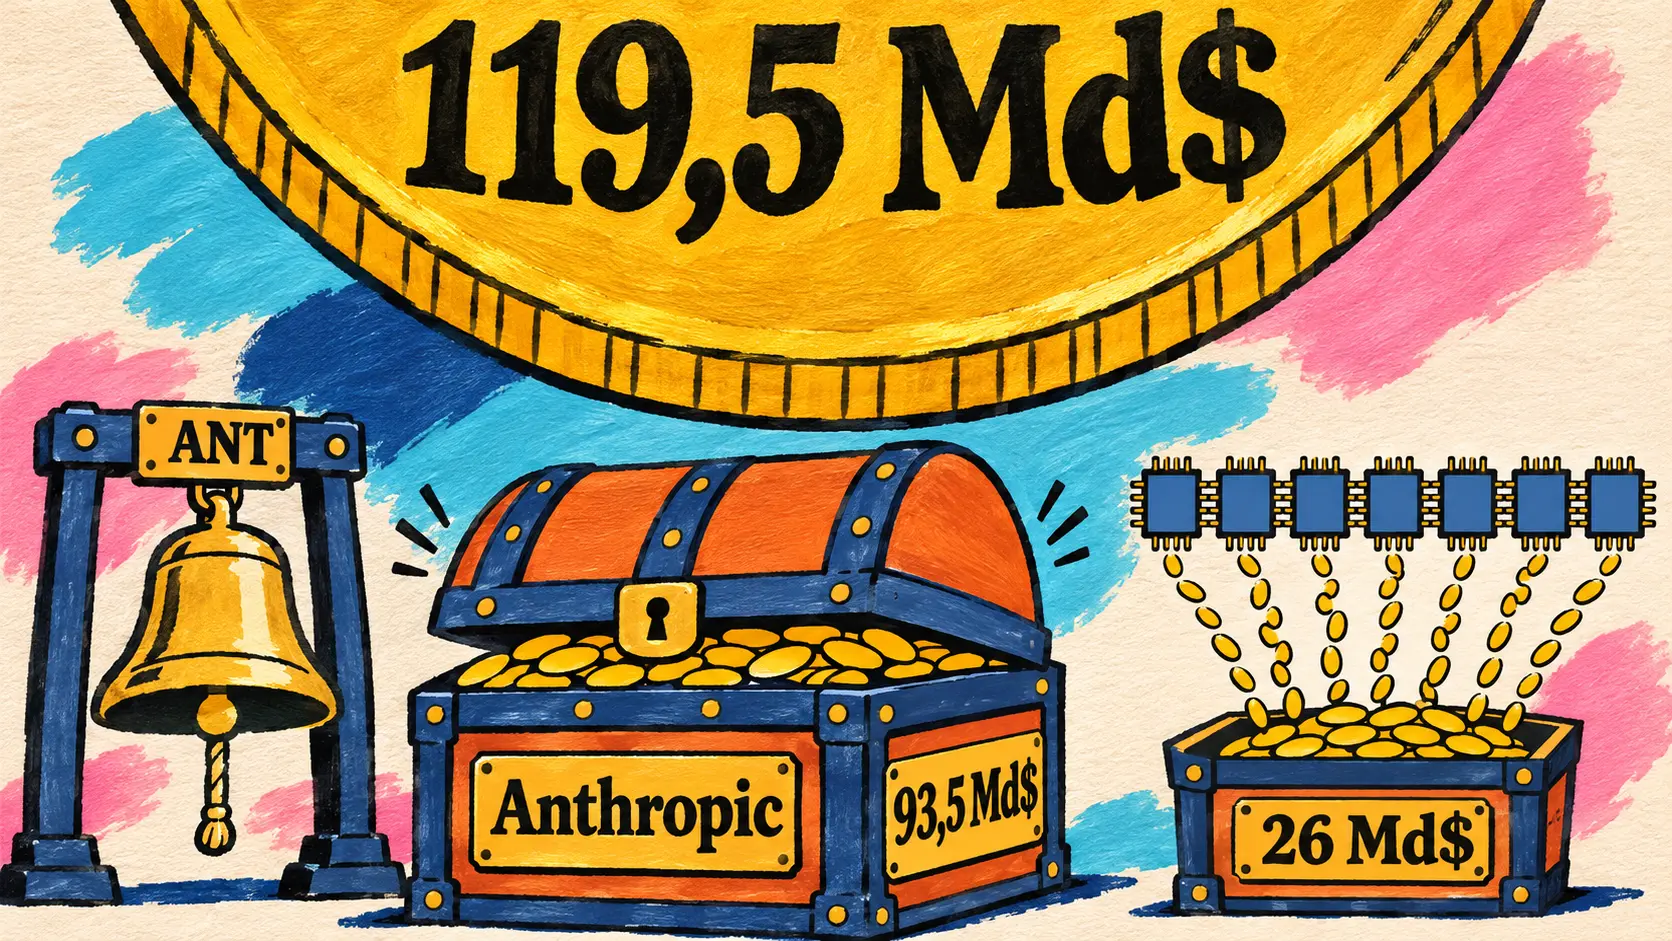
金融:Anthropicが新規株式公開を完了、公募・売出しの総額935億ドルと私募260億ドル
11月20日 — 株式の取引開始翌日、Anthropicは新規株式公開の完了を発表した。公開価格は11月18日に1株83ドルに決定していた。引受銀行は追加の1億4700万株を取得するオプションを全額行使し、売却されたクラスA株式は合計1 127 000 000株となった。手数料・費用控除前の総額は約935億ドルで、このうち約916億ドルがAnthropicに入る。既存株主が売却した23 648 646株について、同社は収入を得ない。
記事では、価格決定時の発表には記載されていなかった、並行実施の私募も完了したと報告している。半導体・コンピューティング分野の7グループ(AMD、Broadcom、Google、Micron、Microsoft、NVIDIA、TSMC Partners)に、同じ1株83ドルでクラスN株式313 253 007株を売却し、約260億ドルを調達した。これらの株式は1933年証券法に基づく登録を行っていない。公募・売出しと私募を合わせた手数料・費用控除前の総額は、約1195億ドルとなる。
| 取引の項目 | Anthropicの発表値 |
|---|---|
| 売却されたクラスA株式 | 1 127 000 000株、うち147 000 000株は引受銀行のオプション行使分 |
| うちAnthropicによる売却 | 1 103 351 354 |
| うち既存株主による売却 | 23 648 646 |
| 1株あたりの価格 | 83ドル |
| 公募・売出しの総額 | 約93,5十億ドル |
| Anthropicの受取額 | 約91,6十億ドル |
| 私募(クラスN) | 313 253 007株、約26,0十億ドル |
| 公募・売出しと私募の総額 | 約119,5十億ドル |
| 上場 | 11月19日から、Nasdaq Global Select Market、銘柄コードANT |
記事は上場を確認しているが、株価や時価総額は示していない。Goldman SachsとMorgan Stanleyが取引を主導し、J.P. Morgan、Citigroup、BNP Paribas、Crédit Agricole CIB、Société Généraleなど約20行の引受団が参加した。同日、@AnthropicAIは、共同創業者7人のダリオ・アモデイ、ダニエラ・アモデイ、トム・ブラウン、ジャック・クラーク、ジャレッド・カプラン、サム・マッキャンドリッシュ、クリス・オラーが同社の歩みを語る動画を公開した。
🔗 新規株式公開の完了(Anthropic) · @AnthropicAIのX投稿:共同創業者たち
オープンモデル:Thinking MachinesのInkling 2 Mini、Tencent Hy4、Qwen3.8-27B向けスーパーアダプター、Ayb 0.5、Depth Pro 2
11月20日 — Thinking Machines Labは、Inkling 2 Small(5940億パラメータ、本記事では11月12日に紹介)の小型版となるInkling 2 Miniを公開した。Apache 2.0ライセンスで重みを公開する混合エキスパート(Mixture-of-Experts)モデルで、総パラメータ数は264億、トークンごとの有効パラメータ数は34億。テキストと画像を読み取り、100万トークンのコンテキストに対応する。重みは学習時の精度のまま提供され、20層がNVFP4、最後の4層がMXFP8となっている。変換による損失なしで約20 GBに収まり、メモリ32 GB以上のすべてのMacでOllamaを使って実行できる。
Today we are releasing Inkling 2 Mini, a fast, powerful model that’s small enough to run on your laptop.
🇯🇵 本日公開するInkling 2 Miniは、高速かつ強力で、ノートパソコンでも動かせるほど小さなモデルです。 — Thinking Machines Lab、Inkling 2 Miniの発表
特徴はそのアーキテクチャにあり、ループ型トランスフォーマー(looped transformer)を採用している。24層のうち中央の12層を3回通過するため、保存する層数は24のまま、トークンごとに48層分を処理し、有効化される重みは延べ54億となる。学習中にはエキスパートの3分の2を削減し(384から128へ)、その後、より大型の社内Inklingモデルから蒸留した1兆トークンでモデルを修復した。同研究所によると、損失を同じにそろえた場合、ループを使わないモデルでは学習時の計算量が7.5%少なくなる一方、推論時の計算量は140%多くなるという。
| ベンチマーク(Thinking Machinesの表) | Inkling 2 Mini | Qwen3.8-27B | Nemotron 3.5 Super VL |
|---|---|---|---|
| トークンごとに有効化される重み数 / 総パラメータ数 | 5,4B / 26,4B | 27,0B / 27,0B | 12,0B / 124,5B |
| AA Index v5.0 | 20,1 | 20,1 | 13,6 |
| DeepSWE v1.1 | 48,2 % | 42,2 % | 24,7 % |
| SWE-bench Pro v2 Hard | 77,9 % | 73,8 % | 44,1 % |
| Terminal-Bench 2.1 (pi) | 71,6 % | 73,0 % | 60,7 % |
| BrowseComp | 79,0 % | 61,6 % | 78,9 % |
| MCP Atlas | 82,7 % | 77,3 % | 67,7 % |
Thinking Machinesによると、同モデルは1000億パラメータ未満のオープンモデルの中で、DeepSWE v1.1とVals Index v2.2(46.5%)で首位に立つ。一方、Terminal-Bench 2.1ではQwen3.8-27Bに及ばない。また、複数ターンの会話(MultiChallengeで50.0%)や複数の制約を含む指示(ComplexConstraints v1.1で33.4%)では、小型モデルの中で最高ではないとThinking Machinesも認めている。グラフの凡例には、評価設定がモデルごとに異なると明記されている。先行アクセスを得たスタンフォード大学の研究者は、DGX Spark上で1ジュールあたりの知能スコアを0.703と測定した。Qwen3.6-35B-A3Bでは0.430だった。
同研究所は、このモデルを思考連鎖(chain of thought)の監視に関する研究対象としても位置づけている。ループ型モデルは、推論を文章として書き出さずに計算を増やせるため、監視モデルがその処理を捉えられない可能性がある。同時に公開されたパス回数を変えられる派生モデルでは、推論を文章化せずに解けるタスクが、1回のパスでは人間の作業時間16秒相当だったのに対し、3回では37秒相当になった。5回のパスでは、推論の長さが約半分になり(GPQA Diamondで平均1,661トークン、比較対象は3,703トークン)、読みやすさも維持された。Thinking Machinesは、ループ回数の増加に伴うエージェントの妨害行為の増加を観測していない。モデルはTinker、Ollama、SGLang、vLLM、llama.cpp、MLX、Transformersで利用でき、UnslothからGGUF版も提供されている。
🔗 Inkling 2 Mini(Thinking Machines) · Hugging Faceの記事 · Hugging Faceで公開された重み
Together AIが7700億パラメータの混合エキスパートモデルTencent Hy4を提供、入力100万トークンあたり0.83ドル
11月19日 — Together AIは、サーバーレス推論サービスにTencent Hy4を追加した。100万トークンのコンテキスト、ツール呼び出し、JSON出力に対応する。同社によると、Tencentの主力モデルであるHy4は、総パラメータ数7700億、トークンごとの有効パラメータ数490億の混合エキスパートモデル。Hy4 Previewの後継で、コンピューター操作を追加し、Hyシリーズで初めて画像を読み取れるようになった。
| 100万トークンあたりの料金 | Together AI | Tencent(11月4日の発表) |
|---|---|---|
| 入力 | 0,83ドル | 約0,90ドル |
| キャッシュ済み入力 | 0,042ドル | 約0,045ドル |
| 出力 | 2,50ドル | 約2,70ドル |
Tencentは11月4日にHy4を公開し、最高水準のオープンソースモデルの一つと位置づけ、数日以内の重み公開を約束していた。Hugging Faceにはtencent/Hy4リポジトリがあり、ライセンス区分は「other」となっている。発表では、金融分野のブラインド評価(専門家213人、579タスク)でHy4が3.04を獲得し、DeepSeek-V4.1-Flash-1017(2.97)を上回ったことや、社内評価でのハルシネーション率を12.95%から7.2%に引き下げたことを挙げていた。
🔗 Together AIのTencent Hy4 · Tencentの11月4日の発表
Hugging Faceがハーネスアダプターの作成手順と、Qwen3.8-27B向けの単一スーパーアダプターを公開
11月20日 — 昨日ここで紹介したHermesアダプターを含む3日間の公開を経て、Hugging Faceはハーネスアダプターの作成手順をすべて公開した。Qwen3.8-27Bを基盤に、エージェントハーネス(pi、Hermes Agent、OpenCode)の内部で強化学習したLoRAである。今回の新要素はスーパーアダプターで、ランク32の3つのLoRAを、3種類すべてのハーネスで動作する単一のランク96のLoRAに連結する。それぞれの更新がほぼ直交している(コサイン類似度0.01~0.02)ため、統合後も3つの更新がそのまま適用される。
| SWE-bench Pro(難しいタスク51件)、思考あり | ベースモデル | スーパーアダプター適用後 |
|---|---|---|
| Hermes Agentハーネス | 45 % | 61 % |
| OpenCodeハーネス | 47 % | 67 % |
| piハーネス | 74 % | 74 % |
チームの投稿スレッドによると、思考ありでは、ハーネスとベンチマークの6通りの組み合わせの平均が55.5%から63.5%に上昇し、ツール呼び出しは19~48%減少した。記事によると、思考なしでは、スーパーアダプターがSWE-bench Proで6~18ポイントの改善をもたらし、ツール呼び出しを53~73%削減した。各ハーネスは既定の設定が異なるため、ハーネス間でスコアを比較することはできない。学習には598ステップ、1億6700万トークンを要した。safeagentsガードは130万回のツール呼び出しを検査し、647回をブロックした。タスク、アダプター、GGUF、評価時の実行軌跡が公開されている。
🔗 ハーネスアダプターの大規模展開(Hugging Face) · @yb2698のX投稿
Metric AIがアルメニア語向けのテキスト・音声オープンモデルAyb 0.5、OhanTTS、OhanASRを公開
11月20日 — アルメニアのチームMetric AIは、同日、アルメニア語向けの3つのモデルシリーズを公開した。Ayb 0.5は、Qwen3.5を基盤とし、トークナイザーの拡張から事後学習までアルメニア語に適応させた3つの言語モデル(0.8B、4B、9B)で構成される。Ayb-9Bは複数ターンの対話、ツール呼び出し、画像に対応する。OhanTTS-v0.1は、アルメニア語とフランス語を含む8言語で音声を合成し、3~10秒の音声から声を複製できる。2Bの音声認識モデルOhanASR-v0.1は、820時間のアルメニア語音声でファインチューニングされている。
| Metric AIのモデル | 著者らが公開した結果 |
|---|---|
| Ayb-9B | ArmBench総合3位(0,6164) |
| OhanTTS-v0.1、アルメニア語61時間 | WER 14,70 %、GB10で最初の音声まで331 ms |
| OhanASR-v0.1 | ArmBench-ASRでWER 16,12 %(2位)、CER 3,49 %(1位) |
Ayb-9Bの重みは非商用ライセンス(CC BY-NC 4.0)で提供され、手動承認後にアクセスできる。
🔗 Ayb 0.5(Metric AI) · OhanTTS · OhanASR
Appleが写真と動画の深度をメートル単位で推定するDepth Pro 2を公開
11月19日 — Appleは、写真と動画の深度を元の解像度でメートル単位で推定するモデルシリーズ、Depth Pro 2を公開した。論文の要旨によると、従来の手法ではフレーム間の一貫性と輪郭の鮮明さのどちらかを選ぶ必要があったが、Depth Pro 2は単一のネットワークで両立を目指す。Hugging Faceでは4つのサイズ(S、B、L、H)の重みが提供されている。Core ML版と共通の焦点距離推定器もあり、EXIFに焦点距離の情報がない場合に役立つ。
| DepthPro2-Lの処理解像度(334M、B200上) | 1秒あたりの画像数 |
|---|---|
| VGA | 150,1 |
| 720p | 33,7 |
| 1080p | 9,1 |
| 4K | 0,7 |
重みは非商用研究用途に限定されており(Apple Machine Learning Research Modelライセンス)、コードはGitHubで公開されている。Hugging Faceのペドロ・クエンカが11月20日に、オンラインデモとともに公開を紹介した。
🔗 @pcuenqのX投稿 · arXiv論文2611.26603 · DepthPro2-L(Hugging Face)
モデルの安全性:OpenAIが敵対的蒸留に対抗、Sakana AIがセキュリティ研究グループを設立
OpenAI、敵対的蒸留への対策を詳述し、保護された推論の抽出率を54,0 %から0,2 %に低減
11月20日 — OpenAIが敵対的蒸留(adversarial distillation)に関する記事を公開した。これは、最先端モデルの出力を無断で使って別のモデルを訓練し、同等の安全対策を備えずに運用する行為で、例えば元のモデルが拒否するような攻撃に利用される。記事はまず、回答の前に生成される思考の連鎖である、保護された推論に焦点を当てている。社内研究によると、生徒モデルは一般に、推論の要約よりも正確な推論過程を使った方が大きく性能を向上させる。
| 測定した攻撃(適応型評価、6つの攻撃モデル) | GPT-6 Astra、初期の安全対策 | GPT-6.2 Astra、更新後の安全対策 |
|---|---|---|
| 過去のリクエストの推論 | 54,0 % | 0,2 % |
| 現在のリクエストの推論 | 22,9 % | 0,9 % |
防御には、敵対的訓練、入力と出力の分類器(ツール呼び出しの引数も対象)、APIでのチェック、調査を組み合わせており、数千から数万のアカウントを使う活動に対して毎週制裁を科している。GPT-6.2 AstraとSolでは、保護された推論を、それを生成した履歴に結び付けている。過去のメッセージが書き換えられるとAPIはその推論を破棄し、旧世代のモデル系列は読み取れなくなる。OpenAIは、DeepSeekが米国のモデルの蒸留を試みていることを示す活動を2月に米議会へ報告し、その後9月には別の活動をMoonshot AIの関係者によるものと特定したと改めて説明した。また、Chip Security Act、AI OVERWATCH Act、MATCH Actを支持しているとしている。
🔗 敵対的蒸留への対抗(OpenAI) · Xの@OpenAI
Sakana AI、集団的なサイバー防衛に向けた独立チームSecurity Research Groupを設立
11月20日 — Sakana AIがSecurity Research Groupを発足させた。東京を拠点とする独立した研究開発チームで、商用事業から分離し、公益を目的とする。
Excited to announce the Sakana AI Security Research Group, an independent, public-interest R&D team in Tokyo co-led by Akihiro Umegai and me.
🇯🇵 アキヒロ・ウメガイと私が共同で率いる、東京を拠点とした公益目的の独立した研究開発チーム、Sakana AI Security Research Groupの発足を発表でき、うれしく思います。 — Xの@hardmaru
デビッド・ハはSakana AIの共同創業者兼最高経営責任者だ。チームは、設計段階からの予防、組織間に分散したエージェントによる集団防衛、防御エージェント自体の安全確保という3つの軸に取り組む。防御エージェントの権限は担当タスクに限定し、行動を記録する。基盤となるのはDigital Red Queen、ShinkaEvolve、Fugu-Cyberなどの自社研究で、Sakana AIはFugu-CyberについてCyberGymで86,9 %、CTI-REALMで72,1 %という成績を発表している。ただし記事の注記では、Fugu-Cyberのページには比較基準となるスコアも評価手順も記載されていないと説明している。チームはホワイトペーパー、ベンチマーク、防御の手引きを公開するが、脆弱性の悪用に使える資料は公開せず、発見した脆弱性は調整された開示手続きを通じて報告する。Sakana AIは、NISTによると2020年から2025年にかけてCVEの申請が263 %増加したことにも言及している。
ソフトウェアの開発・提供に組み込まれるエージェント:Runwayのファクトリー、Google LabsのStitch Loop
Runway、ソフトウェアの開発・提供工程をエージェントに委ね、10月のマージの38 %をエージェントが主導
11月20日 — Runwayがエンジニアリングブログで「ソフトウェアファクトリー」(software factory)の成果を数値で公表した。コードの作成からマージの調整まで、7つの工程を1つずつエージェントに委ねている。10月にマージされたプルリクエストの38 %をクラウドエージェントが主導し、11月前半にマージされたこうしたPRのうち100件を見ると、78件には人間によるコミットが一切含まれていなかった。
| ソフトウェアファクトリーの指標 | 開始時点 | 最新の測定値 |
|---|---|---|
| クラウドエージェントが主導したマージ | 0,1 %(6月) | 38 %(10月) |
| 最初の承認までの待ち時間の中央値 | 2,3 h(9月) | 約5 min(11月中旬) |
| 週平均のマージ数 | 929(9月) | 2 235(10月中旬以降) |
10月中旬から、低リスクに分類されたPRはAIだけで承認し、中リスクのPRもリポジトリが許可していれば同様に承認する。高リスクのPRは人間が担当し、移行処理、CIとデプロイの設定、シークレット、認証には引き続きコードオーナーの承認が必須となる。9月と10月には、AIが承認した977件のPRのうち15件に人間が異議を申し立てた。また、AIだけで承認したマージのロールバック率は0,10 %で、人間が承認した場合は約200件に1件だった。エージェントは利用者と同じようにApp Studioをテストすることもでき、4日間で86件の不具合を確認したほか、調整役のエージェントは2週間で14 000件を超えるタスクを割り振った。これらは社内用のツールで、製品としての提供や料金設定はない。
Google Labs、稼働中のアプリを継続的に改善するプロダクトエージェントStitch Loopを発表
11月18日 — Google Labsが、コーディングエージェントの仕事が終わる本番公開後から作業を引き継ぐ、長期稼働型のプロダクトエージェントStitch Loopを発表した。180以上の連携機能、独自のMCPサーバー、ローカルCLIからの送信を通じて、GitHubリポジトリと稼働中の製品データ(ログ、利用者の行動、フィードバック)に接続し、測定可能な目標に向かって継続的に作業する。
各ループでは、データに基づく改善案を提案し、解決策とそのトレードオフを詳しく説明し、隔離されたクラウドサンドボックスでコードを書き、承認を求めるプルリクエストを作成した後、稼働中の指標を観測する。サイバーセキュリティ、レイテンシー、アクセシビリティの3種類のループが標準で用意され、セキュリティのループはGemini 4 CarbonとGoogle DeepMindのコードセキュリティエージェントCodeMenderを組み合わせる。チームのレビューなしにマージされることはない。Stitch Loopは、Stitch CLIとMCPを通じてGoogle Antigravityなどのコーディングエージェントに製品のコンテキストを提供する役割も担い、Slackでも利用できる。現在は世界中でウェイティングリストへの登録のみ受け付けており、対象となるGoogle AI Ultra加入者には優先的にアクセスを提供する。
一般利用者向けアシスタント:Plus加入者向けChatGPT Space、GeminiアプリのGIF、Chromiumブラウザーで使えるPerplexity Computer
ChatGPT Space、世界中のPlus加入者に提供開始
11月20日 — 9月29日のDevDayで発表され、これまでPro、Business、Enterpriseプランに限定されていたChatGPT Spaceが、18歳以上のPlus加入者向けに世界中で順次提供される。ウェブ、デスクトップアプリ、iOS、Androidのサイドバーで、Spaceがライブラリに置き換わり、ページ、スライド、画像、アップロードしたファイルをまとめる。
ChatGPTと一緒にインタラクティブなページやプレゼンテーションを作成でき、Spaceにアクセスできるほかの人も内容を追加・改善できる。ページやスライドは、接続したアプリから自動で更新することも可能だ。OpenAIは、自動更新されるタスクリストや、Slackでの決定を反映するプロジェクト計画を例に挙げている。コメントでChatGPTにメンションするだけで変更を依頼でき、dotを共同作業に招待することもできる。共有は限定されたままで、閲覧権限と、SpaceにアクセスできるPlus、Pro、Business、Enterpriseのいずれかのアカウントが必要になる。Freeアカウントでは共有コンテンツを開けず、公開リンクも用意されていない。
Geminiアプリ、Gemini Omni 1.2 FlashでアニメーションGIFを作成、フランスでは無料で利用可能
11月20日 — Geminiアプリで、写真にループする効果を加えたり、ミームを作ったりするアニメーションGIFを作成できるようになった。使用するのはGoogleが11月5日に公開した動画モデルGemini Omni 1.2 Flashで、Googleによると、滑らかな動きとフレーム間で一貫した品質を実現する。メインのチャットに依頼を入力するか、画像または動画ツールを開き、形式の選択欄でGIFを選ぶ。
GIFs are now available to all Google AI subscribers and free of charge in the U.S., Japan, Korea, Australia, Canada, U.K., Germany, and France.
🇯🇵 GIFはすべてのGoogle AI加入者が利用できるようになり、米国、日本、韓国、オーストラリア、カナダ、英国、ドイツ、フランスでは無料でも利用できます。 — Xの@GeminiApp
そのため、フランスの利用者は有料プランに加入していなくても利用できる。GoogleはOpenAIに追随する形で、Images 2.6を使ったChatGPTのアニメーションGIFについては、ここで11月5日に取り上げた。
Perplexity Computer、Perplexity拡張機能を通じてChromiumブラウザー内で直接動作
11月20日 — Perplexity拡張機能を使い、Chromiumベースのブラウザー内でPerplexity Computerを直接利用できるようになった。拡張機能のサイドパネルからタスクを依頼すると、利用者のタブやツールでComputerが作業する様子を確認できる。告知の投稿には、対象プランや対応ブラウザーの一覧は記載されていない。
過去の例は2つある。10月5日にはMacアプリ26.38.0で、拡張機能を通じてComputerがChrome、Edge、Braveを操作できるようになり、10月30日にはChrome拡張機能がComputerのMac版とWindows版のアプリを利用者のブラウザーに接続した。今回は、ブラウザー内にある拡張機能のサイドパネルからタスクを依頼する。
開発者向けAPIとSDK:Python版Agents SDKにCodex、PerplexityのContext APIにDecider
OpenAIのPython版Agents SDK、Codexをモデルプロバイダーにする1.0プレビュー版を公開
11月20日 — OpenAIのPython版Agents SDKが、方式を変更したプレビュー版で1.0系列を開始した。ここで11月16日に取り上げた0.24プレビュー版のような独立したネイティブエンジンではなく、Codexを実行ごとに選択できるモデルプロバイダーとして扱う。CodexProviderを作成し、RunConfig(model_provider=provider)を通じてRunnerに渡すと、保存済みのCodex接続、またはAPIキーを使ってエージェントが動作する。
Pythonのwheelには、PyO3を介してCodex Core(rust-v0.166.0、変更なし)が組み込まれている。SDKはcodex app-serverを起動せず、JSON-RPCも経由せずに、Codexのコアを直接呼び出す。Pythonのツール、専門エージェントへの引き継ぎ(handoffs)、ツール実行前の承認、型付きの出力は引き続き利用でき、ネイティブコマンドはCodexのサンドボックスと承認ルールに従う。1.0.0a1のwheelはGitHub Releasesのみで配布される(Linux x86-64とARM64、Apple silicon搭載のmacOS 11以降、Windows x64、CPython 3.10〜3.14)。0.24.0-alpha.8プレビュー版の保存データはRunnerと互換性がなく、安定版は引き続き11月18日公開の0.25.0となる。
🔗 openai-agents-python v1.0.0-alpha.1
Perplexity、Context APIにDeciderを追加し、プロンプトインジェクションも含めてページを採点
11月19日 — Perplexityが、2日前に公開したContext API(1 000 URLあたり1ドル)に、判断モデルDeciderを追加した。取得した各ページについて、はい・いいえで答える質問を最大5つ設定でき、Deciderが各回答に0から1のスコアを付ける。主に紹介されている用途はセキュリティで、エージェントがページを読む前に、そのページに含まれるプロンプトインジェクション(prompt injection)を検出する。Perplexityは、見込み客の評価、モデレーション、出典のない健康関連の主張の検出も挙げている。
API自体は何も除外せず、すべてのページをスコア付きで返すため、しきい値を適用するのはアプリ側のコードとなる。スコア算出は、URLごとの料金に加えてDecisions APIの入力トークンとして課金され、リクエストの処理時間が最大15秒延びる可能性がある。ドキュメントのクックブックには、11月18日にしきい値0,7で実行したチェックの例が掲載されている。
| テストしたページ(11月18日のクックブック) | インジェクションのスコア | チェックの判定 |
|---|---|---|
| インジェクションの実演(グレシャケほか、2023) | 0,97 | 隔離 |
| OWASPのプロンプトインジェクションに関するページ | 0,0018 | 通過 |
| RFC 9111 | 0,0007 | 通過 |
クックブックは、スコアが低くてもページが安全とは限らないと注意している。PerplexityのBrowseSafe++研究によると、テストしたすべてのモデルが、自ら検出したインジェクションの一部に依然として従っていた。
🔗 @perplexitydevsのスレッド · ドキュメント · クックブック
コーディングエージェント:Claude Code 2.1.329、Codex CLI 0.171.0、Vibe CLI 3.1.4、DevinのGemini 4 Neon
Claude Code 2.1.329、フォルダーを開く際にフックの設定元を表示し、予定タスクを/tasksに集約
11月19日 — Claude Code 2.1.329には130件の項目があり、修正91件、変更20件、追加7件が含まれる。セキュリティ面では、フォルダーを信頼するかを尋ねるダイアログに、フックの定義場所が表示されるようになった。また、Claude Desktopを含む非対話型ホストは、管理対象の設定(managed settings)で指定されたフックが読み込まれない場合に警告する。/tasksには、セッションの予定タスク、/loopの起動予定、現在の目標、会話のフォークも一覧表示される。以前のバージョンで登録した予定タスクの多くは、再設定が必要になる。
対象を指定しない/code-reviewは、ほとんどのモデルで、デフォルトブランチと比較してブランチ全体をレビューするようになり、PR番号を指定するとgh pr diffを通じてPRそのものを読み込む。macOSでは、コンピューター操作機能がより新しい安全ルールに移行し、一部の操作を拒否する。max_tokensエラー後に自動で再試行する、2.1.326で追加された機能は削除された。ゲートウェイを経由する場合はCLAUDE_CODE_MAX_OUTPUT_TOKENSの設定が必要となる。Code Modeには、OpenTelemetryのイベントとメトリクスへの対応を含む17件の項目がある。2.1.330は11月20日からnpmで公開されている。
Codex CLI 0.171.0、GPT-6.2 Solを既定モデルにし、ターミナルのワークスペースを有効化
11月20日 — Codex CLI 0.171.0は、11月18日の0.170.0以来初の安定版で、339件のプルリクエストをまとめている。モデル一覧にGPT-6.2 SolとGPT-6.2 Astraが加わり、Solが既定で選択される。また、/rcと/remoteの各コマンドで、ターミナルからローカルのリモート制御を管理し、デバイスのペアリングコードを表示できる。
11月14日から17日までのプレビュー版にあった複数の新機能が安定版に移行した。既定で有効になるTUIのワークスペースは、会話の横にドキュメントや画像のプレビュー、サブエージェントの会話記録を表示する。codex exec --remoteは既存のアプリケーションサーバー上で非対話型セッションを開始または再開する。入力欄には取り消しとやり直しが加わり、/statuslineはオプションを有効にすると、MCPサーバーが提供するステータス行を選択できる。修正点としては、下書きとキュー内の再試行が元の会話に紐付いたままになり、更新トークンを発行しない認証プロバイダーでも企業向けMCP接続が機能するようになった。
Vibe CLI 3.1.4、エージェントと承認ポリシーを分離し、エージェントから確認を省略する権限を撤廃
11月20日 — MistralがVibe CLI 3.1.4を公開した。Mistral Large 4を既定モデルにした3.1.3から2日後のリリースとなる。79件の項目(追加18件、変更41件、修正18件、削除2件)は、主に権限に関するものだ。各セッションは、エージェント(default、lean、またはカスタム)と承認ポリシー(ask、accept-edits、smart-approve、auto-approve)という2つの独立した設定を組み合わせるようになり、承認ポリシーは--approval-policyまたはdefault_approval_policyで選択する。
エージェントは、確認なしで何を実行するかを単独では決められなくなり、safety、bypass_tool_permissions、permission = "always"の設定は無視される。プロジェクトは.vibe/agents/フォルダー内で承認ポリシーを再定義できなくなり、フォークや子セッションも元のポリシーを継承する。インターフェースには、入力欄の上にチップを並べた「レール」(サブエージェント、バックグラウンドタスク、プルリクエスト、目標、タスク)が追加された。keep_awakeの設定でターン中のスリープを防げるほか、Vibeがシステムの証明書を受け入れるようになり、企業のプロキシ経由でも動作しやすくなった。Mistralのモデルに送信される画像は直近の8枚だけとなり、カスタムのコンパクションプロンプトは廃止された。
DevinでGemini 4 Neonが利用可能に、FrontierCode 2.0で46,2 %、1タスクあたり4,38ドル
11月19日(記事の日付は18日) — 昨日ここで取り上げたCursorとGitHub Copilotに続き、CognitionがDevin DesktopとDevin CLIでGemini 4 Neonを利用可能にした。プルリクエストをマージするに値するかを判定する同社のベンチマークFrontierCode 2.0で、Neonは46,2 %を記録し、CognitionによればGoogleのモデルとして最高の結果となった。Claude Opus 5.5(47,3 %)との差は約1ポイントで、コストは約3分の1となる。1タスクあたり12,82ドルに対し、4,38ドルだ。
| FrontierCode 2.0で評価されたモデル | Cognitionが公表したスコア |
|---|---|
| Claude Fable 5.2 | 50,2 % |
| Claude Opus 5.5 | 47,3 % |
| Gemini 4 Neon | 46,2 % |
| GPT-6.2 Astra | 44,2 % |
| GPT-6.2 Sol | 43,8 % |
| Gemini 4 Carbon | 42,6 % |
コストは、公開割引を含むAPIの定価に基づく、1回の実行あたりの平均支出を示す。必須条件を満たさない解答のスコアはゼロとなる。このグラフの複数のスコアは過去数週間に公表された値と異なるが、記事には説明がない。
🔗 DevinでのGemini 4 Neon(Cognition) · Xの@cognition
科学:OpenAIが創薬化学ベンチマークMedChemBenchを公開、GPT-6.2 Astraは84,5 %を獲得
11月20日 — OpenAIがMedChemBenchを発表した。分子構造と実験結果を結び付ける、化合物を比較する、性質を予測するといった、創薬化学者のように推論するモデルの能力を測るベンチマークだ。117本の論文と特許から抽出した99問に、異なる761種類の分子構造を収録し、構造、科学的推論、化合物の選択、性質の予測という4つの要素を採点する。
| 評価されたモデル(推論レベルxhigh) | 獲得点 |
|---|---|
| GPT-6.2 Astra | 84,5 % |
| GPT-6 Astra | 83,3 % |
| GPT-6.1 Sol | 82,0 % |
| GPT-6.1 Terra | 75,1 % |
| GPT-5.6 Sol | 58,2 % |
分野ごとの成績には偏りがある。GPT-6 Astraは構造の項目で配点の95,4 %を獲得したが、化合物の選択と数値予測では約半分にとどまった。OpenAIは慎重な姿勢を保っている。このベンチマークは過去のデータを対象としており、モデルが新薬を発見できると実証するものではない。また、出典となった文献への事前の接触を排除できず、評価されたのもGPTモデルだけだ。11月6日にここで取り上げたBioBasicsBenchに続く取り組みとなる。
🔗 MedChemBenchの紹介(OpenAI) · 論文全文(PDF)
動画・音声生成:ElevenLabsがAds Engineに再撮影なしで広告の派生版を作る機能を追加
11月20日 — ElevenLabsが、6月に公開したElevenCreative統合の広告制作ツールAds Engineを拡充した。Google、Meta、LinkedInに加え、新たにTikTokの広告アカウントにも接続し、既存の広告とその成果を基に、再撮影せずに派生版を制作する。冒頭のつかみ(フック)を見つけ、成果の出た広告を参考に新しいものを書き起こす。それを元の話者の声のデジタル複製で読み上げ、口の動きを同期し、字幕も更新する。映像の雰囲気とテンポに合わせてElevenLabs Music APIで作曲する新しいサウンドトラックは、商用利用が可能だ。
すでにDubbing v2が担っていたローカライズでは、Ads Engineが話者の口の動きを対象言語に合わせて調整し、焼き込み字幕を、ブランドのタイミングとフォントに合わせた翻訳版に置き換えるようになった。配信前には引き続き人による確認が可能で、対象言語を母語とするローカライズの専門家にも依頼できる。ツールから各プラットフォームへ直接公開することも可能だ。利用には営業チームへの問い合わせが必要で、料金は公表されていない。
🔗 Ads Engineでの動画広告の派生版制作とローカライズ(ElevenLabs)
短報
コーディングエージェント
- Copilot CLI 1.0.115-2 — 修正335件を含む351件の項目からなるこのプレビュー版では、利用権限のあるアカウントでGemini 4 Hydrogenを推論強度Extra Highとともにモデル選択欄から選べるようになった。GPT-6.2 Astraにも対応し、
/modelはカスタムプロバイダーのモデルも扱える。安定版は引き続き1.0.114。🔗 出典 - Codex CLI 0.173.0-alpha.1とalpha.2 — これらのプレビュー版のリリースノートは空欄だが、71件のコミットの題名によれば、MCP接続の共有と、設定済みサーバーのOAuth検出が既定で有効になる。また、管理者はCodexデーモンの更新を無効にできるようになる。安定版までに内容が変わる可能性がある。🔗 出典
- Gemini CLI — 11月4日以来初めてのナイトリービルド(v0.71.0-nightly.20261120)が登場した。メインブランチでは、
gemini --resumeが最後に開始したセッションではなく、最後に使用したセッションを開き直すようになり、~\で始まるパスも、ようやくWindowsで展開されるようになった。🔗 出典 - Antigravity IDE 2.8.0 — Googleのエディターがバックエンドを即座に起動し、更新をバックグラウンドで確認するようになった。リモート接続時のポート転送を自動化し、キーボードで会話内を検索でき、接続時にはカスタム証明書とプロキシも利用できる。🔗 出典
- Qwen Code 0.28.1-preview.1 — 179件の項目からなるこのプレビュー版では、GitHubが3つ目の対応チャネルアダプターとなる。ウェブインターフェースから設定できるWeCom、Microsoft Teams、汎用の送信ウェブフックを追加し、CLIにはスクリーンリーダー向けの表示も導入した。安定版は引き続きv0.28.0。🔗 出典
- Kimi Code 2.7.1と2.7.2、Kimi Code Desktop 1.4.1と1.4.2 — 2.7.0の翌日に4つの修正版が公開された。下書きで選択した思考強度が送信後に既定値に戻らなくなり、ターン中に方向修正したセッションを復元した後でも、フォークが失敗しなくなった。🔗 出典
- mistral CLI 0.20.1 —
mistral evals execは、401エラーなどで1回の実行に含まれるすべての呼び出しが失敗した場合、成功扱いにせず、失敗(コード1)で終了するようになった。Ctrl-Cによる中断も、中断として報告される。🔗 出典 - Replit — ワークスペース(Workspaces)を検索し、ピン留めできるようになった。この機能はワークスペースが5つ以上ある場合にのみ表示される。🔗 出典
- Manim向けDevin Bot — Cognitionが、Grant SandersonがManimでの作業を助けるために導入したDevin Botを紹介した。Manimは3Blue1Brownの動画で使われるオープンソースのアニメーションシステムで、スター数は96,6 k、月間ダウンロード数は250 000回。投稿では、ボットに任せたタスクや成果は明らかにされていない。🔗 出典
APIとプラットフォーム
- Gemini API — 11月17日から、Gemini 3.5 Transcribeの通常版とリアルタイム版で、音声入力した文章や既存のテキストを、声で修正、書き換え、整形できるようになった(パラメーターは
source_text)。Googleは翻訳も挙げている。18日からは、送信したファイルの必要な部分だけを処理し、その分だけを支払えるようになった。ページ範囲、タブ、セル、時間範囲、コンテンツのレイヤーを指定できる。🔗 出典 - Agents APIでの時間認識 — 実験的なオプション(
experimental={"time_awareness": True})がモデルに定期的に時刻を知らせ、期限に合わせて作業を調整できるようにする。非同期ツールと組み合わせることで、エージェントが質問を投げかけ、返答を待つ間も調査を続けられる。OpenAIの開発者ブログの記事で、その例が紹介されている。🔗 出典 - GPT-6.2での会話履歴 — @OpenAIDevsは、Responses APIで過去のメッセージを変更しないよう求めている。変更すると、それ以降の推論がAPIによって破棄されるためだ。使用状況ダッシュボードに新設された「推論の削除」欄でこれを確認でき、関連ガイドでは、推論強度やツールを変更する際、代わりに
configuration_updateまたはadditional_toolsの要素を追加する方法を提案している。🔗 出典
一般向けアシスタント
- ChatGPTがdot用タブとピン留めしたお気に入りを備える新しいモバイルアプリを展開 — Codex、Projects、Imagesをタブバーにピン留めできる。展開は、dotを利用できる地域の18歳以上のProユーザーと、少数のPlusユーザーから始まる。欧州経済領域(EUを含む)、英国、スイス、韓国は対象外(11月19日のリリースノート、リンクは上記)。
- PerplexityのTeammates — Max加入者は、ウェブ上のどのComputerタスクからでもチームメイトを作成し、同じ会話内で名前、役割、アバターを変更できるようになった。🔗 出典
- PerplexityのMacアプリ — 動作が高速化し、進行中のタスクを方向修正する「今すぐ送信」、表、Markdown、プレビュー内を検索する⌘F、閉じたタブを開き直す⌘⇧Tが追加された。🔗 出典
動画・音声生成
- PikaのSeedance 2.5 Flash — RunwayとHeyGenに続き、Pikaが、多数のテイクを要する作業向けにByteDanceの動画モデルの高速版を追加した。480pまたは720pで最大30秒の動画を生成でき、参照素材には画像10枚、動画5本、音声クリップ5本まで使用できる。投稿に料金の記載はない。🔗 出典
- HeyGenのAvatar 6 — 技術報告書から新たなブラインドテストの結果が示された。撮影対象となったHeyGenの従業員が、自分に最も似ている動画を選んだところ、Avatar 6はSeedance 2.5との比較で86,5 %、Wan 3.0との比較で87,9 %の割合で選ばれた。これらの評価はHeyGenが実施している。🔗 出典
- Together AIのQwen3 TTS — オープンな音声合成モデルQwen3-TTS-12Hz-1.7B(Apache 2.0)が、100万文字あたり20ドルで提供される。自然言語の指示で調整できる9種類の音声と、フランス語を含む10言語に対応し、最初の音声が出るまでの時間は最短97 ms。🔗 出典
インフラと研究
- Together Storage Accelerator — Together AIが、すべてのGPUクラスターに、S3ストレージとHugging Face Hub向けのNVMeキャッシュを提供する。コードの変更は不要。同社の測定によると、Cloudflare R2から2 Gioのファイルを読み込む時間が12,7~15,0 sから0,64~0,72 sに短縮され、200ノードのクラスターでも配信元からのダウンロードは1回だけで済む。🔗 出典
- Hugging FaceのCDN — 共同創業者のJulien Chaumondによれば、Hugging Faceは毎月約1エクサバイトのオープンなモデルとデータセットを配信しており、AIのダウンロード向けに独自のコンテンツ配信ネットワーク(CDN)を構築した。🔗 出典
- basecomputeのSuperfluid — ローカルサーバーが、Apple、AMD、NVIDIAのマシン間で推論を分散するようになった。開発元によると、64人のユーザーをシミュレートした条件で、6台のマシンにより出力速度が毎秒112トークンから534トークンに向上し、1ノードが停止してもリクエストは一切失われない。🔗 出典
- WavLate — このオープンな遅延相互作用モデルは、音声0,31秒ごとに1つ、単語ごとに1つのベクトルを使い、テキストから音を、音からテキストを検索する。作者は、AudioCapsとClothoで平均Recall@1が37,9となり、比較した9つのオープンモデルの中で最高だったと報告し、重みとデータを公開している。🔗 出典
- WorldTrace — NVIDIA Researchが、対話型動画世界モデル向けに、再学習を必要としない記憶機構を発表した(論文はNeurIPS 2026に採択)。LoopBenchでは、再訪した場面の再現率がスライディングウィンドウ方式より32,6 %向上し、GPUメモリを3,1 Go使用、実行時間は27 %増加した。🔗 出典
- 強化学習向けのDynamo — NVIDIAが、Dynamoで事後学習のロールアウトを処理する仕組みを詳しく説明した。KVキャッシュに基づくルーティング、ModelExpressによる重みの差分転送、障害が発生したワーカープロセスの復旧を行う。Microsoft AI、Cognition(SWE-1.7向け)、Prime Intellect、H Companyが利用しており、H Companyは学習の各ステップの所要時間を最大20 %短縮している。🔗 出典
- スパースアテンション — NVIDIAは11月17日のガイドで、同社のGPU上で学習するスパースアテンションについて、8つの設計原則を示した。128KトークンでのDeepSeek V3.2のプリフィル層では、トークンを選ぶインデクサーとTop-kが処理の47 %を占める。🔗 出典
GitHub
- GitHub Enterprise Server 3.23のリリース候補版 — パブリックプレビューのAIによるシークレット検出は、アプライアンスのCPU上で動作し、GPU、ホスト型LLM、外部への接続を必要としない。ネットワークから隔離された環境(エアギャップ環境)でも利用できる。また、このバージョンでは、既知の悪意あるパッケージの検出対象を、npmに加えて7つのエコシステムに拡大する。🔗 出典
- AI以外 — GitHubが、プルリクエストの新しい概要ページでマージ状態を分かりやすくした。GitHub Desktop 3.7.0は同じホスト上の複数アカウントに対応し、ダッシュボードではお気に入りのリポジトリを最大25件表示できる。🔗 概要 · 🔗 Desktop · 🔗 お気に入り
企業と論考
- Hebbia — 8月と9月に実施した金融調査のテストで、GPT-6 Astraのプレビュー版が引用した抜粋の99,5 %は関連性があり、提示形式に関する要件の97,9 %を満たした。これは、テストした代替モデルの中で最良のものを14,4ポイント上回るが、OpenAIが公開した導入事例では、そのモデル名は明かされていない。🔗 出典
- 静かな合意 — OpenAIが「知性の時代」(インテリジェンス・エイジ)欄で、Dean Ballの論考を公開した。Harvardでの講演を基にしたもので、著者自身の見解を反映すると明記されている。人間の主導的地位の放棄は避けられないという考えに反対し、個人にひも付き、権限が制限され、取り消しも可能なエージェントを支持している。🔗 出典
- データ拡充 — Perplexityのガイドが、ウェブに接続したモデルを使ってCRMのレコードを補完し、検証する方法を6つのステップで説明している。Apolloは、PerplexityのAPIを通じて毎月560万件のデータ拡充を処理している。🔗 出典
これが意味すること
Anthropicの新規株式公開に関する投稿には、金融市場からの資金と産業界からの資金がまとめて示されている。公募によって同社に約916億ドルの総額がもたらされ、私募によってさらに260億ドルが加わる。この私募は、半導体・コンピューティング分野の7社、AMD、Broadcom、Google、Micron、Microsoft、NVIDIA、TSMC Partnersが、公募と同じ1株83ドルで引き受けた。資金調達の総額は約1,195億ドルに達する。公募の投資家に加え、産業界の7社が、Nasdaq上場企業となったAI研究所の株式を購入する形だ。
安全性への対策は、ツール自体の仕組みに組み込まれるようになっている。OpenAIはGPT-6.2の推論を、それを生成した会話履歴に結びつけることで、測定された抽出率を54.0 %から0.2 %に下げる一方、開発者には会話を書き換えないことを求める。Vibe CLIは、確認を自ら解除する権限をエージェントから取り除く。Claude Codeは、フォルダーを信頼する前に、その中のフックの出所を示す。Deciderは、エージェントが読む前にページを採点する。一方、Sakana AIは、脆弱性の悪用に使える資料を公開しないと約束し、集団的な防御を専門とするチームを設立する。
エージェントの役割は、コードの記述からソフトウェアの提供工程へと広がっている。Runwayでは、エージェントが10月のマージの38 %を担い、リスクの低い変更はAIだけで承認する。Stitch Loopは稼働中の製品を監視し、定量目標を達成するためにプルリクエストを作成する。どちらの場合も、重要な判断は人が握っている。Runwayでは機微な領域を、Stitch Loopでは個々のマージを人が管理する。ツールの整備も進む。Python向けAgents SDKはCodexをモデルプロバイダーとして利用できるようにし、Cognitionは、こうした工程で問われる「プルリクエストをマージすべきかどうか」を基準にモデルを評価する。
オープンモデルでは、より軽量な重みからどれだけの能力を引き出せるかに力が注がれている。Inkling 2 Miniは中間層を3回通ることで、20 GBでAA IndexにおけるQwen3.8-27Bと同等の性能を実現する。Hugging Faceのスーパーアダプターは3種類の専門能力を1つのLoRAに収め、Metric AIはQwen3.5を基にアルメニア語モデルを構築する。ただし、これらの数値は提供元の発表に基づくものだ。MedChemBenchも、こうした評価の限界を改めて示している。OpenAIはそこで自社モデルだけを評価しており、モデルが出典となった論文をすでに見ていた可能性も否定していない。
出典
- 新規株式公開の完了(Anthropic)
- Xの@AnthropicAI:共同創業者
- Inkling 2 Mini(Thinking Machines)
- Inkling 2 Miniに関するHugging Faceの投稿
- Inkling-2-Mini(Hugging Face)
- Together AIでのTencent Hy4
- Hy4に関するTencentの発表
- アダプターを大規模に活用する(Hugging Face)
- Xの@yb2698:スーパーアダプター
- Ayb 0.5(Metric AI)
- OhanTTS(Metric AI)
- OhanASR(Metric AI)
- Xの@pcuenq:Depth Pro 2
- arXiv論文2611.26603:Depth Pro 2
- DepthPro2-L(Hugging Face)
- 敵対的蒸留への対抗(OpenAI)
- Xの@OpenAI:敵対的蒸留
- Xの@hardmaru:セキュリティ研究グループ
- セキュリティ研究グループ(Sakana AI)
- ソフトウェア工場の構築(Runway)
- Stitch Loop(Google)
- ChatGPTのリリースノート
- Xの@GeminiApp:GIFの提供状況
- Xの@GeminiApp:GeminiでのGIF
- Xの@perplexity_ai:ChromiumでのComputer
- openai-agents-python v1.0.0-alpha.1
- Xの@perplexitydevs:Context APIでのDecider
- 基準に沿ってページを採点する(Perplexityのドキュメント)
- インジェクション対策クックブック(Perplexityのドキュメント)
- Claude Code v2.1.329
- Codex CLI 0.171.0
- Vibe CLI v3.1.4
- DevinでのGemini 4 Neon(Cognition)
- Xの@cognition:Gemini 4 Neon
- MedChemBenchの紹介(OpenAI)
- MedChemBenchの論文全文(PDF)
- Ads Engineでの動画広告のバリエーション作成とローカライズ(ElevenLabs)
- Copilot CLI 1.0.115-2
- Codex CLI 0.173.0-alpha.2
- Gemini CLI、プルリクエスト30389
- Antigravityの変更履歴
- Qwen Code v0.28.1-preview.1
- Kimi Code 2.7.2
- mistral CLI 0.20.1
- Replitの11月20日の変更履歴
- Xの@cognition:Manim向けDevin Bot
- Gemini APIのリリースノート
- パーソナルエージェントの時間認識と非同期入力(OpenAI)
- Xの@OpenAIDevs:GPT-6.2の履歴と推論
- Xの@AskPerplexity:Computerから利用できるチームメイト
- Xの@AskPerplexity:Macアプリ
- Xの@pika_labs:Seedance 2.5 Flash
- Xの@HeyGen:Avatar 6のブラインドテスト
- Together AIでのQwen3 TTS
- Together Storage Accelerator(Together AI)
- Xの@julien_c:Hugging FaceのCDN
- Superfluidのフリート運用(basecompute)
- WavLate(Hugging Face)
- Xの@NVIDIAAI:WorldTrace
- Dynamoと強化学習のロールアウト(NVIDIA)
- NVIDIA GPUでのスパースアテンション(NVIDIA)
- GitHub Enterprise Server 3.23リリース候補版(GitHubの変更履歴)
- プルリクエストの概要ページ(GitHubの変更履歴)
- GitHub Desktopとホストごとの複数アカウント(GitHubの変更履歴)
- ダッシュボードのお気に入りリポジトリ(GitHubの変更履歴)
- HebbiaとGPT-6 Astra(OpenAI)
- 静かな合意(OpenAI)
- AIによるデータ拡充(Perplexity)