ai-powered-markdown-translatorArtikel översatt från franska till svenska med gpt-6.1-sol.
Anthropic avslutar sin börsintroduktion: cirka 93,5 miljarder dollar brutto från erbjudandet och ytterligare 26 miljarder från sju koncerner, däribland NVIDIA, Google och Microsoft, genom en parallell privat placering. Thinking Machines släpper Inkling 2 Mini, en modell med öppna vikter och 26,4 miljarder parametrar som ryms i 20 GB, och OpenAI sänker andelen lyckade attacker som extraherar modellernas skyddade resonemang från 54,0 % till 0,2 %. ChatGPT Space öppnas för Plus-prenumeranter, Runway låter agenter hantera 38 % av sina kodsammanslagningar, och Claude Code, Codex CLI och Vibe CLI släpper var sin ny version.
Finans: Anthropic avslutar sin börsintroduktion med 93,5 miljarder dollar brutto och en privat placering på 26 miljarder
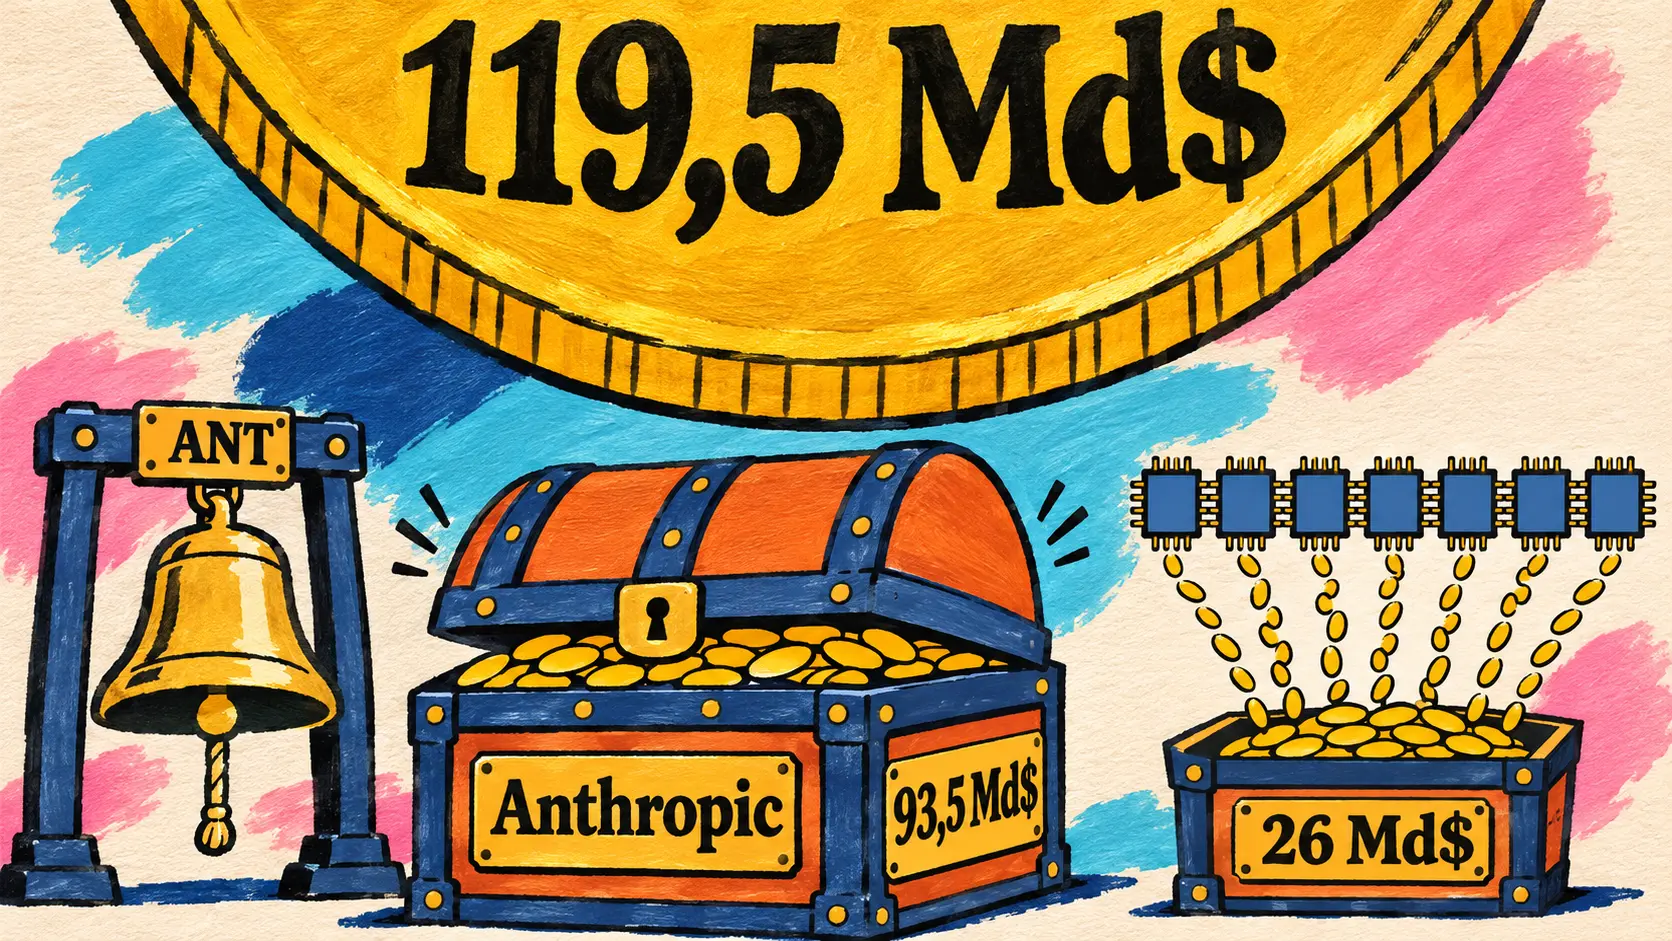
20 november — Dagen efter den första handeln med aktien meddelar Anthropic att börsintroduktionen har slutförts. Priset fastställdes den 18 november till 83 dollar per aktie. Bankerna har utnyttjat hela sin option på ytterligare 147 miljoner aktier: totalt har 1 127 000 000 aktier av klass A sålts. Bruttolikviden uppgår till cirka 93,5 miljarder dollar före provisioner och avgifter, varav cirka 91,6 miljarder tillfaller Anthropic, som inte får någon del av intäkterna från de 23 648 646 aktier som befintliga aktieägare har sålt.
Inlägget redovisar också en parallell privat placering som även den har slutförts, men som inte nämndes när priset tillkännagavs: 313 253 007 aktier av klass N, sålda till samma pris på 83 dollar till sju koncerner inom halvledar- och datorindustrin (AMD, Broadcom, Google, Micron, Microsoft, NVIDIA och TSMC Partners), för cirka 26,0 miljarder dollar. Dessa aktier är inte registrerade enligt Securities Act från 1933. Sammantaget uppgår det offentliga erbjudandet och placeringen till närmare 119,5 miljarder dollar brutto, före provisioner och avgifter.
| Del av transaktionen | Värde som Anthropic har meddelat |
|---|---|
| Sålda aktier av klass A | 1 127 000 000, varav 147 000 000 genom bankernas option |
| varav sålda av Anthropic | 1 103 351 354 |
| varav befintliga aktieägare | 23 648 646 |
| Pris per aktie | 83 dollar |
| Erbjudandets bruttolikvid | cirka 93,5 miljarder dollar |
| Andel som tillfaller Anthropic | cirka 91,6 miljarder dollar |
| Privat placering (klass N) | 313 253 007 aktier, cirka 26,0 miljarder dollar |
| Totalt brutto, erbjudande och placering | cirka 119,5 miljarder dollar |
| Notering | sedan den 19 november, Nasdaq Global Select Market, symbol ANT |
Inlägget bekräftar noteringen utan att ange aktiekurs eller börsvärde. Goldman Sachs och Morgan Stanley ledde transaktionen tillsammans med ett konsortium på ett tjugotal banker, däribland J.P. Morgan, Citigroup, BNP Paribas, Crédit Agricole CIB och Société Générale. Samma dag publicerade @AnthropicAI en video där de sju medgrundarna, Dario Amodei, Daniela Amodei, Tom Brown, Jack Clark, Jared Kaplan, Sam McCandlish och Chris Olah, berättar företagets historia.
🔗 Börsintroduktionens slutförande (Anthropic) · @AnthropicAI på X: medgrundarna
Öppna modeller: Inkling 2 Mini från Thinking Machines, Tencent Hy4, en superadapter för Qwen3.8-27B, Ayb 0.5 och Depth Pro 2
20 november — Thinking Machines Lab släpper Inkling 2 Mini, lillebror till Inkling 2 Small (594 miljarder parametrar, som behandlades här den 12 november). Denna modell med en blandning av experter (Mixture-of-Experts), öppna vikter och Apache 2.0-licens har 26,4 miljarder parametrar, varav 3,4 miljarder är aktiva per token. Den läser text och bilder och har en kontext på en miljon tokens. Vikterna levereras med samma precision som under träningen, NVFP4 för tjugo lager och MXFP8 för de fyra sista, vilket innebär cirka 20 GB utan konverteringsförlust: den kan köras med Ollama på alla Mac-datorer med minst 32 GB.
Today we are releasing Inkling 2 Mini, a fast, powerful model that’s small enough to run on your laptop.
🇸🇪 I dag släpper vi Inkling 2 Mini, en snabb och kraftfull modell som är tillräckligt liten för att köras på din bärbara dator. — Thinking Machines Lab, tillkännagivandet av Inkling 2 Mini
Det speciella ligger i arkitekturen: det är en transformer med loopar (looped transformer). Av dess 24 lager genomlöps de 12 mittersta tre gånger, vilket ger 48 lagerpassager per token med 24 lagrade lager, och därmed 5,4 miljarder viktaktiveringar per token. Under träningen tog laboratoriet också bort två tredjedelar av experterna (från 384 till 128) och reparerade sedan modellen med 1 000 miljarder tokens som destillerats från en större intern Inkling-modell. Enligt laboratoriet skulle en modell utan loopar, vid samma förlustvärde, kräva 7,5 % mindre beräkning under träningen men 140 % mer beräkning vid inferens.
| Benchmark (Thinking Machines tabell) | Inkling 2 Mini | Qwen3.8-27B | Nemotron 3.5 Super VL |
|---|---|---|---|
| Viktaktiveringar per token / totalt antal parametrar | 5,4B / 26,4B | 27,0B / 27,0B | 12,0B / 124,5B |
| AA Index v5.0 | 20,1 | 20,1 | 13,6 |
| DeepSWE v1.1 | 48,2 % | 42,2 % | 24,7 % |
| SWE-bench Pro v2 Hard | 77,9 % | 73,8 % | 44,1 % |
| Terminal-Bench 2.1 (pi) | 71,6 % | 73,0 % | 60,7 % |
| BrowseComp | 79,0 % | 61,6 % | 78,9 % |
| MCP Atlas | 82,7 % | 77,3 % | 67,7 % |
Enligt Thinking Machines leder modellen bland öppna modeller med färre än 100 miljarder parametrar på DeepSWE v1.1 och Vals Index v2.2 (46,5 %). Den ligger fortfarande efter Qwen3.8-27B på Terminal-Bench 2.1, och Thinking Machines medger att den inte är den bästa lilla modellen för samtal i flera turer (50,0 % på MultiChallenge) eller instruktioner med flera begränsningar (33,4 % på ComplexConstraints v1.1); i diagrammets förklaring anges att utvärderingskonfigurationerna varierar mellan modellerna. Forskare vid Stanford med tidig tillgång mätte 0,703 i intelligens per joule på DGX Spark, jämfört med 0,430 för Qwen3.6-35B-A3B.
Laboratoriet använder den också för forskning om övervakning av tankekedjor (chain of thought): en modell med loopar gör fler beräkningar utan att skriva ut dem, vilket skulle kunna undgå en övervakare. I en variant med varierande antal passager, som också har publicerats, ökar svårighetsgraden på uppgiften som löses utan nedskrivet resonemang från motsvarande 16 till 37 sekunders mänskligt arbete när antalet passager ökar från en till tre. Vid fem passager är resonemanget hälften så långt (i genomsnitt 1 661 jämfört med 3 703 tokens på GPQA Diamond) och lika läsbart; Thinking Machines ser ingen ökning av agentiskt sabotage när antalet loopar ökar. Modellen är tillgänglig på Tinker, Ollama, SGLang, vLLM, llama.cpp, MLX och Transformers, med GGUF-versioner hos Unsloth.
🔗 Inkling 2 Mini (Thinking Machines) · Inlägg från Hugging Face · Vikter på Hugging Face
Together AI tillhandahåller Tencent Hy4, en Mixture-of-Experts-modell med 770 miljarder parametrar, för 0,83 dollar per miljon indatatokens
19 november — Together AI lägger till Tencent Hy4 i sitt utbud av serverlös inferens, med en kontext på en miljon tokens, verktygsanrop och JSON-utdata. Enligt leverantören är Tencents flaggskeppsmodell en Mixture-of-Experts-modell med 770 miljarder parametrar, varav 49 miljarder är aktiva per token; den efterträder Hy4 Preview, lägger till datoranvändning och blir den första modellen i Hy-familjen som kan läsa bilder.
| Pris per miljon tokens | Together AI | Tencent (pressmeddelande den 4 november) |
|---|---|---|
| Indata | 0,83 dollar | cirka 0,90 dollar |
| Cachad indata | 0,042 dollar | cirka 0,045 dollar |
| Utdata | 2,50 dollar | cirka 2,70 dollar |
Tencent lanserade Hy4 den 4 november, presenterade den som en av de bästa modellerna med öppen källkod och lovade att släppa vikterna inom några dagar; kodarkivet tencent/Hy4 finns på Hugging Face under en licens av typen ”other”. Pressmeddelandet hänvisade till en blindutvärdering inom finans (213 yrkesverksamma, 579 uppgifter) där Hy4 fick 3,04, före DeepSeek-V4.1-Flash-1017 (2,97), och till en intern hallucinationsfrekvens som sänkts från 12,95 % till 7,2 %.
🔗 Tencent Hy4 på Together AI · Tencents pressmeddelande den 4 november
Hugging Face publicerar receptet för sina harness adapters och en enda superadapter för Qwen3.8-27B
20 november — Efter tre dagars publiceringar, däribland Hermes-adaptern som behandlades här i går, släpper Hugging Face det fullständiga receptet för sina harness adapters: LoRA som tränats med förstärkningsinlärning inne i ett agentramverk (pi, Hermes Agent eller OpenCode), ovanpå Qwen3.8-27B. Nyheten är en superadapter: de tre LoRA-adaptrarna med rang 32 sammanfogas till en enda LoRA med rang 96 som fungerar i alla tre ramverken. Eftersom deras uppdateringar är nästan ortogonala (cosinusvärden från 0,01 till 0,02) tillämpar sammanslagningen exakt alla tre.
| SWE-bench Pro (51 svåra uppgifter), med resonemang | Basmodell | Med superadaptern |
|---|---|---|
| Hermes Agent-ramverket | 45 % | 61 % |
| OpenCode-ramverket | 47 % | 67 % |
| pi-ramverket | 74 % | 74 % |
Med resonemang ökar genomsnittet för de sex kombinationerna av ramverk och benchmark från 55,5 till 63,5 %, med 19 till 48 % färre verktygsanrop, enligt teamets tråd; utan resonemang vinner superadaptern 6 till 18 procentenheter på SWE-bench Pro, med 53 till 73 % färre verktygsanrop, enligt inlägget. Resultaten kan inte jämföras mellan ramverken eftersom deras standardinställningar skiljer sig åt. Träningen krävde 598 steg och 167 miljoner tokens; skyddet safeagents granskade 1,3 miljoner verktygsanrop och blockerade 647 av dem. Uppgifter, adaptrar, GGUF och utvärderingsförlopp har publicerats.
🔗 Harness adapters i stor skala (Hugging Face) · @yb2698 på X
Metric AI släpper Ayb 0.5, OhanTTS och OhanASR, öppna text- och röstmodeller för armeniska
20 november — Det armeniska teamet Metric AI släpper samma dag tre modellfamiljer för sitt språk. Ayb 0.5 omfattar tre språkmodeller (0,8B, 4B och 9B) som bygger på Qwen3.5 och har anpassats till armeniska, från en utökad tokenizer till efterträning; Ayb-9B hanterar dialog i flera turer, verktygsanrop och bilder. OhanTTS-v0.1 syntetiserar tal på åtta språk, däribland armeniska och franska, och klonar en röst från 3 till 10 sekunders ljud. OhanASR-v0.1, en taligenkänningsmodell på 2B, har finjusterats på 820 timmar armeniska.
| Modell från Metric AI | Resultat publicerat av upphovspersonerna |
|---|---|
| Ayb-9B | 3:a totalt på ArmBench (0,6164) |
| OhanTTS-v0.1, 61 timmar armeniska | 14,70 % WER, första ljudet efter 331 ms på en GB10 |
| OhanASR-v0.1 | 16,12 % WER (2:a) och 3,49 % CER (1:a) på ArmBench-ASR |
Vikterna för Ayb-9B har en icke-kommersiell licens (CC BY-NC 4.0) och är tillgängliga efter manuellt godkännande.
🔗 Ayb 0.5 (Metric AI) · OhanTTS · OhanASR
Apple släpper Depth Pro 2, som uppskattar djup i meter i foton och videor
19 november — Apple släpper Depth Pro 2, en familj av modeller som uppskattar djup i meter i både foton och videor, i ursprunglig upplösning. Enligt artikelns sammanfattning har befintliga metoder behövt välja mellan konsekvens från bildruta till bildruta och skarpa konturer; Depth Pro 2 siktar på båda med ett enda nätverk. Vikterna finns på Hugging Face i fyra storlekar (S, B, L, H), med en Core ML-version och en gemensam modell för uppskattning av brännvidden, vilket är användbart när brännvidden saknas i EXIF.
| Upplösning som hanteras av DepthPro2-L (334M, på B200) | Bilder per sekund |
|---|---|
| VGA | 150,1 |
| 720p | 33,7 |
| 1080p | 9,1 |
| 4K | 0,7 |
Vikterna får endast användas för icke-kommersiell forskning (licensen Apple Machine Learning Research Model), och koden finns på GitHub. Lanseringen uppmärksammades den 20 november av Pedro Cuenca från Hugging Face, med en demonstration på nätet.
🔗 @pcuenq på X · Artikel på arXiv 2611.26603 · DepthPro2-L (Hugging Face)
Modellsäkerhet: OpenAI mot adversariell destillering, Sakana AI bildar sitt Security Research Group
OpenAI beskriver sin kamp mot adversariell destillering och minskar extraktionen av skyddat resonemang från 54,0 % till 0,2 %
20 november — OpenAI publicerar ett inlägg om adversariell destillering (adversarial distillation): otillåten användning av utdata från en avancerad modell för att träna en annan, som driftsätts utan samma skyddsmekanismer, exempelvis för attacker som ursprungsmodellen skulle ha avvisat. Inlägget fokuserar främst på skyddat resonemang, den tankekedja som produceras före svaret: enligt en intern studie förbättras en elevmodell i allmänhet mer med exakta resonemangsspår än med sammanfattningar av dem.
| Uppmätt attack (adaptiv utvärdering, sex attackerande modeller) | GPT-6 Astra, ursprungliga skyddsmekanismer | GPT-6.2 Astra, uppdaterade skyddsmekanismer |
|---|---|---|
| Resonemang för en tidigare förfrågan | 54,0 % | 0,2 % |
| Resonemang för den aktuella förfrågan | 22,9 % | 0,9 % |
Försvaret kombinerar adversariell träning, klassificerare för indata och utdata (inklusive argument i verktygsanrop), API-kontroller och utredningar, med sanktioner varje vecka mot kampanjer som omfattar några tusen till några tiotusentals konton. Med GPT-6.2 Astra och Sol knyts det skyddade resonemanget till historiken som skapade det: API:et förkastar det om ett tidigare meddelande skrivs om, och äldre modellfamiljer kan inte längre läsa det. OpenAI påminner om att företaget i februari rapporterade till kongressen om aktivitet som tydde på att DeepSeek försökte destillera amerikanska modeller, och därefter i september tillskrev en kampanj till personer med koppling till Moonshot AI; företaget uppger att det stöder Chip Security Act, AI OVERWATCH Act och MATCH Act.
🔗 Att bekämpa adversariell destillering (OpenAI) · @OpenAI på X
Sakana AI skapar sitt Security Research Group, en oberoende grupp för kollektivt cyberförsvar
20 november — Sakana AI lanserar sitt Security Research Group, en oberoende R&D-grupp i Tokyo, skild från den kommersiella verksamheten och inriktad på allmännytta.
Excited to announce the Sakana AI Security Research Group, an independent, public-interest R&D team in Tokyo co-led by Akihiro Umegai and me.
🇸🇪 Jag är glad att kunna presentera Sakana AI Security Research Group, en oberoende R&D-grupp i allmänhetens intresse, i Tokyo, som leds gemensamt av Akihiro Umegai och mig. — @hardmaru på X
David Ha är medgrundare och vd för Sakana AI. Gruppen ska arbeta inom tre områden: förebyggande säkerhet redan vid utformningen, kollektivt försvar med agenter fördelade mellan organisationer och skydd av själva försvarsagenterna, vars befogenheter begränsas till deras uppgift och vars handlingar loggas. Gruppen utgår från egna projekt som Digital Red Queen, ShinkaEvolve och Fugu-Cyber, för vilket Sakana AI rapporterar 86,9 % på CyberGym och 72,1 % på CTI-REALM; en not i inlägget förtydligar att sidan för Fugu-Cyber varken anger referensresultat eller utvärderingsprotokoll. Gruppen kommer att publicera vitböcker, testsviter och försvarsguider, men inget material för att utnyttja sårbarheter, och upptäckta sårbarheter kommer att hanteras genom samordnat offentliggörande. Sakana AI påminner om att antalet CVE-förfrågningar ökade med 263 % mellan 2020 och 2025, enligt NIST.
🔗 Security Research Group (Sakana AI)
Agenter kopplade till programvaruleverans: Runways fabrik, Stitch Loop från Google Labs
Runway överlåter sin kedja för programvaruleverans till agenter, som hanterade 38 % av sammanslagningarna i oktober
20 november — Runway publicerar en redovisning med siffror för sin ”programvarufabrik” (software factory) på sin teknikblogg: sju steg, från kodskrivning till samordning av sammanslagningar, har ett efter ett överlåtits till agenter. Molnagenter hanterade 38 % av de pull requests som slogs samman i oktober, och av 100 sådana PR som slogs samman under första halvan av november innehöll 78 ingen mänsklig commit.
| Mått för programvarufabriken | Utgångsläge | Senaste mätning |
|---|---|---|
| Sammanslagningar hanterade av molnagenter | 0,1 % (juni) | 38 % (oktober) |
| Medianväntetid till ett första godkännande | 2,3 h (september) | cirka 5 min (mitten av november) |
| Genomsnittligt antal sammanslagningar per vecka | 929 (september) | 2 235 (sedan mitten av oktober) |
Sedan mitten av oktober godkänner AI på egen hand PR som klassificerats som låg risk, och även medelhög risk om kodförrådet tillåter det; hög risk hanteras av en person, och kodägarna godkänner alltid migreringar, CI- och driftsättningskonfiguration, hemligheter och autentisering. Under september och oktober ifrågasatte en person 15 av de 977 PR som godkänts av AI, och sammanslagningar som enbart godkänts av AI har en återställningsfrekvens på 0,10 %, jämfört med cirka 1 av 200 för mänskliga godkännanden. Agenter testar också App Studio som en användare (86 bekräftade buggar på fyra dagar), och en samordnare fördelade över 14 000 uppgifter på två veckor. Det rör sig om interna verktyg, utan produkt eller prisuppgifter.
🔗 Att bygga en programvarufabrik (Runway)
Google Labs lanserar Stitch Loop, en produktagent som kontinuerligt förbättrar en driftsatt applikation
18 november — Google Labs presenterar Stitch Loop, en långvarigt aktiv produktagent som tar vid där en kodagent slutar: efter produktionssättningen. Den ansluter till GitHub-kodförrådet och till data från den driftsatta produkten (loggar, användarbeteende, återkoppling) genom över 180 integrationer, anpassade MCP-servrar eller överföringar från en lokal CLI, och arbetar kontinuerligt mot mätbara mål.
Varje loop föreslår möjligheter som stöds av data, beskriver lösningarna och deras avvägningar, skriver koden i en isolerad molnsandlåda och öppnar en pull request för godkännande, och följer sedan mätvärden i realtid. Tre loopar ingår från början (cybersäkerhet, latens, tillgänglighet); säkerhetsloopen kombinerar Gemini 4 Carbon med CodeMender, Google DeepMinds agent för kodsäkerhet. Ingenting slås samman utan teamets granskning. Stitch Loop fungerar också som en källa till produktkontext för kodagenter som Google Antigravity, via Stitch CLI och MCP, och kan användas i Slack. Endast en väntelista är öppen, globalt, med prioriterad tillgång för berättigade Google AI Ultra-prenumeranter.
Assistenter för allmänheten: ChatGPT Space för Plus-prenumeranter, GIF i Gemini-appen, Perplexity Computer i Chromium-webbläsare
ChatGPT Space öppnas för Plus-prenumeranter över hela världen
20 november — ChatGPT Space, som presenterades på DevDay den 29 september och hittills varit förbehållet Pro-, Business- och Enterprise-abonnemang, rullas ut över hela världen för Plus-prenumeranter som är 18 år eller äldre. Space ersätter Bibliotek i sidofältet (sidor, presentationsbilder, bilder, uppladdade filer), på webben, i skrivbordsappen, på iOS och på Android.
Där skapar man interaktiva sidor och presentationer med ChatGPT, som andra personer med tillgång till Space kan vidareutveckla. Sidor och presentationsbilder kan uppdateras automatiskt från anslutna appar: OpenAI nämner en uppgiftslista som uppdateras av sig själv eller en projektplan som följer beslut som fattas i Slack. Det räcker att nämna ChatGPT i en kommentar för att begära en ändring, och en dot kan bjudas in att samarbeta. Delningen är fortsatt begränsad: läsbehörighet och ett Plus-, Pro-, Business- eller Enterprise-konto med tillgång till Space krävs; Free-konton kan inte öppna delat innehåll, och det finns ingen offentlig länk.
🔗 Versionsinformation för ChatGPT
Gemini-appen skapar animerade GIF med Gemini Omni 1.2 Flash, gratis i Frankrike
20 november — Gemini-appen skapar nu animerade GIF (loopande fotoeffekter, memes) med Gemini Omni 1.2 Flash, videomodellen som Google lanserade den 5 november, för jämna rörelser och enhetlig kvalitet från bildruta till bildruta, enligt Google. Man skriver sin begäran i huvudchatten eller öppnar bild- eller videoverktyget och väljer sedan GIF-formatet i formatväljaren.
GIFs are now available to all Google AI subscribers and free of charge in the U.S., Japan, Korea, Australia, Canada, U.K., Germany, and France.
🇸🇪 GIF är nu tillgängliga för alla Google AI-prenumeranter, och gratis i USA, Japan, Korea, Australien, Kanada, Storbritannien, Tyskland och Frankrike. — @GeminiApp på X
Franska användare utan abonnemang har alltså tillgång till dem. Google följer efter OpenAI, vars animerade GIF i ChatGPT med Images 2.6 behandlades här den 5 november.
🔗 @GeminiApp på X: GIF i Gemini
Perplexity Computer fungerar direkt i Chromium-webbläsare genom Perplexity-tillägget
20 november — Perplexity Computer fungerar nu direkt i Chromium-baserade webbläsare genom Perplexity-tillägget. Man ger den en uppgift från tilläggets sidopanel och följer sedan Computer när den arbetar i användarens flikar och verktyg. Tillkännagivandet på X anger varken vilka abonnemang som omfattas eller vilka webbläsare som stöds.
Två tidigare steg: den 5 oktober lät Mac-appen 26.38.0 Computer använda Chrome, Edge eller Brave genom ett tillägg, och den 30 oktober kopplade ett Chrome-tillägg Computers Mac- och Windows-appar till användarens webbläsare. Den här gången ges uppgiften från tilläggets sidopanel, i webbläsaren.
API och SDK för utvecklare: Codex i Agents SDK för Python, Decider i Perplexitys Context API
OpenAI släpper en förhandsversion 1.0 av Agents SDK för Python som gör Codex till en modellleverantör
20 november — OpenAI inleder 1.0-serien av Agents SDK för Python med en förhandsversion som byter angreppssätt: i stället för en separat inbyggd motor, som i förhandsversion 0.24 som behandlades här den 16 november, blir Codex en modellleverantör som väljs vid varje körning. Man skapar en CodexProvider och skickar den till Runner via RunConfig(model_provider=provider); agenten körs då med den sparade Codex-inloggningen eller med en API-nyckel.
Python-paketet i wheel-format innehåller Codex Core (rust-v0.166.0, oförändrad) via PyO3: SDK:t anropar Codex kärna direkt, utan att starta codex app-server eller gå via JSON-RPC. Python-verktyg, överlämningar till en specialistagent (handoffs), godkännande före ett verktygsanrop och typad utdata finns kvar, och inbyggda kommandon följer Codex sandlåda och godkännanderegler. Wheel-paketen för 1.0.0a1 distribueras enbart via GitHub Releases (Linux x86-64 och ARM64, macOS 11 och senare på Apple silicon, Windows x64, CPython 3.10 till 3.14). Sparade tillstånd från förhandsversion 0.24.0-alpha.8 är inte kompatibla med Runner, och den stabila versionen är fortfarande 0.25.0 från den 18 november.
🔗 openai-agents-python v1.0.0-alpha.1
Perplexity lägger till Decider i Context API för att poängsätta sidor, inklusive promptinjektioner
19 november — Perplexity lägger till Decider, sin beslutsmodell, i Context API som lanserades två dagar tidigare (1 dollar för 1 000 URL). Man kan ställa upp till fem slutna frågor (ja eller nej) om varje hämtad sida, och Decider poängsätter varje svar från 0 till 1. Användningsområdet som lyfts fram gäller säkerhet: att upptäcka en promptinjektion (prompt injection) på en sida innan en agent läser den. Perplexity nämner också kvalificering av leads, moderering och identifiering av hälsopåståenden utan källa.
API:et filtrerar ingenting självt: det returnerar alla sidor med deras poäng, och applikationens kod tillämpar ett tröskelvärde. Poängsättningen debiteras som indatatokens i Decisions API, utöver priset per URL, och kan förlänga förfrågan med högst 15 sekunder. Dokumentationens cookbook visar en kontroll som kördes den 18 november med ett tröskelvärde på 0,7:
| Testad sida (cookbook från den 18 november) | Injektionspoäng | Kontrollens beslut |
|---|---|---|
| Demonstration av injektion (Greshake et al., 2023) | 0,97 | satt i karantän |
| OWASP, sida om promptinjektion | 0,0018 | vidarebefordrad |
| RFC 9111 | 0,0007 | vidarebefordrad |
Dokumentationens cookbook varnar för att en låg poäng inte gör en sida säker: enligt Perplexitys BrowseSafe++-forskning följde varje testad modell fortfarande vissa injektioner som den själv hade flaggat.
🔗 Tråd från @perplexitydevs · Dokumentation · Cookbook
Kodagenter: Claude Code 2.1.329, Codex CLI 0.171.0, Vibe CLI 3.1.4 och Gemini 4 Neon i Devin
Claude Code 2.1.329 visar var hooks kommer från när en mapp öppnas och samlar schemalagda uppgifter i /tasks
19 november — Claude Code 2.1.329 omfattar 130 poster, varav 91 rättningar, 20 ändringar och 7 tillägg. På säkerhetsområdet visar dialogrutan som frågar om man litar på en mapp nu var dess hooks är deklarerade, och Claude Desktop samt andra icke-interaktiva värdar varnar när hooks som krävs av hanterade inställningar (managed settings) inte laddas. /tasks listar också sessionens schemalagda uppgifter, väckningar från /loop, det aktuella målet och konversationens forks; de flesta schemalagda uppgifter som sparats av tidigare versioner måste schemaläggas på nytt.
/code-review utan angivet mål granskar nu, på de flesta modeller, hela grenen i förhållande till standardgrenen, och med ett PR-nummer läser det själva PR:en via gh pr diff. På macOS övergår computer use till nyare säkerhetsregler som nekar vissa åtgärder. Det automatiska återförsöket som infördes i 2.1.326 efter ett max_tokens-fel tas bort: bakom en gateway måste CLAUDE_CODE_MAX_OUTPUT_TOKENS ställas in. Code Mode får 17 poster, däribland stöd för OpenTelemetry-händelser och mätvärden. Version 2.1.330 finns på npm sedan den 20 november.
Codex CLI 0.171.0 gör GPT-6.2 Sol till standard och aktiverar terminalens arbetsyta
20 november — Codex CLI 0.171.0 är den första stabila versionen sedan 0.170.0 från den 18 november och samlar 339 pull requests. GPT-6.2 Sol och GPT-6.2 Astra läggs till i modellkatalogerna, med Sol som standardval, och kommandona /rc och /remote hanterar lokal fjärrstyrning från terminalen och visar enheternas parkopplingskoder.
Flera nyheter från förhandsversionerna den 14 till 17 november blir stabila: arbetsytan i TUI, som är aktiverad som standard, visar förhandsvisningar av dokument och bilder samt transkriptioner från underagenter bredvid konversationen; codex exec --remote startar eller återupptar en icke-interaktiv session på en befintlig applikationsserver; inmatningsfältet får ångra och gör om; /statusline väljer statusrader som tillhandahålls av en MCP-server, bakom en inställning. Bland rättningarna finns att utkast och köade uppföljningar förblir knutna till sin konversation, och att MCP-anslutningen för företag fungerar med identitetsleverantörer som inte utfärdar någon uppdateringstoken.
Vibe CLI 3.1.4 skiljer agenten från godkännandepolicyn och tar bort agenternas rätt att slopa bekräftelser
20 november — Mistral släpper Vibe CLI 3.1.4, två dagar efter 3.1.3 som gjorde Mistral Large 4 till standardmodell. De 79 posterna (18 tillägg, 41 ändringar, 18 rättningar, 2 borttagningar) gäller främst behörigheter: varje session kombinerar nu två oberoende inställningar, en agent (default, lean eller en anpassad) och en godkännandepolicy (ask, accept-edits, smart-approve eller auto-approve), som väljs med --approval-policy eller default_approval_policy.
En agent bestämmer inte längre själv vad som körs utan att fråga: dess inställningar safety, bypass_tool_permissions och permission = "always" ignoreras. Ett projekt kan inte längre omdefiniera en godkännandepolicy i sin mapp .vibe/agents/, och både forks och undersessioner ärver den ursprungliga policyn. Gränssnittet får en « rad » med etiketter ovanför inmatningsfältet (underagenter, bakgrundsuppgifter, pull requests, mål, uppgifter), inställningen keep_awake förhindrar viloläge under en omgång, och Vibe accepterar systemets certifikat, vilket hjälper det att fungera bakom en företagsproxy. Nu skickas endast de 8 senaste bilderna till Mistrals modeller, och anpassade prompts för compaction tas bort.
Devin öppnar för Gemini 4 Neon, med 46,2 % på FrontierCode 2.0 för 4,38 dollar per uppgift
19 november (inlägg daterat den 18:e) — Efter Cursor och GitHub Copilot, som behandlades här i går, gör Cognition Gemini 4 Neon tillgänglig i Devin Desktop och Devin CLI. På FrontierCode 2.0, dess benchmark som bedömer om en pull request bör slås samman, får Neon 46,2 %, det bästa resultatet för en Google-modell enligt Cognition. Det placerar sig ungefär en procentenhet från Claude Opus 5.5 (47,3 %) till ungefär en tredjedel av kostnaden: 4,38 dollar per uppgift jämfört med 12,82 dollar.
| Modell utvärderad på FrontierCode 2.0 | Poäng publicerad av Cognition |
|---|---|
| Claude Fable 5.2 | 50,2 % |
| Claude Opus 5.5 | 47,3 % |
| Gemini 4 Neon | 46,2 % |
| GPT-6.2 Astra | 44,2 % |
| GPT-6.2 Sol | 43,8 % |
| Gemini 4 Carbon | 42,6 % |
Kostnaden motsvarar den genomsnittliga utgiften per körning enligt API:ets listpris, inklusive offentliga rabatter, och en lösning som inte uppfyller ett avgörande kriterium får noll poäng. Flera poäng i detta diagram skiljer sig från värden som publicerats under tidigare veckor, utan någon förklaring i inlägget.
🔗 Gemini 4 Neon i Devin (Cognition) · @cognition på X
Vetenskap: OpenAI publicerar MedChemBench, ett benchmark för läkemedelskemi där GPT-6.2 Astra får 84,5 %
20 november — OpenAI presenterar MedChemBench, ett benchmark som mäter modellernas förmåga att resonera som en läkemedelskemist: koppla en molekyls struktur till experimentella resultat, jämföra föreningar och förutsäga deras egenskaper. Det samlar 99 problem från 117 artiklar och patent, med 761 unika molekylstrukturer, och poängsätter fyra delar: strukturer, vetenskapligt resonemang, val av föreningar och förutsägelse av egenskaper.
| Utvärderad modell (resonemangsnivå xhigh) | Erhållen poängandel |
|---|---|
| GPT-6.2 Astra | 84,5 % |
| GPT-6 Astra | 83,3 % |
| GPT-6.1 Sol | 82,0 % |
| GPT-6.1 Terra | 75,1 % |
| GPT-5.6 Sol | 58,2 % |
Resultatprofilen är ojämn: GPT-6 Astra får 95,4 % av poängen för strukturer, men ungefär hälften för val av föreningar och förutsägelse av numeriska värden. OpenAI är försiktigt: benchmarken bygger på historiska data och visar inte att modellerna kan upptäcka nya läkemedel, tidigare exponering för källpublikationerna kan inte uteslutas, och endast GPT-modeller har utvärderats. Det följer efter BioBasicsBench, som behandlades här den 6 november.
🔗 MedChemBench presenteras (OpenAI) · Fullständig artikel (PDF)
Generativ video och generativt ljud: ElevenLabs lägger till annonsvarianter utan ny inspelning i Ads Engine
20 november — ElevenLabs utökar Ads Engine, sitt verktyg för annonsskapande som är integrerat i ElevenCreative och lanserades i juni. Anslutet till annonskonton hos Google, Meta, LinkedIn och nu även TikTok utgår det från befintliga annonser och deras resultat för att skapa varianter utan ny inspelning. Det identifierar den inledande uppmärksamhetsväckaren (hook) och skriver nya utifrån annonser som har fungerat; de läses upp av en digital kopia av den ursprungliga talarens röst, med läppsynkronisering och uppdaterade undertexter. Nya ljudspår, komponerade av ElevenLabs Music API utifrån bildernas ton och rytm, kan användas kommersiellt.
För lokalisering, som redan hanteras av Dubbing v2, synkroniserar Ads Engine nu talarens läppar med målspråket och ersätter inbrända undertexter med en översatt version, med varumärkets tidsättning och typsnitt. Mänsklig granskning är fortfarande möjlig före publicering, även av en professionell lokaliserare med målspråket som modersmål, och verktyget kan publicera direkt på plattformarna. Åtkomst fås via säljteamet, utan publicerat pris.
🔗 Varianter och lokalisering av videoannonser i Ads Engine (ElevenLabs)
Notiser
Kodagenter
- Copilot CLI 1.0.115-2 — I denna förhandsversion med 351 poster, varav 335 rättningar, läggs Gemini 4 Hydrogen till i modellväljaren med resonemangsnivån Extra High när kontot har åtkomst, GPT-6.2 Astra stöds, och
/modelhanterar även modeller från anpassade leverantörer; den stabila versionen är fortfarande 1.0.114. 🔗 källa - Codex CLI 0.173.0-alpha.1 och alpha.2 — Versionsanteckningarna för dessa förhandsversioner är tomma; enligt rubrikerna för de 71 commits aktiveras delning av MCP-anslutningar och OAuth-upptäckt av konfigurerade servrar som standard, och administratörer kommer att kunna stänga av uppdateringar av Codex-demonen. Innehållet kan ändras före den stabila versionen. 🔗 källa
- Gemini CLI — Första nightly sedan den 4 november (v0.71.0-nightly.20261120); på huvudgrenen öppnar
gemini --resumeden senast använda sessionen igen, inte den senast startade, och sökvägar som börjar med~\expanderas äntligen under Windows. 🔗 källa - Antigravity IDE 2.8.0 — Googles editor startar sin backend omedelbart och söker efter uppdateringar i bakgrunden, vidarebefordrar portar automatiskt för fjärranslutningar, låter användaren söka i en konversation med tangentbordet och accepterar anpassade certifikat och proxy vid anslutning. 🔗 källa
- Qwen Code 0.28.1-preview.1 — Denna förhandsversion med 179 poster gör GitHub till den tredje kanaladaptern som stöds, lägger till WeCom, Microsoft Teams och generiska utgående webhooks som kan konfigureras via webbgränssnittet, och ger CLI en vy för skärmläsare; den stabila versionen är fortfarande v0.28.0. 🔗 källa
- Kimi Code 2.7.1 och 2.7.2, Kimi Code Desktop 1.4.1 och 1.4.2 — Fyra rättningsversioner dagen efter 2.7.0: resonemangsnivån som valts i ett utkast återställs inte längre till standardvärdet efter att det skickats, och forks misslyckas inte längre efter återställning av en session som styrts om under en pågående omgång. 🔗 källa
- CLI mistral 0.20.1 —
mistral evals execavslutas nu med fel (kod 1) när alla anrop i en körning har misslyckats, till exempel vid ett 401-fel, i stället för att rapportera att körningen lyckats; ett avbrott med Ctrl-C rapporteras som ett sådant. 🔗 källa - Replit — Arbetsytor (Workspaces) går nu att söka efter och fästa, ett alternativ som visas först när det finns fem arbetsytor. 🔗 källa
- Devin Bot för Manim — Cognition visar den Devin Bot som Grant Sanderson har satt upp för att hjälpa honom med Manim, animationssystemet med öppen källkod för 3Blue1Browns videor (96,6 k stjärnor, 250 000 nedladdningar per månad); tweeten anger varken vilka uppgifter boten har fått eller vilka resultat den har uppnått. 🔗 källa
API:er och plattformar
- Gemini API — Sedan den 17 november kan Gemini 3.5 Transcribe, både i standardversionen och i liveversionen, ändra, skriva om och formatera en diktamen eller en befintlig text med röststyrning (parametern
source_text), och Google nämner även översättning. Sedan den 18:e gör API:et det möjligt att bara bearbeta och betala för den användbara delen av uppladdade filer: sidintervall, flikar, celler, tidsintervall eller innehållslager. 🔗 källa - Tidsmedvetenhet i Agents API — Ett experimentellt alternativ (
experimental={"time_awareness": True}) påminner regelbundet modellen om tiden så att den kan anpassa sitt arbete till en tidsgräns; i kombination med asynkrona verktyg kan en agent ställa en fråga och fortsätta söka medan den väntar på svaret, som ett inlägg på OpenAI:s utvecklarblogg visar. 🔗 källa - Konversationshistorik med GPT-6.2 — @OpenAIDevs ber användarna att sluta ändra tidigare meddelanden i Responses API, eftersom API:et kastar bort resonemanget som följer efter ändringen. Det nya avsnittet Reasoning removals på panelen Usage hjälper till att upptäcka detta, och den tillhörande guiden föreslår att man i stället lägger till ett element av typen
configuration_updateelleradditional_toolsför att ändra resonemangsnivån eller verktygen. 🔗 källa
Konsumentassistenter
- ChatGPT rullar ut en ny mobilapp med en flik för dot och fästa favoriter — Codex, Projects eller Images kan fästas i flikfältet; utrullningen börjar med Pro-användare som är 18 år eller äldre där dots finns, med undantag för Europeiska ekonomiska samarbetsområdet (inklusive EU), Storbritannien, Schweiz och Korea, samt med en liten grupp Plus-användare (versionsanteckningar från den 19 november, länkade ovan).
- Teammates från Perplexity — Max-prenumeranter kan nu skapa en teammate från valfri Computer-uppgift på webben och sedan ändra dess namn, roll eller avatar i samma konversation. 🔗 källa
- Perplexitys Mac-app — Den har blivit snabbare och lägger till « Send now » för att styra om en pågående uppgift, ⌘F för att söka i tabeller, Markdown och förhandsvisningar samt ⌘⇧T för att öppna en stängd flik igen. 🔗 källa
Generativ video och generativt ljud
- Seedance 2.5 Flash på Pika — Efter Runway och HeyGen lägger Pika till den snabba varianten av ByteDances videomodell för arbeten med många tagningar: videor på upp till 30 sekunder i 480p eller 720p, med upp till 10 bilder, 5 videor och 5 ljudklipp som referens; tweeten anger inget pris. 🔗 källa
- Avatar 6 från HeyGen — Nya blindtester från den tekniska rapporten: när de filmade personerna, som är anställda på HeyGen, väljer den video som liknar dem mest, vinner Avatar 6 med 86,5 % mot Seedance 2.5 och med 87,9 % mot Wan 3.0; dessa utvärderingar genomförs av HeyGen. 🔗 källa
- Qwen3 TTS hos Together AI — Den öppna talsyntesmodellen Qwen3-TTS-12Hz-1.7B (Apache 2.0) tillhandahålls för 20 dollar per miljon tecken, med nio röster som kan anpassas med en instruktion på vanligt språk, tio språk däribland franska och ett första ljud efter som bäst 97 ms. 🔗 källa
Infrastruktur och forskning
- Together Storage Accelerator — Together AI erbjuder en NVMe-cache för S3-lagring och Hugging Face Hub med varje GPU-kluster, utan kodändringar; enligt företagets mätningar minskar lästiden för en fil på 2 Gio från Cloudflare R2 från 12,7–15,0 s till 0,64–0,72 s, och ett kluster med 200 noder laddar bara ned en gång från ursprungskällan. 🔗 källa
- CDN från Hugging Face — Hugging Face levererar nästan en exabyte öppna modeller och dataset per månad, enligt medgrundaren Julien Chaumond, och har byggt ett eget distributionsnät (CDN) för AI-nedladdningar. 🔗 källa
- Superfluid från basecompute — Den lokala servern fördelar nu inferensen mellan maskiner från Apple, AMD och NVIDIA: sex maskiner ökar genomströmningen från 112 till 534 genererade tokens per sekund för 64 simulerade användare, och när en nod stängs av går ingen begäran förlorad, enligt leverantören. 🔗 källa
- WavLate — Denna öppna modell med sen interaktion söker efter ljud med text och efter text med ljud, med en vektor för varje 0,31 sekund ljud och en per ord; upphovspersonen uppger ett genomsnittligt Recall@1 på 37,9 på AudioCaps och Clotho, bäst av de nio öppna modeller som jämförts, och publicerar vikter och data. 🔗 källa
- WorldTrace — NVIDIA Research presenterar ett minne för interaktiva videovärldsmodeller, utan omträning (artikeln antagen till NeurIPS 2026): på LoopBench förbättras återkallningen av återbesökta scener med 32,6 % jämfört med ett glidande fönster, till priset av 3,1 Go GPU-minne och 27 % längre körtid. 🔗 källa
- Dynamo för förstärkningsinlärning — NVIDIA beskriver hur Dynamo hanterar rollouts under efterträningen: routning utifrån KV-cachen, differentiell överföring av vikter med ModelExpress och återstart av felande arbetsprocesser. Microsoft AI, Cognition (för SWE-1.7), Prime Intellect och H Company använder det; H Company sparar upp till 20 % tid per träningssteg. 🔗 källa
- Gles attention — I en guide från den 17 november ger NVIDIA åtta designregler för gles attention som tränas på dess GPU:er; indexeraren som väljer tokens och Top-k står för 47 % av ett prefill-lager i DeepSeek V3.2 vid 128K tokens. 🔗 källa
GitHub
- GitHub Enterprise Server 3.23 som release candidate — AI-baserad detektering av hemligheter, i offentlig förhandsversion, körs på processorn i appliance-enheten, utan GPU, hostad LLM eller utgående anslutning, även i isolerade miljöer (air-gapped); versionen utökar även detekteringen av kända skadliga paket till ytterligare sju ekosystem utöver npm. 🔗 källa
- Utanför AI — GitHub förtydligar sammanslagningsstatusen på den nya sidan Overview för pull requests, GitHub Desktop 3.7.0 stöder flera konton på samma värd, och översiktspanelen visar upp till 25 favoritmarkerade repon. 🔗 Overview · 🔗 Desktop · 🔗 favoriter
Företag och essäer
- Hebbia — I företagets tester av finansiell research i augusti och september är 99,5 % av de utdrag som citeras av en förhandsversion av GPT-6 Astra relevanta, och modellen uppfyller 97,9 % av presentationskraven, 14,4 procentenheter före det bästa testade alternativet, som inte namnges i den fallstudie OpenAI publicerat. 🔗 källa
- Den tysta samsynen — OpenAI publicerar i sin avdelning Intelligensens tidsålder (Intelligence Age) en essä av Dean Ball, bearbetad från en föreläsning vid Harvard och presenterad som ett uttryck för författarens åsikter, som vänder sig mot tanken att det skulle vara oundvikligt att ge upp människans överordnade ställning; han förespråkar agenter knutna till personer, med begränsade behörigheter som kan återkallas. 🔗 källa
- Databerikning — En guide från Perplexity beskriver hur CRM-poster kan kompletteras och verifieras med en modell ansluten till webben, i sex steg; Apollo genomför 5,6 miljoner berikningar per månad via Perplexitys API. 🔗 källa
Vad det innebär
Anthropics börsintroduktion samlar i ett och samma inlägg pengar från både marknaden och industrin. Det offentliga erbjudandet tillför företaget omkring 91,6 miljarder dollar brutto, och den riktade emissionen ytterligare 26 miljarder, tecknade till samma pris på 83 dollar av sju koncerner inom halvledar- och datorindustrin: AMD, Broadcom, Google, Micron, Microsoft, NVIDIA och TSMC Partners. Totalt närmar sig transaktionen 119,5 miljarder dollar brutto: vid sidan av investerarna i erbjudandet köper sju industrikoncerner aktier i ett AI-labb som nu är noterat på Nasdaq.
Säkerheten hanteras alltmer genom själva verktygens funktionssätt. OpenAI knyter resonemanget i GPT-6.2 till den historik som gav upphov till det, vilket minskar den uppmätta extraktionen från 54,0 % till 0,2 %, men kräver att utvecklarna slutar skriva om sina konversationer. Vibe CLI tar ifrån agenterna rätten att själva häva kraven på bekräftelse, Claude Code visar varifrån en mapps hooks kommer innan man litar på den, och Decider poängsätter sidor innan en agent läser dem. Sakana AI skapar för sin del en grupp som ägnar sig åt kollektivt försvar och lovar att inte publicera material för att utnyttja sårbarheter.
Agenterna går från att skriva kod till att delta i leveranskedjan. Hos Runway styr de 38 % av sammanslagningarna i oktober, och AI godkänner på egen hand ändringar med låg risk; Stitch Loop övervakar en produkt i drift och öppnar pull requests för att nå ett mätbart mål. I båda fallen behåller en människa kontrollen över det som är viktigt: känsliga områden hos Runway, varje sammanslagning hos Stitch Loop. Verktygen följer efter: Agents SDK för Python gör Codex till en modellleverantör, och Cognition utvärderar modeller utifrån den fråga som dessa kedjor väcker, nämligen om en PR ska slås samman.
För öppna modeller ligger fokus på vad man kan få ut av lättare modellvikter. Inkling 2 Mini går igenom sina mittersta lager tre gånger för att matcha Qwen3.8-27B på AA Index med 20 Go, Hugging Faces superadapter rymmer tre specialiseringar i en enda LoRA, och Metric AI utgår från Qwen3.5 för att bygga armeniska modeller. Siffrorna kommer fortfarande från leverantörerna själva, och MedChemBench påminner om utvärderingens begränsningar: OpenAI utvärderar där bara sina egna modeller och utesluter inte att de har sett källpublikationerna.
Källor
- Börsintroduktionen slutförd (Anthropic)
- @AnthropicAI på X: medgrundarna
- Inkling 2 Mini (Thinking Machines)
- Hugging Faces inlägg om Inkling 2 Mini
- Inkling-2-Mini (Hugging Face)
- Tencent Hy4 på Together AI
- Tencents pressmeddelande om Hy4
- Harness-adaptrar i stor skala (Hugging Face)
- @yb2698 på X: superadaptern
- Ayb 0.5 (Metric AI)
- OhanTTS (Metric AI)
- OhanASR (Metric AI)
- @pcuenq på X: Depth Pro 2
- arXiv-artikel 2611.26603: Depth Pro 2
- DepthPro2-L (Hugging Face)
- Att motverka adversarial distillation (OpenAI)
- @OpenAI på X: adversarial distillation
- @hardmaru på X: Security Research Group
- Security Research Group (Sakana AI)
- Att bygga en mjukvarufabrik (Runway)
- Stitch Loop (Google)
- Versionsinformation för ChatGPT
- @GeminiApp på X: tillgång till GIF
- @GeminiApp på X: GIF i Gemini
- @perplexity_ai på X: Computer i Chromium
- openai-agents-python v1.0.0-alpha.1
- @perplexitydevs på X: Decider i Context API
- Poängsätt sidor utifrån kriterier (Perplexitys dokumentation)
- Kokbok mot injektioner (Perplexitys dokumentation)
- Claude Code v2.1.329
- Codex CLI 0.171.0
- Vibe CLI v3.1.4
- Gemini 4 Neon i Devin (Cognition)
- @cognition på X: Gemini 4 Neon
- Presentation av MedChemBench (OpenAI)
- Den fullständiga artikeln om MedChemBench (PDF)
- Varianter och lokalisering av videoannonser i Ads Engine (ElevenLabs)
- Copilot CLI 1.0.115-2
- Codex CLI 0.173.0-alpha.2
- Gemini CLI, PR 30389
- Ändringslogg för Antigravity
- Qwen Code v0.28.1-preview.1
- Kimi Code 2.7.2
- CLI mistral 0.20.1
- Replits ändringslogg från den 20 november
- @cognition på X: Devin Bot för Manim
- Versionsinformation för Gemini API
- Tidsmedvetenhet och asynkron inmatning för personliga agenter (OpenAI)
- @OpenAIDevs på X: historik och resonemang i GPT-6.2
- @AskPerplexity på X: teammates från Computer
- @AskPerplexity på X: Mac-appen
- @pika_labs på X: Seedance 2.5 Flash
- @HeyGen på X: blindtester av Avatar 6
- Qwen3 TTS på Together AI
- Together Storage Accelerator (Together AI)
- @julien_c på X: Hugging Faces CDN
- Superfluid i en maskinflotta (basecompute)
- WavLate (Hugging Face)
- @NVIDIAAI på X: WorldTrace
- Dynamo och RL-rollouts (NVIDIA)
- Gles attention på NVIDIA GPU (NVIDIA)
- GitHub Enterprise Server 3.23 release candidate (GitHubs ändringslogg)
- Sidan Overview för pull requests (GitHubs ändringslogg)
- GitHub Desktop och flera konton per värd (GitHubs ändringslogg)
- Favoritarkiv på instrumentpanelen (GitHubs ändringslogg)
- Hebbia och GPT-6 Astra (OpenAI)
- Den tysta enigheten (OpenAI)
- Databerikning med AI (Perplexity)