ai-powered-markdown-translatorलेख का fr से hi में अनुवाद gpt-5.6-sol के साथ किया गया।
Meta ने Muse लॉन्च किया है, एक निजी एजेंट जो प्रत्येक उपयोगकर्ता को cloud में उसकी अपनी Linux मशीन देता है, और उसी दिन उसने इससे जुड़ी सुरक्षा संरचना भी प्रकाशित की, जिसमें सभी के लिए खुला 300,000 डॉलर तक का भेद्यता पुरस्कार कार्यक्रम (bug bounty) शामिल है। Mistral ने 3 अरब यूरो की Series D की घोषणा की, जो किसी यूरोपीय तकनीकी कंपनी द्वारा अब तक पूरा किया गया सबसे बड़ा इक्विटी वित्तपोषण दौर है। दूसरी ओर, OpenAI ने Navier-Stokes समीकरणों के लिए सीमित समय में singularity का प्रमाण प्रकाशित किया, जिसे एजेंटों की एक प्रणाली ने तैयार किया है, और Google DeepMind ने मानव DNA में संभावित 9 अरब उत्परिवर्तनों के प्रभाव की पूर्व-गणना की है।
Meta ने अपना निजी एजेंट Muse लॉन्च किया और उसकी सुरक्षा संरचना प्रकाशित की
8 सितंबर — Meta ने Muse लॉन्च किया है, जो iOS और Android अनुप्रयोगों, web interface और WhatsApp में उपलब्ध एक निजी एजेंट है तथा Muse Spark 1.3 द्वारा संचालित है। मॉडल नया नहीं है: यह 2 सितंबर को Muse Code और Meta Model API में आया था, और इसका अधिकतम reasoning स्तर 4 सितंबर को सार्वजनिक किया गया था। नया वह आम उपभोक्ताओं के लिए बनाया गया उत्पाद है जो इसके इर्द-गिर्द निर्मित है।
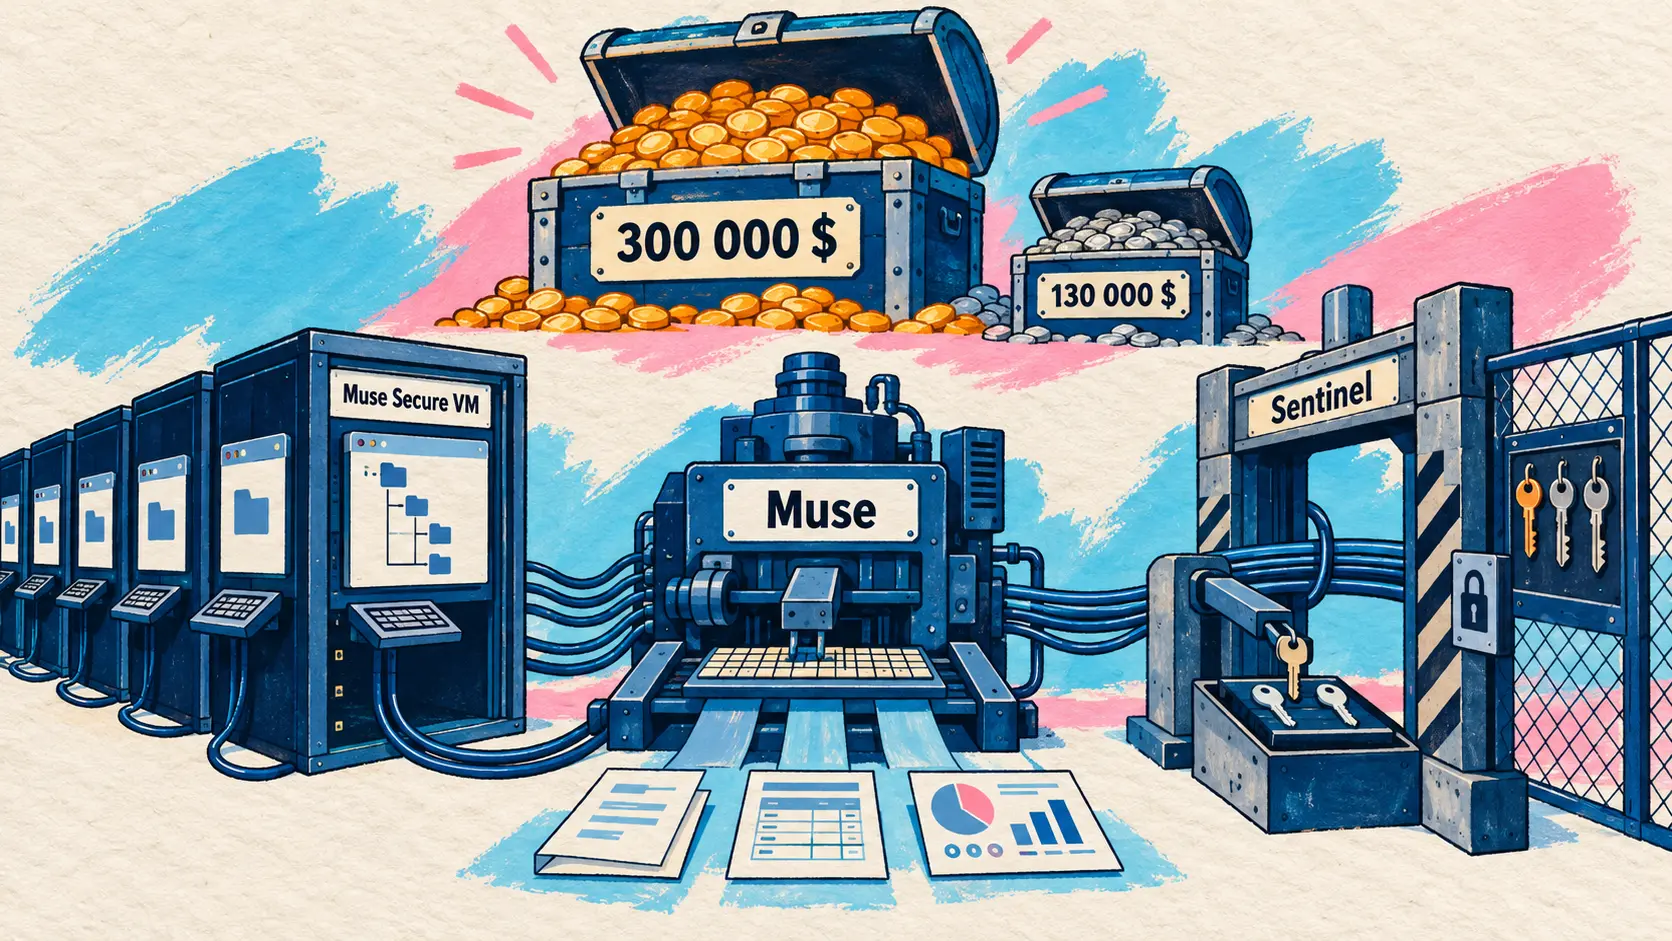
इस संरचना का आधार एक ऐसा विचार है जिसे कहना सरल, लेकिन लागू करना कठिन है: प्रत्येक उपयोगकर्ता को cloud में उसका अपना computer मिलता है। Muse Secure VM एक स्थायी और पृथक Linux मशीन है, जिसमें file system, terminal और पूर्ण browser के साथ इतना storage, processor और memory है कि code compile किया जा सके, मनचाही skills विकसित की जा सकें और कई sub-agents समानांतर चलाए जा सकें। यही मशीन, न कि Meta का कोई केंद्रीकृत infrastructure, जुड़े हुए services के data और credentials के लिए संदर्भ प्रणाली का काम करती है। जब किसी कार्य के लिए कोई tool उपलब्ध नहीं होता, तो एजेंट उसे स्वयं लिखता है, और text blocks के बजाय ऐसे objects तैयार करता है जिन्हें उपयोगकर्ता संशोधित कर सकता है: यात्रा-योजनाएँ, PDF, web pages और dashboards, जिन्हें Meta Artifacts कहता है।
दूसरा घोषित बड़ा बदलाव यह है कि application बंद होने पर भी एजेंट background में, निर्धारित कार्यक्रम के अनुसार और घटनाओं की प्रतिक्रिया में काम करता है, फिर स्वयं तय करता है कि परिणाम notification भेजने योग्य है या नहीं। memory स्थायी है तथा उपयोगकर्ता उसे पढ़ और संशोधित कर सकता है, जबकि Objectives नामक tab एजेंट द्वारा देखी जा रही सभी चीज़ों का समग्र दृश्य देता है। जो बात Meta नहीं बताता, वह यह है कि कोई मूल्य प्रकाशित नहीं किया गया है और लॉन्च के साथ उपलब्धता वाले देशों की कोई सूची भी नहीं दी गई है।
उत्पाद की घोषणा के बीस मिनट बाद, Meta ने इस व्यवस्था की सुरक्षा पर Meta Superintelligence Labs के software engineer और vice president Tarek Sheasha द्वारा हस्ताक्षरित एक engineering दस्तावेज़ प्रकाशित किया। मार्गदर्शक सिद्धांत शुरुआत में ही स्पष्ट कर दिया गया है: प्रणाली को इस धारणा के साथ बनाया गया है कि एजेंट पर हमला होगा। code में Hatch कहलाने वाला agentic harness एक systemd-nspawn container में चलता है, जिसका root host के एक गैर-विशेषाधिकार प्राप्त उपयोगकर्ता से mapped है, system calls filtered हैं और kernel capabilities हटा दी गई हैं। चार services को जानबूझकर इस container से बाहर रखा गया है, ताकि एजेंट को compromise करने वाला हमलावर उन्हें निष्क्रिय न कर सके: सुरक्षा classifiers, अलग privileges वाले workers, credentials storage daemon और Sentinel।
Sentinel इसका केंद्रीय घटक है: connector action या network egress को अधिकृत करने में सक्षम एकमात्र प्राधिकरण होने के नाते, यह layers 4 और 7 पर प्रत्येक request का मूल्यांकन करता है और वास्तव में resolve हुए address की जाँच करता है। सबसे महत्वपूर्ण बात यह है कि एजेंट केवल substitution tokens का उपयोग करता है, जिन्हें network boundary पर वास्तविक credentials से बदल दिया जाता है। prompt injection के माध्यम से एजेंट से कोई secret उगलवाना निरर्थक हो जाता है, क्योंकि वह secret उसके पास कभी था ही नहीं। इसके साथ kernel स्तर पर flow tracking भी जुड़ी है, जिसे tainted egress कहा गया है: उपयोगकर्ता का data पढ़ने वाली प्रत्येक process को चिह्नित कर दिया जाता है और वह अपना automatic authorization खो देती है। implementation में cgroups से जुड़े eBPF programs और Meta द्वारा जोड़े गए Linux Security Module hooks का संयोजन किया गया है।
| संरचना का घटक | चुना गया विकल्प |
|---|---|
| agentic harness का container | systemd-nspawn, root को गैर-विशेषाधिकार प्राप्त उपयोगकर्ता से mapped किया गया |
| authorization प्राधिकरण | Sentinel, container के बाहर, layers 4 और 7 |
| एजेंट को दिखाई देने वाले credentials | केवल substitution tokens |
| email connector | one-time codes और reset links की filtering |
| browser sub-agent | accessibility tree, raw DOM नहीं, page में JavaScript नहीं |
| भुगतान | लॉन्च के समय Stripe Link, बाद में Shop Pay, single-use card |
| bug bounty, प्रति वैध report अधिकतम | 300,000 डॉलर |
| bug bounty, prompt injection | 130,000 डॉलर तक |
दस्तावेज़ के साथ दो घोषणाएँ की गई हैं। भेद्यता पुरस्कार कार्यक्रम लॉन्च के समय से ही सभी के लिए खुला है, जिसमें प्रमाणित प्रभाव के आधार पर प्रति वैध report 300,000 डॉलर तक और किसी उपयोगकर्ता को प्रभावित करने वाले सफल prompt injection के लिए 130,000 डॉलर तक दिए जाएँगे। वहीं, वर्ष के अंत तक आने वाली Muse Confidential VM का उद्देश्य cryptographic और सत्यापन योग्य तरीके से Meta को किसी virtual machine के data तक पहुँचने से रोकना है; इसकी design और source code पहले ही बाहरी auditors को सौंपे जा चुके हैं। लेख का निष्कर्ष किसी कंपनी के प्रकाशन के लिए असामान्य रूप से स्पष्ट है: prompt injection उद्योग में अब भी एक अनसुलझी समस्या है, और Muse गलतियाँ करेगा।
🔗 Muse का लॉन्च · 🔗 एजेंटों की सुरक्षा और संरक्षा, Meta
Mistral ने 3 अरब यूरो जुटाए, यूरोपीय तकनीकी क्षेत्र का सबसे बड़ा इक्विटी वित्तपोषण दौर
8 सितंबर — Mistral ने 3 अरब यूरो की Series D की घोषणा की है, जिसमें post-money valuation 21 अरब यूरो से अधिक है। कंपनी अपनी स्थापना के केवल तीन वर्ष बाद हुए इस दौर को किसी यूरोपीय तकनीकी कंपनी द्वारा अब तक पूरा किया गया सबसे बड़ा इक्विटी वित्तपोषण बताती है।
Samsung Electronics इस सौदे का नेतृत्व कर रहा है। EQT द्वारा प्रबंधित Scaleup Europe Fund और पहले से शेयरधारक PSG Equity इसके सह-नेता हैं। तीन नए निवेशक इसमें शामिल हुए हैं: Advent, BlackRock द्वारा प्रबंधित funds और accounts, तथा Grand Duchy of Luxembourg। मौजूदा निवेशकों की सूची लंबी है और तीन महाद्वीपों तक फैली है, जिसमें a16z से Salesforce Ventures तक और ASML, BNP Paribas CIB, Bpifrance, DST Global, General Catalyst, Index Ventures, Korelya Capital, Lightspeed तथा NVIDIA शामिल हैं।
ध्यान देने योग्य विवरण लगातार हुए दोनों दौरों के प्रमुख निवेशकों की प्रकृति है। Series C का नेतृत्व ASML ने किया था और Series D का नेतृत्व Samsung Electronics कर रहा है: दोनों advanced manufacturing की औद्योगिक कंपनियाँ हैं, न कि सामान्य तकनीकी funds। Mistral इसे जटिल औद्योगिक परिवेशों में अत्याधुनिक models तैनात करने की अपनी क्षमता पर भरोसे का संकेत मानता है, जहाँ data और infrastructure पर नियंत्रण ही अपनाए जाने की शर्त तय करता है।
| संकेतक | मान |
|---|---|
| जुटाई गई राशि | 3 अरब यूरो |
| post-money valuation | 21 अरब यूरो से अधिक |
| कंपनी की आयु | 3 वर्ष |
| प्रमुख निवेशक | Samsung Electronics |
| सह-प्रमुख निवेशक | EQT द्वारा प्रबंधित Scaleup Europe Fund, PSG Equity |
| संचालन वाले देश | 20 |
| बड़े corporate ग्राहक | 125 से अधिक, जिनमें Airbus, ASML और HSBC शामिल हैं |
धन के उपयोग में कंपनी सबसे पहले frontier research, फिर training के लिए computing capacity बढ़ाने, infrastructure के विस्तार और अंतरराष्ट्रीय व्यावसायिक तेजी का उल्लेख करती है। इसका तर्क गर्मियों से अपनाए गए रुख को दोहराता है: संगठनों के सामने अब यह प्रश्न नहीं होगा कि सबसे शक्तिशाली model कौन बनाता है, बल्कि यह होगा कि अपने infrastructure का नियंत्रण छोड़े बिना AI का उपयोग कैसे किया जाए। Mistral स्वयं को इस क्षेत्र की एकमात्र ऐसी कंपनी बताता है जो आवश्यक पूरी stack को जोड़ती है—open-weight models से लेकर products और computing capacity तक।
Today marks a major step for Mistral: we’re announcing a €3B Series D, the largest equity round ever raised by a European tech company, just three years after launch.
🇮🇳 आज Mistral के लिए एक महत्वपूर्ण उपलब्धि का दिन है: हम 3 अरब यूरो की Series D की घोषणा कर रहे हैं, जो हमारे लॉन्च के केवल तीन वर्ष बाद किसी यूरोपीय तकनीकी कंपनी द्वारा अब तक पूरा किया गया सबसे बड़ा इक्विटी वित्तपोषण दौर है। — X पर @MistralAI
OpenAI के वैज्ञानिक एजेंट: Navier-Stokes पर एक प्रमाण, MIT में calibrate किए गए qubits
8 सितंबर — OpenAI ने त्रि-आयामी Navier-Stokes समीकरणों के लिए सीमित समय में singularity बनने का प्रमाण प्रकाशित किया है, जिसके साथ Lean proof assistant में उसका formalization भी दिया गया है। घोषित परिणाम यह है कि शुरू में smooth और स्थिर कोई त्रि-आयामी fluid, जब किसी smooth बाहरी force के अधीन हो, तो सीमित समय में उसकी velocity असीमित रूप से बढ़ सकती है, जबकि viscosity गति को smooth करने की ओर प्रवृत्त रहती है और system की energy सीमित बनी रहती है। Clay Mathematics Institute के आधिकारिक formulation में यह “C” और “D” statements के अनुरूप है, जो regularity का प्रमाण नहीं बल्कि उसका खंडन प्रस्तुत करते हैं।
OpenAI क्या दावा करता है और क्या दावा नहीं करता, इसे सटीक रूप से स्पष्ट करना आवश्यक है। यह प्रमाण सार्वजनिक नाम से रहित एक internal model से जुड़े समन्वित agents की प्रणाली ने तैयार किया है। कंपनी इसे GPT-6 Astra से उल्लेखनीय रूप से अधिक सक्षम बताती है और इसका training 28 अगस्त से जारी है। वर्णित एकमात्र verification Lean में formalization है, जिसे GPT-6 Astra को सौंपा गया और समाधान मिलने के 17 घंटे बाद पूरा किया गया। घोषणा में न तो किसी peer review का उल्लेख है, न ही Clay Mathematics Institute द्वारा validation का। OpenAI का कहना है कि वह millennium prize का दावा करने का इरादा नहीं रखता और अपने परिणाम को अंतिम उपलब्धि के बजाय एक तत्कालीन झलक के रूप में प्रस्तुत करता है।
इसकी विधि कम से कम परिणाम जितनी ही उल्लेखनीय है। यह प्रयास 1 सितंबर को शुरू हुआ, जब अफवाहें फैली थीं कि millennium की दो समस्याएँ अभी-अभी हल कर ली गई हैं। अलग-अलग agent groups को statement के अलग variants दिए गए: “A” और “B” versions को प्रमाण की दिशा में तथा “C” और “D” versions को खंडन की दिशा में लगाया गया। एक सहायक समस्या, बिना बाहरी force वाले Euler समीकरणों की regularity, पर लगभग 100 agents ने करीब पचास घंटे में एक खंडन तैयार किया; इस परिणाम को Navier-Stokes पर काम कर रहे agents के prompts में फिर से शामिल किया गया।
| metric | मान |
|---|---|
| concurrent agents, Navier-Stokes group | लगभग 10,000 |
| समाधान मिलने तक का समय | लगभग 88 घंटे |
| Lean में formalization और verification | GPT-6 Astra के माध्यम से 17 अतिरिक्त घंटे |
| आदान-प्रदान किए गए messages, Navier-Stokes | 2.7 मिलियन |
| output tokens, Navier-Stokes | लगभग 130 अरब |
| आदान-प्रदान किए गए messages, सभी आजमाई गई समस्याएँ | 4.9 मिलियन |
| output tokens, सभी आजमाई गई समस्याएँ | लगभग 300 अरब |
| बिना बाहरी force वाले Euler की regularity का खंडन | लगभग 100 agents, करीब 50 घंटे |
समानांतर हुए एक अन्य शोध से तस्वीर जटिल हो जाती है। Anthropic के कर्मचारी Levent Alpöge और NYU में गणित के professor Tristan Buckmaster के पास बाहरी force वाले Euler समीकरणों पर एक परिणाम था। OpenAI ने अपना project पूरा और verify करने के बाद 6 सितंबर को संयुक्त प्रकाशन का प्रस्ताव देने और उनकी प्राथमिकता स्वीकार करने के लिए उनसे संपर्क किया, लेकिन बाद में पता चला कि उनका परिणाम OpenAI के statement से अलग statement पर आधारित था।
This model represents a step-function improvement on many benchmarks, and its training is ongoing. Our internal model group arrived at the Navier–Stokes solution in 88 hours, using around 10,000 coordinating AI agents. Throughout the effort, we maintained the strict safeguards—including monitoring and isolation—that we apply to all our frontier evaluations.
🇮🇳 यह model कई benchmarks पर चरणबद्ध रूप से बड़ा सुधार दर्शाता है, और इसका training जारी है। हमारा internal model group लगभग 10,000 समन्वित AI agents के साथ 88 घंटों में Navier-Stokes के समाधान तक पहुँचा। पूरे प्रयास के दौरान हमने monitoring और isolation सहित वे कड़े safeguards बनाए रखे जिन्हें हम frontier models के अपने सभी evaluations पर लागू करते हैं। — X पर @OpenAI
उसी दिन OpenAI ने कहीं अधिक सीमित और कहीं अधिक सत्यापन योग्य case study प्रकाशित की। MIT के Engineering Quantum Systems group की PhD छात्रा Beatriz Yankelevich ने GPT-5.6 Sol द्वारा संचालित Codex को उसके experiments समन्वित करने वाले software से जोड़कर छह uncalibrated superconducting qubits वाली chip को calibrate किया। agents को प्रत्येक measurement type के लिए अलग skills दी गईं, जिनमें measurement करने और उसका मूल्यांकन करने का तरीका बताया गया था। स्पष्ट signals पर Codex ने बहुत कम हस्तक्षेप के साथ पूरी sequence पूरी की: transition frequencies की पहचान, control और readout pulses का calibration तथा quantum information के संरक्षण की अवधि का measurement। कमजोर या noisy signals पर उपयोगी parameters खोजने में इसे अधिक समय लगता है और कभी-कभी यह किसी अनुभवी researcher की निगाह की माँग करता है, जो model से तेज रहता है। इसलिए लाभ गति नहीं, बल्कि निरंतर supervision की आवश्यकता समाप्त होना है: ऐसी एक standard chip के characterization में किसी researcher के कई दिन लगते हैं, और group अब routine measurements agents को सौंपता है।
🔗 Navier-Stokes समाधान, OpenAI · 🔗 Codex और quantum experiments, OpenAI
ChatGPT Images 2.5, Sketch और API में दो इमेज मॉडल के साथ
8 सितंबर — OpenAI ने अपने उत्पादों और API में ChatGPT Images 2.5 लॉन्च किया। शुरुआत में दिया गया उपयोग का आँकड़ा इसके महत्व को दर्शाता है: ChatGPT Images और API के GPT-Image मॉडल पर हर सप्ताह 3 अरब से अधिक इमेज बनाई जाती हैं। सबसे ठोस सुधार विलंबता में है, जो Images 2.0 की तुलना में 50 प्रतिशत तक कम हुई है; अन्य सुधार संदर्भ फ़ोटो के प्रति निष्ठा और लंबी बातचीत के दौरान निरंतरता से जुड़े हैं, जिसमें पहले किए गए बदलाव बेहतर ढंग से संरक्षित रहते हैं।
ChatGPT में तीन सुविधाएँ आ रही हैं। Sketch से « @Sketch » टाइप करके सीधे बातचीत में चित्र बनाया जा सकता है, जो दृश्य मार्गदर्शक का काम करता है। templates में पोस्टर या merchandising जैसे सामान्य प्रारूप शामिल हैं। किसी विशेष हिस्से में बदलाव करने के लिए इमेज पर टिप्पणियाँ जोड़ी जा सकती हैं। अब इमेज साझा करते समय उसे बनाने वाला prompt भी शामिल किया जा सकता है। यह सुविधा desktop, mobile और web पर सभी स्तरों के ChatGPT उपयोगकर्ताओं, ChatGPT Work और Codex के लिए उपलब्ध कराई जा रही है।
| API में मॉडल | घोषित उपयोग-स्थिति | विलंबता |
|---|---|---|
| GPT-Image-2.5 Flare | डिफ़ॉल्ट विकल्प, सामाजिक सामग्री, बड़े पैमाने पर निर्माण | Images 2.0 से 50 प्रतिशत तक कम |
| GPT-Image-2.5 Sunburst | सटीकता, प्रसारण के लिए तैयार अभियान | निर्माण में अधिक समय |
दोनों मॉडल गुणवत्ता की नई सेटिंग्स xhigh और max का समर्थन करते हैं और GPT Image 2 की token कीमतें अपनाते हैं: Standard स्तर पर प्रति दस लाख image input tokens के लिए 8.00 डॉलर, image output के लिए 30.00 डॉलर और text input के लिए 5.00 डॉलर। C2PA metadata और अदृश्य watermark बरकरार रखे गए हैं तथा रिलीज़ के साथ एक system card भी दी गई है।
Manus ने उसी दिन मॉडल को एकीकृत किया
घोषणा वाली शाम Manus ने GPT-Image-2.5 को अपने प्लेटफ़ॉर्म में जोड़ा और डेढ़ घंटे पहले प्रकाशित OpenAI के संदेश का उल्लेख किया। 1 सितंबर को फिर से स्वतंत्र हुई इस agent प्रयोगशाला ने अपने स्वयं के मूल्यांकन से निकला आँकड़ा प्रस्तुत किया है, न कि OpenAI के मूल्यांकन से: उसके अनुसार Flare नाम वाला मॉडल GPT-Image-2 की तुलना में दो से चार गुना तेज़ गति से उच्च-गुणवत्ता वाली इमेज बनाता है। बातचीत के दौरान लगातार दृश्य सामग्री बनाने वाले agent के लिए यह कारक गुणवत्ता में मामूली सुधार से अधिक महत्वपूर्ण है, क्योंकि इसी से तय होता है कि निर्माण कार्यप्रवाह में बना रहेगा या प्रतीक्षा करनी पड़ेगी। Manus ने पारदर्शी background के बेहतर निर्माण को भी प्रमुखता दी है, जिससे पूर्ण automation को बाधित करने वाला हाथ से विषय काटकर अलग करने का चरण समाप्त हो जाता है।
AlphaGenome Atlas, मानव DNA के 9 अरब mutations का पूर्वानुमान मानचित्र
8 सितंबर — Google DeepMind ने AlphaGenome Atlas लॉन्च किया, जो मानव DNA में एक अक्षर के हर संभव mutation के आणविक प्रभाव का पूर्वानुमान लगाने वाला database है। मानव genome में लगभग 3 अरब base pairs हैं, जिनमें केवल 2 प्रतिशत protein को code करते हैं; शेष 98 प्रतिशत अब भी काफी हद तक अन्वेषित हैं, जबकि वहाँ केवल एक अक्षर का बदलाव भी किसी आवश्यक जैविक regulator को निष्क्रिय कर सकता है।
इस पद्धति का आधार गणनात्मक भार को उलटना है। हर प्रयोगशाला को model से एक-एक variant के बारे में पूछने देने के बजाय Google DeepMind ने सभी 9 अरब संभावित substitutions के लिए AlphaGenome model के पूर्वानुमान पहले ही गणना कर लिए हैं। इसका परिणाम 1 petabyte का dataset है, जिसे AlphaFold Database के आकार से तीस गुना अधिक बताया गया है। इस मात्रा को उपयोगी बनाने के लिए Atlas ने AVI score (AlphaGenome Variant Impact) प्रस्तुत किया है। यह एकल संख्या coding और non-coding क्षेत्रों के पूर्वानुमानों को समेकित करके बताती है कि कोई variant किन जैविक प्रक्रियाओं को बाधित करता है और प्रत्येक विशेषता के अनुसार उसका योगदान भी दर्शाती है। इसके साथ 2,500 से अधिक बार दोहराए जाने वाले sequence motifs की सूची भी है—वे regulatory units जिन्हें Google genome के « शब्द » कहता है।
| मापदंड | मान |
|---|---|
| पहले से गणना किए गए variants | 9 अरब, एक अक्षर के सभी बदलाव |
| dataset का आकार | 1 petabyte, AlphaFold Database से 30 गुना से अधिक |
| सूचीबद्ध sequence motifs | 2,500 से अधिक |
| विश्लेषित UK Biobank प्रतिभागी | 54,000 से अधिक |
| अतिरिक्त non-coding associations | 22 प्रतिशत अधिक |
| BMI से जुड़े पहचाने गए genetic regions | 19 |
दस्तावेज़ित किए गए दो उपयोग इस लाभ का पैमाना दिखाते हैं। Broad Institute में Laura Covill और उनकी टीम ने निदान से वंचित दुर्लभ रोगों के संभावित variants को प्राथमिकता देने के लिए AVI score का उपयोग किया। उपकरण ने DNM1 gene के एक variant को प्रमुखता दी और पूर्वानुमान लगाया कि वह एक गलत splicing site बनाता है, जिससे मामले को हल करने वाला निर्णायक प्रमाण मिला। University of Exeter में Gareth Hawkes ने Atlas को UK Biobank के 54,000 से अधिक प्रतिभागियों के data पर लागू किया और 22 प्रतिशत अधिक non-coding genetic associations प्राप्त किए। इसके बाद सबसे अधिक प्रभाव डालने वाले 1 प्रतिशत variants तक सीमित रहकर उन्होंने body mass index से जुड़े 19 genetic regions पहचाने।
पहुँच इसका दूसरा उल्लेखनीय पहलू है। Atlas बिना code लिखे उपयोग किए जा सकने वाले web portal के माध्यम से उपलब्ध है, जो programming न करने वाले चिकित्सकों और जीवविज्ञानियों के लिए बनाया गया है। यह AlphaGenome API, Model Garden के माध्यम से Cloud पर और GitHub पर प्रकाशित research data के रूप में भी उपलब्ध है। Google के agent ecosystem पर नज़र रखने वाले developers के लिए एक खास बात यह है कि Atlas को Google Antigravity में एक skill के रूप में भी वितरित किया गया है, इसलिए coding agent इसका सीधे उपयोग कर सकता है।
🔗 AlphaGenome Atlas, Google DeepMind
NVIDIA ने CUDA Rust लॉन्च किया और Cosmos ने ECCV का AI City Challenge जीता
8 सितंबर — NVIDIA ने CUDA Rust जारी किया, जो एक स्पष्ट होती कमी का उसका उत्तर है: AI की systems layer तेजी से Rust में लिखी जा रही है, लेकिन GPU kernel इसका अपवाद बना हुआ था। Rust से kernel पहले भी चलाया जा सकता था, लेकिन उसे कहीं और लिखना पड़ता था। CUDA Rust, Rust kernels को मूल रूप से PTX में compile करके इस अंतर को समाप्त करता है। इसके लिए दो अलग मार्ग हैं, जो CUDA द्वारा C++ और Python में पहले से उपलब्ध दो programming models के अनुरूप हैं।
| घटक | cuda-oxide, SIMT मार्ग | cutile-rs, Tile मार्ग |
|---|---|---|
| परिपक्वता | शुरुआती alpha | crates.io पर प्रकाशित |
| आवश्यक Rust toolchain | निश्चित nightly (nightly-2026-04-03) | stable 1.89 या अधिक |
| CUDA version | 12.x या अधिक | 13.3 |
| आवश्यक LLVM | हाँ, साथ में clang और libclang | नहीं |
| compilation | build के समय PTX में | CUDA Tile IR के माध्यम से JIT |
| उल्लिखित बाहरी उपयोग | कोई नहीं | Hugging Face का Grout, mistral.rs |
NVIDIA की सिफारिश स्पष्ट है: Tile से शुरुआत करें, क्योंकि तब source code में किसी architecture-विशिष्ट विकल्प को दर्ज नहीं करना पड़ता, और threads तथा memory पर सूक्ष्म नियंत्रण आवश्यक होने पर SIMT पर जाएँ। फिलहाल इस चुनाव की एक कीमत है, क्योंकि SIMT में तेज़ kernels की नींव shared memory के लिए अभी भी unsafe आवश्यक है। मूल तर्क compile-time memory safety है: दोनों मार्ग उस पारंपरिक aliasing को अस्वीकार करते हैं जिसमें एक buffer input और output दोनों के रूप में काम करता है—SIMT की ओर error[E0502] और Tile की ओर error[E0382] के साथ। परिपक्वता के मामले में NVIDIA बढ़ा-चढ़ाकर दावा नहीं करता: दोनों में से कोई भी project production के लिए तैयार नहीं है, और घोषित प्रतिबद्धता 2027 तथा उसके आगे तक की है, जिसमें rust-cuda के maintainers के साथ संयुक्त कार्य शामिल है।
उसी दिन NVIDIA ने ECCV 2026 के AI City Challenge के परिणाम जारी किए। यातायात दृश्यों के generative video forecasting को समर्पित track 5 में शीर्ष पाँच में से चार solutions Cosmos world foundation models के versions का उपयोग करते हैं। Qyn टीम ने CosmosAlign के साथ सार्वजनिक ranking जीती। यह 16 अरब parameters वाले स्थिर Cosmos3-Nano model को दो-चरणीय LoRA विधि से अनुकूलित करता है, चार पूर्वानुमान बनाता है, medoid चुनता है और देखे गए इतिहास के स्थिर क्षेत्रों को फिर शामिल करता है: SSUPER टीम के 76.04 के मुकाबले 76.39, यानी 0.35 अंक की बढ़त। NVIDIA यह स्पष्ट करता है कि यह अनुकूलन और inference की विधि है, कोई नई architecture नहीं। Cosmos निर्णायक की भूमिका में भी दिखाई देता है: track 3 की दोनों out-of-domain rankings में UWIPL_ETRI टीम ने UniTraffic के साथ जीत हासिल की, जो विवादित दावों की जाँच एक स्वतंत्र Cosmos-Reason1 verifier से कराता है।
🔗 CUDA Rust, NVIDIA · 🔗 AI City Challenge के परिणाम
Cognition ने 2 अरब डॉलर से अधिक जुटाए और 48 अरब डॉलर के मूल्यांकन तक पहुँचा
8 सितंबर — development agent Devin की निर्माता Cognition ने 48 अरब डॉलर के मूल्यांकन पर 2 अरब डॉलर से अधिक की funding जुटाने की घोषणा की। इस round का नेतृत्व दो नए निवेशकों Andreessen Horowitz और Accel ने किया, जिनके साथ मौजूदा निवेशक Founders Fund, General Catalyst और Avenir भी शामिल रहे। लगभग तीस अन्य प्रतिभागियों में NVIDIA, Benchmark, Bessemer, Kleiner Perkins, Greylock, Lightspeed, T. Rowe Price और Bain Capital Ventures शामिल हैं।
| संकेतक | मई 2026 | सितंबर 2026 |
|---|---|---|
| जुटाई गई राशि, round का कुल | 1 अरब डॉलर से अधिक | 2 अरब डॉलर से अधिक |
| मूल्यांकन | 26 अरब डॉलर | 48 अरब डॉलर |
| वार्षिकीकृत राजस्व | 492 मिलियन डॉलर | लगभग 900 मिलियन डॉलर |
| प्रमुख निवेशक | Lux Capital, General Catalyst, 8VC | Andreessen Horowitz, Accel |
इस प्रकार चार महीनों में मूल्यांकन लगभग दोगुना और एक वर्ष में करीब पाँच गुना हो गया है, जबकि वार्षिकीकृत राजस्व भी इसी गति से बढ़ा है। Cognition ने इस वृद्धि को आगे बढ़ाने वाले उपयोगों का विवरण दिया है: Devin, NVIDIA में chip design, GE Aerospace में aviation, Citi में financial services, Mercedes-Benz में automotive और Modal में AI infrastructure पर काम करता है। NVIDIA का इस round में ग्राहक और निवेशक दोनों होना दिखाता है कि ये कंपनियाँ आंतरिक रूप से उपयोग किए जाने वाले उपकरणों तक अपनी पहुँच किस तरह सुरक्षित करती हैं। तीन हालिया क्षमताएँ Devin को कार्य निष्पादन से autonomous action की ओर ले जाती हैं: घटना की शुरुआती जाँच के लिए Auto-Triage, vulnerabilities को छाँटने के लिए Security Swarm और Slack, GitHub या Linear की घटनाओं से सक्रिय होने वाला Automations। एक वर्ष में छह कार्यालय खोले गए हैं, जिनमें पाँच संयुक्त राज्य अमेरिका से बाहर हैं; ये San Francisco, New York और Austin के केंद्रों के अतिरिक्त हैं।
In the next chapter of software engineering, agents will become proactive by default, software will improve itself, and compute will automatically get allocated toward the highest impact use cases. We’re still at the dawn of the self-driving software era.
🇮🇳 software engineering के अगले अध्याय में agents डिफ़ॉल्ट रूप से सक्रिय होंगे, software स्वयं को बेहतर बनाएगा और computing power अपने-आप सबसे अधिक प्रभाव वाले उपयोगों के लिए आवंटित होगी। हम अभी autonomous software के युग की शुरुआत में ही हैं। — X पर @cognition
Suno ने Believe और TuneCore के साथ समझौता किया, जिन्होंने कल तक उसका संगीत वितरित करने से इनकार किया था
8 सितंबर — Suno ने artist development कंपनी Believe और उसके self-distribution platform TuneCore के साथ वैश्विक रणनीतिक साझेदारी की घोषणा की। समझौता दो अलग विषयों से जुड़ा है। पहला, Believe उन नए music models के design में भाग लेगा जिन्हें Suno industry के साथ मिलकर विकसित कर रहा है। दूसरा, और उपयोगकर्ताओं के लिए यही ठोस बिंदु है, इस नए partner model से बनाए गए गाने Believe और TuneCore के माध्यम से Spotify, Apple Music, Amazon Music और YouTube पर वितरण के योग्य होंगे।
इस घोषणा का संदर्भ इसका महत्व स्पष्ट करता है। Suno साफ़ तौर पर याद दिलाता है कि इस वर्ष की शुरुआत में Believe और TuneCore ने घोषणा की थी कि वे उन models से बना संगीत वितरित नहीं करेंगे जो उनके मानदंडों को पूरा नहीं करते, जिनमें उस समय के Suno models भी शामिल थे। इस बदलाव को ऐसी चर्चाओं का परिणाम बताया गया है जिनमें साझा मूल्य सामने आए: artists को वास्तविक विकल्प देना और वितरण तथा आय के रास्ते खोलना।
यह समझौता घटनाओं के एक सुसंगत क्रम का हिस्सा है। यह स्वतंत्र और उभरते artists के लिए Suno के कार्यक्रम Spark को आगे बढ़ाता है तथा Warner Music Group और BMG के साथ मौजूदा समझौतों में independent labels और self-produced artists को जोड़ता है। Suno इसे अपने हालिया safeguards से भी स्पष्ट रूप से जोड़ता है: platform के बाहर उसके गानों की पहचान के लिए audio watermark और acoustic fingerprint, तथा streaming services पर बड़े पैमाने पर प्रसार रोकने के लिए 3 सितंबर से लागू download limits। ये सुरक्षाएँ Believe और TuneCore द्वारा वितरित संगीत पर भी लागू होंगी। घोषणा एक समय-सारिणी के साथ समाप्त होती है: Suno बहुत जल्द अपने नए models लॉन्च करेगा, जिनकी family को 4 सितंबर को v6 नाम दिया गया था।
Cohere ने megakernel पर आधारित serving इंजन जारी किया, जो vLLM से 1.58x तेज़ है
8 सितंबर — Cohere ने पूरी तरह decoding megakernel पर निर्मित inference serving इंजन Apache 2.0 लाइसेंस के अंतर्गत जारी किया। कंपनी इसे पहली उपलब्धि बताती है: यह प्रयोगशाला में गति का प्रदर्शन नहीं, बल्कि OpenAI-संगत endpoint के पीछे वास्तविक अनुरोध संभालने में सक्षम पूरा server है, जिसमें continuous batching, paged attention, prefix cache और tool calling शामिल हैं। इससे serve किया जाने वाला model North Mini Code है, जो 30 अरब parameters वाला mixture of experts है और जिसके प्रति token केवल 3.3 अरब parameters सक्रिय होते हैं।
जिस समस्या को हल किया गया है, उसे एक वाक्य में कहा जा सकता है: decoding के दौरान GPU गणना करने के बजाय प्रतीक्षा में बहुत समय बिताता है। पारंपरिक stack प्रत्येक operation के लिए एक kernel शुरू करता है, और हर kernel boundary पूरी compute grid पर एक barrier लगाती है। लेकिन autoregressive decoding memory bandwidth से सीमित होती है: हर चरण में North Mini Code, HBM memory से 6.6 GB weights और 8K context पर लगभग 0.5 GB key-value cache स्थानांतरित करता है, जिससे H100 की 3.35 TB/s गति पर सैद्धांतिक सीमा लगभग 470 tokens प्रति सेकंड बनती है। Megakernel एक ऐसा persistent kernel शुरू करके इन boundaries को हटा देता है, जो पूरे decoding चरण के दौरान resident रहता है और जिसकी dependencies global memory में counters तक सीमित रहती हैं।
| माप | Megakernel | vLLM v0.24 | बढ़त |
|---|---|---|---|
| Decoding, batch size 1, context 8K (tok/s) | 292 | 185 | 1.58x |
| AIME 2025, आरंभ से अंत तक (tok/s) | 935 | 661 | 1.41x |
| SciCode, आरंभ से अंत तक (tok/s) | 711 | 560 | 1.37x |
| MMLU-Pro, computer science subset (tok/s) | 948 | 713 | 1.33x |
| LiveCodeBench v6, आरंभ से अंत तक (tok/s) | 803 | 625 | 1.28x |
| GPQA, आरंभ से अंत तक (tok/s) | 787 | 631 | 1.25x |
Batch size 1 पर 292 tokens प्रति सेकंड सैद्धांतिक सीमा का 62 प्रतिशत है, जबकि vLLM के लिए यह 39 प्रतिशत है। गुणवत्ता अपरिवर्तित रहती है: SciCode पर 38.9 प्रतिशत के मुकाबले 38.2 प्रतिशत और LiveCodeBench v6 पर दोनों ओर 70.3 प्रतिशत, जो सात executions का औसत है। एक विवरण ध्यान देने योग्य है: बढ़त experts के distribution पर निर्भर करती है—model की वास्तविक routing में 1.32x, जबकि simulated uniform routing में 1.14x—जिससे uniform measurements प्रतिकूल स्थिति बन जाती हैं। अंत में Cohere एक सहज-बोध के विपरीत बात पर ज़ोर देता है: megakernel लिखना उसकी प्रतिष्ठा से कहीं सरल होगा, क्योंकि एक ही CUDA file में सोलह operation codes पूरे decoding चरण को समेटते हैं। सीमाएँ स्वीकार की गई हैं और implementation limitations बताई गई हैं: केवल decoding, जबकि prefill अभी भी सामान्य PyTorch kernels पर चलता है; केवल H100 और BF16; तथा 1 से 8 तक batch sizes।
Anthropic ने बताया कि performance खोए बिना Claude Platform का खर्च कैसे घटाएँ
8 सितंबर — Anthropic ने एक engineering guide प्रकाशित की है, जो इस आम धारणा के विपरीत है कि किसी agent का खर्च घटाने का अर्थ खराब नतीजे स्वीकार करना है। इसमें तीन उपाय बताए गए हैं: prompt cache की सफलता दर को अधिकतम करना, frontier model पर जाते समय prompt anti-patterns हटाना और कार्य के अनुसार effort को calibrate करना। यह विधि Claude Code में चलाए जा सकने वाले commands के रूप में दी गई है, जिसमें /claude-api prompt-audit और /claude-api hillclimb, /claude-api cost-optimize के साथ जुड़ते हैं।
| Benchmark, Sonnet 5 आधार | लागत में कमी | मापा गया विवरण |
|---|---|---|
| LegalBench | लगभग 58 प्रतिशत | reasoning tokens 102 779 से घटकर 8 284 |
| tau2-bench retail | लगभग 73 प्रतिशत | स्पष्ट breakpoints वाला prompt cache |
| OfficeQA Pro | लगभग 52 प्रतिशत | 136.20 से घटकर 64.87 dollars |
| SWE-bench Verified | लगभग 55 प्रतिशत | median steps 29 से 17, prompt tokens आधे से भी कम |
सबसे उपयोगी आँकड़ा इस तालिका में नहीं है। CursorBench 3.2 पर low effort वाला Claude Fable 5.1, लागत के एक-तिहाई में high effort वाले Fable 5 के बराबर है। इसका कुछ हिस्सा cache read pricing से आता है, जिसकी दर पहले के 1.00 dollar के मुकाबले अब प्रति दस लाख tokens पर 0.25 dollar है। इसके विपरीत, बिना tools वाले Humanity’s Last Exam पर effort का अंतिम स्तर 46 प्रतिशत अधिक लागत में लगभग आधा point दिलाता है—ऐसी बढ़त जो benchmark के noise में खो जाती है।
🔗 Claude Platform पर लागत घटाना
Claude Code 2.1.265: plugin folders, 1 GB सीमा और prompt cache की मरम्मत
8 सितंबर — Claude Code को 2.1.265 पर अद्यतन किया गया है, जिसके changelog में पचास entries हैं और इनमें चौंतीस fixes शामिल हैं। यह उस 2.1.263 release के दो दिन बाद आया है, जिसमें केवल एक entry थी। अब --plugin-dir option plugins का पूरा folder स्वीकार करता है; manifest वाला प्रत्येक subfolder load होता है और execution के दौरान किए गए additions तथा deletions का पता लगाया जाता है। Disk पर लिखे गए tool results पर 1 GB की सीमा लागू होती है और preview बताता है कि file truncate की गई है।
सबसे विस्तृत हिस्सा prompt cache से जुड़ा है और उसी दिन प्रकाशित guide की प्रतिध्वनि करता है। दो अलग fixes उन स्थितियों को सुधारते हैं जहाँ Claude Code स्वयं cache reuse को तोड़ता था: foreground में शुरू किए गए sub-agent को resume करने पर उसकी tool list और system prompt prefix बदल जाते थे, जबकि resumed agent teammates और sub-agents, SubagentStart hooks के context तथा preloaded skills को prefix से बाहर खिसका देते थे। दो fixes security से जुड़े हैं: backslash वाला plugin path macOS और Linux पर symbolic links की confinement verification को bypass करता था, और Windows पर read तथा write tools, AppContainer या restricted-token sandbox में मौजूद हर file को अस्वीकार करते थे। अब किसी third party द्वारा लिखे गए artifact को पढ़ना untrusted content के रूप में माना जाता है।
Amp ने message queue की जगह live steering अपनाई
8 सितंबर — Amp ने काम के दौरान भेजे गए messages के प्रति अपने agent का default व्यवहार बदल दिया है। अब तक agent के चलते समय लिखा गया message queue में डाल दिया जाता था और turn पूरा होने के बाद ही process होता था; अब उसे पहले उपलब्ध अवसर पर पहुँचा दिया जाता है। Editor इसके दो लाभ बताता है: agent feedback को पहले ध्यान में रखता है और वे verification steps शुरू नहीं करता जिन्हें नया निर्देश अनावश्यक बना देता है। इससे उस सामान्य स्थिति में समय और tokens बचते हैं, जब उपयोगकर्ता agent को गलत दिशा में जाते देखता है।
यह बदलाव side effects से मुक्त नहीं है और Amp ने उनका विवरण दिया है। यदि steering बहुत अचानक लगे, तो editor सलाह देता है कि requests को “Now, …” के बजाय “When done, then…” के रूप में लिखा जाए, ताकि स्पष्ट हो कि निर्देश मौजूदा task के बाद लागू होगा। Ship, Review और अन्य integrated actions पुराने व्यवहार को बनाए रखते हैं और queue में ही रहते हैं, क्योंकि सामान्यतः काम पूरा होने के बाद ही delivery या review शुरू करना वांछित होता है। Manual queuing app और CLI दोनों में उपलब्ध है।
🔗 Queue न करें, steer करें, Amp
Muse Spark 1.3, CursorBench के सर्वोत्तम score-to-cost अनुपात के साथ Cursor में आया
8 सितंबर — Cursor ने Meta Superintelligence Labs के agentic model Muse Spark 1.3 को उसकी प्रस्तुति के छह दिन बाद जोड़ा है। प्रकाशित आँकड़े raw performance नहीं, बल्कि लागत की कहानी बताते हैं। वास्तविक multi-file tasks से बने in-house benchmark CursorBench 3.2 पर Max tier को 1.31 dollar प्रति task में 67.9 प्रतिशत मिलता है और वह बारहवें स्थान पर है।
| Model और tier | CursorBench 3.2 score | प्रति task लागत, dollars में | प्रति task tokens | स्थान |
|---|---|---|---|---|
| Fable 5.1 Max | 73.4 प्रतिशत | 9.64 | 72 060 | 1 |
| Grok 4.6 Extra High | 70.8 प्रतिशत | 2.81 | 41 136 | 3 |
| Opus 5 Max | 70.0 प्रतिशत | 8.23 | 61 838 | 5 |
| Gemini 3.8 Flash High | 69.2 प्रतिशत | 2.38 | 81 524 | 9 |
| Muse Spark 1.3 Max | 67.9 प्रतिशत | 1.31 | 33 034 | 12 |
| GPT-5.6 Sol Max | 67.2 प्रतिशत | 5.69 | 28 320 | 13 |
| Muse Spark 1.3 Low | 55.0 प्रतिशत | 0.45 | 12 181 | 49 |
इस प्रकार Meta का model score में Claude Fable 5.1 Max से बहुत पीछे है, लेकिन Claude Fable 5.1 Max की प्रति task लागत सात गुना से अधिक है। सबसे अहम बात यह है कि यह अपने Max tier में GPT-5.6 Sol से आगे रहते हुए चार गुना से भी कम खर्च करता है। Cursor अपनी उस पद्धति पर कायम है जिसमें केवल उपलब्धता घोषित करने के बजाय जोड़े गए हर model का score और प्रति task लागत व्यवस्थित रूप से प्रकाशित की जाती है।
Grok Bot अब chat से forms और credentials भरता है, Grok Imagine को keyframes का नियंत्रण मिला
8 सितंबर — SpaceXAI अब उपयोगकर्ताओं को conversation छोड़े बिना अपने Grok Bot के लिए forms और login pages भरने देता है और किसी भी password manager के समर्थन का दावा करता है। यह feature persistent agents से जुड़ी एक friction को संबोधित करता है: जैसे ही agent को login screen पार करनी हो या व्यक्तिगत जानकारी वाला form submit करना हो, उसे या तो stored credentials चाहिए या उपयोगकर्ता का हस्तक्षेप। इस चरण को अलग browser session के बजाय conversation thread में लाना usability के साथ-साथ security का भी निर्णय है।
दो घंटे बाद Grok Imagine को video scene की शुरुआती और अंतिम images का नियंत्रण तथा seamless loops बनाने की क्षमता मिली, साथ ही बेहतर instruction following और अधिक video quality का दावा किया गया। Keyframe control लगातार shots बनाने वालों के लिए tool का स्वरूप बदल देता है: एक shot की अंतिम image तय करके उसे अगले shot की पहली image के रूप में दोबारा इस्तेमाल किया जा सकता है, जिससे ऐसी sequences जोड़ी जा सकती हैं जिनकी continuity अब generation के संयोग पर निर्भर नहीं रहती। यह घोषणा Image 2.0 model से संचालित Grok Imagine Video 1.5 agent को सेवा में लाए जाने के तीन दिन बाद हुई।
🔗 Grok Bot में forms भरना · 🔗 Grok Imagine में keyframes
Hugging Face blog पर तीन research posts
8 सितंबर — Hugging Face community की उसी दिन प्रकाशित तीन posts पढ़ने योग्य हैं, जो मौसम, model security और जीव-जगत से प्रेरित models पर केंद्रित हैं।
GPU के बिना open weather model चलाना
Hugging Face और Earthmover ने एक ऐसी समस्या पर संयुक्त post प्रकाशित की है जिस पर बहुत कम चर्चा होती है: machine-learning weather models laptop पर चलने जितने हल्के हैं, फिर भी लगभग कोई उन्हें नहीं चलाता। तीन बाधाएँ पहचानी गई हैं: compute—AIFS सहित कई models flash attention पर निर्भर हैं, जो कुछ graphics card architectures तक सीमित है—storage और सबसे बढ़कर bandwidth, क्योंकि हर forecast के लिए लगभग 1 GB initial conditions चाहिए। इसका समाधान तीन public artifacts में है: demo space, storage bucket और reproducible tutorial, जो Microsoft के model Aurora को 0.25-degree pretrained version में चलाता है, जहाँ initial ERA5 conditions Earthmover data marketplace द्वारा उपलब्ध कराई जाती हैं। किसी GPU की आवश्यकता नहीं है: CPU पर प्रति compute step दो से तीन मिनट, graphics card पर कुछ सेकंड, और चौबीस घंटे के forecast के लिए छह घंटे के चार steps, जिसकी बाद में ERA5 से तुलना की जाती है।
🔗 Earthmover के साथ open weather models
अधिक सुरक्षित माना गया model, तीन-चौथाई निरापद प्रश्नों को अस्वीकार करता है
Multiverse Computing ने ऐसा परिणाम प्रकाशित किया है जिसकी चर्चा alignment research से कहीं आगे होनी चाहिए। राजनीतिक manipulation requests अस्वीकार करने के लिए Qwen3-8B को train करने पर team को ऐसे आँकड़े मिलते हैं जो स्पष्ट जीत जैसे लगते हैं: HarmBench, StrongREJECT और WildJailbreak पर औसत harmful response rate 26.26 से गिरकर 0.14 प्रतिशत हो जाती है। उसी checkpoint पर XSTest में over-refusal 2.00 से बढ़कर 74.00 प्रतिशत हो जाता है। दूसरे शब्दों में, कागज़ पर सबसे सुरक्षित configuration वास्तव में refusal machine है, और सामान्य measurements में इसे देखने का कोई तरीका नहीं है। दो corrections प्रभावी सिद्ध होते हैं: external compliance responses को target model के verified responses से बदलने पर XSTest over-refusal 15.20 से घटकर 5.20 प्रतिशत हो जाता है, और benign boundary pairs जोड़ने पर satisfy किए जाने वाले पक्ष का over-refusal 32.94 से गिरकर 4.16 प्रतिशत रह जाता है, जबकि harmful पक्ष के refusal में केवल चार points की कमी आती है।
🔗 किसके लिए सुरक्षा, Multiverse Computing
Fly connectome अपने shuffled wiring को नहीं पछाड़ता
Oruk ने ऐसी methodological सीख प्रकाशित की है जो connectome-inspired models से कहीं आगे लागू होती है। Team ने fly के public MaleCNS reconstruction से 499 अत्यधिक connected neurons को reservoir की तरह काम करने वाले recurrent network में copy किया, जिसके ऊपर केवल एक trained ridge readout लगाया गया। Fly wiring को test पर 16.84 प्रतिशत औसत accuracy मिली, जबकि shuffled wiring को 16.88 प्रतिशत: अंतर ऋण 0.04 point है और confidence interval शून्य को पार करता है। दूसरा experiment इसके विपरीत प्रमाण लग सकता था, क्योंकि सबसे बड़े readout weight norms वाले 50 neurons हटाने से accuracy 16.91 से गिरकर 10.83 प्रतिशत हो जाती है। Authors बताते हैं कि इसमें विरोधाभास क्यों नहीं है: dramatic ablation कभी यह सिद्ध नहीं करता कि biological topology आवश्यक थी। यह भी उल्लेखनीय है कि post स्वयं बताती है कि इसे एक AI agent ने non-peer-reviewed paper से तैयार किया था और पूरा evaluation dataset अब भी private है।
🔗 Connectome और shuffled wiring, Oruk
Runway ने Paris स्थित Kinetix laboratory की team को नियुक्त किया
8 सितंबर — Runway ने घोषणा की है कि Paris स्थित AI research laboratory Kinetix की team उससे जुड़ रही है। Laboratory 3D human motion और physics-grounded video generation पर काम कर रही थी—दो ऐसे विषय जिन्हें Runway robotics में लागू world models पर अपने research से सीधे जोड़ता है। Team कंपनी के Paris hub में शामिल होगी, जहाँ research और engineering के लिए अन्य भर्तियाँ भी चल रही हैं।
तकनीकी तर्क announcement के एक वाक्य में समाया है: वास्तव में उपयोगी robot को नए environments, tasks और situations को समझना तथा संभालना चाहिए, और Runway के अनुसार large-scale video pre-training इन generalization समस्याओं को हल करने का सबसे प्रभावी मार्ग प्रदान करती है। यह 31 अगस्त को प्रस्तुत Solaris और 3 सितंबर को प्रस्तुत GWM Worlds 2 की सीधी निरंतरता है: models को दुनिया simulate करना सिखाने के बाद Runway अब उन्हें उसमें कार्य करना सिखाना चाहता है। Kinetix के CEO Yassine Tahi के अनुसार laboratory का foundational bet छह वर्ष पहले लगाया गया था। लेनदेन की किसी राशि या संरचना की जानकारी नहीं दी गई है।
Sarah Friar ने OpenAI के पैमाने और उसके मॉडलों के लागत-प्रभाव को आँकड़ों में बताया
8 सितंबर — Sarah Friar ने एक विचार-लेख प्रकाशित किया है कि OpenAI अपनी शोध प्रगति को आर्थिक गतिविधि में कैसे बदलता है। इस लेख की दिलचस्पी उसके तर्क से अधिक तीन नए आँकड़ों में है।
| संकेतक | मान |
|---|---|
| साप्ताहिक सक्रिय उपयोगकर्ता | एक अरब से अधिक |
| ग्राहक कंपनियाँ | 2.5 मिलियन |
| छह महीने बाद प्रतिदिन संदेश, व्यक्तिगत योजनाएँ | पहले महीने की तुलना में लगभग 50 प्रतिशत अधिक |
| छह महीने बाद आज़माए गए अलग-अलग कार्य | लगभग दोगुने |
| अनुकूलन के बाद शुरू से अंत तक की सेवा लागत | 20 प्रतिशत कम |
| token निर्माण दक्षता | 15 प्रतिशत से अधिक |
तीसरा आँकड़ा एक दिलचस्प चक्र पूरा करता है। GPT-5.6 Sol का उपयोग OpenAI के उत्पादन सेवा सॉफ़्टवेयर को बेहतर बनाने के लिए किया गया, जिससे सेवा लागत में 20 प्रतिशत की कमी आई और token निर्माण की दक्षता में 15 प्रतिशत से अधिक की अतिरिक्त बढ़ोतरी हुई। दूसरे शब्दों में, मॉडल उस परोसने वाली परत को अनुकूलित करके अपने ही बुनियादी ढाँचे के एक हिस्से का खर्च वहन करता है। व्यक्तिगत उपयोग का रुझान एक ऐसे प्रश्न का भी उत्तर देता है जिसे अक्सर पूछा जाता है लेकिन शायद ही कभी दस्तावेज़ित किया जाता है: उपयोगकर्ता प्रतिधारण।
🔗 काम अब पहुँच के भीतर, OpenAI
OpenAI ने किशोरों पर स्वतंत्र शोध के लिए 5 मिलियन डॉलर की प्रतिबद्धता जताई
8 सितंबर — OpenAI ने 13-17 वर्ष के किशोरों पर जनरेटिव AI के प्रभावों से जुड़े स्वतंत्र शोध के लिए 5 मिलियन डॉलर का अनुदान कार्यक्रम शुरू किया है, जिसमें सामाजिक और भावनात्मक विकास पर स्पष्ट रूप से ज़ोर दिया गया है। प्रत्येक परियोजना के लिए व्यक्तिगत अनुदान 1 मिलियन डॉलर तक होगा। आवेदन 6 अक्टूबर 2026 को बंद होंगे, चयनित परियोजनाओं को अधिकतम 13 नवंबर 2026 तक सूचित किया जाएगा, 2027 की पहली तिमाही में प्रगति की समीक्षा अपेक्षित है और प्रत्येक अनुदान में सामान्य प्रशासनिक खर्च की सीमा 10 प्रतिशत रखी गई है।
दो विवरण ध्यान देने योग्य हैं। पहला घोषित स्वतंत्रता से संबंधित है: मूल्यांकन मानदंडों में यह क्षमता शामिल है कि परियोजना विश्वसनीय परिणाम दे सके, चाहे वे AI उत्पाद प्रदाताओं के अनुकूल हों या नहीं; प्रकाशन को प्रोत्साहित किया गया है, लेकिन वह वित्तपोषण की शर्त नहीं है। दूसरा प्रशासनिक है, लेकिन महत्त्वपूर्ण है, क्योंकि अनुदानों का वित्तपोषण और प्रबंधन व्यावसायिक इकाई OpenAI Group PBC करती है, OpenAI Foundation नहीं। समय-सारिणी भी तटस्थ नहीं है: OpenAI ने 31 अगस्त को AI से नाबालिगों की सुरक्षा संबंधी कैलिफ़ोर्निया विधेयक का समर्थन किया था और लेख में कहा गया है कि इसका उद्देश्य नियामकों के निर्णयों के लिए जानकारी उपलब्ध कराना है।
संक्षिप्त समाचार
- Boris Cherny ने prompt injection के जोखिम पर अन्य प्रयोगशालाओं का सार्वजनिक रूप से आकलन किया — Claude Code के निर्माता ने OpenAI के नए मॉडल को prompt injection के मामले में Gemini Flash और Opus 4.8 के स्तर पर रखा और कहा कि जब तक प्रयोगशालाएँ सुरक्षा को अधिक गंभीरता से नहीं लेंगी, वह सार्वजनिक रूप से उनके नाम लेते रहेंगे। लगभग बीस मिनट बाद अपने ही थ्रेड के उत्तर में उन्होंने अपने स्वर को थोड़ा नरम किया। 🔗 पोस्ट
- Anthropic ने Claude Managed Agents पर निर्माण करने वाले संस्थापकों का वीडियो प्रकाशित किया — Wispr Flow, Actively और Pendo के संस्थापकों के साथ outcomes, sandbox और memory के उपयोग से विस्तार करने पर साक्षात्कार। 🔗 पोस्ट
- RelayShield repository के code के बजाय निर्देश फ़ाइलों को scan करता है — यह सशुल्क सेवा AGENTS.md, CLAUDE.md, .cursorrules और mcp.json को पढ़कर प्राकृतिक भाषा में लिखे ऐसे दुर्भावनापूर्ण निर्देश खोजती है जिन्हें static analysis नहीं देख पाता। लेख में उद्धृत दुर्भावनापूर्ण repository की संख्या उसके अपने स्रोत से मेल नहीं खाती। 🔗 लेख
- Ai2 ने ECCV 2026 में अपनी उपस्थिति की घोषणा की — सम्मेलन में विभिन्न लेख और प्रस्तुतियाँ होंगी, लेकिन कोई शीर्षक या कार्यक्रम साझा नहीं किया गया है। 🔗 पोस्ट
- Prismberry ने उद्यम एजेंटों की tool layer पर एक निबंध प्रकाशित किया — यह वैचारिक लेख सूचना, विश्लेषण और कार्रवाई के tools के बीच अंतर बताता है; इसमें कोई घोषणा या माप नहीं है और यह प्रकाशक के Agent IQ उत्पाद का प्रचार करता है। 🔗 लेख
- Hugging Face ब्लॉग पर प्रकाशित hardware maintenance विवरणिका — 650 W की power supply के fan में bearing के घिसाव का निदान, जिसमें कृत्रिम बुद्धिमत्ता से संबंधित कोई सामग्री नहीं है। 🔗 लेख
- Missouri ने 1.1 मिलियन विद्यार्थियों के लिए Gemini for Education उपलब्ध कराया — राज्यव्यापी साझेदारी के अंतर्गत लगभग 100,000 शिक्षकों और 1.1 मिलियन से अधिक विद्यार्थियों को Gemini for Education, Gemini Notebook और Google certifications की निःशुल्क पहुँच मिलेगी; उनके data को training से बाहर रखा जाएगा और इसे अपनाने का निर्णय प्रत्येक संस्थान पर छोड़ा गया है। 🔗 घोषणा
- Dependabot निजी GitHub registries को व्यक्तिगत token के बिना पढ़ता है — Dependabot का
GITHUB_TOKENअनुमतिpackages: readमाँग सकता है और निजी GitHub Packages registries से सामग्री प्राप्त कर सकता है। जून में जारी होकर वापस ली गई यह सुविधा अब लौट आई है, जिसमें स्वचालित credentials केवल fallback की भूमिका में सीमित हैं। 🔗 बदलाव-विवरण - GitHub का support portal help.github.com पर स्थानांतरित हुआ — support, documentation, learning, community और account resources अब एक ही स्थान पर उपलब्ध हैं, जहाँ बिना sign-in के Copilot-संचालित search भी मिलता है। 🔗 बदलाव-विवरण
- Genspark ने SF Tech Week के दौरान GenTeam की शुरुआती पहुँच के साथ Spark House खोला — यह सामुदायिक पहल प्रतिभागियों को GenTeam की शुरुआती पहुँच और संस्थापकों व निवेशकों के बीच निजी बातचीत का अवसर देती है। 🔗 पोस्ट
- Ethan Tandowsky ElevenLabs के मुख्य वित्तीय अधिकारी बने — 2 सितंबर को Ashley Kramer को मुख्य राजस्व अधिकारी नियुक्त किए जाने के बाद छह दिनों में ElevenLabs की यह दूसरी वरिष्ठ नियुक्ति है। 🔗 पोस्ट
- MiniMax ने Tokyo में जापानी मनोरंजन जगत की आवाज़ों और जनरेटिव AI के चार प्रतिभागियों को एकत्र किया — 11 सितंबर को Shibuya में होने वाले कार्यक्रम में निर्माता Yasushi Akimoto, KADOKAWA, KAGAMIAI, Higgsfield, Krea, Runway और HeyGen शामिल होंगे; कोई लॉन्च या आँकड़ा नहीं है। 🔗 पोस्ट
- एक ही दिन में Nemotron Labs के दो प्रसारण, OpenShell और Domyn पर — OpenShell द्वारा autonomous agents को सुरक्षित करने पर 49 मिनट 44 सेकंड और Domyn द्वारा Nemotron के उपयोग पर 54 मिनट 20 सेकंड, बिना वर्णनात्मक पाठ या transcript के। 🔗 पोस्ट
- HeyGen ने किसी tool या model का नाम लिए बिना एक ही चेहरे के दो avatars की तुलना की — यह विपणन तुलना है जिसमें किसी प्रतिस्पर्धी tool का नाम, model या माप नहीं दिया गया। 🔗 पोस्ट
- OpenAI ने अपने पत्रकारिता कार्यक्रम का विस्तार पत्रकारिता विद्यालयों तक किया — 2026-2027 के लिए CUNY के Newmark J-School और Northwestern के Medill School के master विद्यार्थियों एवं शिक्षकों को 400 से अधिक ChatGPT Edu subscriptions। 🔗 घोषणा
- Perplexity ने AI integration के निवेश प्रतिफल पर मार्गदर्शिका प्रकाशित की — यह बिना किसी उत्पाद घोषणा वाला शैक्षणिक लेख है, जिसके सभी आँकड़े तृतीय पक्षों या ग्राहकों के अनुभवों से लिए गए हैं। 🔗 लेख
इसका क्या अर्थ है
व्यक्तिगत agent बुनियादी ढाँचे का उत्पाद बन रहा है और उसकी सुरक्षा अपने आप में एक उत्पाद बन रही है। Meta केवल Muse उपलब्ध कराने तक सीमित नहीं है: उसी दिन उसने अब तक का सबसे विस्तृत विवरण प्रकाशित किया कि shell, browser और mailbox की पहुँच वाले agent को कैसे नियंत्रित रखा जाए। सबसे शिक्षाप्रद विकल्प substitution tokens का है, जो credentials की चोरी के संदर्भ में prompt injection को निरर्थक बना देता है—इसलिए नहीं कि model बेहतर प्रतिरोध करता है, बल्कि इसलिए कि उसके पास कभी secret होता ही नहीं। tainted egress भी इसी तर्क पर आधारित है: model पर भरोसा नहीं किया जाता, kernel में instrumentation किया जाता है। 300,000 डॉलर का bug bounty और निष्कर्ष की साफ़गोई—जिसमें स्वीकार किया गया है कि Muse गलतियाँ करेगा—वही बात कहते हैं जो Boris Cherny इस जोखिम पर अन्य प्रयोगशालाओं का सार्वजनिक आकलन करते समय कहते हैं। agents की सुरक्षा अब केवल टिक लगाने वाला ख़ाना नहीं है, बल्कि engineering की ऐसी सतह है जिसे प्रकाशित किया जाता है और जिसे तोड़ने के लिए भुगतान किया जाता है।
यह दिन AI के अर्थशास्त्र का भी एक पाठ है और अब गणना की इकाई score नहीं, बल्कि प्रति कार्य लागत है। Mistral ने 21 अरब यूरो से अधिक के मूल्यांकन पर 3 अरब यूरो जुटाए, जबकि Cognition ने 48 अरब के मूल्यांकन पर 2 अरब से अधिक जुटाए; दोनों मामलों में केवल technology funds के बजाय औद्योगिक कंपनियाँ और ग्राहक भी मेज़ पर हैं। उसी समय Cursor ने एक तालिका प्रकाशित की जिसमें Muse Spark 1.3 प्रति कार्य 1.31 डॉलर में 67.9 प्रतिशत प्राप्त करता है, जबकि पहले स्थान वाला model केवल छह अंक अधिक पाने के लिए 9.64 डॉलर खर्च करता है। Anthropic ने प्रदर्शन खोए बिना लागत में 52 से 73 प्रतिशत की कमी दर्ज की और दिखाया कि कम effort पर चलाया गया अधिक शक्तिशाली model अक्सर पूरी क्षमता तक धकेले गए कमज़ोर model को पछाड़ देता है। Sarah Friar ने श्रृंखला के दूसरे छोर को आँकड़ों में बताया: GPT-5.6 Sol से उसे परोसने वाली layer को optimize कराकर सेवा लागत में 20 प्रतिशत की कमी। ये चार अलग-अलग ढंग से बताते हैं कि समझौते का केंद्र क्षमता से हटकर उस क्षमता की कीमत पर आ गया है।
वैज्ञानिक क्षेत्र में प्रश्न अब यह नहीं है कि agents परिणाम देते हैं या नहीं, बल्कि यह है कि उनका सत्यापन कैसे किया जाए। OpenAI ने Navier-Stokes के लिए singularity का एक प्रमाण घोषित किया, जिसे लगभग 10,000 agents ने 88 घंटों में तैयार किया और Lean में formalize किया; लेकिन किसी peer review या संस्थागत validation का उल्लेख नहीं है और इसमें ऐसा internal model उपयोग हुआ है जिससे बाहर का कोई व्यक्ति प्रश्न नहीं कर सकता। कंपनी की सावधानी—millennium prize का दावा न करना और इसे snapshot कहना—अपने आप में एक जानकारी है। उस दिन के दो अन्य शोध इस विरोधाभास का पैमाना बताते हैं: MIT में Codex अच्छी तरह परिभाषित protocols निभाता है लेकिन अस्पष्ट signals पर अटकता है, और एक अनुभवी researcher अब भी अधिक तेज़ है; Google DeepMind में AlphaGenome Atlas कुछ सिद्ध करने का दावा नहीं करता, बल्कि 9 अरब predictions की पूर्व-गणना करके प्रयास को experimental validation की ओर स्थानांतरित करता है। Oruk का लेख यह दिखाकर तर्क पूरा करता है कि शानदार ablation बिना matched comparison के कुछ सिद्ध नहीं करता, और Multiverse Computing का लेख याद दिलाता है कि सुरक्षा का कोई आँकड़ा तब तक अर्थहीन है जब तक benign पक्ष को भी उतनी ही कठोरता से नहीं मापा जाता।
अंत में निचली layer बचती है, जहाँ लाभ अब weights से नहीं आते। Cohere ने एक पूर्ण serving engine उपलब्ध कराया है, जिसमें एकमात्र परिवर्तन kernel boundaries को हटाना है; यह समान गुणवत्ता पर vLLM के मुकाबले 1.58x throughput देता है और स्पष्ट करता है कि megakernel लिखने की कठिनाई को बढ़ा-चढ़ाकर आँका गया है। NVIDIA ने Rust में GPU kernels लिखने के दो रास्ते खोले हैं, जिनमें से एक का उपयोग पहले से ही उसके बाहर Hugging Face के Grout inference engine और mistral.rs में हो रहा है, और वह स्वीकार करता है कि अभी कुछ भी production के लिए तैयार नहीं है। AI City Challenge में पाँच सर्वोत्तम video solutions में से चार LoRA से अनुकूलित Cosmos models पर आधारित हैं; विजेता टीम ने ज़ोर दिया कि यह adaptation recipe है, कोई नई architecture नहीं। Earthmover का मौसम tutorial दूसरे छोर से यही कहानी बताता है: Aurora model processor पर चल जाता है; रुकावट computation नहीं, बल्कि download की जाने वाली एक gigabyte initial conditions थीं। हर मामले में मूल्य model के आसपास की engineering में है और उसे प्रकाशित किया जा रहा है।
स्रोत
- Muse का लॉन्च, Meta
- Muse के साथ agents की सुरक्षा और संरक्षा, Meta
- Mistral की Series D
- X पर Series D की घोषणा
- Navier-Stokes समस्या का समाधान, OpenAI
- internal model पर OpenAI का थ्रेड
- MIT में Codex और quantum computing प्रयोग
- ChatGPT Images 2.5, OpenAI
- Manus ने GPT-Image-2.5 को integrate किया
- AlphaGenome Atlas, Google DeepMind
- CUDA Rust, NVIDIA
- ECCV 2026 की AI City Challenge, NVIDIA
- Cognition की Series E
- X पर Cognition का थ्रेड
- Suno, Believe और TuneCore की साझेदारी
- decoding megakernel, Cohere
- Claude Platform पर लागत घटाना, Anthropic
- Claude Code 2.1.265
- agent का live steering, Amp
- Cursor में Muse Spark 1.3
- Grok Bot में form filling
- Grok Imagine में keyframes और loops
- Earthmover के साथ open weather models, Hugging Face
- किसके लिए सुरक्षा, Multiverse Computing
- मक्खी का connectome और मिश्रित wiring, Oruk
- Kinetix, Runway में शामिल हुआ
- Sarah Friar का विचार-लेख, OpenAI
- किशोर शोध अनुदान, OpenAI
- prompt injection के जोखिम पर Boris Cherny
- Claude Managed Agents पर निर्माण करने वाले संस्थापक
- RelayShield और निर्देश फ़ाइलें
- ECCV 2026 में Ai2
- agents की tool layer, Prismberry
- hardware maintenance विवरणिका
- Missouri में Gemini for Education
- Dependabot और निजी GitHub registries
- नया GitHub support portal
- SF Tech Week के दौरान Spark House, Genspark
- Ethan Tandowsky, ElevenLabs के मुख्य वित्तीय अधिकारी
- Tokyo में MiniMax कार्यक्रम
- Nemotron Labs प्रसारण
- HeyGen avatars की तुलना
- OpenAI का पत्रकारिता कार्यक्रम
- AI के निवेश प्रतिफल पर मार्गदर्शिका, Perplexity