ai-powered-markdown-translatorArtikel vertaald van het Frans naar het Nederlands met gpt-5.6-sol.
Meta lanceert Muse, een persoonlijke agent die elke gebruiker een eigen Linux-machine in de cloud geeft, en publiceert diezelfde dag de beveiligingsarchitectuur eromheen, met een voor iedereen toegankelijk beloningsprogramma voor kwetsbaarheden (bug bounty) tot 300.000 dollar. Mistral kondigt een Serie D van 3 miljard euro aan, de grootste aandelenfinancieringsronde die ooit door een Europees technologiebedrijf is afgerond. OpenAI publiceert op zijn beurt een door een agentsysteem opgesteld bewijs van singulariteit in eindige tijd voor de Navier-Stokes-vergelijkingen, en Google DeepMind berekent vooraf het effect van de 9 miljard mogelijke mutaties van menselijk DNA.
Meta lanceert Muse, zijn persoonlijke agent, en publiceert zijn beveiligingsarchitectuur
8 september — Meta lanceert Muse, een persoonlijke agent die beschikbaar is als iOS- en Android-app, via een webinterface en in WhatsApp, aangedreven door Muse Spark 1.3. Het model is niet nieuw: het verscheen op 2 september in Muse Code en de Meta Model API, en het hoogste redeneerniveau werd op 4 september openbaar. Wat wel nieuw is, is het consumentenproduct dat eromheen is gebouwd.
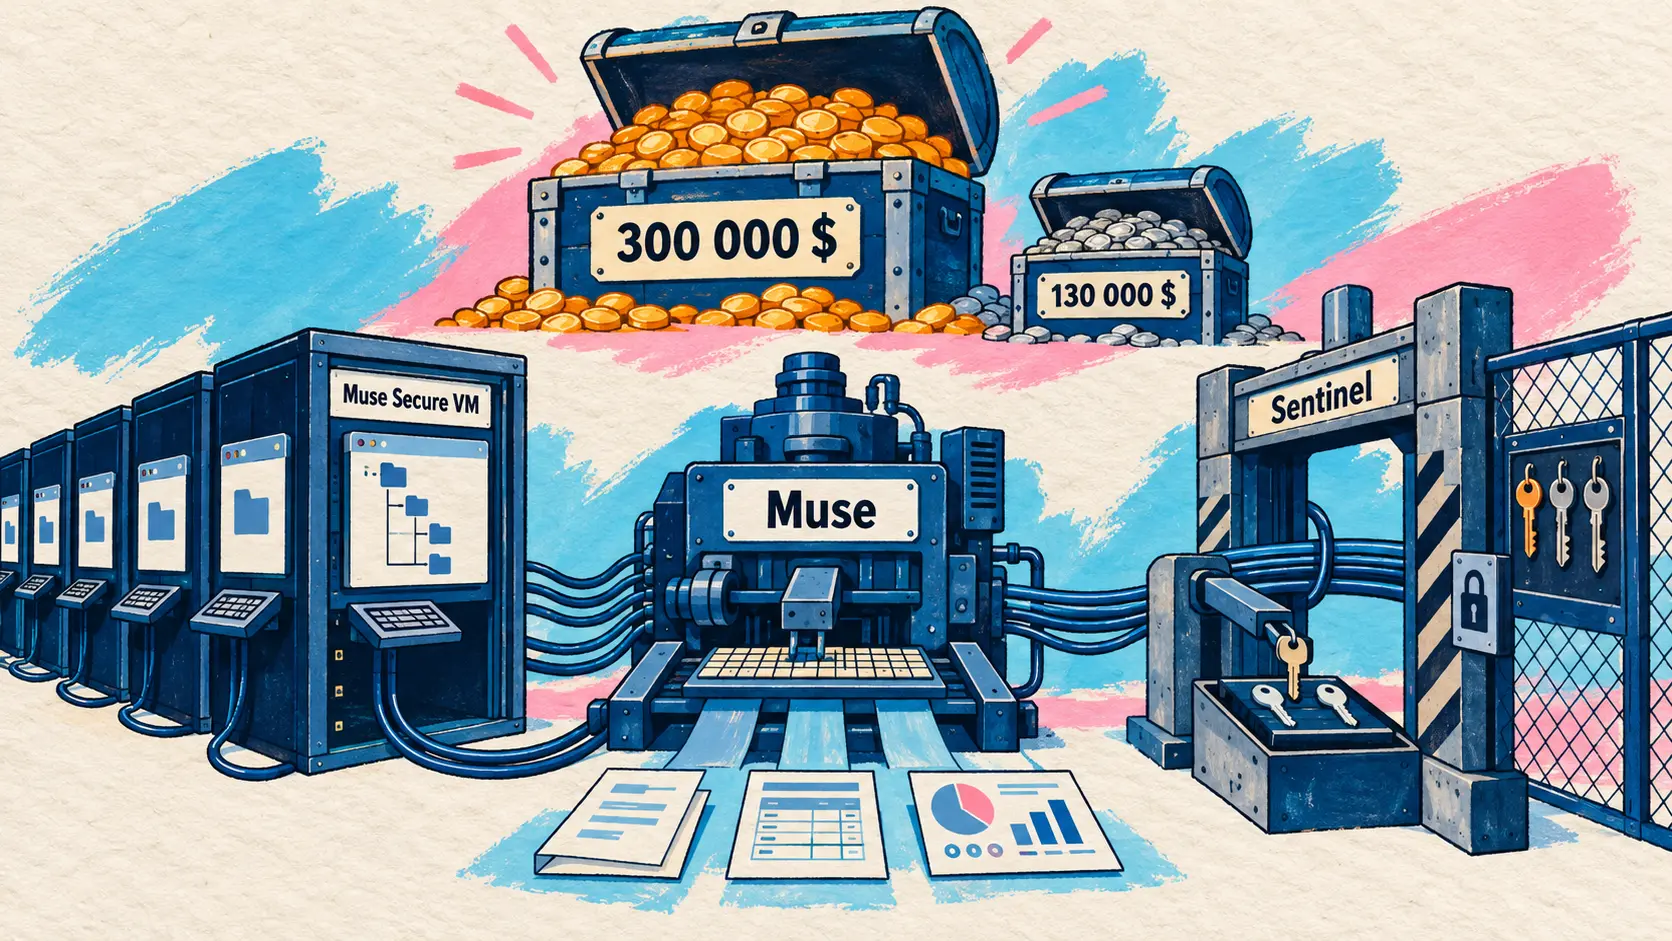
De architectuur berust op een eenvoudig te verwoorden maar moeilijk uit te voeren idee: elke gebruiker krijgt een eigen computer in de cloud. De Muse Secure VM is een persistente en geïsoleerde Linux-machine, voorzien van een bestandssysteem, een terminal en een volledige browser, met voldoende opslagruimte, processorcapaciteit en geheugen om code te compileren, vaardigheden op maat te ontwikkelen en subagenten parallel te laten draaien. Deze machine, en niet een gecentraliseerde infrastructuur van Meta, dient als bron van waarheid voor de gegevens en inloggegevens van verbonden diensten. Wanneer voor een taak een tool ontbreekt, schrijft de agent die zelf, en hij produceert bewerkbare objecten in plaats van tekstblokken: routes, PDF’s, webpagina’s en dashboards, die Meta Artifacts noemt.
De tweede geclaimde doorbraak is dat de agent op de achtergrond werkt wanneer de applicatie gesloten is, volgens een planning en als reactie op gebeurtenissen, en vervolgens beslist of het resultaat een melding verdient. Het geheugen is persistent en kan door de gebruiker worden bekeken en aangepast, terwijl een tabblad Doelen een overzicht biedt van wat de agent volgt. Dan blijft nog over wat Meta niet zegt: er zijn geen prijzen gepubliceerd en de lancering gaat niet vergezeld van een lijst met landen waar Muse beschikbaar is.
Twintig minuten na de productaankondiging publiceerde Meta een technisch document van Tarek Sheasha, software-engineer en vicepresident bij Meta Superintelligence Labs, over de beveiliging van dit systeem. Het uitgangspunt wordt meteen duidelijk gemaakt: het systeem is ontworpen vanuit de aanname dat de agent zal worden aangevallen. Het agentische harnas, in de code Hatch genoemd, draait in een systemd-nspawn-container waarvan de root is gekoppeld aan een niet-bevoorrechte gebruiker op de host, met gefilterde systeemaanroepen en verwijderde kernelcapaciteiten. Vier diensten bevinden zich bewust buiten deze container, zodat een aanvaller die de agent compromitteert ze niet kan uitschakelen: de beveiligingsclassificatoren, workers met gescheiden bevoegdheden, de daemon voor de opslag van inloggegevens en Sentinel.
Sentinel is het centrale onderdeel: als enige autoriteit die een connectoractie of uitgaand netwerkverkeer kan toestaan, beoordeelt het elk verzoek op laag 4 en 7 en controleert het het daadwerkelijk opgeloste adres. Bovenal verwerkt de agent uitsluitend vervangende tokens, die aan de netwerkgrens door de echte inloggegevens worden vervangen. Een geheim via prompt injection aan de agent ontfutselen wordt zinloos, omdat hij het nooit heeft gehad. Daar komt tainted egress bij, het volgen van gegevensstromen op kernelniveau: elk proces dat gebruikersgegevens leest, wordt gemarkeerd en verliest zijn automatische toestemming. De implementatie combineert aan cgroups gekoppelde eBPF-programma’s met door Meta toegevoegde Linux Security Module-hooks.
| Onderdeel van de architectuur | Gemaakte keuze |
|---|---|
| Container van het agentische harnas | systemd-nspawn, root gekoppeld aan een niet-bevoorrechte gebruiker |
| Autorisatie-autoriteit | Sentinel, buiten de container, lagen 4 en 7 |
| Inloggegevens die de agent ziet | uitsluitend vervangende tokens |
| E-mailconnector | filtering van eenmalige codes en links voor het opnieuw instellen |
| Browser-subagent | toegankelijkheidsboom, geen ruwe DOM, geen JavaScript op de pagina |
| Betalingen | Stripe Link bij lancering, daarna Shop Pay, kaart voor eenmalig gebruik |
| Bug bounty, maximum per geldig rapport | 300.000 dollar |
| Bug bounty, prompt injection | tot 130.000 dollar |
Het document gaat vergezeld van twee aankondigingen. Het beloningsprogramma voor kwetsbaarheden staat vanaf de lancering open voor iedereen, met maximaal 300.000 dollar per geldig rapport, afhankelijk van de aangetoonde impact, waaronder maximaal 130.000 dollar voor een geslaagde prompt injection die een gebruiker treft. Daarnaast moet Muse Confidential VM, dat voor het einde van het jaar gepland staat, Meta op cryptografisch verifieerbare wijze verhinderen toegang te krijgen tot de gegevens van een virtuele machine; het ontwerp en de broncode zijn al aan externe auditors voorgelegd. De conclusie van de tekst is ongewoon openhartig voor een bedrijfspublicatie: prompt injection blijft een onopgelost probleem in de sector en Muse zal fouten maken.
🔗 Lancering van Muse · 🔗 Beveiliging en veiligheid van agenten, Meta
Mistral haalt 3 miljard euro op, de grootste aandelenfinancieringsronde in de Europese technologiesector
8 september — Mistral kondigt een Serie D van 3 miljard euro aan, tegen een post-moneywaardering van meer dan 21 miljard euro. Het bedrijf presenteert deze ronde als de grootste aandelenfinancieringsronde die ooit door een Europees technologiebedrijf is afgerond, slechts drie jaar na de oprichting.
Samsung Electronics leidt de transactie. Het door EQT beheerde Scaleup Europe Fund en de bestaande aandeelhouder PSG Equity treden op als medehoofdinvesteerders. Drie nieuwe investeerders sluiten zich aan: Advent, fondsen en rekeningen beheerd door BlackRock, en het Groothertogdom Luxemburg. De lijst met bestaande investeerders is lang en bestrijkt drie continenten, van a16z tot Salesforce Ventures, via ASML, BNP Paribas CIB, Bpifrance, DST Global, General Catalyst, Index Ventures, Korelya Capital, Lightspeed en NVIDIA.
Het detail dat aandacht verdient, is de aard van de twee opeenvolgende hoofdinvesteerders. ASML leidde de Serie C, Samsung Electronics leidt de Serie D: twee bedrijven uit de geavanceerde maakindustrie, geen algemene technologiefondsen. Mistral ziet daarin een teken van vertrouwen in zijn vermogen om geavanceerde modellen uit te rollen binnen complexe industriële omgevingen, waar controle over gegevens en infrastructuur bepalend is voor de invoering ervan.
| Indicator | Waarde |
|---|---|
| Opgehaald bedrag | 3 miljard euro |
| Post-moneywaardering | meer dan 21 miljard euro |
| Leeftijd van het bedrijf | 3 jaar |
| Hoofdinvesteerder | Samsung Electronics |
| Medehoofdinvesteerders | Scaleup Europe Fund beheerd door EQT, PSG Equity |
| Landen waarin het actief is | 20 |
| Grote zakelijke klanten | meer dan 125, waaronder Airbus, ASML en HSBC |
Wat het gebruik van de middelen betreft, noemt het bedrijf allereerst grensverleggend onderzoek, gevolgd door de uitbreiding van de rekencapaciteit voor training, de uitbouw van de infrastructuur en de versnelling van de internationale commerciële activiteiten. De argumentatie volgt de lijn die sinds de zomer wordt verdedigd: organisaties zouden zich niet langer afvragen wie het krachtigste model bouwt, maar hoe ze AI kunnen benutten zonder de controle over hun infrastructuur uit handen te geven. Mistral omschrijft zichzelf als het enige bedrijf in de sector dat de volledige benodigde stack samenstelt, van open-weightmodellen tot producten en rekencapaciteit.
Today marks a major step for Mistral: we’re announcing a €3B Series D, the largest equity round ever raised by a European tech company, just three years after launch.
🇳🇱 Vandaag markeert een belangrijke mijlpaal voor Mistral: we kondigen een Serie D van 3 miljard euro aan, de grootste aandelenfinancieringsronde die ooit door een Europees technologiebedrijf is gerealiseerd, slechts drie jaar na onze lancering. — @MistralAI op X
De wetenschappelijke agenten van OpenAI: een bewijs over Navier-Stokes, gekalibreerde qubits bij MIT
8 september — OpenAI publiceert een bewijs van de vorming van een singulariteit in eindige tijd voor de driedimensionale Navier-Stokes-vergelijkingen, vergezeld van een formalisering in de bewijsassistent Lean. Het aangekondigde resultaat is dat een aanvankelijk gladde, stilstaande driedimensionale vloeistof die aan een gladde externe kracht wordt blootgesteld, in eindige tijd een onbegrensde snelheid kan ontwikkelen, terwijl viscositeit de beweging probeert af te vlakken en de energie van het systeem eindig blijft. In de officiële formulering van het Clay Mathematics Institute komt dit overeen met de uitspraken ‘C’ en ‘D’, die een weerlegging vormen en geen bewijs van regelmatigheid.
Wat OpenAI wel en niet claimt, moet nauwkeurig worden uiteengezet. Het bewijs is opgesteld door een systeem van gecoördineerde agenten dat steunt op een intern model zonder openbare naam, door het bedrijf omschreven als aanzienlijk capabeler dan GPT-6 Astra en sinds 28 augustus nog altijd in training. De enige beschreven verificatie is de formalisering in Lean, uitgevoerd door GPT-6 Astra en 17 uur na de oplossing voltooid. In de aankondiging wordt geen melding gemaakt van collegiale toetsing of validatie door het Clay Mathematics Institute, en OpenAI verklaart niet van plan te zijn de millenniumprijs op te eisen. Het presenteert zijn resultaat als een momentopname en niet als een eindpunt.
De methode is minstens even opmerkelijk als het resultaat. De inspanning begon op 1 september, na geruchten dat twee millenniumproblemen zojuist waren opgelost. Afzonderlijke groepen agenten kregen verschillende varianten van de formulering toegewezen: de versies ‘A’ en ‘B’ waren gericht op een bewijs, de versies ‘C’ en ‘D’ op een weerlegging. Voor een verwant probleem, de regelmatigheid van de niet-gedwongen Euler-vergelijkingen, produceerden bijna 100 agenten in ongeveer vijftig uur een weerlegging; dat resultaat werd vervolgens verwerkt in de prompts van de agenten die aan Navier-Stokes werkten.
| Metriek | Waarde |
|---|---|
| Gelijktijdige agenten, Navier-Stokes-groep | in de orde van 10.000 |
| Tijd tot de oplossing | ongeveer 88 uur |
| Formalisering en verificatie in Lean | nog eens 17 uur, via GPT-6 Astra |
| Uitgewisselde berichten, Navier-Stokes | 2,7 miljoen |
| Uitvoertokens, Navier-Stokes | ongeveer 130 miljard |
| Uitgewisselde berichten, alle onderzochte problemen | 4,9 miljoen |
| Uitvoertokens, alle onderzochte problemen | ongeveer 300 miljard |
| Weerlegging van de regelmatigheid van niet-gedwongen Euler | bijna 100 agenten, ongeveer 50 uur |
Een concurrerend onderzoek maakt het beeld ingewikkelder. Levent Alpöge, medewerker van Anthropic, en Tristan Buckmaster, hoogleraar wiskunde aan NYU, beschikten over een resultaat voor de gedwongen versie van de Euler-vergelijkingen. OpenAI nam op 6 september contact met hen op, nadat zijn project was voltooid en geverifieerd, om een gezamenlijke publicatie voor te stellen en hun eerdere werk te erkennen, voordat het ontdekte dat hun resultaat betrekking had op een andere formulering.
This model represents a step-function improvement on many benchmarks, and its training is ongoing. Our internal model group arrived at the Navier–Stokes solution in 88 hours, using around 10,000 coordinating AI agents. Throughout the effort, we maintained the strict safeguards—including monitoring and isolation—that we apply to all our frontier evaluations.
🇳🇱 Dit model vertegenwoordigt een sprongsgewijze verbetering op tal van benchmarks en de training ervan gaat door. Onze interne modelgroep bereikte de oplossing voor Navier-Stokes in 88 uur, met ongeveer 10.000 gecoördineerde AI-agenten. Gedurende de hele inspanning handhaafden we de strikte waarborgen, waaronder toezicht en isolatie, die we toepassen op al onze evaluaties van grensverleggende modellen. — @OpenAI op X
Diezelfde dag publiceert OpenAI een aanzienlijk bescheidener en veel beter verifieerbare casestudy. Beatriz Yankelevich, promovenda bij de groep Engineering Quantum Systems van MIT, koppelde Codex, aangestuurd door GPT-5.6 Sol, aan de software die haar experimenten coördineert om een ongekalibreerde chip met zes supergeleidende qubits te kalibreren. De agenten kregen skills die specifiek waren voor elk type meting en beschreven hoe die moest worden uitgevoerd en beoordeeld. Bij duidelijke signalen voerde Codex met weinig tussenkomst een volledige reeks uit: identificatie van de overgangsfrequenties, kalibratie van de besturings- en uitleespulsen en meting van de bewaartijd van de kwantuminformatie. Bij zwakke signalen of veel ruis duurt het langer voordat bruikbare parameters worden gevonden en is soms het oog van een ervaren onderzoeker nodig, die nog altijd sneller is dan het model. De winst zit dus niet in snelheid, maar in het ontbreken van voortdurend toezicht: het karakteriseren van een van deze standaardchips kost een onderzoeker meerdere dagen, en de groep laat routinemetingen voortaan aan agenten over.
🔗 Navier-Stokes-oplossing, OpenAI · 🔗 Codex en kwantumexperimenten, OpenAI
ChatGPT Images 2.5, met Sketch en twee afbeeldingsmodellen in de API
8 september — OpenAI lanceert ChatGPT Images 2.5 in zijn producten en in de API. Het gebruikscijfer waarmee het bericht opent, maakt duidelijk wat er op het spel staat: elke week worden er meer dan 3 miljard afbeeldingen gemaakt met ChatGPT Images en de GPT-Image-modellen van de API. De concreetste verbetering is de latentie, die tot 50 procent lager ligt dan bij Images 2.0. De overige verbeteringen betreffen de getrouwheid aan referentiefoto’s en de consistentie tijdens lange gesprekken, waarbij eerdere wijzigingen beter behouden blijven.
Aan de ChatGPT-kant komen er drie functies bij. Met Sketch kun je rechtstreeks in het gesprek tekenen om een visuele leidraad te bieden, door „@Sketch” te typen. Templates ondersteunen gangbare formaten, zoals posters of merchandising. Opmerkingen kunnen op de afbeelding worden geplaatst om een bewerking gericht aan te geven. Bij het delen van een afbeelding kan voortaan ook de prompt worden opgenomen waarmee deze is gemaakt. De uitrol omvat alle gebruikers van ChatGPT, ChatGPT Work en Codex, op desktop, mobiel en het web, ongeacht het abonnement.
| Model in de API | Aangekondigde positionering | Latentie |
|---|---|---|
| GPT-Image-2.5 Flare | standaardkeuze, sociale content, generatie op schaal | tot 50 procent lager dan Images 2.0 |
| GPT-Image-2.5 Sunburst | precisie, campagnes die klaar zijn voor publicatie | langere generatietijden |
Beide modellen ondersteunen de nieuwe kwaliteitsinstellingen xhigh en max en hanteren dezelfde tokenprijzen als GPT Image 2: in de Standard-laag 8,00 dollar per miljoen tokens voor afbeeldingsinvoer, 30,00 dollar voor afbeeldingsuitvoer en 5,00 dollar voor tekstinvoer. De C2PA-metadata en het onzichtbare watermerk blijven behouden, en de release gaat vergezeld van een system card.
Manus integreert het model nog dezelfde dag
Manus voegt GPT-Image-2.5 op de avond van de aankondiging toe aan zijn platform en verwijst daarbij naar het bericht dat OpenAI anderhalf uur eerder publiceerde. Het agentlab, dat op 1 september opnieuw onafhankelijk werd, noemt een cijfer uit zijn eigen evaluaties en niet uit die van OpenAI: het model dat het Flare noemt, produceert afbeeldingen van hoge kwaliteit met een snelheid die twee tot vier keer hoger ligt dan die van GPT-Image-2. Voor een agent die tijdens een gesprek beelden genereert, weegt die factor zwaarder dan een marginale kwaliteitsverbetering, omdat hij bepaalt of de generatie deel blijft uitmaken van de workflow of een wachttijd oplegt. Manus benadrukt ook de verbeterde generatie van transparante achtergronden, waardoor de stap van handmatig vrijstaand maken, die volledige automatisering doorbreekt, niet meer nodig is.
AlphaGenome Atlas, de voorspellende kaart van 9 miljard mutaties in menselijk DNA
8 september — Google DeepMind lanceert AlphaGenome Atlas, een database die het moleculaire effect voorspelt van elke mogelijke mutatie van één letter in menselijk DNA. Het menselijk genoom telt ongeveer 3 miljard basenparen, waarvan slechts 2 procent voor eiwitten codeert; de overige 98 procent is nog grotendeels onverkend, hoewel één enkele letterwijziging er een essentiële biologische regulator kan uitschakelen.
De methode berust op een omkering van de werklast. In plaats van elk laboratorium het model variant voor variant te laten raadplegen, heeft Google DeepMind de voorspellingen van het AlphaGenome-model vooraf berekend voor alle 9 miljard mogelijke substituties. Het resultaat is een dataset van 1 petabyte, die volgens Google meer dan dertig keer zo groot is als de AlphaFold Database. Om dit volume bruikbaar te maken, introduceert de Atlas de AVI-score (AlphaGenome Variant Impact), één getal dat voorspellingen voor coderende en niet-coderende regio’s samenvoegt en aangeeft welke biologische processen een variant verstoort, met toeschrijvingen per kenmerk. Daar komt een catalogus bij van meer dan 2.500 terugkerende sequentiemotieven, de regulerende eenheden die Google omschrijft als de „woorden” van het genoom.
| Metriek | Waarde |
|---|---|
| Vooraf berekende varianten | 9 miljard, alle wijzigingen van één letter |
| Omvang van de dataset | 1 petabyte, meer dan 30 keer de AlphaFold Database |
| Gecatalogiseerde sequentiemotieven | meer dan 2.500 |
| Geanalyseerde deelnemers aan UK Biobank | meer dan 54.000 |
| Aanvullende niet-coderende associaties | 22 procent meer |
| Geïdentificeerde genetische regio’s voor BMI | 19 |
Twee gedocumenteerde toepassingen tonen de omvang van de winst. Bij het Broad Institute gebruikten Laura Covill en haar team de AVI-score om kandidaatvarianten voor zeldzame ziekten die nog niet waren gediagnosticeerd te prioriteren: de tool wees een variant van het DNM1-gen aan en voorspelde dat deze een onjuiste splicingsite creëerde, wat het doorslaggevende bewijs leverde om de casus op te lossen. Aan de University of Exeter paste Gareth Hawkes de Atlas toe op gegevens van meer dan 54.000 deelnemers aan de UK Biobank en vond hij 22 procent meer niet-coderende genetische associaties. Vervolgens identificeerde hij 19 genetische regio’s die verband houden met de body mass index door zich te beperken tot de 1 procent varianten met de grootste impact.
De toegang is het tweede opvallende punt. De Atlas is beschikbaar via een webportaal waarvoor geen code hoeft te worden geschreven, bedoeld voor clinici en biologen die niet programmeren, maar ook via de AlphaGenome API, in de Cloud via Model Garden, waarbij de onderzoeksgegevens op GitHub zijn gepubliceerd. Een detail dat ontwikkelaars die het agentecosysteem van Google volgen zal interesseren: de Atlas wordt ook aangeboden als skill in Google Antigravity en kan dus rechtstreeks door een coding agent worden ingezet.
🔗 AlphaGenome Atlas, Google DeepMind
NVIDIA lanceert CUDA Rust en Cosmos domineert de AI City Challenge van ECCV
8 september — NVIDIA brengt CUDA Rust uit, als antwoord op een steeds zichtbaarder gemis: de systeemlaag van AI wordt steeds vaker in Rust geschreven, maar de GPU-kernel bleef de uitzondering. Het was al mogelijk om vanuit Rust een kernel te starten; deze moest alleen elders worden geschreven. CUDA Rust dicht deze kloof door Rust-kernels native naar PTX te compileren, via twee afzonderlijke trajecten die aansluiten bij de twee programmeermodellen die CUDA al voor C++ en Python aanbiedt.
| Onderdeel | cuda-oxide, SIMT-traject | cutile-rs, Tile-traject |
|---|---|---|
| Volwassenheid | vroege alpha | gepubliceerd op crates.io |
| Vereiste Rust-toolchain | vastgezette nightly (nightly-2026-04-03) | stable 1.89 of hoger |
| CUDA-versie | 12.x of hoger | 13.3 |
| Vereiste LLVM | ja, plus clang en libclang | nee |
| Compilatie | naar PTX tijdens het bouwen | JIT via CUDA Tile IR |
| Genoemde externe toepassingen | geen | Grout van Hugging Face, mistral.rs |
De aanbeveling van NVIDIA is expliciet: begin met Tile, omdat de broncode dan geen enkele architectuurspecifieke keuze vastlegt, en schakel over op SIMT wanneer fijnmazige controle over threads en geheugen noodzakelijk wordt. Die afweging brengt momenteel kosten met zich mee, omdat gedeeld geheugen, de basis van snelle kernels, bij SIMT nog steeds unsafe vereist. Het fundamentele argument is geheugenveiligheid tijdens het compileren: beide trajecten weigeren klassieke aliasing waarbij een buffer zowel als invoer als uitvoer dient, met error[E0502] aan de SIMT-kant en error[E0382] aan de Tile-kant. Wat de volwassenheid betreft, overdrijft NVIDIA niet: geen van beide projecten is klaar voor productie en de aangekondigde inzet strekt zich uit tot 2027 en daarna, met gezamenlijke werkzaamheden met de beheerders van rust-cuda.
Diezelfde dag publiceert NVIDIA de ranglijst van de AI City Challenge van ECCV 2026. In track 5, gewijd aan generatieve videovoorspelling van verkeerssituaties, gebruiken vier van de vijf beste oplossingen versies van de Cosmos-wereldfundatiemodellen. Team Qyn wint het openbare klassement met CosmosAlign, dat het bevroren Cosmos3-Nano-model met 16 miljard parameters aanpast met een LoRA-recept in twee stappen, vier voorspellingen genereert, de medoïde kiest en stabiele regio’s uit de geobserveerde geschiedenis opnieuw invoert: 76,39 tegenover 76,04 voor team SSUPER, een voorsprong van 0,35 punt. NVIDIA benadrukt dat dit een recept voor aanpassing en inferentie is, geen nieuwe architectuur. Cosmos treedt ook op als beoordelaar: in de twee klassementen buiten het domein van track 3 wint team UWIPL_ETRI met UniTraffic, dat betwiste beweringen laat controleren door een onafhankelijke Cosmos-Reason1-verificateur.
🔗 CUDA Rust, NVIDIA · 🔗 Ranglijst AI City Challenge
Cognition haalt meer dan 2 miljard dollar op en bereikt een waardering van 48 miljard
8 september — Cognition, de maker van de development agent Devin, kondigt aan meer dan 2 miljard dollar te hebben opgehaald tegen een waardering van 48 miljard. De ronde wordt geleid door twee nieuwe deelnemers, Andreessen Horowitz en Accel, naast bestaande investeerders Founders Fund, General Catalyst en Avenir. Een dertigtal andere deelnemers maakt de groep compleet, waaronder NVIDIA, Benchmark, Bessemer, Kleiner Perkins, Greylock, Lightspeed, T. Rowe Price en Bain Capital Ventures.
| Indicator | Mei 2026 | September 2026 |
|---|---|---|
| Opgehaald bedrag, totaal in ronde | meer dan 1 miljard dollar | meer dan 2 miljard |
| Waardering | 26 miljard dollar | 48 miljard |
| Geannualiseerde omzet | 492 miljoen dollar | bijna 900 miljoen |
| Hoofdinvesteerders | Lux Capital, General Catalyst, 8VC | Andreessen Horowitz, Accel |
De waardering is daarmee in vier maanden bijna verdubbeld en in een jaar bijna vervijfvoudigd, terwijl de geannualiseerde omzet dezelfde stijgende lijn volgt. Cognition licht de toepassingen toe die deze groei aanjagen: Devin werkt aan chipontwerp bij NVIDIA, aan luchtvaart bij GE Aerospace, aan financiële dienstverlening bij Citi, aan auto’s bij Mercedes-Benz en aan AI-infrastructuur bij Modal. Dat NVIDIA zowel klant als investeerder in de ronde is, illustreert hoe deze bedrijven de toegang veiligstellen tot de tools die ze intern gebruiken. Drie recente mogelijkheden verschuiven Devin van taakuitvoering naar autonoom handelen: Auto-Triage voor de eerste onderzoeksronde bij incidenten, Security Swarm voor het beoordelen van kwetsbaarheden en Automations die worden geactiveerd door gebeurtenissen in Slack, GitHub of Linear. In één jaar zijn zes kantoren geopend, waarvan vijf buiten de Verenigde Staten, naast de vestigingen in San Francisco, New York en Austin.
In the next chapter of software engineering, agents will become proactive by default, software will improve itself, and compute will automatically get allocated toward the highest impact use cases. We’re still at the dawn of the self-driving software era.
🇳🇱 In het volgende hoofdstuk van software-engineering worden agents standaard proactief, verbetert software zichzelf en wordt rekenkracht automatisch toegewezen aan toepassingen met de grootste impact. We staan nog maar aan het begin van het tijdperk van autonome software. — @cognition op X
Suno sluit een overeenkomst met Believe en TuneCore, die gisteren nog weigerden zijn muziek te distribueren
8 september — Suno kondigt een wereldwijd strategisch partnerschap aan met Believe, een bedrijf voor artiestenontwikkeling, en zijn zelfdistributieplatform TuneCore. De overeenkomst omvat twee afzonderlijke zaken. Ten eerste wordt Believe betrokken bij het ontwerp van de nieuwe muziekmodellen die Suno samen met de industrie ontwikkelt. Ten tweede, en dat is het concrete punt voor gebruikers, komen nummers die met dit nieuwe partnermodel zijn gemaakt in aanmerking voor distributie via Believe en TuneCore, en daarmee naar Spotify, Apple Music, Amazon Music en YouTube.
De context maakt duidelijk hoe belangrijk de aankondiging is. Suno herinnert er onomwonden aan dat Believe en TuneCore eerder dit jaar aankondigden geen muziek te distribueren die was gemaakt met modellen die niet aan hun criteria voldeden, waaronder destijds die van Suno. De koerswijziging wordt gepresenteerd als het resultaat van gesprekken waaruit gedeelde waarden naar voren kwamen: artiesten echte keuzemogelijkheden bieden en nieuwe wegen naar distributie en inkomsten openen.
De overeenkomst past in een samenhangende reeks ontwikkelingen. Ze bouwt voort op Spark, het programma van Suno voor onafhankelijke en opkomende artiesten, en vult de bestaande overeenkomsten met Warner Music Group en BMG aan door onafhankelijke labels en artiesten die in eigen beheer produceren erbij te betrekken. Suno koppelt de overeenkomst ook expliciet aan zijn recente waarborgen: het audiowatermerk en de akoestische vingerafdruk waarmee zijn nummers buiten het platform kunnen worden geïdentificeerd, en de downloadlimieten die op 3 september van kracht werden om massale verspreiding naar streamingdiensten te voorkomen. Deze beveiligingsmaatregelen zullen van toepassing zijn op muziek die door Believe en TuneCore wordt gedistribueerd. De aankondiging eindigt met een tijdschema: Suno meldt dat zijn nieuwe modellen zeer binnenkort worden gelanceerd, waarvan de familie op 4 september de naam v6 kreeg.
🔗 Partnerschap met Believe, Suno
Cohere brengt een serving-engine uit die rond een megakernel is gebouwd en 1,58x sneller is dan vLLM
8 september — Cohere brengt een inference-serving-engine uit die volledig rond een decoding-megakernel is gebouwd, onder de Apache 2.0-licentie. Het bedrijf claimt een primeur: geen snelheidsdemonstratie in een laboratorium, maar een complete server die echte verzoeken kan verwerken achter een OpenAI-compatibel endpoint, met continuous batching, paged attention, prefix caching en tool calling. Het gebruikte model is North Mini Code, een mixture of experts met 30 miljard parameters, waarvan slechts 3,3 miljard per token actief zijn.
Het aangepakte probleem laat zich in één zin samenvatten: tijdens het decoden besteedt de GPU veel tijd aan wachten in plaats van rekenen. Een klassieke stack start één kernel per bewerking, en elke kernelgrens legt een barrière op aan de volledige compute-grid. Autoregressief decoden wordt echter beperkt door de geheugenbandbreedte: bij elke stap verplaatst North Mini Code 6,6 GB aan gewichten uit het HBM-geheugen, plus ongeveer 0,5 GB aan key-value-cache bij een context van 8K, waardoor de theoretische bovengrens rond 470 tokens per seconde ligt op de 3,35 TB/s van een H100. Een megakernel verwijdert deze grenzen door één persistente kernel te starten die gedurende de volledige decoding-stap resident blijft, waarbij afhankelijkheden worden teruggebracht tot tellers in het globale geheugen.
| Maatstaf | Megakernel | vLLM v0.24 | Winst |
|---|---|---|---|
| Decoding, batchgrootte 1, context 8K (tok/s) | 292 | 185 | 1,58x |
| AIME 2025, end-to-end (tok/s) | 935 | 661 | 1,41x |
| SciCode, end-to-end (tok/s) | 711 | 560 | 1,37x |
| MMLU-Pro, subset informatica (tok/s) | 948 | 713 | 1,33x |
| LiveCodeBench v6, end-to-end (tok/s) | 803 | 625 | 1,28x |
| GPQA, end-to-end (tok/s) | 787 | 631 | 1,25x |
De 292 tokens per seconde bij batchgrootte 1 vertegenwoordigen 62 procent van de theoretische bovengrens, tegenover 39 procent voor vLLM. De kwaliteit verandert niet: 38,9 procent tegenover 38,2 op SciCode en aan beide kanten 70,3 procent op LiveCodeBench v6, gemiddeld over zeven uitvoeringen. Eén detail verdient aandacht: de voorsprong hangt af van de verdeling van de experts, met 1,32x bij de werkelijke routing van het model tegenover 1,14x bij gesimuleerde uniforme routing, waardoor uniforme metingen het ongunstige geval vormen. Tot slot benadrukt Cohere een contra-intuïtief punt: het schrijven van een megakernel zou eenvoudiger zijn dan de reputatie ervan doet vermoeden, met één CUDA-bestand waarin zestien operation codes de volledige decoding-stap afdekken. De beperkingen worden erkend en omschreven als implementatiebeperkingen: uitsluitend decoding, terwijl prefill nog met gewone PyTorch-kernels draait, alleen H100 en BF16, en batchgroottes van 1 tot 8.
Anthropic documenteert hoe de kosten van Claude Platform kunnen worden verlaagd zonder prestatieverlies
8 september — Anthropic publiceert een engineeringgids die ingaat tegen het gangbare idee dat een lagere rekening voor een agent automatisch slechtere resultaten betekent. Drie hefbomen worden beschreven: het hitpercentage van de prompt-cache maximaliseren, prompt-anti-patterns verwijderen bij de overstap naar een frontier model en de effort afstemmen op de taak. De methode wordt aangeboden als uitvoerbare opdrachten in Claude Code, waarbij /claude-api prompt-audit en /claude-api hillclimb zich voegen bij /claude-api cost-optimize.
| Benchmark, Sonnet 5 als basis | Kostenverlaging | Gemeten detail |
|---|---|---|
| LegalBench | ongeveer 58 procent | reasoning-tokens van 102 779 naar 8 284 |
| tau2-bench retail | ongeveer 73 procent | prompt-cache met expliciete breekpunten |
| OfficeQA Pro | ongeveer 52 procent | van 136,20 naar 64,87 dollar |
| SWE-bench Verified | ongeveer 55 procent | mediane stappen van 29 naar 17, prompt-tokens meer dan gehalveerd |
Het meest bruikbare cijfer staat niet in deze tabel. Op CursorBench 3.2 evenaart Claude Fable 5.1 met low effort Fable 5 met high effort voor een derde van de kosten, deels dankzij het tarief voor cache reads, die 0,25 dollar per miljoen tokens kosten tegenover voorheen 1,00 dollar. Daarentegen levert het hoogste effort-niveau op Humanity’s Last Exam zonder tools ongeveer een half punt op voor 46 procent extra kosten, een winst die wegvalt in de ruis van de benchmark.
🔗 Kosten verlagen op Claude Platform
Claude Code 2.1.265: pluginmappen, limiet van 1 GB en herstel van de prompt-cache
8 september — Claude Code gaat naar versie 2.1.265 met vijftig changelog-items, waaronder vierendertig fixes, twee dagen na versie 2.1.263, die er slechts één bevatte. De optie --plugin-dir accepteert voortaan een volledige map met plugins; elke submap met een manifest wordt geladen en toevoegingen en verwijderingen tijdens de uitvoering worden gedetecteerd. Voor toolresultaten die naar schijf worden geschreven geldt een limiet van 1 GB, waarbij de preview meldt dat een bestand is afgekapt.
Het uitgebreidste deel betreft de prompt-cache, in aansluiting op de gids die dezelfde dag werd gepubliceerd. Twee afzonderlijke fixes herstellen gevallen waarin Claude Code zelf het hergebruik van de cache verstoorde: het hervatten van een sub-agent die op de voorgrond was gestart, wijzigde diens toollijst en prefix van de system prompt, terwijl agent-teamgenoten en hervatte sub-agents de context van SubagentStart-hooks en vooraf geladen skills buiten de prefix plaatsten. Twee fixes hebben betrekking op beveiliging: een pluginpad met een backslash omzeilde op macOS en Linux de containmentcontrole voor symbolische links, en op Windows weigerden lees- en schrijftools elk bestand in een AppContainer of een sandbox met beperkt token. Het lezen van een artifact dat door een derde partij is geschreven, wordt voortaan behandeld als niet-vertrouwde inhoud.
Amp vervangt de berichtenwachtrij door directe aansturing
8 september — Amp verandert het standaardgedrag van zijn agent voor berichten die tijdens het werk worden verzonden. Tot nu toe werd een bericht dat werd getypt terwijl de agent actief was in een wachtrij geplaatst en pas verwerkt nadat de beurt was voltooid; voortaan wordt het bij de eerst mogelijke gelegenheid afgeleverd. De ontwikkelaar noemt twee voordelen: de agent verwerkt feedback eerder en stopt met verificatiestappen die door de nieuwe instructie overbodig zijn geworden. Dat bespaart tijd en tokens in het veelvoorkomende geval waarin men ziet dat de agent de verkeerde kant opgaat.
De verandering heeft ook neveneffecten, en Amp documenteert die. Als de aansturing te abrupt blijkt, adviseert de ontwikkelaar verzoeken te formuleren als ‘When done, then…’ in plaats van ‘Now, …’, om expliciet aan te geven dat de instructie na de huidige taak geldt. Ship, Review en de andere ingebouwde acties behouden het oude gedrag en blijven in de wachtrij staan, omdat het werk doorgaans voltooid moet zijn voordat het wordt opgeleverd of beoordeeld. Handmatig in de wachtrij plaatsen blijft beschikbaar, zowel in de applicatie als in de CLI.
🔗 Aansturen, niet in de wachtrij plaatsen, Amp
Muse Spark 1.3 komt naar Cursor met de beste score-kostenverhouding van CursorBench
8 september — Cursor voegt Muse Spark 1.3 toe, het agentic model van Meta Superintelligence Labs, zes dagen na de presentatie ervan. De gepubliceerde cijfers vertellen geen verhaal over pure prestaties, maar over kosten. Op CursorBench 3.2, de interne benchmark die is opgebouwd uit echte taken met meerdere bestanden, behaalt het Max-niveau 67,9 procent voor 1,31 dollar per taak en eindigt het als twaalfde.
| Model en niveau | CursorBench 3.2-score | Kosten per taak, in dollar | Tokens per taak | Rang |
|---|---|---|---|---|
| Fable 5.1 Max | 73,4 procent | 9,64 | 72 060 | 1 |
| Grok 4.6 Extra High | 70,8 procent | 2,81 | 41 136 | 3 |
| Opus 5 Max | 70,0 procent | 8,23 | 61 838 | 5 |
| Gemini 3.8 Flash High | 69,2 procent | 2,38 | 81 524 | 9 |
| Muse Spark 1.3 Max | 67,9 procent | 1,31 | 33 034 | 12 |
| GPT-5.6 Sol Max | 67,2 procent | 5,69 | 28 320 | 13 |
| Muse Spark 1.3 Low | 55,0 procent | 0,45 | 12 181 | 49 |
Het model van Meta blijft qua score dus ver achter Claude Fable 5.1 Max, maar dat laatste kost per taak meer dan zeven keer zoveel. Belangrijker is dat het GPT-5.6 Sol op het Max-niveau voorblijft terwijl het ruim vier keer goedkoper is. Cursor houdt vast aan zijn methode om voor elk toegevoegd model systematisch zowel de score als de kosten per taak te publiceren, in plaats van alleen de beschikbaarheid aan te kondigen.
Grok Bot laat formulieren en inloggegevens vanuit de chat invullen, Grok Imagine krijgt controle via keyframes
8 september — SpaceXAI maakt het voortaan mogelijk formulieren en inlogpagina’s voor zijn Grok Bot in te vullen zonder het gesprek te verlaten, met aangekondigde ondersteuning voor elke password manager. De functie pakt een specifiek knelpunt voor persistente agents aan: zodra de agent een inlogscherm moet passeren of een formulier met persoonlijke informatie moet indienen, heeft deze opgeslagen inloggegevens of tussenkomst van de gebruiker nodig. Deze stap naar de conversatiethread halen in plaats van naar een afzonderlijke browsersessie is zowel een ergonomische als een beveiligingskeuze.
Twee uur later krijgt Grok Imagine controle over de begin- en eindbeelden van een videoscène, evenals het genereren van naadloze loops, met betere opvolging van instructies en een aangekondigd hogere videokwaliteit. Controle via keyframes verandert de aard van de tool voor wie opeenvolgende shots produceert: door het laatste beeld van een shot vast te leggen, kan het als eerste beeld van het volgende worden hergebruikt, zodat reeksen kunnen worden aaneengeschakeld waarvan de continuïteit niet langer van het toeval van de generatie afhangt. De aankondiging komt drie dagen na de ingebruikname van de Grok Imagine Video 1.5-agent, aangedreven door het Image 2.0-model.
🔗 Formulieren invullen in Grok Bot · 🔗 Keyframes in Grok Imagine
Drie onderzoeksartikelen op de Hugging Face-blog
8 september — Drie publicaties van de Hugging Face-community zijn dezelfde dag het lezen waard, over het weer, modelveiligheid en door levende systemen geïnspireerde modellen.
Een open weermodel zonder GPU draaien
Hugging Face en Earthmover publiceren samen een artikel over een zelden behandeld probleem: weermodellen op basis van machine learning zijn licht genoeg om op een laptop te draaien, en toch voert vrijwel niemand ze uit. Er worden drie obstakels genoemd: rekenkracht — verschillende modellen, waaronder AIFS, zijn afhankelijk van flash attention, dat tot bepaalde GPU-architecturen beperkt is — opslag en vooral bandbreedte, met ongeveer 1 GB aan initiële condities per voorspelling. Het antwoord bestaat uit drie publieke artifacts: een demonstratiespace, een storage bucket en een reproduceerbare tutorial die Aurora, het model van Microsoft, uitvoert in de voorgetrainde versie met een resolutie van 0,25 graad, met ERA5-initiële condities die via de datamarktplaats van Earthmover worden aangeboden. Er is geen GPU vereist: twee tot drie minuten per rekenstap op een processor, enkele seconden op een GPU, en vier stappen van zes uur voor een voorspelling van vierentwintig uur die vervolgens met ERA5 wordt vergeleken.
🔗 Open weermodellen met Earthmover
Een naar verluidt veiliger model dat driekwart van de onschuldige vragen weigert
Multiverse Computing publiceert een resultaat dat veel breder aandacht verdient dan alleen binnen onderzoek naar alignment. Door Qwen3-8B te trainen om verzoeken tot politieke manipulatie te weigeren, behaalt het team cijfers die op een duidelijke overwinning lijken: het gemiddelde percentage gevaarlijke antwoorden op HarmBench, StrongREJECT en WildJailbreak daalt van 26,26 naar 0,14 procent. Op hetzelfde checkpoint stijgt de over-refusal op XSTest van 2,00 naar 74,00 procent. Met andere woorden: de configuratie die op papier het veiligst is, is een weigeringsmachine, en niets in de gebruikelijke metingen maakt dat zichtbaar. Twee correcties lossen het probleem op: door externe compliance-antwoorden te vervangen door geverifieerde antwoorden van het doelmodel daalt de XSTest-over-refusal van 15,20 naar 5,20 procent, en door goedaardige grensparen toe te voegen daalt de over-refusal aan de kant die moet worden ingewilligd van 32,94 naar 4,16 procent, terwijl de weigering aan de schadelijke kant slechts vier punten verliest.
🔗 Veiligheid voor wie, Multiverse Computing
Een vliegenconnectoom verslaat zijn eigen door elkaar gehusselde bedrading niet
Oruk publiceert een methodologische les die verder reikt dan door connectomen geïnspireerde modellen. Het team kopieerde 499 sterk verbonden neuronen uit de openbare MaleCNS-reconstructie van een vlieg naar een recurrent netwerk dat als reservoir diende, met daarbovenop slechts één getrainde ridge readout. De bedrading van de vlieg behaalt tijdens de test een gemiddelde nauwkeurigheid van 16,84 procent, door elkaar gehusselde bedrading 16,88 procent: het verschil bedraagt min 0,04 punt, met een betrouwbaarheidsinterval dat nul omvat. Het tweede experiment had als bewijs van het tegendeel kunnen worden gezien, omdat het verwijderen van de 50 neuronen met de grootste normen van de readout-gewichten de nauwkeurigheid van 16,91 naar 10,83 procent laat dalen. De auteurs leggen uit waarom er geen tegenspraak is: een spectaculaire ablatie toont nooit aan dat een biologische topologie noodzakelijk was. Vermeldenswaard is dat het artikel zelf aangeeft dat het door een AI-agent is voorbereid op basis van een niet-peer-reviewed paper, en dat de volledige evaluatiedataset privé blijft.
🔗 Connectoom en door elkaar gehusselde bedrading, Oruk
Runway neemt het team van het Parijse laboratorium Kinetix aan
8 september — Runway kondigt aan dat het team van Kinetix, een in Parijs gevestigd AI-onderzoekslaboratorium, zich bij het bedrijf aansluit. Het laboratorium werkte aan menselijke beweging in 3D en aan videogeneratie die in natuurkunde is verankerd, twee onderwerpen die Runway rechtstreeks koppelt aan zijn onderzoek naar world models voor robotica. Het team sluit zich aan bij de Parijse afdeling van het bedrijf, die daarnaast lokaal mensen werft voor onderzoeks- en engineeringfuncties.
Het technische argument wordt in één zin uit de aankondiging samengevat: een werkelijk nuttige robot moet nieuwe omgevingen, taken en situaties begrijpen en aankunnen, en grootschalige video-pretraining biedt volgens Runway de effectiefste manier om deze generalisatieproblemen op te lossen. Dit ligt rechtstreeks in het verlengde van Solaris, gepresenteerd op 31 augustus, en GWM Worlds 2, gepresenteerd op 3 september: nadat het modellen heeft geleerd de wereld te simuleren, wil Runway ze leren erin te handelen. Yassine Tahi, algemeen directeur van Kinetix, dateert de oorspronkelijke ambitie van het laboratorium op zes jaar geleden. Er worden geen bedrag of transactiestructuur bekendgemaakt.
🔗 Kinetix sluit zich aan bij Runway
Sarah Friar becijfert de schaal van OpenAI en het effect van zijn modellen op de kosten
8 september — Sarah Friar publiceert een opiniestuk over hoe OpenAI zijn onderzoeksdoorbraken omzet in economische activiteit. Het belang van de tekst ligt eerder in drie niet eerder gepubliceerde cijfers dan in het betoog.
| Indicator | Waarde |
|---|---|
| Wekelijks actieve gebruikers | meer dan één miljard |
| Zakelijke klanten | 2,5 miljoen |
| Dagelijkse berichten na zes maanden, individuele abonnementen | ongeveer 50 procent meer dan in de eerste maand |
| Verschillende taken geprobeerd na zes maanden | ongeveer het dubbele |
| End-to-end servicekosten na optimalisatie | 20 procent lager |
| Efficiëntie van tokengeneratie | meer dan 15 procent |
Het derde cijfer maakt een interessante cirkel rond. GPT-5.6 Sol werd gebruikt om OpenAI’s productiesoftware voor de dienstverlening te verbeteren, wat resulteerde in 20 procent lagere servicekosten, boven op een efficiëntiewinst van meer dan 15 procent bij het genereren van tokens. Met andere woorden: het model financiert een deel van zijn eigen infrastructuur door de laag die het bedient te optimaliseren. Het verloop van individueel gebruik beantwoordt bovendien een vaak gestelde maar zelden gedocumenteerde vraag: die van retentie.
🔗 Werk nu binnen handbereik, OpenAI
OpenAI trekt 5 miljoen dollar uit voor onafhankelijk onderzoek naar tieners
8 september — OpenAI start een subsidieprogramma van 5 miljoen dollar voor onafhankelijk onderzoek naar de effecten van generatieve AI op 13- tot 17-jarigen, met expliciete aandacht voor hun sociale en emotionele ontwikkeling. Individuele subsidies kunnen oplopen tot 1 miljoen dollar per project. De inschrijvingen sluiten op 6 oktober 2026, geselecteerde projecten krijgen uiterlijk 13 november 2026 bericht, in het eerste kwartaal van 2027 wordt een voortgangsrapport verwacht en de overheadkosten zijn beperkt tot 10 procent per subsidie.
Twee details verdienen aandacht. Het eerste betreft de beoogde onafhankelijkheid: een van de beoordelingscriteria is het vermogen van het project om betrouwbare resultaten op te leveren, ongeacht of die gunstig zijn voor aanbieders van AI-producten, en publicatie wordt aangemoedigd zonder een voorwaarde voor financiering te zijn. Het tweede is administratief, maar wel van belang: de subsidies worden gefinancierd en beheerd door OpenAI Group PBC, de commerciële entiteit, en niet door de OpenAI Foundation. De timing is niet neutraal: OpenAI had op 31 augustus zijn steun uitgesproken voor het Californische wetsvoorstel over de bescherming van minderjarigen tegen AI, en in het bericht staat dat het bedrijf de besluitvorming van toezichthouders wil voeden.
🔗 Onderzoekssubsidies voor tieners
Kort nieuws
- Boris Cherny beoordeelt andere laboratoria publiekelijk op het risico van prompt injection — de maker van Claude Code plaatst het nieuwe model van OpenAI op hetzelfde niveau als Gemini Flash en Opus 4.8 wat prompt injection betreft, en staat achter zijn keuze om laboratoria publiekelijk te noemen zolang zij beveiliging niet serieuzer nemen. Ongeveer twintig minuten later zwakt hij de toon af in een reactie op zijn eigen thread. 🔗 Publicatie
- Anthropic publiceert een video met oprichters die bouwen op Claude Managed Agents — interviews met de oprichters van Wispr Flow, Actively en Pendo over het gebruik van outcomes, de sandbox en het geheugen om op te schalen. 🔗 Publicatie
- RelayShield scant instructiebestanden in plaats van de code in repositories — een betaalde dienst die AGENTS.md, CLAUDE.md, .cursorrules en mcp.json leest om kwaadaardige instructies in natuurlijke taal te detecteren die statische analyse niet ziet. Een in het bericht genoemd aantal kwaadaardige repositories komt niet overeen met de eigen bron. 🔗 Bericht
- Ai2 kondigt zijn aanwezigheid op ECCV 2026 aan — artikelen en presentaties verspreid over de conferentie, zonder bekendgemaakte titels of programma. 🔗 Publicatie
- Prismberry publiceert een essay over de gereedschapslaag van bedrijfsagents — een positioneringstekst die onderscheid maakt tussen tools voor informatie, analyse en actie, zonder aankondiging of meting, en die het product Agent IQ van de uitgever promoot. 🔗 Bericht
- Een logboek over hardwareonderhoud op de blog van Hugging Face — diagnose van slijtage aan een lager in de ventilator van een voeding van 650 W, zonder inhoud over kunstmatige intelligentie. 🔗 Bericht
- Missouri stelt Gemini for Education open voor 1,1 miljoen leerlingen en studenten — een partnerschap voor de hele staat dat bijna 100.000 docenten en meer dan 1,1 miljoen leerlingen en studenten gratis toegang geeft tot Gemini for Education, Gemini Notebook en Google-certificeringen, waarbij de gegevens niet voor training worden gebruikt en elke onderwijsinstelling zelf over invoering beslist. 🔗 Aankondiging
- Dependabot leest besloten GitHub-registers zonder persoonlijk token —
GITHUB_TOKENvan Dependabot kan om de toestemmingpackages: readvragen en pakketten uit besloten GitHub Packages-registers ophalen. De functie, die in juni werd uitgebracht en vervolgens teruggedraaid, keert terug met automatische inloggegevens die alleen nog als terugvaloptie dienen. 🔗 Changelog - Het supportportaal van GitHub verhuist naar help.github.com — support, documentatie, leren, community en accountresources worden op één plek samengebracht, met door Copilot aangedreven zoekfunctionaliteit waarvoor inloggen niet nodig is. 🔗 Changelog
- Genspark opent Spark House tijdens SF Tech Week met vroege toegang tot GenTeam — een community-initiatief dat deelnemers vroege toegang geeft tot GenTeam en besloten gesprekken tussen oprichters en investeerders. 🔗 Publicatie
- Ethan Tandowsky wordt financieel directeur van ElevenLabs — de tweede benoeming in de directie van ElevenLabs in zes dagen, na die van Ashley Kramer tot commercieel directeur op 2 september. 🔗 Publicatie
- MiniMax brengt in Tokio Japanse stemmen uit de entertainmentsector en vier spelers in generatieve AI samen — evenement op 11 september in Shibuya met producent Yasushi Akimoto, KADOKAWA, KAGAMIAI, Higgsfield, Krea, Runway en HeyGen, zonder lancering of cijfers. 🔗 Publicatie
- Twee uitzendingen van Nemotron Labs op dezelfde dag, over OpenShell en Domyn — 49 minuten en 44 seconden over het beveiligen van autonome agents met OpenShell, en 54 minuten en 20 seconden over Domyns gebruik van Nemotron, zonder beschrijvende tekst of transcriptie. 🔗 Publicatie
- HeyGen zet twee avatars met hetzelfde gezicht tegenover elkaar zonder een tool of model te noemen — marketingvergelijking zonder genoemde concurrerende tool, genoemd model of meting. 🔗 Publicatie
- OpenAI breidt zijn journalistiekprogramma uit naar journalistiekopleidingen — meer dan 400 ChatGPT Edu-abonnementen voor masterstudenten en docenten aan de Newmark J-School van CUNY en de Medill School van Northwestern, voor 2026-2027. 🔗 Aankondiging
- Perplexity publiceert een gids over het rendement van AI-integratie — educatief bericht zonder productaankondiging, waarvan alle cijfers afkomstig zijn van derden of klantgetuigenissen. 🔗 Bericht
Wat dit betekent
De persoonlijke agent wordt een infrastructuurproduct, en de beveiliging ervan wordt een volwaardig product. Meta levert niet alleen Muse: het publiceert diezelfde dag ook de tot nu toe meest gedetailleerde beschrijving van hoe een agent met toegang tot een shell, een browser en een mailbox in bedwang kan worden gehouden. De leerzaamste keuze is die voor vervangende tokens, waardoor prompt injection voor het stelen van inloggegevens irrelevant wordt, niet omdat het model beter weerstand biedt, maar omdat het het geheim nooit heeft gehad. Tainted egress volgt dezelfde logica: men vertrouwt het model niet, maar instrumenteert de kernel. De bug bounty van 300.000 dollar en de openhartigheid van de conclusie, waarin wordt erkend dat Muse fouten zal maken, zeggen hetzelfde als Boris Cherny wanneer hij andere laboratoria publiekelijk op dit risico beoordeelt. De beveiliging van agents is niet langer een afvinkvakje, maar een technisch werkterrein dat openbaar wordt gemaakt en waarvoor men betaalt om het te laten kraken.
De dag biedt ook een les in de economie van AI, waarbij niet langer de score maar de kosten per taak de rekeneenheid vormen. Mistral haalt 3 miljard euro op tegen een waardering van meer dan 21 miljard, Cognition meer dan 2 miljard tegen een waardering van 48 miljard, waarbij in beide gevallen industriële partijen en klanten aan tafel zitten in plaats van uitsluitend technologiefondsen. Tegelijkertijd publiceert Cursor een ranglijst waarin Muse Spark 1.3 67,9 procent behaalt voor 1,31 dollar per taak, terwijl de nummer één 9,64 dollar betaalt voor zes punten meer, en documenteert Anthropic kostenbesparingen van 52 tot 73 procent zonder prestatieverlies, waarbij het laat zien dat een sterker model met minder inspanning vaak beter presteert dan een zwakker model dat tot het uiterste wordt gedreven. Sarah Friar becijfert het andere uiteinde van de keten, met 20 procent lagere servicekosten doordat GPT-5.6 Sol de laag optimaliseerde die het model bedient. Dit zijn vier manieren om te zeggen dat de afweging is verschoven van capaciteit naar de prijs van die capaciteit.
Op wetenschappelijk gebied is de vraag niet langer óf agents resultaten produceren, maar hoe die worden geverifieerd. OpenAI kondigt een bewijs van singulariteit voor Navier-Stokes aan dat door ongeveer 10.000 agents in 88 uur is geproduceerd en in Lean is geformaliseerd, zonder vermelde peerreview of institutionele validatie, en met een intern model dat niemand buiten het bedrijf kan bevragen. De voorzichtigheid van het bedrijf, dat afziet van de millenniumprijs en spreekt van een momentopname, is op zichzelf informatief. De twee andere onderzoeken van die dag maken het contrast duidelijk: bij MIT kan Codex goed overweg met helder gedefinieerde protocollen, maar loopt het vast op dubbelzinnige signalen, en blijft een ervaren onderzoeker sneller; bij Google DeepMind beweert AlphaGenome Atlas niets te bewijzen, maar berekent het vooraf 9 miljard voorspellingen en verschuift het de inspanning naar experimentele validatie. Het bericht van Oruk rondt het betoog af door te laten zien dat een spectaculaire ablation niets bewijst zonder een gekoppelde vergelijking, en dat van Multiverse Computing herinnert eraan dat een beveiligingscijfer niets betekent zolang de goedaardige kant niet met dezelfde strengheid wordt gemeten.
Dan blijft de onderste laag over, waar de winst niet langer uit de gewichten komt. Cohere stelt een complete serving engine beschikbaar waarin de enige verandering het verwijderen van kernelgrenzen is, voor 1,58x de throughput van vLLM bij gelijke kwaliteit, en benadrukt dat de moeilijkheid van het schrijven van een megakernel wordt overschat. NVIDIA opent twee wegen om GPU-kernels in Rust te schrijven, waarvan er één al buiten het bedrijf wordt gebruikt in de inference engine Grout van Hugging Face en in mistral.rs, en erkent dat niets klaar is voor productie. Bij de AI City Challenge steunen vier van de vijf beste video-oplossingen op Cosmos-modellen die met LoRA zijn aangepast, waarbij het winnende team benadrukt dat het om een aanpassingsrecept gaat en niet om een nieuwe architectuur. De weerhandleiding van Earthmover vertelt vanaf het andere uiteinde hetzelfde verhaal: het model Aurora draait op één processor; de bottleneck was niet de berekening, maar de gigabyte aan beginvoorwaarden die moest worden gedownload. Telkens ligt de waarde in de engineering rond het model, en die wordt gepubliceerd.
Bronnen
- Lancering van Muse, Meta
- Beveiliging en veiligheid van agents met Muse, Meta
- Serie D van Mistral
- Aankondiging van de Serie D op X
- Oplossing van het Navier-Stokes-probleem, OpenAI
- OpenAI-thread over het interne model
- Codex en experimenten met quantumcomputing bij MIT
- ChatGPT Images 2.5, OpenAI
- Manus integreert GPT-Image-2.5
- AlphaGenome Atlas, Google DeepMind
- CUDA Rust, NVIDIA
- AI City Challenge van ECCV 2026, NVIDIA
- Serie E van Cognition
- Cognition-thread op X
- Partnerschap tussen Suno, Believe en TuneCore
- Megakernel voor decoding, Cohere
- Kosten verlagen op Claude Platform, Anthropic
- Claude Code 2.1.265
- Live aansturing van de agent, Amp
- Muse Spark 1.3 in Cursor
- Formulieren invullen in Grok Bot
- Keyframes en loops in Grok Imagine
- Open weermodellen met Earthmover, Hugging Face
- Beveiliging voor wie, Multiverse Computing
- Vliegenconnectoom en gemengde bedrading, Oruk
- Kinetix sluit zich aan bij Runway
- Opiniestuk van Sarah Friar, OpenAI
- Onderzoekssubsidies voor tieners, OpenAI
- Boris Cherny over het risico van prompt injection
- Oprichters die bouwen op Claude Managed Agents
- RelayShield en instructiebestanden
- Ai2 op ECCV 2026
- De gereedschapslaag van agents, Prismberry
- Logboek over hardwareonderhoud
- Gemini for Education in Missouri
- Dependabot en besloten GitHub-registers
- Nieuw supportportaal van GitHub
- Spark House tijdens SF Tech Week, Genspark
- Ethan Tandowsky, financieel directeur van ElevenLabs
- MiniMax-evenement in Tokio
- Uitzendingen van Nemotron Labs
- Vergelijking van HeyGen-avatars
- Journalistiekprogramma van OpenAI
- Gids over het rendement van AI, Perplexity