ai-powered-markdown-translatorArtikel översatt från franska till svenska med gpt-5.6-sol.
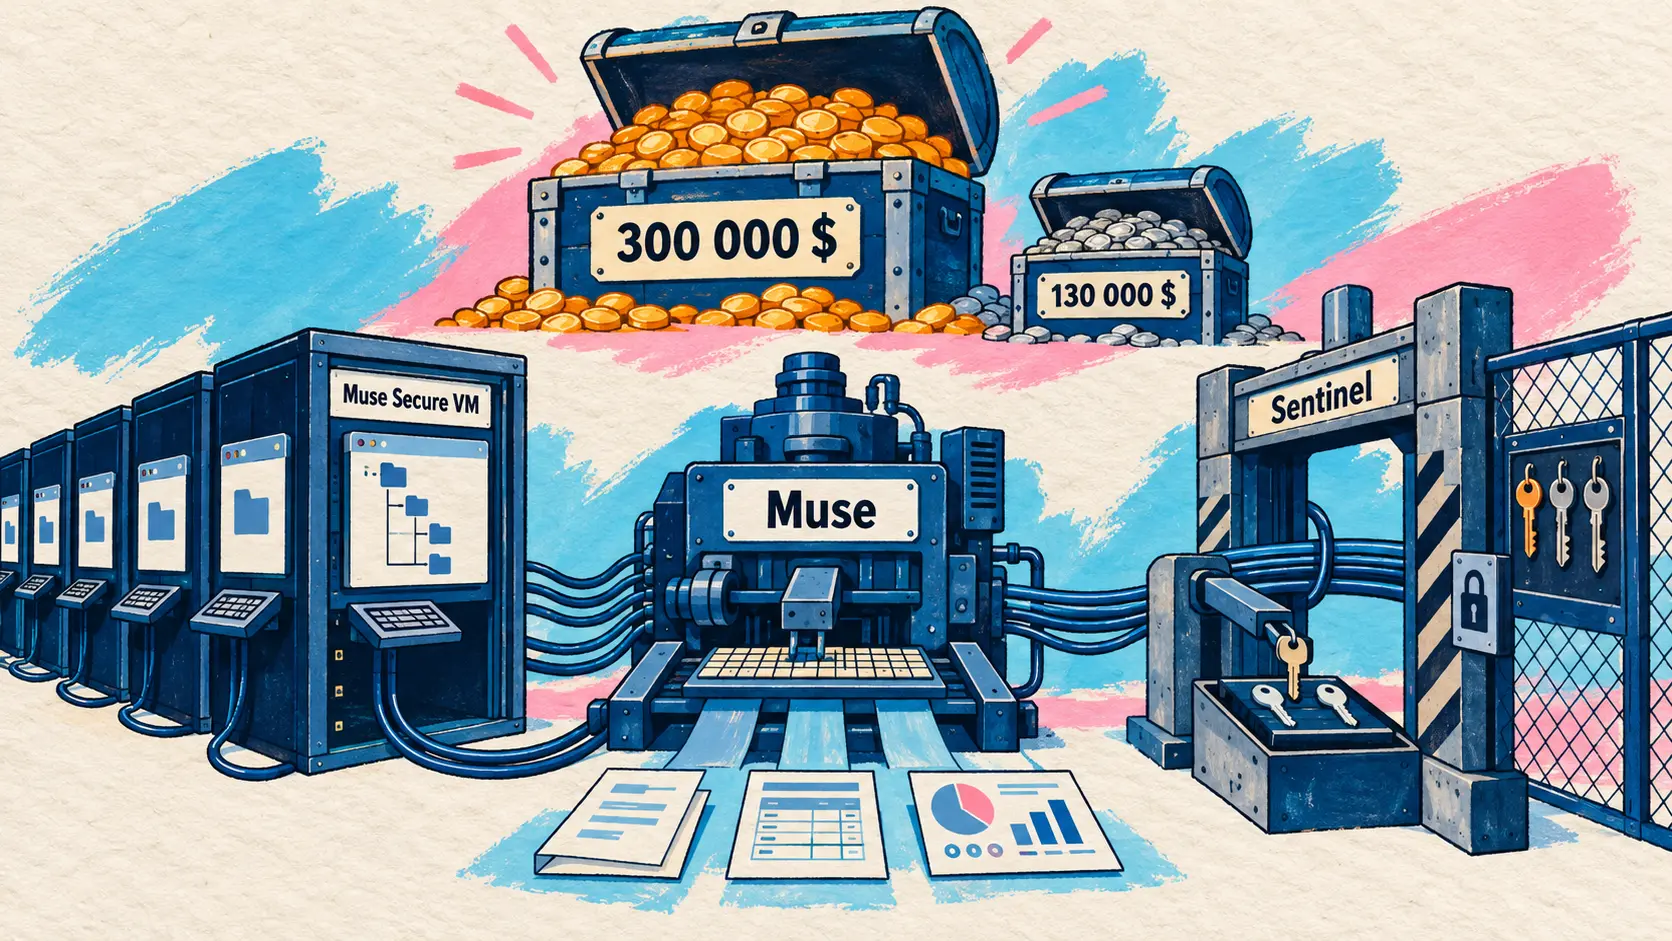
Meta lanserar Muse, en personlig agent som ger varje användare en egen Linux-maskin i molnet, och publicerar samma dag säkerhetsarkitekturen runt den, med ett bug bounty-program som är öppet för alla och erbjuder upp till 300 000 dollar. Mistral tillkännager en Serie D-runda på 3 miljarder euro, den största aktiefinansieringsrundan som någonsin slutförts av ett europeiskt teknikföretag. OpenAI publicerar å sin sida ett bevis för singularitet inom ändlig tid för Navier–Stokes-ekvationerna, framtaget av ett agentsystem, och Google DeepMind förberäknar effekten av de 9 miljarder möjliga mutationerna i människans DNA.
Meta lanserar Muse, sin personliga agent, och publicerar dess säkerhetsarkitektur
8 september — Meta lanserar Muse, en personlig agent som finns som iOS- och Android-appar, i ett webbgränssnitt och i WhatsApp, driven av Muse Spark 1.3. Modellen är inte ny: den kom den 2 september till Muse Code och Meta Model API, och dess högsta resonemangsnivå blev offentligt tillgänglig den 4 september. Det nya är konsumentprodukten som har byggts kring den.
Arkitekturen bygger på en idé som är enkel att formulera men tung att genomföra: varje användare får en egen dator i molnet. Muse Secure VM är en beständig och isolerad Linux-maskin med filsystem, terminal och fullständig webbläsare samt tillräckligt med lagring, processorkraft och minne för att kompilera kod, utveckla skräddarsydda skills och köra underagenter parallellt. Det är denna maskin, inte en centraliserad Meta-infrastruktur, som fungerar som referenssystem för data och autentiseringsuppgifter till anslutna tjänster. När ett verktyg saknas för en uppgift skriver agenten det själv, och den skapar manipulerbara objekt i stället för textblock: resplaner, PDF-filer, webbsidor och instrumentpaneler, som Meta kallar Artifacts.
Det andra påstådda paradigmskiftet är att agenten arbetar i bakgrunden när applikationen är stängd, enligt scheman och som reaktion på händelser, och sedan avgör om resultatet motiverar en avisering. Minnet är beständigt och kan läsas och ändras av användaren, medan fliken Mål ger en överblick över vad agenten följer. Kvarstår gör det Meta inte säger: inga priser har publicerats och lanseringen åtföljs inte av någon lista över länder där tjänsten är tillgänglig.
Tjugo minuter efter produktannonseringen publicerade Meta ett tekniskt dokument undertecknat av Tarek Sheasha, mjukvaruingenjör och vice vd vid Meta Superintelligence Labs, om systemets säkerhet. Den vägledande principen slås fast direkt: systemet är utformat med antagandet att agenten kommer att utsättas för angrepp. Agentens körmiljö, som i koden kallas Hatch, körs i en systemd-nspawn-container vars root mappas till en användare på värdsystemet utan särskilda privilegier, med filtrerade systemanrop och borttagna kärnfunktioner. Fyra tjänster ligger avsiktligt utanför denna container, så att en angripare som komprometterar agenten inte kan stänga av dem: säkerhetsklassificerarna, workers med separata privilegier, demonen för lagring av autentiseringsuppgifter och Sentinel.
Sentinel är den centrala komponenten: som enda instans med befogenhet att godkänna en connector-åtgärd eller utgående nätverkstrafik utvärderar den varje begäran på lager 4 och 7 och kontrollerar den faktiskt upplösta adressen. Framför allt hanterar agenten endast ersättningstokens, som byts ut mot de verkliga autentiseringsuppgifterna vid nätverksgränsen. Att genom prompt injection få agenten att avslöja en hemlighet blir meningslöst eftersom den aldrig har haft tillgång till den. Därtill kommer flödesspårning på kärnnivå, tainted egress: varje process som läser användardata märks och förlorar sitt automatiska tillstånd. Implementeringen kombinerar eBPF-program kopplade till cgroups med hooks för Linux Security Module som Meta har lagt till.
| Arkitekturkomponent | Vald lösning |
|---|---|
| Container för agentens körmiljö | systemd-nspawn, root mappad till en användare utan särskilda privilegier |
| Behörighetsinstans | Sentinel, utanför containern, lager 4 och 7 |
| Autentiseringsuppgifter som agenten ser | endast ersättningstokens |
| E-postconnector | filtrering av engångskoder och återställningslänkar |
| Underagent för webbläsaren | tillgänglighetsträd, ingen rå DOM, ingen JavaScript på sidan |
| Betalningar | Stripe Link vid lanseringen, därefter Shop Pay, kort för engångsbruk |
| Bug bounty, tak per giltig rapport | 300 000 dollar |
| Bug bounty, prompt injection | upp till 130 000 dollar |
Två tillkännagivanden åtföljer dokumentet. Bug bounty-programmet öppnas för alla redan vid lanseringen, med upp till 300 000 dollar per giltig rapport beroende på den påvisade effekten, varav upp till 130 000 dollar för en lyckad prompt injection som påverkar en användare. Muse Confidential VM, som planeras före årets slut, ska dessutom på ett kryptografiskt och verifierbart sätt hindra Meta från att komma åt data på en virtuell maskin, och både designen och källkoden har redan lämnats till externa granskare. Textens slutsats är ovanligt rättfram för en företagspublikation: prompt injection är fortfarande ett olöst problem i branschen, och Muse kommer att göra misstag.
🔗 Lanseringen av Muse · 🔗 Agenters säkerhet och trygghet, Meta
Mistral tar in 3 miljarder euro, den största aktiefinansieringsrundan inom europeisk tech
8 september — Mistral tillkännager en Serie D-runda på 3 miljarder euro till en post-money-värdering på över 21 miljarder euro. Företaget beskriver rundan som den största aktiefinansieringen som någonsin slutförts av ett europeiskt teknikföretag, bara tre år efter grundandet.
Samsung Electronics leder transaktionen. Scaleup Europe Fund, som förvaltas av EQT, och den befintliga aktieägaren PSG Equity är medansvariga för rundan. Tre nya investerare ansluter: Advent, fonder och konton som förvaltas av BlackRock samt Storhertigdömet Luxemburg. Listan över befintliga investerare är lång och sträcker sig över tre kontinenter, från a16z till Salesforce Ventures via ASML, BNP Paribas CIB, Bpifrance, DST Global, General Catalyst, Index Ventures, Korelya Capital, Lightspeed och NVIDIA.
Den detalj som förtjänar uppmärksamhet är vilken typ av aktörer som har lett de två senaste rundorna. ASML ledde Serie C-rundan och Samsung Electronics leder Serie D-rundan: två industriföretag inom avancerad tillverkning, inte allmänna teknikfonder. Mistral ser detta som ett tecken på förtroende för företagets förmåga att driftsätta avancerade modeller i komplexa industrimiljöer, där kontrollen över data och infrastruktur är avgörande för införandet.
| Indikator | Värde |
|---|---|
| Anskaffat belopp | 3 miljarder euro |
| Post-money-värdering | över 21 miljarder euro |
| Företagets ålder | 3 år |
| Huvudinvesterare | Samsung Electronics |
| Medansvariga investerare | Scaleup Europe Fund förvaltat av EQT, PSG Equity |
| Verksamhetsländer | 20 |
| Stora företagskunder | över 125, däribland Airbus, ASML och HSBC |
När det gäller användningen av kapitalet nämner företaget först forskning vid den tekniska frontlinjen, därefter utökad beräkningskapacitet för träning, expansion av infrastrukturen och snabbare internationell kommersiell tillväxt. Argumentationen följer den linje som företaget har drivit sedan sommaren: frågan för organisationer är inte längre vem som bygger den kraftfullaste modellen, utan hur AI kan användas utan att kontrollen över infrastrukturen överlåts. Mistral beskriver sig som det enda företaget i sektorn som sätter samman hela den nödvändiga stacken, från modeller med öppna vikter via beräkningskapacitet till produkter.
Today marks a major step for Mistral: we’re announcing a €3B Series D, the largest equity round ever raised by a European tech company, just three years after launch.
🇸🇪 I dag markerar en viktig milstolpe för Mistral: vi tillkännager en Serie D-runda på 3 miljarder euro, den största aktiefinansieringsrundan som någonsin genomförts av ett europeiskt teknikföretag, bara tre år efter vår lansering. — @MistralAI på X
OpenAI:s vetenskapliga agenter: ett bevis om Navier–Stokes, qubits kalibrerade vid MIT
8 september — OpenAI publicerar ett bevis för att en singularitet bildas inom ändlig tid i de tredimensionella Navier–Stokes-ekvationerna, tillsammans med en formalisering i bevisassistenten Lean. Det tillkännagivna resultatet är att en tredimensionell fluid som från början är jämn och i vila, och utsätts för en jämn yttre kraft, kan få en hastighet som växer utan gräns inom ändlig tid, trots att viskositeten tenderar att jämna ut rörelsen och systemets energi förblir ändlig. I Clay Mathematics Institutes officiella formulering motsvarar detta påståendena ”C” och ”D”, vilka utgör ett motbevis och inte ett bevis för regularitet.
Det är viktigt att exakt klargöra vad OpenAI gör och inte gör anspråk på. Beviset togs fram av ett system med samordnade agenter baserat på en intern modell utan offentligt namn, som företaget beskriver som betydligt mer kapabel än GPT-6 Astra och som har fortsatt tränas sedan den 28 augusti. Den enda beskrivna verifieringen är formaliseringen i Lean, som anförtroddes GPT-6 Astra och slutfördes 17 timmar efter lösningen. Tillkännagivandet nämner varken någon sakkunniggranskning eller någon validering av Clay Mathematics Institute, och OpenAI uppger att företaget inte avser att göra anspråk på millenniepriset utan presenterar sitt resultat som en ögonblicksbild snarare än en slutpunkt.
Metoden är minst lika anmärkningsvärd som resultatet. Arbetet inleddes den 1 september efter rykten om att två millennieproblem just hade lösts. Olika agentgrupper fick olika varianter av påståendet: versionerna ”A” och ”B” inriktades på att ta fram ett bevis, medan versionerna ”C” och ”D” inriktades på ett motbevis. För ett angränsande problem, regulariteten hos de opåtverkade Euler-ekvationerna, tog närmare 100 agenter fram ett motbevis på omkring femtio timmar. Resultatet matades sedan tillbaka in i prompterna för agenterna som arbetade med Navier–Stokes.
| Mätvärde | Värde |
|---|---|
| Samtidiga agenter, Navier–Stokes-gruppen | omkring 10 000 |
| Tid till lösning | omkring 88 timmar |
| Formalisering och verifiering i Lean | ytterligare 17 timmar, via GPT-6 Astra |
| Utväxlade meddelanden, Navier–Stokes | 2,7 miljoner |
| Utdatatokens, Navier–Stokes | omkring 130 miljarder |
| Utväxlade meddelanden, alla prövade problem | 4,9 miljoner |
| Utdatatokens, alla prövade problem | omkring 300 miljarder |
| Motbevis för regulariteten hos opåtverkad Euler | närmare 100 agenter, omkring 50 timmar |
Ett konkurrerande arbete komplicerar bilden. Levent Alpöge, anställd på Anthropic, och Tristan Buckmaster, matematikprofessor vid NYU, hade ett resultat om Euler-ekvationerna i deras påverkade version. OpenAI kontaktade dem den 6 september, när det egna projektet hade slutförts och verifierats, för att föreslå en gemensam publikation och erkänna deras prioritet, innan det framkom att deras resultat gällde ett annat påstående.
This model represents a step-function improvement on many benchmarks, and its training is ongoing. Our internal model group arrived at the Navier–Stokes solution in 88 hours, using around 10,000 coordinating AI agents. Throughout the effort, we maintained the strict safeguards—including monitoring and isolation—that we apply to all our frontier evaluations.
🇸🇪 Den här modellen innebär en stegvis förbättring på många benchmarks, och träningen fortsätter. Vår interna modellgrupp nådde lösningen på Navier–Stokes på 88 timmar med omkring 10 000 samordnade AI-agenter. Under hela arbetet upprätthöll vi de strikta skyddsåtgärder, däribland övervakning och isolering, som vi tillämpar vid alla våra utvärderingar av frontier-modeller. — @OpenAI på X
Samma dag publicerar OpenAI en fallstudie som är betydligt mer blygsam och betydligt lättare att verifiera. Beatriz Yankelevich, doktorand i MIT:s Engineering Quantum Systems-grupp, kopplade Codex, styrd av GPT-5.6 Sol, till programvaran som samordnar hennes experiment för att kalibrera ett okalibrerat chip med sex supraledande qubits. Agenterna fick skills som var specifika för varje typ av mätning och beskrev hur den skulle genomföras och bedömas. Vid tydliga signaler genomförde Codex en fullständig sekvens med få ingrepp: identifiering av övergångsfrekvenser, kalibrering av styr- och avläsningspulser samt mätning av hur länge kvantinformationen bevarades. Vid svaga eller brusiga signaler tar det längre tid att hitta användbara parametrar och ibland krävs bedömning av en erfaren forskare, som fortfarande är snabbare än modellen. Vinsten ligger alltså inte i hastigheten utan i att ständig övervakning inte behövs: karakteriseringen av ett sådant standardchip tar flera dagar för en forskare, och gruppen överlåter numera rutinmätningarna åt agenter.
🔗 Navier–Stokes-lösningen, OpenAI · 🔗 Codex och kvantexperiment, OpenAI
ChatGPT Images 2.5, med Sketch och två bildmodeller i API:et
8 september — OpenAI lanserar ChatGPT Images 2.5 i sina produkter och i API:et. Användningssiffran som anges inledningsvis visar omfattningen: mer än 3 miljarder bilder skapas varje vecka med ChatGPT Images och API:ets GPT-Image-modeller. Den mest konkreta förbättringen är latensen, som har minskat med upp till 50 procent jämfört med Images 2.0, medan resten gäller troheten mot referensbilder och konsekvensen under långa konversationer, där tidigare ändringar bevaras bättre.
Tre funktioner lanseras i ChatGPT. Med Sketch går det att rita direkt i konversationen för att skapa en visuell vägledning genom att skriva ”@Sketch”. Templates täcker vanliga format, exempelvis affischer och merchandising. Kommentarer kan placeras på bilden för att precisera en retuschering. När en bild delas kan nu även den prompt som skapade den inkluderas. Lanseringen omfattar alla användare av ChatGPT, ChatGPT Work och Codex på desktop, mobil och webben, oavsett abonnemangsnivå.
| Modell i API:et | Tillkännagiven positionering | Latens |
|---|---|---|
| GPT-Image-2.5 Flare | standardval, innehåll för sociala medier, volymgenerering | upp till 50 procent lägre än Images 2.0 |
| GPT-Image-2.5 Sunburst | precision, publiceringsklara kampanjer | längre genereringstider |
Båda modellerna stöder de nya kvalitetsinställningarna xhigh och max och använder samma tokenpriser som GPT Image 2: på Standard-nivån 8,00 dollar per miljon tokens för bildindata, 30,00 dollar för bildutdata och 5,00 dollar för textindata. C2PA-metadata och den osynliga vattenstämpeln finns kvar, och en system card medföljer lanseringen.
Manus integrerar modellen samma dag
Manus lägger till GPT-Image-2.5 på sin plattform under kvällen efter tillkännagivandet och hänvisar till OpenAI:s meddelande, som publicerades en och en halv timme tidigare. Agentlabbet, som åter blev självständigt den 1 september, presenterar en siffra från sina egna utvärderingar och inte från OpenAI:s: modellen som det kallar Flare skapar högkvalitativa bilder två till fyra gånger snabbare än GPT-Image-2. För en agent som genererar visuellt material under en pågående konversation är denna faktor viktigare än en marginell kvalitetsförbättring, eftersom den avgör om genereringen förblir en del av arbetsflödet eller medför väntetid. Manus lyfter också fram förbättrad generering av transparenta bakgrunder, vilket eliminerar det manuella friläggningsmoment som bryter en fullständig automatisering.
AlphaGenome Atlas, den prediktiva kartan över det mänskliga DNA:ts 9 miljarder mutationer
8 september — Google DeepMind lanserar AlphaGenome Atlas, en databas som förutsäger den molekylära effekten av varje möjlig enbokstavsmutation i mänskligt DNA. Det mänskliga genomet omfattar omkring 3 miljarder baspar, varav endast 2 procent kodar för proteiner. De återstående 98 procenten är fortfarande till stor del outforskade, trots att ett enkelt bokstavsbyte där kan inaktivera en avgörande biologisk regulator.
Metoden bygger på en omvänd arbetsfördelning. I stället för att låta varje laboratorium fråga modellen variant för variant har Google DeepMind förberäknat AlphaGenome-modellens förutsägelser för samtliga 9 miljarder möjliga substitutioner. Resultatet är ett dataset på 1 petabyte, vilket uppges vara mer än trettio gånger så stort som AlphaFold Database. För att göra denna datamängd användbar introducerar Atlas AVI-poängen (AlphaGenome Variant Impact), ett enda tal som sammanställer förutsägelser för kodande och icke-kodande regioner och anger vilka biologiska processer en variant stör, med bidrag fördelade per egenskap. Därtill kommer en katalog med över 2 500 återkommande sekvensmotiv, de reglerande enheter som Google beskriver som genomets ”ord”.
| Mått | Värde |
|---|---|
| Förberäknade varianter | 9 miljarder, alla enbokstavsförändringar |
| Datasetets storlek | 1 petabyte, över 30 gånger AlphaFold Database |
| Katalogiserade sekvensmotiv | över 2 500 |
| Analyserade deltagare från UK Biobank | över 54 000 |
| Ytterligare icke-kodande associationer | plus 22 procent |
| Identifierade genetiska regioner kopplade till BMI | 19 |
Två dokumenterade användningsfall visar omfattningen av vinsten. Vid Broad Institute använde Laura Covill och hennes team AVI-poängen för att prioritera kandidatvarianter vid sällsynta sjukdomar som förblivit odiagnostiserade: verktyget lyfte fram en variant i genen DNM1 genom att förutsäga att den skapade ett felaktigt splitsningsställe, vilket gav den avgörande ledtråden för att lösa fallet. Vid University of Exeter tillämpade Gareth Hawkes Atlas på data från över 54 000 deltagare i UK Biobank och fann 22 procent fler icke-kodande genetiska associationer. Därefter identifierade han 19 genetiska regioner kopplade till kroppsmasseindex genom att begränsa analysen till den 1 procent av varianterna som hade störst påverkan.
Åtkomsten är den andra anmärkningsvärda punkten. Atlas är tillgängligt via en webbportal som inte kräver någon kod, avsedd för kliniker och biologer som inte programmerar, men även via AlphaGenome API, i Cloud genom Model Garden, med forskningsdata publicerade på GitHub. En detalj som kan intressera utvecklare som följer Googles agentekosystem är att Atlas också distribueras som en färdighet (skill) i Google Antigravity och därmed kan användas direkt av en kodningsagent.
🔗 AlphaGenome Atlas, Google DeepMind
NVIDIA lanserar CUDA Rust, och Cosmos dominerar ECCV:s AI City Challenge
8 september — NVIDIA lanserar CUDA Rust, sitt svar på en brist som blivit alltmer synlig: AI-systemlagret skrivs i allt högre grad i Rust, men GPU-kernels har förblivit undantaget. Det gick redan att starta en kernel från Rust, men den behövde skrivas någon annanstans. CUDA Rust överbryggar denna klyfta genom att kompilera Rust-kernels direkt till PTX via två separata spår, anpassade till de två programmeringsmodeller som CUDA redan erbjuder i C++ och Python.
| Komponent | cuda-oxide, SIMT-spåret | cutile-rs, Tile-spåret |
|---|---|---|
| Mognadsgrad | tidig alpha | publicerat på crates.io |
| Rust-verktygskedja som krävs | låst nightly (nightly-2026-04-03) | stable 1.89 eller senare |
| CUDA-version | 12.x eller senare | 13.3 |
| LLVM som måste tillhandahållas | ja, plus clang och libclang | nej |
| Kompilering | till PTX vid build | JIT via CUDA Tile IR |
| Nämnda externa användningar | inga | Grout från Hugging Face, mistral.rs |
NVIDIA:s rekommendation är tydlig: börja med Tile, eftersom källkoden då inte kodar in något arkitekturspecifikt val, och gå ned till SIMT när detaljerad kontroll över trådar och minne blir nödvändig. Denna avvägning har i dag en kostnad, eftersom delat minne i SIMT, grunden för snabba kernels, fortfarande kräver unsafe. Det grundläggande argumentet är minnessäkerhet vid kompilering: båda spåren förhindrar klassisk aliasing där en buffert används både som indata och utdata, med error[E0502] på SIMT-sidan och error[E0382] på Tile-sidan. När det gäller mognadsgraden överdriver NVIDIA inte: inget av projekten är redo för produktion, och det tillkännagivna åtagandet sträcker sig till 2027 och därefter, med gemensamt arbete tillsammans med underhållarna av rust-cuda.
Samma dag publicerar NVIDIA resultatlistan för ECCV 2026:s AI City Challenge. På spår 5, som handlar om generativ videoprognostisering av trafikscener, använder fyra av de fem bästa lösningarna versioner av Cosmos världsgrundmodeller. Team Qyn vinner den offentliga rankningen med CosmosAlign, som anpassar den frysta modellen Cosmos3-Nano med 16 miljarder parametrar genom ett LoRA-recept i två steg, genererar fyra prognoser, väljer medoiden och återinför stabila regioner från den observerade historiken: 76,39 mot 76,04 för team SSUPER, en ledning på 0,35 poäng. NVIDIA är noga med att klargöra att detta är ett recept för anpassning och inferens, inte en ny arkitektur. Cosmos förekommer också som domare: i de två rankningarna för data utanför domänen på spår 3 vinner team UWIPL_ETRI med UniTraffic, som låter en oberoende Cosmos-Reason1-verifierare kontrollera omtvistade påståenden.
🔗 CUDA Rust, NVIDIA · 🔗 Resultat från AI City Challenge
Cognition tar in över 2 miljarder dollar och når en värdering på 48 miljarder
8 september — Cognition, företaget bakom utvecklingsagenten Devin, tillkännager en kapitalanskaffning på över 2 miljarder dollar till en värdering av 48 miljarder. Rundan leds av två nya investerare, Andreessen Horowitz och Accel, tillsammans med de befintliga investerarna Founders Fund, General Catalyst och Avenir. Ett trettiotal andra deltagare kompletterar investerarlistan, däribland NVIDIA, Benchmark, Bessemer, Kleiner Perkins, Greylock, Lightspeed, T. Rowe Price och Bain Capital Ventures.
| Indikator | Maj 2026 | September 2026 |
|---|---|---|
| Anskaffat belopp, totalt i rundan | över 1 miljard dollar | över 2 miljarder |
| Värdering | 26 miljarder dollar | 48 miljarder |
| Årsberäknad omsättning | 492 miljoner dollar | närmare 900 miljoner |
| Huvudinvesterare | Lux Capital, General Catalyst, 8VC | Andreessen Horowitz, Accel |
Värderingen har därmed nästan fördubblats på fyra månader och nästan femdubblats på ett år, samtidigt som den årsberäknade omsättningen följer samma utveckling. Cognition redogör för de användningsområden som driver tillväxten: Devin arbetar med chipdesign hos NVIDIA, flygteknik hos GE Aerospace, finansiella tjänster hos Citi, fordon hos Mercedes-Benz och AI-infrastruktur hos Modal. Att NVIDIA både är kund och investerare i rundan illustrerar hur dessa företag säkrar tillgången till verktyg som de använder internt. Tre nya funktioner förflyttar Devin från uppgiftsutförande till självständigt agerande: Auto-Triage för den första fasen av incidentutredningar, Security Swarm för prioritering av sårbarheter och Automations som utlöses av händelser i Slack, GitHub eller Linear. Sex kontor har öppnats på ett år, varav fem utanför USA, utöver hubbarna i San Francisco, New York och Austin.
In the next chapter of software engineering, agents will become proactive by default, software will improve itself, and compute will automatically get allocated toward the highest impact use cases. We’re still at the dawn of the self-driving software era.
🇸🇪 I nästa kapitel av mjukvaruutvecklingen kommer agenter att vara proaktiva som standard, mjukvara kommer att förbättra sig själv och beräkningskraft kommer automatiskt att fördelas till användningsområden med störst effekt. Vi befinner oss fortfarande i början av den autonoma mjukvarans era. — @cognition på X
Suno tecknar avtal med Believe och TuneCore, som tidigare vägrade distribuera företagets musik
8 september — Suno tillkännager ett globalt strategiskt partnerskap med artistutvecklingsföretaget Believe och dess plattform för självdistribution, TuneCore. Avtalet omfattar två skilda delar. För det första deltar Believe i utformningen av de nya musikmodeller som Suno utvecklar tillsammans med branschen. För det andra, och detta är den konkreta punkten för användarna, kommer låtar som skapats med den nya partnermodellen att kunna distribueras via Believe och TuneCore, och därmed till Spotify, Apple Music, Amazon Music och YouTube.
Bakgrunden visar tillkännagivandets betydelse. Suno påminner öppet om att Believe och TuneCore tidigare i år meddelade att de inte skulle distribuera musik som producerats med modeller som inte uppfyllde deras kriterier, inklusive Sunos dåvarande modeller. Helomvändningen framställs som resultatet av diskussioner som synliggjort gemensamma värderingar: att ge artister verkliga valmöjligheter och öppna vägar till distribution och intäkter.
Avtalet ingår i en sammanhängande utveckling. Det bygger vidare på Spark, Sunos program för oberoende och nya artister, och kompletterar de befintliga avtalen med Warner Music Group och BMG genom att även omfatta oberoende skivbolag och självproducerande artister. Suno kopplar det också uttryckligen till sina senaste skyddsåtgärder: ljudvattenmärkning och akustiska fingeravtryck avsedda att identifiera företagets låtar utanför plattformen, samt de nedladdningsbegränsningar som trädde i kraft den 3 september för att förhindra massdistribution till streamingtjänster. Dessa skydd kommer att tillämpas på musik som distribueras av Believe och TuneCore. Tillkännagivandet avslutas med en tidsplan: Suno uppger att de nya modellerna lanseras mycket snart, och modellfamiljen fick namnet v6 den 4 september.
🔗 Partnerskapet med Believe, Suno
Cohere öppnar en inferensservermotor (serving) byggd kring en megakernel, 1,58x snabbare än vLLM
8 september — Cohere lanserar en inferensservermotor som helt är uppbyggd kring en megakernel för avkodning, under Apache 2.0-licensen. Företaget hävdar att det är först med detta: inte en hastighetsdemonstration i laboratoriemiljö, utan en komplett server som kan hantera verkliga förfrågningar bakom en OpenAI-kompatibel endpoint, med kontinuerlig batchbearbetning, paginerad attention, prefixcache och verktygsanrop. Modellen som körs är North Mini Code, en mixture-of-experts-modell med 30 miljarder parametrar, varav endast 3,3 miljarder är aktiva per token.
Problemet som angrips kan sammanfattas i en mening: under avkodningen tillbringar GPU:n mycket tid med att vänta i stället för att beräkna. En klassisk stack startar en kernel per operation, och varje kernelgräns skapar en barriär över hela beräkningsgridden. Autoregressiv avkodning begränsas dock av minnesbandbredden: vid varje steg överför North Mini Code 6,6 GB vikter från HBM-minnet, plus cirka 0,5 GB key-value-cache vid en kontext på 8K, vilket placerar det teoretiska taket kring 470 tokens per sekund med de 3,35 TB/s som en H100 erbjuder. En megakernel tar bort dessa gränser genom att starta en enda persistent kernel som förblir resident under hela avkodningssteget, med beroenden reducerade till räknare i det globala minnet.
| Mätning | Megakernel | vLLM v0.24 | Vinst |
|---|---|---|---|
| Avkodning, batchstorlek 1, kontext 8K (tok/s) | 292 | 185 | 1,58x |
| AIME 2025, från början till slut (tok/s) | 935 | 661 | 1,41x |
| SciCode, från början till slut (tok/s) | 711 | 560 | 1,37x |
| MMLU-Pro, delmängd för datavetenskap (tok/s) | 948 | 713 | 1,33x |
| LiveCodeBench v6, från början till slut (tok/s) | 803 | 625 | 1,28x |
| GPQA, från början till slut (tok/s) | 787 | 631 | 1,25x |
De 292 tokens per sekund som uppnås med batchstorlek 1 motsvarar 62 procent av det teoretiska taket, jämfört med 39 procent för vLLM. Kvaliteten förändras inte: 38,9 procent jämfört med 38,2 på SciCode och 70,3 procent för båda på LiveCodeBench v6, som genomsnitt över sju körningar. En detalj förtjänar uppmärksamhet: försprånget beror på experternas fördelning, med 1,32x under modellens verkliga routing jämfört med 1,14x under simulerad enhetlig routing, vilket gör enhetliga mätningar till det ogynnsamma fallet. Cohere betonar slutligen en kontraintuitiv punkt: att skriva en megakernel skulle vara enklare än dess rykte antyder, med en enda CUDA-fil där sexton operationskoder täcker hela avkodningssteget. Begränsningarna är uttalade och beskrivs som implementeringsbegränsningar: endast avkodning, medan prefill fortfarande körs med vanliga PyTorch-kernels, endast H100 och BF16 samt batchstorlekar från 1 till 8.
Anthropic dokumenterar hur kostnaden för Claude Platform kan sänkas utan prestandaförlust
8 september — Anthropic publicerar en ingenjörsguide som går emot den vedertagna uppfattningen att en lägre kostnad för en agent innebär att man måste acceptera sämre resultat. Tre åtgärder dokumenteras: maximera träfffrekvensen för promptcachen, ta bort anti-patterns i promptar vid övergången till en frontier-modell och anpassa ansträngningsnivån efter uppgiften. Metoden levereras som körbara kommandon i Claude Code, där /claude-api prompt-audit och /claude-api hillclimb ansluter till /claude-api cost-optimize.
| Benchmark, baslinje Sonnet 5 | Kostnadsminskning | Uppmätt detalj |
|---|---|---|
| LegalBench | cirka 58 procent | reasoning-tokens från 102 779 till 8 284 |
| tau2-bench retail | cirka 73 procent | promptcache med uttryckliga brytpunkter |
| OfficeQA Pro | cirka 52 procent | från 136,20 till 64,87 dollar |
| SWE-bench Verified | cirka 55 procent | mediansteg från 29 till 17, prompt-tokens mer än halverade |
Den mest användbara siffran finns inte i tabellen. På CursorBench 3.2 når Claude Fable 5.1 med effort low samma resultat som Fable 5 med effort high till en tredjedel av kostnaden, vilket delvis beror på priset för cacheläsningar, som nu kostar 0,25 dollar per miljon tokens jämfört med tidigare 1,00 dollar. På Humanity’s Last Exam utan verktyg ger däremot den högsta ansträngningsnivån ungefär en halv poäng för 46 procent högre kostnad, en förbättring som drunknar i benchmarkets brus.
🔗 Minska kostnaderna på Claude Platform
Claude Code 2.1.265: pluginmappar, gräns på 1 GB och reparation av promptcachen
8 september — Claude Code uppdateras till 2.1.265 med femtio poster i ändringsloggen, varav trettiofyra är korrigeringar, två dagar efter version 2.1.263 som bara innehöll en. Alternativet --plugin-dir accepterar nu en hel mapp med plugins, där varje undermapp som har ett manifest läses in och tillägg eller borttagningar som görs under körningen upptäcks. En gräns på 1 GB gäller för verktygsresultat som skrivs till disk, och förhandsvisningen anger om en fil har trunkerats.
Den mest omfattande delen gäller promptcachen, i linje med guiden som publicerades samma dag. Två separata korrigeringar löser fall där Claude Code självt bröt återanvändningen av cachen: när en subagent som startats i förgrunden återupptogs ändrades dess verktygslista och systempromptprefix, medan återupptagna agentmedarbetare och subagenter flyttade kontexten för hooks SubagentStart och förinlästa skills utanför prefixet. Två korrigeringar gäller säkerheten: en pluginsökväg som innehöll ett omvänt snedstreck kringgick kontrollen som begränsar symboliska länkar på macOS och Linux, och på Windows nekade läs- och skrivverktygen åtkomst till alla filer i en AppContainer eller en sandlåda med begränsad token. Läsning av en artifact som skrivits av en tredje part behandlas nu som opålitligt innehåll.
🔗 Versionsinformation för 2.1.265
Amp ersätter meddelandekön med styrning i realtid
8 september — Amp ändrar agentens standardbeteende för meddelanden som skickas medan den arbetar. Tidigare placerades ett meddelande som skrevs medan agenten kördes i en kö och behandlades först när omgången var klar; nu levereras det vid första möjliga tillfälle. Utvecklaren lyfter fram två fördelar: agenten tar hänsyn till återkopplingen tidigare och slutar påbörja verifieringssteg som den nya instruktionen gör överflödiga, vilket sparar tid och tokens i det vanliga fallet där man ser agenten gå åt fel håll.
Förändringen är inte utan bieffekter, och Amp dokumenterar dem. Om styrningen visar sig vara för abrupt rekommenderar utvecklaren att formulera önskemål som ”When done, then…” i stället för ”Now, …”, för att uttryckligen ange att instruktionen ska tillämpas efter den pågående uppgiften. Ship, Review och övriga inbyggda åtgärder behåller det tidigare beteendet och fortsätter att köas, eftersom man i regel vill att arbetet ska vara klart innan det levereras eller granskas. Manuell köläggning är fortfarande tillgänglig, både i applikationen och i CLI.
Muse Spark 1.3 kommer till Cursor med CursorBenchs bästa förhållande mellan resultat och kostnad
8 september — Cursor lägger till Muse Spark 1.3, agentmodellen från Meta Superintelligence Labs, sex dagar efter att den presenterades. De publicerade siffrorna berättar inte en historia om rå prestanda, utan om kostnad. På CursorBench 3.2, det egenutvecklade benchmark som bygger på verkliga uppgifter över flera filer, uppnår Max-nivån 67,9 procent till en kostnad på 1,31 dollar per uppgift och placerar sig på tolfte plats.
| Modell och nivå | Resultat i CursorBench 3.2 | Kostnad per uppgift, dollar | Tokens per uppgift | Placering |
|---|---|---|---|---|
| Fable 5.1 Max | 73,4 procent | 9,64 | 72 060 | 1 |
| Grok 4.6 Extra High | 70,8 procent | 2,81 | 41 136 | 3 |
| Opus 5 Max | 70,0 procent | 8,23 | 61 838 | 5 |
| Gemini 3.8 Flash High | 69,2 procent | 2,38 | 81 524 | 9 |
| Muse Spark 1.3 Max | 67,9 procent | 1,31 | 33 034 | 12 |
| GPT-5.6 Sol Max | 67,2 procent | 5,69 | 28 320 | 13 |
| Muse Spark 1.3 Low | 55,0 procent | 0,45 | 12 181 | 49 |
Metas modell hamnar alltså långt efter Claude Fable 5.1 Max sett till resultat, men den senare kostar mer än sju gånger så mycket per uppgift. Framför allt slår den GPT-5.6 Sol på Max-nivån samtidigt som den kostar mer än fyra gånger mindre. Cursor håller fast vid sin metod att systematiskt publicera både resultat och kostnad per uppgift för varje modell som läggs till, i stället för att bara meddela att modellen är tillgänglig.
Grok Bot fyller i formulär och inloggningsuppgifter från chatten, Grok Imagine får kontroll med nyckelbilder
8 september — SpaceXAI gör det nu möjligt att fylla i formulär och inloggningssidor för Grok Bot utan att lämna konversationen, med utlovat stöd för valfri lösenordshanterare. Funktionen hanterar en friktionspunkt som är specifik för persistenta agenter: så snart agenten måste ta sig förbi en inloggningsskärm eller skicka in ett formulär med personuppgifter behöver den antingen lagrade inloggningsuppgifter eller användarens ingripande. Att flytta detta steg till konversationstråden i stället för en separat webbläsarsession är både ett användbarhets- och säkerhetsval.
Två timmar senare får Grok Imagine kontroll över start- och slutbilderna i en videoscen samt generering av sömlösa loopar, med bättre följsamhet till instruktioner och utlovat högre videokvalitet. Kontrollen med nyckelbilder förändrar verktygets karaktär för den som producerar på varandra följande tagningar: genom att låsa den sista bilden i en tagning kan den återanvändas som den första bilden i nästa, så att sekvenser kan länkas samman utan att kontinuiteten längre beror på slumpen i genereringen. Tillkännagivandet kommer tre dagar efter lanseringen av agenten Grok Imagine Video 1.5, som drivs av modellen Image 2.0.
🔗 Formulärifyllning i Grok Bot · 🔗 Nyckelbilder i Grok Imagine
Tre forskningsinlägg på Hugging Face-bloggen
8 september — Tre publikationer från Hugging Face-communityn förtjänar att läsas samma dag, om väder, modellsäkerhet och biologiskt inspirerade modeller.
Köra en öppen vädermodell utan GPU
Hugging Face och Earthmover publicerar ett gemensamt inlägg om ett problem som sällan behandlas: maskininlärningsbaserade vädermodeller är tillräckligt lätta för att köras på en bärbar dator, men ändå är det nästan ingen som kör dem. Tre hinder identifieras: beräkning (flera modeller, däribland AIFS, är beroende av flash attention, som är begränsad till vissa grafikkortsarkitekturer), lagring och framför allt bandbredd, med cirka 1 GB initialvillkor per prognos. Lösningen består av tre offentliga artefakter: en demonstrationsmiljö, en lagringsbucket och en reproducerbar handledning som kör Aurora, Microsofts modell, i den förtränade versionen med 0,25 graders upplösning och med initialvillkor från ERA5 som tillhandahålls via Earthmovers datamarknad. Ingen GPU krävs: två till tre minuter per beräkningssteg på processor, några sekunder på grafikkort och fyra steg på sex timmar vardera för en 24-timmarsprognos som därefter jämförs med ERA5.
🔗 Öppna vädermodeller med Earthmover
En modell som anses säkrare men vägrar besvara tre fjärdedelar av ofarliga frågor
Multiverse Computing publicerar ett resultat som borde få spridning långt utanför forskningen om alignment. Genom att träna Qwen3-8B att avvisa förfrågningar om politisk manipulation får teamet siffror som ser ut som en tydlig seger: den genomsnittliga andelen skadliga svar på HarmBench, StrongREJECT och WildJailbreak sjunker från 26,26 till 0,14 procent. Vid samma checkpoint stiger övervägran på XSTest från 2,00 till 74,00 procent. Med andra ord är konfigurationen som ser säkrast ut på papperet en maskin som vägrar svara, och inget i de vanliga mätningarna avslöjar det. Två korrigeringar löser problemet: när externa tillmötesgående svar ersätts med verifierade svar från målmodellen sjunker övervägran på XSTest från 15,20 till 5,20 procent, och när godartade gränsfall läggs till sjunker övervägran på sidan som ska tillmötesgås från 32,94 till 4,16 procent, medan vägransgraden på den skadliga sidan bara tappar fyra punkter.
🔗 Säkerhet för vem, Multiverse Computing
En flugas connectome slår inte sin egen slumpmässigt omkopplade struktur
Oruk publicerar en metodologisk lärdom som sträcker sig bortom modeller inspirerade av connectomes. Teamet kopierade 499 starkt sammankopplade neuroner från den offentliga MaleCNS-rekonstruktionen av en fluga till ett rekurrent nätverk som fungerade som reservoir, med en enda ridge-readout tränad ovanpå. Flugans ledningsstruktur uppnår en genomsnittlig testnoggrannhet på 16,84 procent, medan en slumpmässigt omkopplad struktur når 16,88 procent: skillnaden är minus 0,04 procentenheter, med ett konfidensintervall som korsar noll. Det andra experimentet hade kunnat uppfattas som bevis för motsatsen, eftersom noggrannheten sjunker från 16,91 till 10,83 procent när de 50 neuronerna med störst normer för readout-vikter tas bort. Författarna förklarar varför det inte finns någon motsägelse: en dramatisk ablation visar aldrig att en biologisk topologi var nödvändig. Det bör också nämnas att inlägget självt uppger att det har förberetts av en AI-agent utifrån en artikel som inte har sakkunniggranskats, och att hela utvärderingsdatasetet förblir privat.
🔗 Connectome och slumpmässigt omkopplad struktur, Oruk
Runway rekryterar teamet från det Parisbaserade laboratoriet Kinetix
8 september — Runway meddelar att teamet från Kinetix, ett AI-forskningslaboratorium baserat i Paris, ansluter sig till företaget. Laboratoriet arbetade med mänsklig rörelse i 3D och fysikförankrad videogenerering, två områden som Runway direkt kopplar till sin forskning om världsmodeller för robotik. Teamet ansluter sig till företagets verksamhet i Paris, där Runway även rekryterar lokalt inom forskning och teknik.
Det tekniska argumentet sammanfattas i en mening från tillkännagivandet: en verkligt användbar robot måste förstå och hantera nya miljöer, uppgifter och situationer, och storskalig förträning på video erbjuder enligt Runway den effektivaste vägen för att lösa dessa generaliseringsproblem. Det är en direkt fortsättning på Solaris, som presenterades den 31 augusti, och GWM Worlds 2, som presenterades den 3 september: efter att ha lärt modeller att simulera världen vill Runway lära dem att agera i den. Yassine Tahi, vd för Kinetix, daterar laboratoriets ursprungliga satsning till sex år tillbaka. Ingen köpeskilling eller transaktionsstruktur anges.
🔗 Kinetix ansluter sig till Runway
Sarah Friar sätter siffror på OpenAI:s skala och modellernas effekt på kostnaderna
8 september — Sarah Friar publicerar en debattartikel om hur OpenAI omvandlar sina forskningsframsteg till ekonomisk verksamhet. Textens värde ligger snarare i tre tidigare opublicerade siffror än i dess argumentation.
| Indikator | Värde |
|---|---|
| Aktiva användare per vecka | över en miljard |
| Företagskunder | 2,5 miljoner |
| Dagliga meddelanden efter sex månader, individuella abonnemang | cirka 50 procent fler än under den första månaden |
| Olika uppgifter som provats efter sex månader | ungefär dubbelt så många |
| Heltäckande driftkostnader efter optimering | 20 procent lägre |
| Effektivitet vid token-generering | över 15 procent högre |
Den tredje siffran sluter en intressant cirkel. GPT-5.6 Sol har använts för att förbättra OpenAI:s produktionsprogramvara för drift, vilket har gett 20 procent lägre driftkostnader och dessutom över 15 procent högre effektivitet vid token-generering. Med andra ord finansierar modellen en del av sin egen infrastruktur genom att optimera lagret som kör den. Utvecklingen för individuell användning besvarar dessutom en fråga som ofta ställs men sällan dokumenteras: frågan om användarretention.
🔗 Arbete nu inom räckhåll, OpenAI
OpenAI satsar 5 miljoner dollar på oberoende forskning om ungdomar
8 september — OpenAI lanserar ett stipendieprogram på 5 miljoner dollar för oberoende forskning om effekterna av generativ AI på 13–17-åringar, med särskilt fokus på social och emotionell utveckling. Enskilda stipendier uppgår till högst 1 miljon dollar per projekt. Ansökan stänger den 6 oktober 2026, de utvalda projekten meddelas senast den 13 november 2026, en lägesrapport väntas under första kvartalet 2027 och de indirekta kostnaderna begränsas till 10 procent per stipendium.
Två detaljer är värda att notera. Den första gäller det uttalade oberoendet: bland bedömningskriterierna finns projektets förmåga att ge tillförlitliga resultat oavsett om de är gynnsamma för leverantörer av AI-produkter eller inte, och publicering uppmuntras utan att vara ett villkor för finansieringen. Den andra är administrativ men betydelsefull, eftersom stipendierna finansieras och förvaltas av OpenAI Group PBC, den kommersiella enheten, och inte av OpenAI Foundation. Tidpunkten är inte neutral: den 31 augusti gav OpenAI sitt stöd till Kaliforniens lagförslag om minderårigas säkerhet i förhållande till AI, och i inlägget anges att avsikten är att ge underlag för tillsynsmyndigheternas beslut.
🔗 Forskningsstipendier om ungdomar
Kortfattat
- Boris Cherny bedömer offentligt andra laboratorier när det gäller risken för prompt injection — skaparen av Claude Code placerar OpenAI:s nya modell på samma nivå som Gemini Flash och Opus 4.8 när det gäller prompt injection och står för beslutet att offentligt namnge laboratorierna tills de tar säkerheten på större allvar. Ett tjugotal minuter senare nyanserar han tonen i ett svar på sin egen tråd. 🔗 Inlägg
- Anthropic publicerar en video med grundare som bygger på Claude Managed Agents — intervjuer med grundarna av Wispr Flow, Actively och Pendo om hur outcomes, sandbox-miljön och minnet används för att skala upp. 🔗 Inlägg
- RelayShield skannar instruktionsfiler i stället för kod i kodförråd — en betaltjänst som läser AGENTS.md, CLAUDE.md, .cursorrules och mcp.json för att upptäcka fientliga instruktioner på naturligt språk som statisk analys inte ser. En uppgift i inlägget om antalet skadliga kodförråd stämmer inte överens med dess egen källa. 🔗 Blogginlägg
- Ai2 meddelar att organisationen deltar på ECCV 2026 — artiklar och framträdanden under konferensen, utan att några titlar eller något program har presenterats. 🔗 Inlägg
- Prismberry publicerar en essä om verktygslagret för företagsagenter — en positionerande text som skiljer mellan informations-, analys- och åtgärdsverktyg, utan tillkännagivande eller mätvärden, och som marknadsför utgivarens produkt Agent IQ. 🔗 Blogginlägg
- En journal över maskinvaruunderhåll publiceras på Hugging Faces blogg — diagnostisering av lagerslitage i fläkten på ett nätaggregat på 650 W, utan innehåll som rör artificiell intelligens. 🔗 Blogginlägg
- Missouri ger 1,1 miljoner elever och studenter tillgång till Gemini for Education — ett partnerskap på delstatsnivå som ger närmare 100 000 lärare och över 1,1 miljoner elever och studenter kostnadsfri tillgång till Gemini for Education, Gemini Notebook och Googles certifieringar, med data undantagna från träning och där varje lärosäte själv får välja om tjänsterna ska införas. 🔗 Tillkännagivande
- Dependabot läser privata GitHub-register utan personlig token — Dependabots
GITHUB_TOKENkan begära behörighetenpackages: readoch hämta från privata GitHub Packages-register. Funktionen, som lanserades och sedan drogs tillbaka i juni, återkommer med automatiska autentiseringsuppgifter reducerade till en reservlösning. 🔗 Ändringslogg - GitHubs supportportal flyttar till help.github.com — support, dokumentation, utbildning, community och kontoresurser samlas på samma plats, med en Copilot-driven sökfunktion som inte kräver inloggning. 🔗 Ändringslogg
- Genspark öppnar Spark House under SF Tech Week med tidig tillgång till GenTeam — ett communityinitiativ som ger deltagarna tidig tillgång till GenTeam och privata samtal mellan grundare och investerare. 🔗 Inlägg
- Ethan Tandowsky blir finansdirektör på ElevenLabs — den andra utnämningen till företagsledningen på sex dagar hos ElevenLabs, efter att Ashley Kramer utsågs till intäktsdirektör den 2 september. 🔗 Inlägg
- MiniMax samlar japanska röster från underhållningsbranschen och fyra aktörer inom generativ AI i Tokyo — evenemang den 11 september i Shibuya med producenten Yasushi Akimoto, KADOKAWA, KAGAMIAI, Higgsfield, Krea, Runway och HeyGen, utan lansering eller siffror. 🔗 Inlägg
- Två sändningar från Nemotron Labs samma dag, om OpenShell och Domyn — 49 minuter och 44 sekunder om hur autonoma agenter säkras med OpenShell, 54 minuter och 20 sekunder om Domyns användning av Nemotron, utan beskrivande text eller transkription. 🔗 Inlägg
- HeyGen ställer två avatarer med samma ansikte mot varandra utan att namnge något verktyg eller någon modell — en marknadsföringsjämförelse utan namngivet konkurrerande verktyg, angiven modell eller mätvärden. 🔗 Inlägg
- OpenAI utvidgar sitt journalistikprogram till journalistskolor — över 400 ChatGPT Edu-abonnemang för masterstudenter och lärare vid CUNY:s Newmark J-School och Northwesterns Medill School under 2026–2027. 🔗 Tillkännagivande
- Perplexity publicerar en guide om avkastningen på AI-integrationer — ett pedagogiskt blogginlägg utan produktnyheter, där samtliga siffror kommer från tredje part eller kundberättelser. 🔗 Blogginlägg
Vad det innebär
Den personliga agenten blir en infrastrukturprodukt, och dess säkerhet blir en självständig produkt. Meta nöjer sig inte med att lansera Muse: samma dag publicerar företaget den hittills mest detaljerade beskrivningen av hur en agent som har tillgång till ett shell, en webbläsare och en inkorg kan hållas under kontroll. Det mest lärorika valet är användningen av ersättningstoken, som gör prompt injection irrelevant för stöld av autentiseringsuppgifter, inte för att modellen är mer motståndskraftig utan för att den aldrig har fått tillgång till hemligheten. Tainted egress följer samma logik: man litar inte på modellen, utan instrumenterar kärnan. Bug bounty-programmet på 300 000 dollar och den uppriktiga slutsatsen, som medger att Muse kommer att göra misstag, säger samma sak som Boris Cherny när han offentligt bedömer andra laboratorier utifrån denna risk. Agentsäkerhet är inte längre en ruta att kryssa i, utan en teknisk angreppsyta som man offentliggör och betalar andra för att försöka knäcka.
Dagen ger också en lektion i AI-ekonomi, där beräkningsenheten inte längre är poängen utan kostnaden per uppgift. Mistral tar in 3 miljarder euro till en värdering på över 21 miljarder, Cognition över 2 miljarder till en värdering på 48 miljarder, i båda fallen med industriföretag och kunder runt bordet i stället för enbart teknikfonder. Samtidigt publicerar Cursor en tabell där Muse Spark 1.3 får 67,9 procent till en kostnad på 1,31 dollar per uppgift, medan topplaceringen kostar 9,64 dollar för sex procentenheter mer. Anthropic dokumenterar kostnadsminskningar på 52–73 procent utan försämrad prestanda och visar att en starkare modell med lägre ansträngningsnivå ofta slår en svagare modell som pressas maximalt. Sarah Friar sätter siffror på den andra änden av kedjan: driftkostnaderna har minskat med 20 procent genom att GPT-5.6 Sol fått optimera lagret som kör modellen. Det är fyra sätt att säga att avvägningen har förskjutits från kapaciteten till priset för denna kapacitet.
På det vetenskapliga området är frågan inte längre om agenter ger resultat, utan hur resultaten verifieras. OpenAI tillkännager ett singularitetsbevis för Navier–Stokes som framställts av omkring 10 000 agenter under 88 timmar och formaliserats i Lean, utan någon omnämnd sakkunniggranskning eller institutionell validering och med en intern modell som ingen utanför företaget kan ställa frågor till. Företagets försiktighet, genom att avstå från millenniepriset och tala om en ögonblicksbild, är i sig information. Dagens två andra arbeten tydliggör kontrasten: vid MIT klarar Codex väldefinierade protokoll men stöter på problem med tvetydiga signaler, och en erfaren forskare är fortfarande snabbare. Hos Google DeepMind gör AlphaGenome Atlas inte anspråk på att bevisa något, utan förberäknar 9 miljarder förutsägelser och flyttar arbetet till experimentell validering. Oruks blogginlägg sluter cirkeln genom att visa att en spektakulär ablation inte bevisar någonting utan en matchad jämförelse, och Multiverse Computings inlägg påminner om att ett säkerhetsmått inte betyder någonting förrän den ofarliga sidan mäts med samma noggrannhet.
Kvar finns det underliggande lagret, där vinsterna inte längre kommer från vikterna. Cohere öppnar en komplett driftmotor där den enda förändringen är att gränserna mellan kernels tas bort, vilket ger 1,58x genomströmningen hos vLLM med samma kvalitet, och framhåller att svårigheten med att skriva en megakernel är överskattad. NVIDIA öppnar två vägar för att skriva GPU-kernels i Rust, varav den ena redan används externt i Hugging Faces inferensmotor Grout och i mistral.rs, och medger att ingenting är produktionsklart. I AI City Challenge bygger fyra av de fem bästa videolösningarna på Cosmos-modeller som anpassats med LoRA, och det vinnande laget betonar att det handlar om en anpassningsmetod och inte om en ny arkitektur. Earthmovers väderhandledning berättar samma historia från motsatt håll: modellen Aurora kan köras på en processor, och flaskhalsen var inte beräkningen utan den gigabyte med initialvillkor som måste hämtas. Varje gång ligger värdet i tekniken runt modellen, och den offentliggörs.
Källor
- Lanseringen av Muse, Meta
- Agentsäkerhet och trygghet med Muse, Meta
- Mistrals serie D
- Tillkännagivandet av serie D på X
- Lösning av Navier–Stokes-problemet, OpenAI
- OpenAI:s tråd om den interna modellen
- Codex och experiment inom kvantberäkning vid MIT
- ChatGPT Images 2.5, OpenAI
- Manus integrerar GPT-Image-2.5
- AlphaGenome Atlas, Google DeepMind
- CUDA Rust, NVIDIA
- ECCV 2026 AI City Challenge, NVIDIA
- Cognitions serie E
- Cognitions tråd på X
- Partnerskapet mellan Suno, Believe och TuneCore
- Megakernel för avkodning, Cohere
- Minskade kostnader på Claude Platform, Anthropic
- Claude Code 2.1.265
- Direktstyrning av agenten, Amp
- Muse Spark 1.3 i Cursor
- Formulärifyllning i Grok Bot
- Nyckelbilder och loopar i Grok Imagine
- Öppna vädermodeller med Earthmover, Hugging Face
- Säkerhet för vem, Multiverse Computing
- Flugans konnektom och blandade kopplingar, Oruk
- Kinetix ansluter sig till Runway
- Sarah Friars debattartikel, OpenAI
- Forskningsstipendier om ungdomar, OpenAI
- Boris Cherny om risken för prompt injection
- Grundare som bygger på Claude Managed Agents
- RelayShield och instruktionsfiler
- Ai2 på ECCV 2026
- Agenternas verktygslager, Prismberry
- Journal över maskinvaruunderhåll
- Gemini for Education i Missouri
- Dependabot och privata GitHub-register
- Ny supportportal för GitHub
- Spark House under SF Tech Week, Genspark
- Ethan Tandowsky, finansdirektör på ElevenLabs
- MiniMax-evenemang i Tokyo
- Sändningar från Nemotron Labs
- HeyGens avatarjämförelse
- OpenAI:s journalistikprogram
- Guide om avkastningen på AI, Perplexity