ai-powered-markdown-translatorgpt-5.6-sol을 사용하여 프랑스어에서 한국어로 번역된 기사.
Meta가 사용자마다 클라우드에 전용 Linux 머신을 제공하는 개인 에이전트 Muse를 출시하고, 같은 날 이를 둘러싼 보안 아키텍처와 누구나 참여할 수 있는 최대 30만 달러 규모의 버그 바운티 프로그램을 공개했다. Mistral은 유럽 기술 기업이 성사시킨 지분 투자 중 사상 최대 규모인 30억 유로의 시리즈 D를 발표했다. 한편 OpenAI는 에이전트 시스템이 도출한 Navier-Stokes 방정식의 유한 시간 특이점 증명을 발표했으며, Google DeepMind는 인간 DNA에서 발생할 수 있는 90억 개 돌연변이의 영향을 사전 계산했다.
Meta, 개인 에이전트 Muse 출시 및 보안 아키텍처 공개
9월 8일 — Meta가 Muse Spark 1.3으로 구동되는 개인 에이전트 Muse를 출시했다. iOS 및 Android 앱과 웹 인터페이스, WhatsApp에서 이용할 수 있다. 모델 자체는 새롭지 않다. 9월 2일 Muse Code와 Meta Model API에 도입됐고, 최대 추론 단계는 9월 4일 공개됐다. 새로운 것은 이 모델을 중심으로 구축된 소비자용 제품이다.
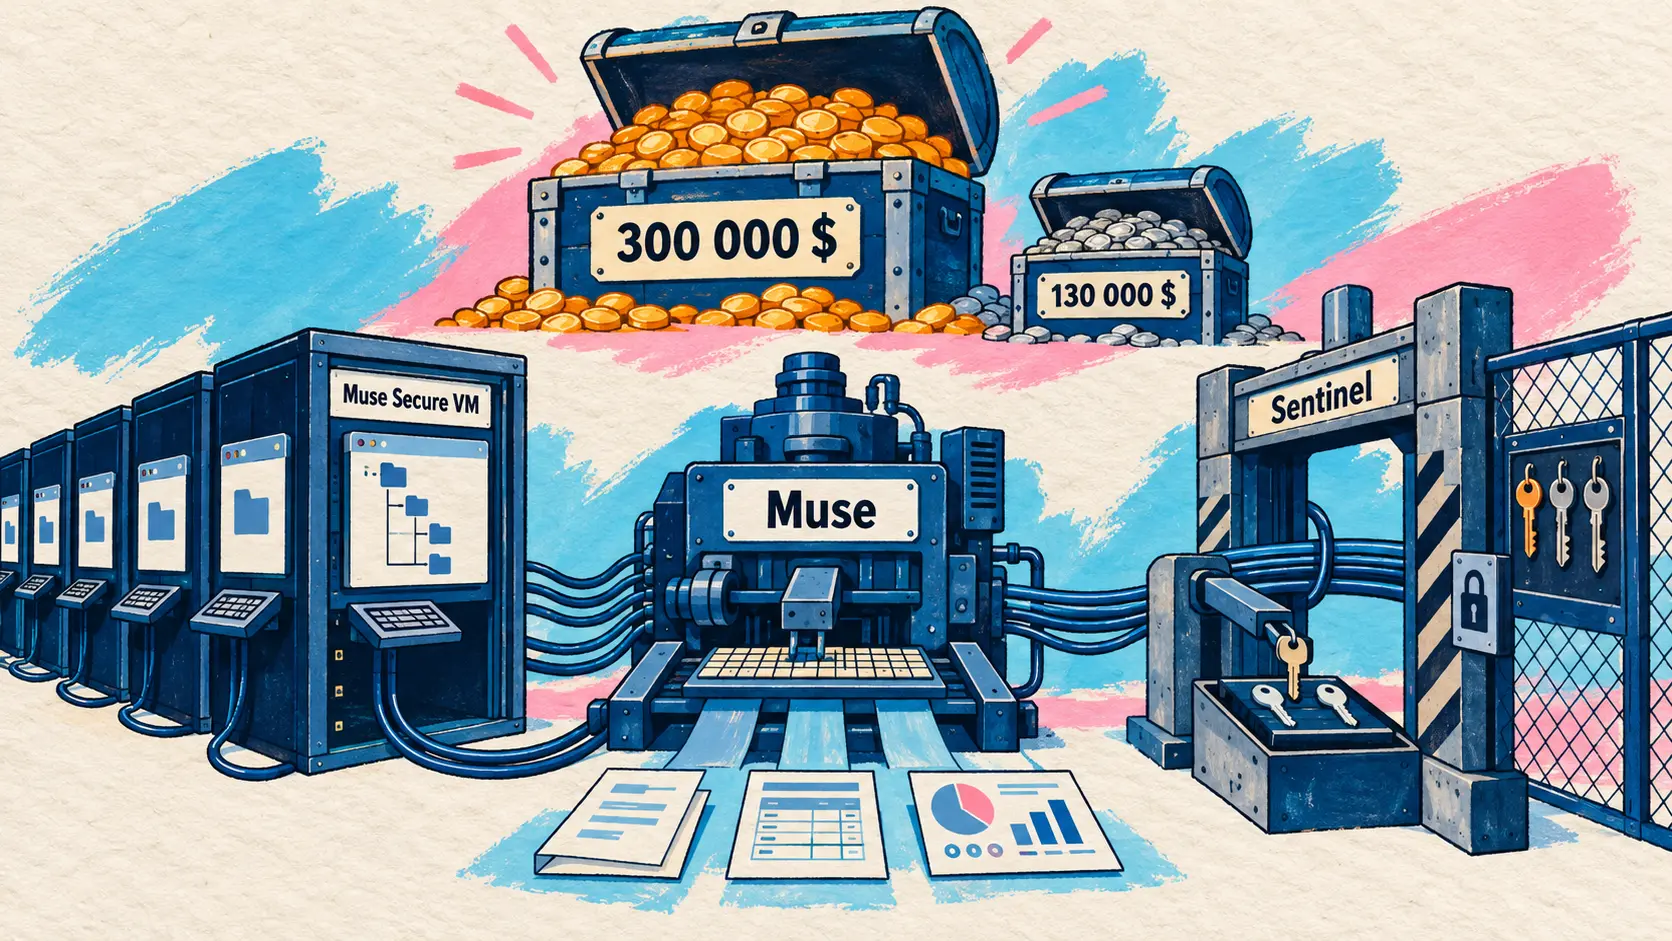
아키텍처는 설명하기는 간단하지만 구현하기는 어려운 아이디어에 기반한다. 모든 사용자에게 클라우드의 전용 컴퓨터를 제공하는 것이다. Muse Secure VM은 지속적이고 격리된 Linux 머신으로, 파일 시스템과 터미널, 완전한 브라우저를 갖추고 있으며 코드를 컴파일하고 맞춤형 skills를 개발하고 여러 하위 에이전트를 병렬로 실행하기에 충분한 저장 공간과 프로세서, 메모리를 제공한다. 연결된 서비스의 데이터와 자격 증명에 대한 기준 시스템 역할을 하는 것은 Meta의 중앙 집중식 인프라가 아니라 바로 이 머신이다. 작업에 필요한 도구가 없으면 에이전트가 직접 작성하며, 텍스트 블록 대신 조작 가능한 객체를 생성한다. 여기에는 일정표, PDF, 웹페이지, 대시보드가 포함되며 Meta는 이를 Artifacts라고 부른다.
두 번째로 내세운 변화는 앱이 닫힌 상태에서도 에이전트가 백그라운드에서 일정에 따라 또는 이벤트에 반응해 작업한 뒤, 결과를 알림으로 보낼 가치가 있는지 스스로 판단한다는 점이다. 메모리는 영구적으로 유지되며 사용자가 읽고 수정할 수 있고, 목표 탭에서는 에이전트가 추적하는 작업을 한눈에 볼 수 있다. 다만 Meta가 밝히지 않은 것도 있다. 가격은 공개되지 않았으며, 출시와 함께 제공 국가 목록도 발표되지 않았다.
제품 발표 20분 뒤 Meta는 Meta Superintelligence Labs의 소프트웨어 엔지니어이자 부사장인 Tarek Sheasha가 작성한 이 시스템의 보안 관련 엔지니어링 문서를 공개했다. 기본 원칙은 처음부터 명확하다. 에이전트가 공격받는다는 전제 아래 시스템을 설계했다는 것이다. 코드에서 Hatch라고 불리는 에이전트 하네스는 root가 호스트의 비특권 사용자에 매핑된 systemd-nspawn 컨테이너 안에서 실행되며, 시스템 호출은 필터링되고 커널 기능은 제거된다. 에이전트를 침해한 공격자가 비활성화하지 못하도록 네 가지 서비스는 의도적으로 이 컨테이너 외부에서 실행된다. 보안 분류기, 권한이 분리된 workers, 자격 증명 저장 daemon, Sentinel이다.
Sentinel은 핵심 구성 요소다. 커넥터 작업이나 네트워크 송신을 승인할 수 있는 유일한 권한 주체로서 계층 4와 7에서 모든 요청을 평가하고, 실제로 확인된 주소를 검증한다. 특히 에이전트는 대체 토큰만 취급하며, 실제 자격 증명으로의 교체는 네트워크 경계에서 이루어진다. 에이전트는 애초에 비밀 정보를 보유한 적이 없으므로 prompt injection으로 이를 유출시키는 공격은 무의미해진다. 여기에 커널 수준의 흐름 추적인 tainted egress가 추가된다. 사용자 데이터를 읽은 모든 프로세스에는 표시가 붙고 자동 승인 권한이 해제된다. 구현에는 cgroups에 연결된 eBPF 프로그램과 Meta가 추가한 Linux Security Module hooks가 결합된다.
| 아키텍처 요소 | 채택한 방식 |
|---|---|
| 에이전트 하네스 컨테이너 | systemd-nspawn, root를 비특권 사용자에 매핑 |
| 승인 권한 주체 | Sentinel, 컨테이너 외부, 계층 4와 7 |
| 에이전트에 노출되는 자격 증명 | 대체 토큰만 제공 |
| 이메일 커넥터 | 일회용 코드와 재설정 링크 필터링 |
| 브라우저 하위 에이전트 | 원시 DOM이 아닌 접근성 트리 사용, 페이지 내 JavaScript 실행 없음 |
| 결제 | 출시 시 Stripe Link, 이후 Shop Pay, 일회용 카드 |
| 유효한 보고서당 버그 바운티 상한 | 300 000달러 |
| prompt injection 버그 바운티 | 최대 130 000달러 |
이 문서와 함께 두 가지 발표가 나왔다. 버그 바운티 프로그램은 출시와 동시에 누구에게나 개방되며, 입증된 영향에 따라 유효한 보고서당 최대 30만 달러를 지급한다. 이 가운데 사용자 한 명에게 영향을 미치는 성공적인 prompt injection에는 최대 13만 달러가 지급된다. 또한 연말까지 출시될 예정인 Muse Confidential VM은 Meta가 가상 머신의 데이터에 접근하지 못하도록 암호학적으로, 그리고 검증 가능한 방식으로 차단하는 것을 목표로 하며, 설계와 소스 코드는 이미 외부 감사 기관에 제출됐다. 문서의 결론은 기업 발표로서는 이례적으로 솔직하다. prompt injection은 업계에서 여전히 해결되지 않은 문제이며, Muse도 실수할 것이라는 내용이다.
🔗 Muse 출시 · 🔗 에이전트 보안과 안전, Meta
Mistral, 유럽 기술 기업 사상 최대 지분 투자로 30억 유로 조달
9월 8일 — Mistral이 30억 유로 규모의 시리즈 D 투자를 발표했다. 투자 후 기업 가치는 210억 유로를 넘는다. 회사는 창립 3년 만에 성사된 이번 투자가 유럽 기술 기업이 유치한 사상 최대 규모의 지분 투자라고 밝혔다.
Samsung Electronics가 투자를 주도했다. EQT가 운용하는 Scaleup Europe Fund와 기존 주주인 PSG Equity가 공동 주도했다. Advent, BlackRock이 운용하는 펀드 및 계정, 룩셈부르크 대공국 등 세 곳도 새로 투자자로 합류했다. 기존 투자자 명단은 길고 세 대륙에 걸쳐 있다. a16z부터 Salesforce Ventures까지, ASML, BNP Paribas CIB, Bpifrance, DST Global, General Catalyst, Index Ventures, Korelya Capital, Lightspeed, NVIDIA 등이 포함된다.
주목할 부분은 연속된 두 차례 투자에서 주도 투자자의 성격이다. 시리즈 C는 ASML이 주도했고 시리즈 D는 Samsung Electronics가 주도했다. 두 곳 모두 일반적인 기술 투자 펀드가 아니라 첨단 제조 기업이다. Mistral은 이를 데이터와 인프라에 대한 통제력이 도입 여부를 결정하는 복잡한 산업 환경 내부에 최첨단 모델을 배포할 역량을 인정받았다는 신호로 해석한다.
| 지표 | 값 |
|---|---|
| 조달 금액 | 30억 유로 |
| 투자 후 기업 가치 | 210억 유로 이상 |
| 기업 업력 | 3년 |
| 주도 투자자 | Samsung Electronics |
| 공동 주도 투자자 | EQT가 운용하는 Scaleup Europe Fund, PSG Equity |
| 사업 운영 국가 | 20 |
| 대기업 고객 | Airbus, ASML, HSBC를 포함해 125곳 이상 |
자금 사용처로 회사는 먼저 최첨단 연구를 꼽았으며, 이어 학습을 위한 연산 능력 확대, 인프라 확장, 해외 사업 가속을 제시했다. 논리는 여름부터 주장해 온 기조를 되풀이한다. 조직이 마주한 질문은 더 이상 누가 가장 강력한 모델을 구축하느냐가 아니라, 인프라 통제권을 내주지 않고 어떻게 AI를 활용하느냐라는 것이다. Mistral은 공개 가중치 모델부터 제품과 연산 능력에 이르기까지 필요한 전체 스택을 구축하는 업계 유일의 기업이라고 자평한다.
Today marks a major step for Mistral: we’re announcing a €3B Series D, the largest equity round ever raised by a European tech company, just three years after launch.
🇰🇷 오늘은 Mistral에 중대한 이정표가 되는 날입니다. 창립한 지 불과 3년 만에 유럽 기술 기업이 유치한 사상 최대 규모의 지분 투자인 30억 유로 규모의 시리즈 D를 발표합니다. — @MistralAI가 X에서
OpenAI의 과학 에이전트: Navier-Stokes 증명과 MIT의 qubits 보정
9월 8일 — OpenAI가 3차원 Navier-Stokes 방정식에서 유한 시간 내 특이점이 형성된다는 증명을 발표하고, 증명 보조 도구 Lean을 이용한 형식화도 함께 공개했다. 발표된 결과에 따르면, 처음에는 매끄럽고 정지 상태인 3차원 유체에 매끄러운 외력이 가해질 경우 점성이 운동을 평탄화하려 하고 시스템 에너지는 유한하게 유지되는데도 속도가 유한 시간 안에 무한히 증가할 수 있다. Clay Mathematics Institute의 공식 정식화에서는 정칙성을 증명하는 것이 아니라 반증하는 명제인 ‘C’와 ‘D’에 해당한다.
OpenAI가 주장하는 것과 주장하지 않는 것을 정확히 구분할 필요가 있다. 이 증명은 공개 명칭이 없는 내부 모델을 기반으로 한 조율된 에이전트 시스템이 도출했다. 회사는 이 모델이 GPT-6 Astra보다 상당히 강력하며 8월 28일부터 계속 학습 중이라고 설명한다. 공개된 유일한 검증 절차는 GPT-6 Astra에 맡긴 Lean 형식화로, 문제 해결 후 17시간 만에 완료됐다. 발표에는 동료 평가나 Clay Mathematics Institute의 검증이 언급되지 않았으며, OpenAI는 밀레니엄 문제 상금을 신청할 의사가 없다고 밝혔다. 또한 이번 결과를 최종 성과가 아닌 한 시점의 스냅샷으로 제시했다.
방법론은 결과만큼이나 주목할 만하다. 두 개의 밀레니엄 문제가 해결됐다는 소문이 퍼진 뒤인 9월 1일 작업이 시작됐다. 서로 다른 에이전트 그룹에는 명제의 상이한 변형이 주어졌다. ‘A’와 ‘B’ 버전은 증명을, ‘C’와 ‘D’ 버전은 반증을 지향했다. 별도의 문제인 외력이 없는 Euler 방정식의 정칙성에 대해서는 약 100개의 에이전트가 약 50시간 만에 반증을 도출했다. 이 결과는 Navier-Stokes 문제를 다루는 에이전트들의 prompts에 다시 입력됐다.
| 측정 항목 | 값 |
|---|---|
| Navier-Stokes 그룹의 동시 실행 에이전트 | 약 10 000개 |
| 해결까지 걸린 시간 | 약 88시간 |
| Lean 형식화 및 검증 | GPT-6 Astra로 추가 17시간 |
| Navier-Stokes에서 교환된 메시지 | 270만 개 |
| Navier-Stokes 출력 tokens | 약 1 300억 개 |
| 시도한 모든 문제에서 교환된 메시지 | 490만 개 |
| 시도한 모든 문제의 출력 tokens | 약 3 000억 개 |
| 외력이 없는 Euler 정칙성 반증 | 약 100개 에이전트, 약 50시간 |
동시에 진행된 다른 연구는 상황을 복잡하게 만든다. Anthropic 직원 Levent Alpöge와 NYU 수학 교수 Tristan Buckmaster는 외력이 있는 Euler 방정식에 관한 결과를 보유하고 있었다. OpenAI는 자사 프로젝트를 완료하고 검증한 뒤인 9월 6일 두 사람에게 연락해 공동 발표와 선행 연구 인정을 제안했으나, 이후 그들의 결과가 자사와는 다른 명제를 다룬다는 사실을 확인했다.
This model represents a step-function improvement on many benchmarks, and its training is ongoing. Our internal model group arrived at the Navier–Stokes solution in 88 hours, using around 10,000 coordinating AI agents. Throughout the effort, we maintained the strict safeguards—including monitoring and isolation—that we apply to all our frontier evaluations.
🇰🇷 이 모델은 여러 benchmarks에서 계단식의 큰 향상을 보여주며, 학습은 계속 진행 중입니다. 저희 내부 모델 그룹은 조율된 약 10 000개의 AI 에이전트를 활용해 88시간 만에 Navier-Stokes 해법에 도달했습니다. 작업 전반에 걸쳐 모든 최첨단 모델 평가에 적용하는 감시 및 격리를 포함한 엄격한 안전장치를 유지했습니다. — @OpenAI가 X에서
같은 날 OpenAI는 훨씬 소박하고 훨씬 검증하기 쉬운 사례 연구도 발표했다. MIT Engineering Quantum Systems 그룹의 박사 과정 연구원 Beatriz Yankelevich는 GPT-5.6 Sol로 구동되는 Codex를 자신의 실험을 조율하는 소프트웨어에 연결해, 보정되지 않은 6개의 초전도 qubits 칩을 보정했다. 에이전트에는 측정 유형별 전용 skills가 제공됐으며, 여기에는 측정 수행 방법과 결과 판단 방법이 설명돼 있었다. 신호가 명확한 경우 Codex는 거의 개입 없이 전체 과정을 수행했다. 전이 주파수를 식별하고, 제어 및 판독 pulses를 보정하고, 양자 정보의 유지 시간을 측정했다. 신호가 약하거나 잡음이 많은 경우에는 활용 가능한 매개변수를 찾는 데 더 오래 걸리고, 때로는 모델보다 더 빠르게 판단하는 숙련된 연구원의 검토를 요청한다. 따라서 이점은 속도가 아니라 지속적인 감독이 필요 없다는 데 있다. 이러한 표준 칩 하나를 특성화하는 데 연구원은 며칠을 써야 하며, 이 그룹은 이제 일상적인 측정을 에이전트에 맡기고 있다.
🔗 Navier-Stokes 해법, OpenAI · 🔗 Codex와 양자 실험, OpenAI
ChatGPT Images 2.5, Sketch와 API의 두 가지 이미지 모델
9월 8일 — OpenAI가 자사 제품과 API에 ChatGPT Images 2.5를 출시한다. 서두에서 제시된 사용량 수치는 그 중요성을 보여준다. 매주 ChatGPT Images와 API의 GPT-Image 모델에서 30억 개 이상의 이미지가 생성된다. 가장 실질적인 개선점은 Images 2.0보다 최대 50퍼센트 단축된 지연 시간이며, 그 밖에도 참조 사진에 대한 충실도와 긴 대화에서의 일관성이 개선되어 이전 수정 사항이 더 잘 유지된다.
ChatGPT에는 세 가지 기능이 추가된다. Sketch를 사용하면 대화에서 « @Sketch »를 입력해 시각적 가이드로 활용할 그림을 직접 그릴 수 있다. 템플릿은 포스터나 상품 제작 같은 일반적인 형식을 지원한다. 이미지에 댓글을 달아 수정할 부분을 지정할 수 있다. 이제 이미지를 공유할 때 해당 이미지를 생성한 prompt도 포함할 수 있다. 이 기능은 모든 요금제의 ChatGPT, ChatGPT Work, Codex 사용자에게 데스크톱, 모바일, 웹 전반에 걸쳐 배포된다.
| API 모델 | 발표된 용도 | 지연 시간 |
|---|---|---|
| GPT-Image-2.5 Flare | 기본 선택, 소셜 콘텐츠, 대량 생성 | Images 2.0보다 최대 50퍼센트 단축 |
| GPT-Image-2.5 Sunburst | 정밀도, 바로 배포할 수 있는 캠페인 | 더 긴 생성 시간 |
두 모델 모두 새로운 품질 설정 xhigh 및 max을 지원하며 GPT Image 2의 token 요금을 그대로 적용한다. Standard 요금제 기준으로 이미지 입력 token 100만 개당 8.00달러, 이미지 출력은 30.00달러, 텍스트 입력은 5.00달러다. C2PA metadata와 보이지 않는 watermark도 유지되며, 출시에 맞춰 system card가 제공된다.
Manus가 발표 당일 모델을 통합하다
Manus는 발표 당일 저녁, 한 시간 반 전에 게시된 OpenAI의 메시지를 인용하며 자사 플랫폼에 GPT-Image-2.5를 추가했다. 9월 1일 다시 독립한 이 에이전트 연구소는 OpenAI가 아닌 자체 평가에서 나온 수치를 제시한다. Manus가 Flare라고 부르는 모델은 GPT-Image-2보다 2배에서 4배 빠른 속도로 고품질 이미지를 생성한다. 대화를 이어가며 시각 자료를 생성하는 에이전트에게는 이러한 속도 차이가 미미한 품질 향상보다 중요하다. 이미지 생성이 작업 흐름 안에 머무를지, 아니면 사용자가 기다려야 할지를 결정하기 때문이다. Manus는 완전한 자동화를 방해하는 수동 누끼 작업을 생략할 수 있도록 투명 배경 생성 기능이 향상됐다는 점도 강조한다.
🔗 Manus 통합
AlphaGenome Atlas, 인간 DNA의 90억 개 돌연변이를 예측하는 지도
9월 8일 — Google DeepMind가 인간 DNA에서 발생할 수 있는 모든 단일 문자 돌연변이의 분자적 영향을 예측하는 데이터베이스 AlphaGenome Atlas를 출시한다. 인간 genome은 약 30억 개의 염기쌍으로 구성되지만, 그중 단 2퍼센트만 단백질을 암호화한다. 나머지 98퍼센트는 문자 하나의 변화만으로도 필수적인 생물학적 조절자가 비활성화될 수 있음에도 여전히 대부분 미지의 영역으로 남아 있다.
이 방법의 핵심은 계산 부담의 방향을 뒤집는 데 있다. 각 연구소가 변이별로 모델에 질의하도록 두는 대신, Google DeepMind는 가능한 90억 개의 모든 치환에 관해 AlphaGenome 모델의 예측을 미리 계산했다. 그 결과물은 1페타바이트 규모의 데이터 세트로, AlphaFold Database보다 30배 이상 크다고 소개됐다. 이 방대한 데이터를 활용할 수 있도록 Atlas는 AVI 점수(AlphaGenome Variant Impact)를 도입한다. 이는 암호화 영역과 비암호화 영역의 예측을 종합해 특정 변이가 어떤 생물학적 과정을 교란하는지 특성별 기여도와 함께 보여주는 단일 수치다. 여기에 Google이 genome의 « 단어 »라고 표현하는 조절 단위인 반복적인 서열 motif 2,500개 이상의 목록도 추가된다.
| 지표 | 값 |
|---|---|
| 사전 계산된 변이 | 90억 개, 모든 단일 문자 변화 |
| 데이터 세트 크기 | 1페타바이트, AlphaFold Database의 30배 이상 |
| 목록화된 서열 motif | 2,500개 이상 |
| 분석된 UK Biobank 참여자 | 54,000명 이상 |
| 추가로 확인된 비암호화 연관성 | 22퍼센트 증가 |
| 확인된 체질량지수 관련 유전 영역 | 19 |
문서화된 두 가지 활용 사례가 개선 효과를 잘 보여준다. Broad Institute에서 Laura Covill과 연구진은 진단되지 않은 희귀 질환의 후보 변이 우선순위를 정하는 데 AVI 점수를 사용했다. 이 도구는 DNM1 유전자의 한 변이가 잘못된 splicing site를 생성한다고 예측해 해당 사례를 해결하는 결정적 단서를 제공했다. University of Exeter의 Gareth Hawkes는 54,000명이 넘는 UK Biobank 참여자의 데이터에 Atlas를 적용해 비암호화 유전적 연관성을 22퍼센트 더 많이 확인했다. 이어 영향력이 가장 큰 상위 1퍼센트의 변이만을 사용해 체질량지수와 관련된 유전 영역 19개를 찾아냈다.
접근성도 주목할 만한 두 번째 특징이다. Atlas는 코드를 작성하지 않는 임상의와 생물학자를 위해 코딩 없이 사용할 수 있는 웹 portal로 제공된다. AlphaGenome API와 Cloud의 Model Garden을 통해서도 이용할 수 있으며, 연구 데이터는 GitHub에 공개됐다. Google의 에이전트 생태계를 지켜보는 개발자에게 흥미로운 점은 Atlas가 Google Antigravity에서 skill로도 배포되어 코딩 에이전트가 직접 활용할 수 있다는 것이다.
🔗 AlphaGenome Atlas, Google DeepMind
NVIDIA가 CUDA Rust를 출시하고 Cosmos가 ECCV AI City Challenge를 휩쓸다
9월 8일 — NVIDIA가 점점 뚜렷해진 공백에 대한 해답으로 CUDA Rust를 공개한다. AI의 system 계층은 갈수록 Rust로 작성되고 있지만 GPU kernel만은 예외로 남아 있었다. 기존에도 Rust에서 kernel을 실행할 수 있었지만, kernel 자체는 다른 언어로 작성해야 했다. CUDA Rust는 Rust kernel을 PTX로 직접 compile해 이 간극을 메운다. 이를 위해 CUDA가 이미 C++와 Python에서 제공하는 두 가지 programming model에 맞춘 별도의 두 경로를 지원한다.
| 요소 | cuda-oxide, SIMT 경로 | cutile-rs, Tile 경로 |
|---|---|---|
| 성숙도 | 초기 alpha | crates.io에 공개 |
| 필요한 Rust toolchain | 고정된 nightly (nightly-2026-04-03) | stable 1.89 이상 |
| CUDA 버전 | 12.x 이상 | 13.3 |
| 별도 LLVM 필요 여부 | 필요, clang 및 libclang도 필요 | 불필요 |
| compilation | build 시 PTX로 변환 | CUDA Tile IR을 통한 JIT |
| 언급된 외부 활용 사례 | 없음 | Hugging Face의 Grout, mistral.rs |
NVIDIA의 권고는 명확하다. source code에 특정 architecture를 위한 선택이 전혀 포함되지 않는 Tile로 시작하고, thread와 memory를 세밀하게 제어해야 할 때 SIMT로 내려가라는 것이다. 현재 이 선택에는 대가가 따른다. 빠른 kernel의 기반인 shared memory를 SIMT에서 사용하려면 여전히 unsafe이 필요하기 때문이다. 핵심 논거는 compile 단계의 memory safety다. 두 경로 모두 하나의 buffer를 입력과 출력으로 동시에 사용하는 전형적인 aliasing을 허용하지 않으며, SIMT에서는 error[E0502], Tile에서는 error[E0382]을 사용한다. NVIDIA는 성숙도를 과장하지 않는다. 두 프로젝트 모두 아직 production에 사용할 준비가 되지 않았으며, rust-cuda 유지관리자들과 협력해 2027년 이후까지 작업을 이어가겠다고 밝혔다.
같은 날 NVIDIA는 ECCV 2026 AI City Challenge의 결과도 발표한다. 교통 장면을 생성형 video로 예측하는 track 5에서는 상위 5개 solution 가운데 4개가 Cosmos world foundation model의 여러 version을 사용했다. Qyn 팀은 160억 parameter의 고정된 Cosmos3-Nano 모델을 2단계 LoRA 방식으로 조정하는 CosmosAlign으로 공개 순위 1위를 차지했다. 이 방식은 네 가지 예측을 생성해 medoid를 선택한 뒤 관찰된 과거 영상의 안정적인 영역을 다시 주입한다. 점수는 76.39로 SSUPER 팀의 76.04보다 0.35점 앞섰다. NVIDIA는 이것이 새로운 architecture가 아니라 adaptation 및 inference 방식이라는 점을 분명히 한다. Cosmos는 심판 역할로도 등장한다. track 3의 두 가지 domain 외 순위에서 UWIPL_ETRI 팀은 UniTraffic으로 우승했는데, 이 방식은 논쟁의 여지가 있는 주장을 독립적인 Cosmos-Reason1 verifier가 검토하도록 한다.
🔗 CUDA Rust, NVIDIA · 🔗 AI City Challenge 결과
Cognition이 20억 달러 이상을 조달하며 기업가치 480억 달러를 달성하다
9월 8일 — 개발 에이전트 Devin을 만든 Cognition이 기업가치 480억 달러를 인정받으며 20억 달러 이상의 자금을 조달했다고 발표한다. 이번 투자는 신규 투자자인 Andreessen Horowitz와 Accel이 주도했으며, 기존 투자자인 Founders Fund, General Catalyst, Avenir도 참여했다. NVIDIA, Benchmark, Bessemer, Kleiner Perkins, Greylock, Lightspeed, T. Rowe Price, Bain Capital Ventures를 비롯한 약 30곳의 참여자가 투자자 명단을 채웠다.
| 지표 | 2026년 5월 | 2026년 9월 |
|---|---|---|
| 해당 round의 누적 조달액 | 10억 달러 이상 | 20억 달러 이상 |
| 기업가치 | 260억 달러 | 480억 달러 |
| 연환산 매출 | 4억 9,200만 달러 | 약 9억 달러 |
| 주요 투자자 | Lux Capital, General Catalyst, 8VC | Andreessen Horowitz, Accel |
기업가치는 4개월 만에 거의 두 배가 됐고 1년 만에 약 5배로 증가했으며, 연환산 매출도 같은 추세를 보인다. Cognition은 이러한 성장을 이끄는 활용 사례를 구체적으로 소개한다. Devin은 NVIDIA의 chip 설계, GE Aerospace의 항공 분야, Citi의 금융 서비스, Mercedes-Benz의 자동차 분야, Modal의 AI infrastructure에서 일하고 있다. NVIDIA가 고객이면서 동시에 이번 round의 투자자라는 사실은 이 기업들이 내부에서 사용하는 도구에 대한 접근권을 확보하는 방식을 보여준다. 최근 추가된 세 가지 기능은 Devin을 작업 실행 도구에서 자율적으로 행동하는 시스템으로 전환한다. Auto-Triage는 incident 조사의 1차 분석을 수행하고, Security Swarm은 취약점을 분류하며, Automations는 Slack, GitHub 또는 Linear의 event로 실행된다. 1년 동안 6개 사무소를 열었으며, 그중 5개는 미국 외 지역에 있다. 기존 거점은 San Francisco, New York, Austin에 있다.
In the next chapter of software engineering, agents will become proactive by default, software will improve itself, and compute will automatically get allocated toward the highest impact use cases. We’re still at the dawn of the self-driving software era.
🇰🇷 소프트웨어 엔지니어링의 다음 장에서는 에이전트가 기본적으로 선제적으로 행동하고, 소프트웨어가 스스로 개선되며, 연산 능력이 가장 큰 효과를 내는 용도에 자동으로 할당될 것입니다. 우리는 아직 자율 소프트웨어 시대의 여명에 서 있습니다. — @cognition의 X 게시물
Suno가 전날까지만 해도 자사 음악 배포를 거부했던 Believe 및 TuneCore와 계약하다
9월 8일 — Suno가 아티스트 개발 기업 Believe 및 그 자체 배포 플랫폼 TuneCore와 세계적인 전략적 협력 관계를 발표한다. 계약은 서로 다른 두 가지 사안을 다룬다. 먼저 Believe는 Suno가 음악 업계와 함께 개발하는 새로운 음악 모델의 설계에 참여한다. 다음으로 사용자에게 실질적인 변화가 되는 부분은 이 새로운 협력 모델로 만든 곡이 Believe와 TuneCore를 통해 Spotify, Apple Music, Amazon Music, YouTube에 배포될 수 있게 된다는 점이다.
이 발표의 의미는 그 배경에서 드러난다. Suno는 올해 초 Believe와 TuneCore가 자신들의 기준을 충족하지 못하는 모델로 제작된 음악을 배포하지 않겠다고 발표했으며, 당시 Suno의 모델도 그 대상에 포함됐다는 사실을 숨김없이 상기시킨다. 이번 입장 전환은 아티스트에게 실질적인 선택권을 주고 배포와 수익 창출의 길을 연다는 공통의 가치를 확인한 논의의 결과로 설명된다.
이번 계약은 일관된 흐름의 연장선에 있다. 독립 및 신진 아티스트를 위한 Suno의 프로그램 Spark를 확대하고, Warner Music Group 및 BMG와 체결한 기존 계약에 독립 label과 자체 제작 아티스트를 추가한다. Suno는 최근 도입한 보호 장치와도 이번 계약을 명시적으로 연결한다. 플랫폼 밖에서 자사 곡을 식별하기 위한 audio watermark와 acoustic fingerprint, streaming service로 음악이 대량 유통되는 것을 막기 위해 9월 3일 발효된 다운로드 제한이 그것이다. 이러한 보호 조치는 Believe와 TuneCore를 통해 배포되는 음악에도 적용된다. 발표는 향후 일정으로 마무리된다. Suno는 9월 4일 v6라는 이름으로 공개했던 새로운 모델 제품군을 조만간 출시한다고 밝혔다.
Cohere, megakernel 중심의 서빙 엔진 공개…vLLM보다 1.58배 빨라
9월 8일 — Cohere가 디코딩 megakernel을 중심으로 완전히 구축된 추론 서빙 엔진을 Apache 2.0 라이선스로 공개했다. 회사는 이것이 최초라고 주장한다. 단순한 실험실 속도 시연이 아니라, 연속 배치 처리, paged attention, prefix cache, 도구 호출을 지원하며 OpenAI 호환 엔드포인트에서 실제 요청을 처리할 수 있는 완전한 서버라는 것이다. 서빙되는 모델은 300억 개 매개변수 중 token당 33억 개만 활성화되는 mixture-of-experts 모델 North Mini Code다.
해결하려는 문제는 한 문장으로 요약된다. 디코딩 중 GPU가 계산보다 대기에 많은 시간을 쓴다는 것이다. 기존 스택은 연산마다 kernel 하나를 실행하며, 각 kernel 경계는 전체 계산 grid에 barrier를 부과한다. 그런데 autoregressive 디코딩은 메모리 대역폭의 제약을 받는다. 각 단계에서 North Mini Code는 HBM 메모리에서 6.6GB의 weight를 전송하고, 8K context에서는 약 0.5GB의 key-value cache도 추가로 전송한다. 이에 따라 H100의 3.35TB/s 대역폭에서 이론적 상한은 초당 약 470 tokens가 된다. megakernel은 디코딩 단계 전체에서 상주하는 단일 persistent kernel을 실행하고 dependency를 global memory의 counter로 축소해 이러한 경계를 없앤다.
| 측정 항목 | Megakernel | vLLM v0.24 | 향상 |
|---|---|---|---|
| 디코딩, batch size 1, context 8K (tok/s) | 292 | 185 | 1.58x |
| AIME 2025, end-to-end (tok/s) | 935 | 661 | 1.41x |
| SciCode, end-to-end (tok/s) | 711 | 560 | 1.37x |
| MMLU-Pro, 컴퓨터 과학 하위 집합 (tok/s) | 948 | 713 | 1.33x |
| LiveCodeBench v6, end-to-end (tok/s) | 803 | 625 | 1.28x |
| GPQA, end-to-end (tok/s) | 787 | 631 | 1.25x |
batch size 1에서 초당 292 tokens는 이론적 상한의 62%로, vLLM의 39%보다 높다. 품질은 변하지 않았다. 7회 실행 평균으로 SciCode에서는 38.9% 대 38.2%, LiveCodeBench v6에서는 양쪽 모두 70.3%였다. 주목할 만한 세부 사항은 우위가 expert 분포에 따라 달라진다는 점이다. 모델의 실제 routing에서는 1.32x였지만 시뮬레이션한 균등 routing에서는 1.14x로, 균등 측정이 불리한 경우에 해당한다. Cohere는 마지막으로 직관에 반하는 점도 강조한다. megakernel 작성은 알려진 평판보다 간단하며, 하나의 CUDA 파일에서 16개의 opcode로 디코딩 단계 전체를 처리한다는 것이다. 한계도 인정하며 구현상의 제약으로 규정했다. 디코딩만 지원하고 prefill은 여전히 일반 PyTorch kernel로 실행되며, H100과 BF16만 지원하고 batch size는 1~8이다.
Anthropic, 성능 저하 없이 Claude Platform 비용을 낮추는 방법 공개
9월 8일 — Anthropic이 agent 비용 절감은 결과 악화를 감수해야 한다는 통념을 뒤집는 엔지니어링 가이드를 공개했다. 여기에는 prompt cache 적중률 극대화, frontier model로 전환할 때 prompt anti-pattern 제거, 작업에 맞춘 effort 조정이라는 세 가지 수단이 담겼다. 이 방법은 Claude Code에서 실행할 수 있는 명령 형태로 제공되며, /claude-api prompt-audit 및 /claude-api hillclimb은 /claude-api cost-optimize에 합류한다.
| 벤치마크, Sonnet 5 기준 | 비용 절감 | 측정 세부 사항 |
|---|---|---|
| LegalBench | 약 58% | reasoning tokens가 102 779에서 8 284로 감소 |
| tau2-bench retail | 약 73% | 명시적 breakpoint를 사용한 prompt cache |
| OfficeQA Pro | 136.20달러에서 64.87달러로 약 52% 감소 | |
| SWE-bench Verified | 약 55% | 중간 단계 수가 29에서 17로 감소하고 prompt tokens는 절반 이하로 감소 |
가장 실용적인 수치는 이 표에 없다. CursorBench 3.2에서 low effort의 Claude Fable 5.1은 high effort의 Fable 5와 같은 성능을 비용 3분의 1로 달성한다. 여기에는 cache read 요금이 100만 tokens당 기존 1.00달러에서 0.25달러로 낮아진 영향도 일부 포함된다. 반대로 도구를 사용하지 않는 Humanity’s Last Exam에서는 마지막 effort 단계가 약 0.5점의 향상을 위해 비용을 46% 더 요구하며, 그 향상은 benchmark의 잡음에 묻힌다.
Claude Code 2.1.265: plugin 폴더, 1GB 상한, prompt cache 복구
9월 8일 — Claude Code가 2.1.265로 업데이트됐다. changelog에는 수정 사항 34개를 포함해 50개 항목이 있으며, 단 하나의 항목만 있었던 2.1.263 출시 이틀 만이다. 이제 --plugin-dir 옵션은 plugin 폴더 전체를 받는다. manifest가 있는 각 하위 폴더가 로드되며, 실행 중 이루어진 추가와 삭제도 감지된다. disk에 기록되는 도구 결과에는 1GB 상한이 적용되며, 미리보기에는 파일이 잘렸다는 사실이 표시된다.
가장 많은 내용은 같은 날 공개된 가이드와 맥을 같이하는 prompt cache 관련 사항이다. 서로 다른 두 수정 사항은 Claude Code가 스스로 cache 재사용을 깨뜨리던 경우를 해결한다. foreground에서 실행된 sub-agent를 재개하면 도구 목록과 system prompt prefix가 바뀌었고, agent teammate와 재개된 sub-agent는 SubagentStart hook context와 사전 로드된 skill을 prefix 밖으로 이동시켰다. 보안 관련 수정 사항도 두 가지다. backslash가 포함된 plugin path는 macOS와 Linux에서 symbolic link 격리 검사를 우회했으며, Windows에서는 읽기 및 쓰기 도구가 AppContainer나 restricted-token sandbox 안의 모든 파일을 거부했다. 이제 제3자가 작성한 artifact를 읽을 때는 신뢰할 수 없는 콘텐츠로 취급한다.
Amp, 메시지 대기열을 실시간 조정으로 교체
9월 8일 — Amp가 agent 작업 도중 전송되는 메시지에 대한 기본 동작을 변경했다. 이전까지 agent가 실행되는 동안 입력한 메시지는 대기열에 들어가 현재 turn이 끝난 뒤에야 처리됐다. 이제는 가능한 첫 번째 시점에 전달된다. 개발사는 두 가지 이점을 제시한다. agent가 feedback을 더 빨리 반영하고, 새 지시로 불필요해진 검증 단계를 더 이상 시작하지 않아, agent가 잘못된 방향으로 가는 것을 발견하는 일반적인 상황에서 시간과 tokens를 절약한다는 것이다.
이 변경에 부작용이 없는 것은 아니며 Amp도 이를 문서화했다. 실시간 조정이 지나치게 급격하다면 지시가 현재 작업 이후에 적용된다는 점을 명시하기 위해 요청을 “Now, …” 대신 “When done, then…”으로 표현하라고 권한다. Ship, Review 및 기타 내장 action은 일반적으로 전달이나 검토를 시작하기 전에 작업이 완료되기를 원하므로 이전 동작을 유지하며 계속 대기열에 들어간다. 수동 대기열 기능도 앱과 CLI 모두에서 계속 사용할 수 있다.
Muse Spark 1.3, CursorBench 최고 점수 대비 비용 효율로 Cursor에 출시
9월 8일 — Cursor가 Meta Superintelligence Labs의 agentic model Muse Spark 1.3을 공개 6일 만에 추가했다. 공개된 수치는 절대적인 성능보다 비용에 관한 이야기를 보여준다. 실제 multi-file 작업으로 자체 구축한 benchmark인 CursorBench 3.2에서 Max 단계는 67.9%를 기록했고, 작업당 1.31달러로 12위에 올랐다.
| 모델 및 단계 | CursorBench 3.2 점수 | 작업당 비용, 달러 | 작업당 Tokens | 순위 |
|---|---|---|---|---|
| Fable 5.1 Max | 73.4% | 9.64 | 72 060 | 1 |
| Grok 4.6 Extra High | 70.8% | 2.81 | 41 136 | 3 |
| Opus 5 Max | 70.0% | 8.23 | 61 838 | 5 |
| Gemini 3.8 Flash High | 69.2% | 2.38 | 81 524 | 9 |
| Muse Spark 1.3 Max | 67.9% | 1.31 | 33 034 | 12 |
| GPT-5.6 Sol Max | 67.2% | 5.69 | 28 320 | 13 |
| Muse Spark 1.3 Low | 55.0% | 0.45 | 12 181 | 49 |
따라서 Meta의 모델은 점수 면에서 Claude Fable 5.1 Max에 크게 뒤처지지만, 후자는 작업당 비용이 7배 이상 비싸다. 특히 Max 단계에서는 GPT-5.6 Sol보다 앞서면서 비용은 4분의 1 미만이다. Cursor는 단순히 이용 가능 여부만 알리는 대신 추가되는 각 모델의 점수와 작업당 비용을 체계적으로 공개하는 방식을 유지하고 있다.
Grok Bot, 채팅에서 양식과 로그인 정보 입력…Grok Imagine은 keyframe 제어 지원
9월 8일 — SpaceXAI는 이제 대화를 벗어나지 않고 Grok Bot의 양식과 로그인 페이지를 작성할 수 있게 했으며, 모든 password manager를 지원한다고 밝혔다. 이 기능은 persistent agent 특유의 마찰 지점을 해결한다. agent가 로그인 화면을 통과하거나 개인 정보가 포함된 양식을 제출해야 할 때마다 저장된 로그인 정보 또는 사용자의 개입이 필요하다. 이 단계를 별도 browser session이 아닌 대화 thread에 표시하는 것은 편의성만큼이나 보안을 고려한 선택이다.
두 시간 뒤 Grok Imagine은 영상 장면의 시작 및 종료 이미지를 제어하고 자연스럽게 이어지는 loop를 생성하는 기능을 추가했으며, instruction following과 영상 품질도 향상됐다고 밝혔다. keyframe 제어는 연속된 shot을 제작하는 사용자에게 도구의 성격을 바꾼다. 한 shot의 마지막 이미지를 고정해 다음 shot의 첫 이미지로 재사용할 수 있으므로, 생성의 우연성에 의존하지 않고 연속성이 유지되는 sequence를 연결할 수 있다. 이번 발표는 Image 2.0 모델로 구동되는 Grok Imagine Video 1.5 agent 출시 사흘 뒤에 나왔다.
🔗 Grok Bot의 양식 작성 · 🔗 Grok Imagine의 keyframe
Hugging Face 블로그의 연구 게시물 세 편
9월 8일 — 날씨, 모델 안전성, 생물학에서 영감을 얻은 모델을 다룬 Hugging Face 커뮤니티 게시물 세 편이 같은 날 읽어볼 만한 글로 공개됐다.
GPU 없이 공개 기상 모델 실행하기
Hugging Face와 Earthmover가 좀처럼 다뤄지지 않는 문제에 관한 공동 게시물을 공개했다. machine learning 기반 기상 모델은 노트북에서 실행할 수 있을 만큼 가볍지만, 실제로 실행하는 사람은 거의 없다는 것이다. 세 가지 장애물이 지목됐다. 계산 측면에서는 AIFS를 비롯한 여러 모델이 일부 GPU architecture에서만 지원되는 flash attention에 의존하며, 그 밖에 저장 공간, 특히 예보당 약 1GB의 초기 조건을 전송해야 하는 대역폭 문제가 있다. 해법은 공개 artifact 세 가지로 구성된다. demo space, storage bucket, 그리고 Microsoft의 모델 Aurora를 0.25도 해상도의 pre-trained 버전으로 실행하는 재현 가능한 tutorial이다. 초기 조건은 Earthmover data marketplace가 제공하는 ERA5를 사용한다. GPU는 필요 없다. CPU에서는 계산 단계당 2~3분, GPU에서는 몇 초가 걸리며, 6시간 간격의 네 단계를 거쳐 24시간 예보를 만든 뒤 ERA5와 비교한다.
더 안전하다고 평가된 모델, 무해한 질문의 4분의 3을 거부
Multiverse Computing이 alignment 연구를 넘어 널리 알려져야 할 결과를 공개했다. Qwen3-8B가 정치적 조작 요청을 거부하도록 훈련하자 명백한 성공처럼 보이는 수치가 나왔다. HarmBench, StrongREJECT, WildJailbreak에서 평균 유해 응답률이 26.26%에서 0.14%로 떨어졌다. 하지만 같은 checkpoint에서 XSTest의 over-refusal은 2.00%에서 74.00%로 상승했다. 다시 말해 문서상 가장 안전한 설정은 거부만 하는 기계이며, 일반적인 측정 방식으로는 이를 전혀 알아낼 수 없다. 두 가지 수정이 효과를 냈다. 외부 compliance response를 target model의 검증된 response로 교체하자 XSTest over-refusal은 15.20%에서 5.20%로 떨어졌고, 무해한 boundary pair를 추가하자 응답해야 하는 측의 over-refusal은 32.94%에서 4.16%로 낮아졌다. 반면 유해한 측의 거부율은 4점만 감소했다.
🔗 누구를 위한 안전인가, Multiverse Computing
파리 connectome, 무작위로 섞은 자체 wiring을 이기지 못해
Oruk가 connectome에서 영감을 얻은 모델을 넘어 적용할 수 있는 방법론적 교훈을 공개했다. 연구팀은 공개된 파리 MaleCNS reconstruction에서 강하게 연결된 neuron 499개를 reservoir 역할의 recurrent network에 복제하고, 그 위에 단일 ridge readout만 훈련했다. 파리의 wiring은 test에서 평균 정확도 16.84%를 기록했고, 무작위로 섞은 wiring은 16.88%를 기록했다. 차이는 -0.04점에 불과하며 confidence interval은 0을 가로지른다. 두 번째 실험은 반대 증거처럼 보일 수도 있었다. readout weight norm이 가장 큰 neuron 50개를 제거하자 정확도가 16.91%에서 10.83%로 떨어졌기 때문이다. 저자들은 모순이 없는 이유를 설명한다. 극적인 ablation은 생물학적 topology가 필요했다는 사실을 결코 입증하지 못한다. 참고로 게시물은 peer review를 거치지 않은 논문을 바탕으로 AI agent가 작성했다고 직접 밝히며, 전체 evaluation dataset은 여전히 비공개다.
🔗 Connectome과 무작위로 섞은 wiring, Oruk
Runway, 파리 소재 Kinetix 연구소 팀 영입
9월 8일 — Runway가 파리에 기반을 둔 AI 연구소 Kinetix 팀의 합류를 발표했다. 이 연구소는 3D 인간 움직임과 물리학에 기반한 영상 생성을 연구했으며, Runway는 이 두 주제를 robotics에 적용하는 world model 연구와 직접 연결한다. 팀은 회사의 파리 조직에 합류하며, 회사는 현지 연구 및 엔지니어링 인력도 별도로 채용하고 있다.
기술적 주장은 발표문의 한 문장으로 요약된다. 실제로 유용한 robot은 새로운 환경과 작업, 상황을 이해하고 다룰 수 있어야 하며, Runway에 따르면 대규모 영상 pre-training이 이러한 일반화 문제를 해결하는 가장 효과적인 길을 제공한다. 이는 8월 31일 공개된 Solaris와 9월 3일 공개된 GWM Worlds 2의 직접적인 연장선이다. 모델에 세계를 시뮬레이션하는 법을 가르친 데 이어, 이제 Runway는 그 안에서 행동하는 법을 가르치려 한다. Kinetix 최고경영자 Yassine Tahi는 연구소 설립 당시의 이러한 구상이 6년 전 시작됐다고 설명한다. 거래 금액이나 구조는 공개되지 않았다.
Sarah Friar가 공개한 OpenAI의 규모와 모델이 비용에 미치는 효과
9월 8일 — Sarah Friar가 OpenAI가 연구 성과를 경제 활동으로 전환하는 방식을 다룬 기고문을 발표했다. 이 글에서 주목할 부분은 논지보다 새롭게 공개된 세 가지 수치다.
| 지표 | 값 |
|---|---|
| 주간 활성 사용자 | 10억 명 이상 |
| 기업 고객 | 250만 곳 |
| 개인 요금제 가입자의 6개월 차 일일 메시지 수 | 첫 달보다 약 50퍼센트 증가 |
| 6개월 차에 시도한 서로 다른 작업 수 | 약 2배 |
| 최적화 후 엔드투엔드 서비스 비용 | 20퍼센트 감소 |
| 토큰 생성 효율 | 15퍼센트 이상 향상 |
세 번째 수치는 흥미로운 순환 구조를 완성한다. GPT-5.6 Sol은 OpenAI의 실제 운영 환경에서 서비스 소프트웨어를 개선하는 데 사용됐으며, 그 결과 서비스 비용이 20퍼센트 절감됐고 토큰 생성 효율도 15퍼센트 이상 향상됐다. 다시 말해 모델이 자신을 제공하는 계층을 최적화함으로써 자체 인프라 비용의 일부를 충당하는 셈이다. 한편 개인 사용량의 변화 추이는 자주 제기되지만 좀처럼 자료로 확인되지 않았던 유지율 문제에도 답을 준다.
OpenAI, 청소년 관련 독립 연구에 500만 달러 지원
9월 8일 — OpenAI가 생성형 AI가 13~17세 청소년에게 미치는 영향을 독립적으로 연구하는 데 500만 달러 규모의 보조금 프로그램을 시작했다. 특히 사회적·정서적 발달에 초점을 맞춘다. 개별 프로젝트에는 최대 100만 달러가 지원된다. 신청은 2026년 10월 6일 마감되며, 선정 프로젝트는 늦어도 2026년 11월 13일까지 통보된다. 2027년 1분기에는 중간 진행 상황을 제출해야 하며, 간접비는 보조금별로 10퍼센트 이하로 제한된다.
두 가지 세부 사항에 주목할 만하다. 첫째는 이 프로그램이 내세우는 독립성이다. 평가 기준에는 결과가 AI 제품 공급업체에 유리한지 여부와 관계없이 신뢰할 수 있는 결과를 산출할 역량이 포함되며, 출판을 권장하지만 지원 조건으로 삼지는 않는다. 둘째는 행정적인 사항이지만 중요하다. 보조금의 자금 지원과 관리는 OpenAI Foundation이 아니라 영리 법인인 OpenAI Group PBC가 맡는다. 일정에도 의미가 있다. OpenAI는 8월 31일 미성년자를 AI로부터 보호하기 위한 캘리포니아주 법안을 지지했으며, 게시물에서는 규제 기관의 의사 결정에 필요한 자료를 제공하려 한다고 밝혔다.
단신
- Boris Cherny가 다른 연구소들의 prompt injection 위험을 공개적으로 평가 — Claude Code 제작자는 OpenAI의 새 모델이 prompt injection 측면에서 Gemini Flash 및 Opus 4.8과 비슷한 수준이라고 평가했으며, 각 연구소가 보안을 더 진지하게 받아들일 때까지 공개적으로 이름을 언급하겠다는 입장을 밝혔다. 약 20분 뒤 자신의 스레드에 단 답변에서는 어조를 다소 누그러뜨렸다. 🔗 게시물
- Anthropic, Claude Managed Agents를 기반으로 제품을 구축한 창업자들의 영상 공개 — Wispr Flow, Actively, Pendo 창업자들이 outcomes, sandbox, memory를 활용해 규모를 확장하는 방법을 이야기한다. 🔗 게시물
- RelayShield, 저장소 코드 대신 지침 파일 검사 — 정적 분석으로 포착할 수 없는 자연어 악성 지침을 탐지하기 위해 AGENTS.md, CLAUDE.md, .cursorrules, mcp.json을 읽는 유료 서비스다. 게시물에서 인용한 악성 저장소 수치는 자체 출처와 일치하지 않는다. 🔗 게시물
- Ai2, ECCV 2026 참가 발표 — 학회 전반에 걸쳐 논문과 발표가 예정돼 있지만 제목이나 프로그램은 공개하지 않았다. 🔗 게시물
- Prismberry, 기업용 agent의 도구 계층에 관한 글 공개 — 정보·분석·행동 도구를 구분한 입장문으로, 발표나 측정 결과는 없으며 발행사의 Agent IQ 제품을 홍보한다. 🔗 게시물
- Hugging Face 블로그에 하드웨어 유지보수 기록 공개 — 650 W 전원공급장치 팬의 베어링 마모를 진단한 내용으로, 인공지능과 관련된 내용은 없다. 🔗 게시물
- 미주리주, 110만 명의 학생에게 Gemini for Education 제공 — 주 전역의 파트너십을 통해 약 10만 명의 교사와 110만 명 이상의 학생에게 Gemini for Education, Gemini Notebook, Google 인증 프로그램을 무료로 제공한다. 데이터는 학습에서 제외되며 도입 여부는 각 교육기관이 선택한다. 🔗 발표
- Dependabot, 개인 토큰 없이 비공개 GitHub 레지스트리 접근 — Dependabot의
GITHUB_TOKEN가packages: read권한을 요청하고 비공개 GitHub Packages 레지스트리에서 항목을 가져올 수 있다. 6월에 출시됐다가 철회된 기능으로, 이번에는 자동 자격 증명을 예비 수단으로 제한해 다시 도입됐다. 🔗 변경 기록 - GitHub 지원 포털, help.github.com으로 이전 — 지원, 문서, 학습, 커뮤니티, 계정 자료를 한곳에 통합했으며, 로그인 없이 이용할 수 있는 Copilot 기반 검색을 제공한다. 🔗 변경 기록
- Genspark, SF Tech Week 기간에 Spark House를 열고 GenTeam 사전 이용권 제공 — 참가자에게 GenTeam 사전 이용권과 창업자·투자자 간 비공개 대화 기회를 제공하는 커뮤니티 행사다. 🔗 게시물
- Ethan Tandowsky, ElevenLabs 최고재무책임자로 취임 — 9월 2일 Ashley Kramer를 최고매출책임자로 임명한 데 이어 6일 만에 이뤄진 ElevenLabs의 두 번째 경영진 인사다. 🔗 게시물
- MiniMax, 도쿄에서 일본 엔터테인먼트 업계 인사와 생성형 AI 기업 네 곳 집결 — 9월 11일 시부야에서 프로듀서 Yasushi Akimoto와 KADOKAWA, KAGAMIAI, Higgsfield, Krea, Runway, HeyGen이 참여하는 행사로, 출시 발표나 수치는 없다. 🔗 게시물
- Nemotron Labs, 같은 날 OpenShell과 Domyn 주제로 방송 두 편 공개 — OpenShell을 통한 자율 agent 보안을 다룬 49분 44초 영상과 Domyn의 Nemotron 활용을 다룬 54분 20초 영상으로, 설명문이나 자막은 없다. 🔗 게시물
- HeyGen, 도구나 모델을 밝히지 않고 같은 얼굴의 avatar 두 개 비교 — 경쟁 도구나 모델의 이름도, 측정 결과도 없는 마케팅 비교다. 🔗 게시물
- OpenAI, 저널리즘 프로그램을 언론대학원으로 확대 — 2026~2027학년도 동안 CUNY Newmark J-School과 Northwestern Medill School의 석사과정 학생 및 교직원에게 400개 이상의 ChatGPT Edu 구독을 제공한다. 🔗 발표
- Perplexity, AI 통합의 투자수익률에 관한 안내서 공개 — 제품 발표가 없는 교육용 게시물로, 모든 수치는 제3자 자료나 고객 증언에서 가져왔다. 🔗 게시물
이것이 의미하는 것
개인용 agent는 인프라 제품으로 변하고 있으며, 그 보안도 독립된 제품이 되고 있다. Meta는 Muse를 출시하는 데 그치지 않고, shell과 browser, 이메일함 접근 권한을 가진 agent를 통제하는 방법에 관해 지금까지 가장 상세한 설명을 같은 날 공개했다. 가장 시사적인 선택은 대체 토큰이다. 모델의 저항력이 향상돼서가 아니라 애초에 비밀 정보를 갖고 있지 않기 때문에 prompt injection을 통한 자격 증명 탈취를 무의미하게 만든다. tainted egress도 같은 논리를 따른다. 모델을 신뢰하는 대신 kernel을 계측한다. 30만 달러 규모의 bug bounty와 Muse가 실수를 저지를 것이라고 인정하는 솔직한 결론은 Boris Cherny가 다른 연구소들의 이러한 위험을 공개적으로 평가하며 전한 메시지와 같다. agent 보안은 더 이상 확인란 하나로 끝나는 문제가 아니라, 공개하고 비용을 지불해 공격받게 만드는 하나의 엔지니어링 영역이다.
이날은 AI 경제학에 관한 교훈도 보여준다. 이제 계산 단위는 점수가 아니라 작업당 비용이다. Mistral은 210억 유로가 넘는 기업가치로 30억 유로를, Cognition은 480억 달러의 기업가치로 20억 달러 이상을 조달했다. 두 경우 모두 기술 펀드만이 아니라 산업 기업과 고객이 투자에 참여했다. 같은 시기에 Cursor는 Muse Spark 1.3이 작업당 1.31달러로 67.9퍼센트를 기록한 반면, 순위 1위 모델은 6퍼센트포인트를 더 얻는 데 작업당 9.64달러를 지불하는 비교표를 공개했다. Anthropic은 성능 저하 없이 비용을 52~73퍼센트 줄인 사례를 문서화하면서, 낮은 effort로 실행한 더 강력한 모델이 최대 effort로 실행한 더 약한 모델을 이기는 경우가 많다는 점을 보여줬다. Sarah Friar는 가치 사슬의 반대편을 수치화했다. GPT-5.6 Sol로 자신을 제공하는 계층을 최적화해 서비스 비용을 20퍼센트 절감했다. 이는 모두 판단의 기준이 역량 자체에서 그 역량의 가격으로 이동했음을 보여주는 네 가지 방식이다.
과학 분야에서 이제 질문은 agent가 결과를 내는지가 아니라 그 결과를 어떻게 검증하느냐다. OpenAI는 약 10,000개의 agent가 88시간 동안 생성하고 Lean으로 형식화한 Navier-Stokes 특이점 증명을 발표했다. 그러나 동료 평가나 기관 차원의 검증은 언급하지 않았으며, 외부에서는 누구도 질의할 수 없는 내부 모델이 사용됐다. 밀레니엄 문제의 상금을 포기하고 이를 특정 시점의 결과로 표현한 회사의 신중한 태도 자체가 하나의 정보다. 이날 공개된 다른 두 연구는 그 대비를 잘 보여준다. MIT에서 Codex는 명확하게 정의된 프로토콜은 수행하지만 모호한 신호 앞에서는 난관에 부딪혔으며, 숙련된 연구원이 여전히 더 빨랐다. Google DeepMind의 AlphaGenome Atlas는 무언가를 증명한다고 주장하지 않고 90억 건의 예측을 미리 계산해 검증 작업의 무게중심을 실험으로 옮긴다. Oruk의 게시물은 대응 비교가 없으면 극적인 ablation도 아무것도 증명하지 못한다는 사실을 보여주며 논증을 완성한다. Multiverse Computing의 글은 정상적인 측면을 같은 엄밀함으로 측정하지 않는 한 보안 수치가 아무 의미도 없다는 점을 상기시킨다.
마지막은 성능 향상이 더 이상 weights에서 나오지 않는 저수준 계층이다. Cohere는 kernel 경계를 제거한 것만으로 동일한 품질에서 vLLM 대비 1.58배의 처리량을 내는 완전한 serving engine을 공개하고, megakernel 작성의 어려움이 과장됐다고 명시했다. NVIDIA는 Rust로 GPU kernel을 작성하는 두 가지 접근법을 공개했다. 그중 하나는 이미 외부에서 Hugging Face의 Grout inference engine과 mistral.rs에 사용되고 있으며, 어느 쪽도 production에 투입할 준비가 되지 않았다고 인정했다. AI City Challenge에서는 상위 5개 영상 솔루션 중 4개가 LoRA로 조정한 Cosmos 모델을 사용했으며, 우승팀은 이것이 새로운 아키텍처가 아니라 적응 방식이라고 강조했다. Earthmover의 기상 튜토리얼도 반대편에서 같은 이야기를 전한다. Aurora 모델은 CPU에서도 실행되며, 병목은 연산이 아니라 다운로드해야 하는 1GB 규모의 초기 조건이었다. 모든 사례에서 가치는 모델을 둘러싼 엔지니어링에 있으며, 그것이 공개되고 있다.
출처
- Muse 출시, Meta
- Muse의 agent 보안과 안전, Meta
- Mistral Series D
- X의 Series D 발표
- Navier-Stokes 문제 해결, OpenAI
- 내부 모델에 관한 OpenAI 스레드
- MIT의 Codex와 양자 컴퓨팅 실험
- ChatGPT Images 2.5, OpenAI
- Manus, GPT-Image-2.5 통합
- AlphaGenome Atlas, Google DeepMind
- CUDA Rust, NVIDIA
- ECCV 2026 AI City Challenge, NVIDIA
- Cognition Series E
- X의 Cognition 스레드
- Suno, Believe, TuneCore 파트너십
- 디코딩 megakernel, Cohere
- Claude Platform 비용 절감, Anthropic
- Claude Code 2.1.265
- agent 실시간 조종, Amp
- Cursor의 Muse Spark 1.3
- Grok Bot의 양식 작성
- Grok Imagine의 keyframe과 loop
- Earthmover를 활용한 개방형 기상 모델, Hugging Face
- 누구를 위한 보안인가, Multiverse Computing
- 초파리 connectome과 뒤섞인 배선, Oruk
- Kinetix, Runway 합류
- Sarah Friar 기고문, OpenAI
- 청소년 연구 보조금, OpenAI
- prompt injection 위험에 관한 Boris Cherny의 평가
- Claude Managed Agents를 기반으로 제품을 구축한 창업자들
- RelayShield와 지침 파일
- ECCV 2026의 Ai2
- agent의 도구 계층, Prismberry
- 하드웨어 유지보수 기록
- 미주리주의 Gemini for Education
- Dependabot과 비공개 GitHub 레지스트리
- 새로운 GitHub 지원 포털
- SF Tech Week 기간의 Spark House, Genspark
- Ethan Tandowsky, ElevenLabs 최고재무책임자
- 도쿄 MiniMax 행사
- Nemotron Labs 방송
- HeyGen avatar 비교
- OpenAI 저널리즘 프로그램
- AI 투자수익률 안내서, Perplexity