ai-powered-markdown-translator使用 gpt-5.6-sol 将文章从法语翻译成中文。
Meta 推出个人智能体 Muse,为每位用户提供一台专属的云端 Linux 机器,并于同日公布其周边安全架构,同时向所有人开放最高 30 万美元的漏洞赏金计划(bug bounty)。Mistral 宣布完成 30 亿欧元 D 轮融资,这是欧洲科技企业有史以来规模最大的股权融资。与此同时,OpenAI 发表了由智能体系统生成的 Navier-Stokes 方程有限时间奇点证明,而 Google DeepMind 则预先计算了人类 DNA 全部 90 亿种可能突变的影响。
Meta 推出个人智能体 Muse,并公布其安全架构
9 月 8 日——Meta 推出个人智能体 Muse,通过 iOS 和 Android 应用、网页界面及 WhatsApp 提供服务,由 Muse Spark 1.3 驱动。该模型并非新模型:它已于 9 月 2 日登陆 Muse Code 和 Meta Model API,其最高推理级别也于 9 月 4 日向公众开放。真正的新事物,是围绕它打造的消费级产品。
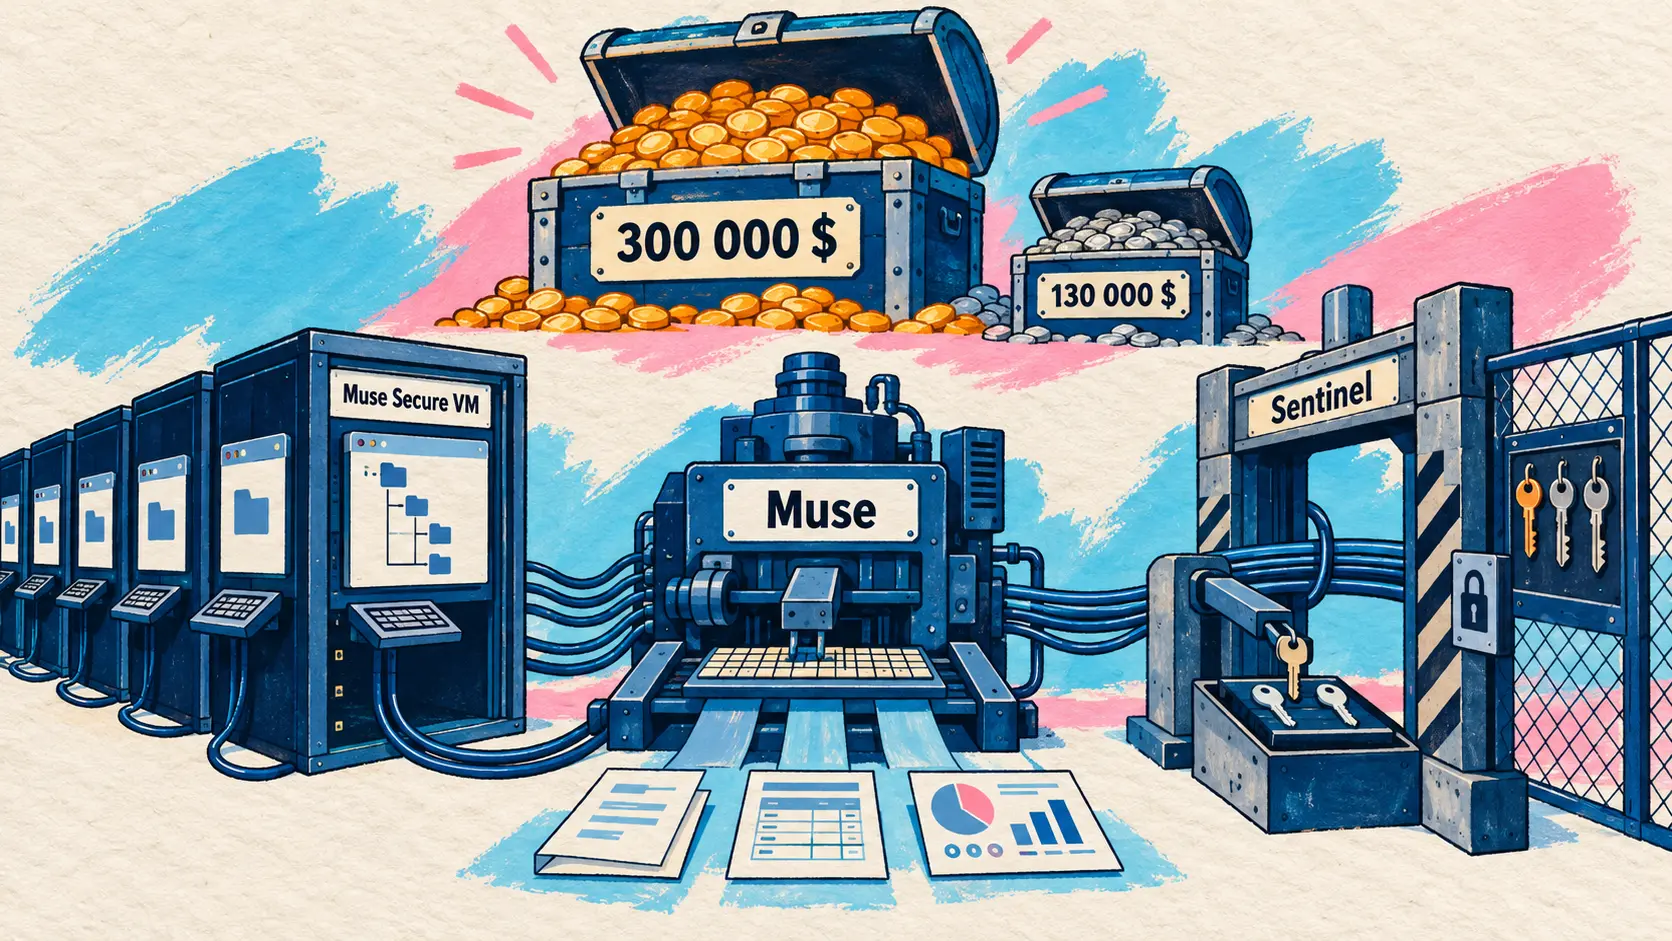
这套架构建立在一个说起来简单、实施起来却很复杂的理念之上:每位用户都会获得一台专属的云端计算机。Muse Secure VM 是一台持久化且相互隔离的 Linux 机器,配备文件系统、终端和完整浏览器,并拥有足够的存储、处理器与内存资源,可以编译代码、开发定制技能,以及并行运行子智能体。作为已连接服务的数据和凭据的基准系统,是这台机器,而不是 Meta 的集中式基础设施。当某项任务缺少所需工具时,智能体会自行编写工具;它生成的也不是文本块,而是可操作的对象,包括行程、PDF、网页和仪表板,Meta 将它们称为 Artifacts。
Meta 宣称的第二项突破是:即使应用已经关闭,智能体也能按计划或响应事件在后台工作,随后自行判断结果是否值得发送通知。记忆是持久化的,用户可以查看和修改;“目标”选项卡则集中展示智能体正在跟进的事项。不过,Meta 并未透露两项信息:目前没有公布任何定价,也没有随发布提供可用国家或地区名单。
产品公告发布二十分钟后,Meta 又公布了一份关于该系统安全性的工程文档,署名人为 Meta Superintelligence Labs 软件工程师兼副总裁 Tarek Sheasha。其指导原则开宗明义:系统在设计时就假定智能体会遭到攻击。代码中称为 Hatch 的智能体运行框架位于 systemd-nspawn 容器内,其 root 被映射到宿主机上的非特权用户,同时系统调用受到过滤,内核能力也被移除。有四项服务被特意部署在该容器之外,使攻击者即使攻陷智能体也无法将它们关闭:安全分类器、具有独立权限的 workers、凭据存储守护进程以及 Sentinel。
Sentinel 是核心组件:作为唯一有权批准连接器操作或网络出口的机构,它会在第 4 层和第 7 层评估每项请求,并核验实际解析出的地址。更关键的是,智能体只能接触替代令牌,这些令牌会在网络边界处被替换为真实凭据。由于智能体从未持有秘密,通过 prompt injection 诱使它泄露秘密也就失去了意义。此外,系统还在内核层面实施名为 tainted egress 的数据流跟踪:任何读取用户数据的进程都会被标记,并失去自动授权。该实现结合了附加到 cgroups 的 eBPF 程序,以及 Meta 新增的 Linux Security Module hooks。
| 架构组件 | 采用的方案 |
|---|---|
| 智能体运行框架容器 | systemd-nspawn,root 映射到非特权用户 |
| 授权机构 | Sentinel,位于容器外,覆盖第 4 层和第 7 层 |
| 智能体可见的凭据 | 仅限替代令牌 |
| 电子邮件连接器 | 过滤一次性验证码和重置链接 |
| 浏览器子智能体 | 使用无障碍树,不使用原始 DOM,不运行页面内 JavaScript |
| 支付 | 发布时支持 Stripe Link,之后支持 Shop Pay,使用一次性银行卡 |
| 漏洞赏金,每份有效报告的最高金额 | 300 000 美元 |
| 漏洞赏金,prompt injection | 最高 130 000 美元 |
该文档还伴随着两项公告。漏洞赏金计划自发布之日起向所有人开放,根据所证明的影响,每份有效报告最高可获 30 万美元,其中成功影响一名用户的 prompt injection 漏洞最高可获 13 万美元。Muse Confidential VM 计划于年底前推出,旨在以加密且可验证的方式阻止 Meta 访问虚拟机中的数据,其设计和源代码已经提交给外部审计机构。文章的结论在企业出版物中显得异常坦率:prompt injection 仍是整个行业尚未解决的问题,而 Muse 也会犯错。
🔗 Muse 发布公告 · 🔗 Meta 的智能体安全与保障
Mistral 完成 30 亿欧元融资,创欧洲科技企业股权融资规模之最
9 月 8 日——Mistral 宣布完成 30 亿欧元 D 轮融资,投后估值超过 210 亿欧元。该公司称,这是欧洲科技企业有史以来完成的最大规模股权融资,而距离公司成立仅过去三年。
本轮融资由 Samsung Electronics 领投。由 EQT 管理的 Scaleup Europe Fund 与现有股东 PSG Equity 共同领投。另有三家新投资方加入:Advent、由 BlackRock 管理的基金和账户,以及卢森堡大公国。现有投资方名单很长,遍及三大洲,包括 a16z、Salesforce Ventures、ASML、BNP Paribas CIB、Bpifrance、DST Global、General Catalyst、Index Ventures、Korelya Capital、Lightspeed 和 NVIDIA。
值得关注的是,连续两轮融资的领投方性质不同寻常。ASML 曾领投 C 轮,Samsung Electronics 则领投 D 轮:二者都是先进制造业企业,而非综合性科技投资基金。Mistral 认为,这表明投资方相信它有能力在复杂工业环境内部部署前沿模型;在这些环境中,对数据和基础设施的掌控决定了技术能否被采用。
| 指标 | 数值 |
|---|---|
| 融资金额 | 30 亿欧元 |
| 投后估值 | 超过 210 亿欧元 |
| 公司成立时间 | 3 年 |
| 领投方 | Samsung Electronics |
| 共同领投方 | 由 EQT 管理的 Scaleup Europe Fund、PSG Equity |
| 开展业务的国家数量 | 20 |
| 大型企业客户 | 超过 125 家,包括 Airbus、ASML 和 HSBC |
关于资金用途,该公司首先提到前沿研究,其次是扩大训练算力、扩充基础设施,以及加快国际商业拓展。其论述延续了自夏季以来一直坚持的立场:组织如今面临的问题已不再是谁能构建最强大的模型,而是如何在不交出基础设施控制权的前提下利用 AI。Mistral 称自己是该行业唯一能够组装完整所需技术栈的企业,从开放权重模型、算力一直覆盖到产品。
Today marks a major step for Mistral: we’re announcing a €3B Series D, the largest equity round ever raised by a European tech company, just three years after launch.
🇨🇳 今天标志着 Mistral 的一个重大里程碑:我们宣布完成 30 亿欧元 D 轮融资,这是欧洲科技企业有史以来规模最大的股权融资,而此时距离我们成立仅仅三年。 — @MistralAI 在 X 上
OpenAI 科学智能体:Navier-Stokes 证明与 MIT 的 qubits 校准
9 月 8 日——OpenAI 发表了三维 Navier-Stokes 方程有限时间奇点形成证明,并附有在证明助手 Lean 中完成的形式化版本。公布的结果是:一种初始时光滑且静止、受到光滑外力作用的三维流体,其速度可能在有限时间内无界增长,尽管黏性倾向于让运动变得平滑,而且系统能量仍保持有限。按照 Clay Mathematics Institute 的正式表述,这对应于命题“C”和“D”,即构成反例的命题,而非正则性证明。
OpenAI 声称了什么、又没有声称什么,值得准确说明。该证明由一个协调式智能体系统生成,其基础是一个尚未公开名称的内部模型。公司称,该模型的能力显著超过 GPT-6 Astra,并且自 8 月 28 日以来仍在持续训练。唯一被描述的验证方式,是将证明交由 GPT-6 Astra 在 Lean 中形式化,并于解题完成后用 17 小时完成。公告没有提及任何同行评审,也没有提及 Clay Mathematics Institute 的验证;OpenAI 还表示无意申领千禧年大奖,并将这一结果描述为阶段性快照,而非最终成果。
其方法至少与结果本身同样引人注目。这项工作于 9 月 1 日启动,起因是有传言称两个千禧年难题刚刚被解决。不同的智能体群组分别获得了题目的不同版本:“A”和“B”版本引导其寻找证明,“C”和“D”版本则引导其寻找反例。在一个附带问题——无外力 Euler 方程的正则性问题——上,近 100 个智能体用约五十小时构造出一个反例;该结果随后被重新注入处理 Navier-Stokes 问题的智能体 prompts 中。
| 指标 | 数值 |
|---|---|
| Navier-Stokes 群组的并发智能体数量 | 约 10 000 |
| 得出解答所用时间 | 约 88 小时 |
| 在 Lean 中形式化并验证 | 另需 17 小时,通过 GPT-6 Astra 完成 |
| Navier-Stokes 任务交换的消息数量 | 270 万 |
| Navier-Stokes 任务的输出 tokens | 约 1 300 亿 |
| 尝试解决的全部问题交换的消息数量 | 490 万 |
| 尝试解决的全部问题的输出 tokens | 约 3 000 亿 |
| 无外力 Euler 方程正则性的反例 | 近 100 个智能体,约 50 小时 |
另一项同期研究让情况变得更加复杂。Anthropic 员工 Levent Alpöge 与 NYU 数学教授 Tristan Buckmaster 已经得出了关于受外力 Euler 方程的结果。OpenAI 在项目完成并得到验证后,于 9 月 6 日联系二人,提议联合发表并承认他们的优先权,随后才发现二人的结果针对的是另一个不同命题。
This model represents a step-function improvement on many benchmarks, and its training is ongoing. Our internal model group arrived at the Navier–Stokes solution in 88 hours, using around 10,000 coordinating AI agents. Throughout the effort, we maintained the strict safeguards—including monitoring and isolation—that we apply to all our frontier evaluations.
🇨🇳 这一模型在众多 benchmarks 上实现了阶跃式提升,并且仍在持续训练。我们的内部模型群组在 88 小时内得出了 Navier-Stokes 问题的解答,参与协作的 AI 智能体约有 10 000 个。在整个过程中,我们始终维持严格的防护措施,包括监控与隔离;这些措施适用于我们对所有前沿模型开展的评估。 — @OpenAI 在 X 上
同一天,OpenAI 还发布了一项规模小得多、但也更容易验证的案例研究。MIT Engineering Quantum Systems 小组的博士生 Beatriz Yankelevich,将由 GPT-5.6 Sol 驱动的 Codex 接入协调其实验的软件,用于校准一块尚未校准、包含六个超导 qubits 的芯片。智能体获得了针对每种测量类型的专用 skills,其中说明了如何执行测量以及如何评估结果。面对清晰信号时,Codex 只需很少干预便完成了整套流程:识别跃迁频率、校准控制与读出脉冲,以及测量量子信息的保存时长。面对微弱或含噪信号时,它需要更长时间才能找到可用参数,有时还需要经验丰富的研究人员介入判断,而研究人员的速度仍然快于模型。因此,收益不在于速度,而在于无需持续监督:完成一块此类标准芯片的表征通常要耗费研究人员数天时间,该小组现在已将常规测量交由智能体执行。
🔗 OpenAI 的 Navier-Stokes 解答 · 🔗 OpenAI:Codex 与量子实验
ChatGPT Images 2.5,新增 Sketch,并在 API 中推出两款图像模型
9 月 8 日 — OpenAI 在旗下产品和 API 中推出 ChatGPT Images 2.5。开篇公布的使用数据表明了其重要性:ChatGPT Images 和 API 的 GPT-Image 模型每周生成超过 30 亿张图像。最直观的提升是延迟,相比 Images 2.0 最多降低 50%;其他改进则集中在对参考照片的忠实度,以及长对话中的一致性,先前的修改能够得到更好的保留。
ChatGPT 端新增三项功能。Sketch 允许用户输入“@Sketch”,直接在对话中绘图并将其用作视觉指引。模板覆盖海报、周边商品等常见格式。用户还可在图像上添加评论,以指定需要修改的区域。现在分享图像时也可以附带生成该图像的提示词。此次更新面向所有 ChatGPT、ChatGPT Work 和 Codex 用户,覆盖桌面端、移动端和网页端的全部套餐层级。
| API 中的模型 | 官方定位 | 延迟 |
|---|---|---|
| GPT-Image-2.5 Flare | 默认选择、社交内容、批量生成 | 比 Images 2.0 最多降低 50% |
| GPT-Image-2.5 Sunburst | 高精度、可直接投放的营销活动素材 | 生成时间更长 |
两款模型均支持新的质量设置 xhigh 和 max,并沿用 GPT Image 2 的 token 定价:Standard 层级中,每百万图像输入 token 为 8.00 美元,图像输出 token 为 30.00 美元,文本输入 token 为 5.00 美元。C2PA 元数据和不可见水印得以保留,同时发布了配套的 system card。
Manus 当天即完成模型集成
Manus 在公告发布当晚将 GPT-Image-2.5 加入其平台,并引用了 OpenAI 在一个半小时前发布的消息。这家于 9 月 1 日恢复独立的智能体实验室给出了一项源自自身评测、而非 OpenAI 评测的数据:其称为 Flare 的模型能够以 GPT-Image-2 两到四倍的速度生成高质量图像。对于在对话过程中持续生成视觉内容的智能体而言,这一速度提升比边际性的质量改进更为重要,因为它决定了图像生成能否留在工作流中顺畅进行,还是会迫使用户等待。Manus 还强调了透明背景生成能力的改善,从而免去会打断全流程自动化的手动抠图步骤。
🔗 Manus 集成
AlphaGenome Atlas:覆盖人类 DNA 90 亿种突变的预测图谱
9 月 8 日 — Google DeepMind 推出 AlphaGenome Atlas,这是一个用于预测人类 DNA 中每一种可能的单字母突变所产生分子效应的数据库。人类基因组约有 30 亿个碱基对,其中只有 2% 用于编码蛋白质;其余 98% 在很大程度上仍未被探索,而其中仅一个字母的变化就可能使关键的生物调控元件失效。
其方法的核心是反转计算负担。Google DeepMind 不再让各实验室逐个变异查询模型,而是预先计算了 AlphaGenome 模型对全部 90 亿种可能替换的预测。最终形成的数据集大小为 1 PB,据称超过 AlphaFold Database 的 30 倍。为了让如此庞大的数据量可供实际使用,Atlas 引入了 AVI 分数(AlphaGenome Variant Impact):这一单一数值汇总了对编码区和非编码区的预测,并通过逐特征归因指出某个变异会扰乱哪些生物过程。此外,它还提供了一个包含 2,500 多种重复序列基序的目录;Google 将这些调控单元描述为基因组的“词语”。
| 指标 | 数值 |
|---|---|
| 预计算变异 | 90 亿种,涵盖所有单字母变化 |
| 数据集大小 | 1 PB,超过 AlphaFold Database 的 30 倍 |
| 已编目序列基序 | 超过 2,500 种 |
| 已分析的 UK Biobank 参与者 | 超过 54,000 人 |
| 新增非编码关联 | 增加 22% |
| 已识别的 BMI 相关基因区域 | 19 |
两个已有记录的应用案例体现了这一进展的价值。在 Broad Institute,Laura Covill 及其团队使用 AVI 分数对尚未确诊的罕见病候选变异进行优先级排序:该工具重点标出了 DNM1 基因的一个变异,并预测它会产生错误的剪接位点,从而提供了解决该病例的决定性线索。在 University of Exeter,Gareth Hawkes 将 Atlas 应用于超过 54,000 名 UK Biobank 参与者的数据,额外发现了 22% 的非编码遗传关联;随后,他仅考察影响最大的 1% 变异,识别出了 19 个与身体质量指数相关的基因区域。
访问方式是另一个值得关注之处。Atlas 可通过无需编写代码的网页门户使用,面向不会编程的临床医生和生物学家;也可通过 AlphaGenome API、Cloud 上的 Model Garden 使用,研究数据则发布在 GitHub 上。对于关注 Google 智能体生态系统的开发者,还有一个值得注意的细节:Atlas 也以技能(skill)形式发布在 Google Antigravity 中,因此编码智能体可以直接调用它。
🔗 AlphaGenome Atlas,Google DeepMind
NVIDIA 推出 CUDA Rust,Cosmos 横扫 ECCV AI City Challenge
9 月 8 日 — NVIDIA 发布 CUDA Rust,以填补一个日益明显的空白:AI 的系统层越来越多地使用 Rust 编写,但 GPU kernel 一直是例外。此前虽可从 Rust 启动 kernel,却必须使用其他语言编写。CUDA Rust 弥合了这一差距,通过两条不同路径将 Rust kernel 原生编译为 PTX,分别对应 CUDA 已在 C++ 和 Python 中提供的两种编程模型。
| 项目 | cuda-oxide,SIMT 路径 | cutile-rs,Tile 路径 |
|---|---|---|
| 成熟度 | 早期 alpha | 已发布至 crates.io |
| 所需 Rust 工具链 | 固定版本的 nightly(nightly-2026-04-03) | stable 1.89 或更高版本 |
| CUDA 版本 | 12.x 或更高版本 | 13.3 |
| 是否需要自行提供 LLVM | 是,另需 clang 和 libclang | 否 |
| 编译方式 | 构建时编译为 PTX | 通过 CUDA Tile IR 进行 JIT |
| 提及的外部应用 | 无 | Hugging Face 的 Grout、mistral.rs |
NVIDIA 的建议十分明确:从 Tile 开始,因为这种方式的源代码不会固化任何特定于架构的选择;当需要精细控制线程和内存时,再转向 SIMT。如今这一取舍仍有代价,因为在 SIMT 中,作为高性能 kernel 基础的共享内存仍然需要 unsafe。其核心优势在于编译期内存安全:两条路径都会拒绝将同一缓冲区同时用作输入和输出的典型别名行为,SIMT 端通过 error[E0502] 实现,Tile 端则通过 error[E0382] 实现。在成熟度方面,NVIDIA 并未夸大其词:两个项目都尚未达到生产就绪状态,公开承诺的投入将延续至 2027 年及以后,并会与 rust-cuda 的维护者共同推进。
同日,NVIDIA 公布了 ECCV 2026 AI City Challenge 的获奖结果。在专注于交通场景生成式视频预测的赛道 5 中,排名前五的方案有四个采用了不同版本的 Cosmos 世界基础模型。Qyn 团队凭借 CosmosAlign 夺得公开排行榜第一名:该方案通过两阶段 LoRA 方法适配冻结的 160 亿参数 Cosmos3-Nano 模型,生成四种预测,选取其中的中心样本,并重新注入已观察历史中的稳定区域;最终得分为 76.39,高于 SSUPER 团队的 76.04,领先 0.35 分。NVIDIA 特别说明,这是一套适配与推理方案,而非新的架构。Cosmos 也以评审者身份出现:在赛道 3 的两个域外排行榜中,UWIPL_ETRI 团队凭借 UniTraffic 夺冠;该方案让一个独立的 Cosmos-Reason1 验证器核查存在争议的断言。
🔗 CUDA Rust,NVIDIA · 🔗 AI City Challenge 获奖结果
Cognition 融资超过 20 亿美元,估值达到 480 亿美元
9 月 8 日 — 开发智能体 Devin 的公司 Cognition 宣布完成超过 20 亿美元融资,估值达到 480 亿美元。本轮融资由两家新投资方 Andreessen Horowitz 和 Accel 领投,现有投资方 Founders Fund、General Catalyst 和 Avenir 共同参与。另有约 30 家投资方加入,其中包括 NVIDIA、Benchmark、Bessemer、Kleiner Perkins、Greylock、Lightspeed、T. Rowe Price 和 Bain Capital Ventures。
| 指标 | 2026 年 5 月 | 2026 年 9 月 |
|---|---|---|
| 本轮累计融资额 | 超过 10 亿美元 | 超过 20 亿美元 |
| 估值 | 260 亿美元 | 480 亿美元 |
| 年化营收 | 4.92 亿美元 | 接近 9 亿美元 |
| 领投方 | Lux Capital、General Catalyst、8VC | Andreessen Horowitz、Accel |
因此,其估值在四个月内接近翻倍,并在一年内增长至近五倍,年化营收也呈现相同的增长趋势。Cognition 详细介绍了推动这一增长的应用场景:Devin 参与 NVIDIA 的芯片设计、GE Aerospace 的航空业务、Citi 的金融服务、Mercedes-Benz 的汽车业务,以及 Modal 的 AI 基础设施工作。NVIDIA 同时既是客户又是本轮投资方,这体现了这些企业如何确保自己能够持续使用其内部采用的工具。近期推出的三项能力正在推动 Devin 从执行任务迈向自主行动:Auto-Triage 用于事故调查的首轮处理,Security Swarm 用于漏洞分流,以及由 Slack、GitHub 或 Linear 事件触发的 Automations。Cognition 一年内新设了六个办公室,其中五个位于美国以外,此外还有 San Francisco、New York 和 Austin 的办公中心。
In the next chapter of software engineering, agents will become proactive by default, software will improve itself, and compute will automatically get allocated toward the highest impact use cases. We’re still at the dawn of the self-driving software era.
🇨🇳 在软件工程的下一个篇章中,智能体将在默认状态下主动行动,软件将实现自我改进,算力也会自动分配至影响最大的应用场景。我们仍处于自主软件时代的黎明。 — @cognition 在 X 上
Suno 与此前拒绝发行其音乐的 Believe 和 TuneCore 达成合作
9 月 8 日 — Suno 宣布与艺人发展公司 Believe 及其自主发行平台 TuneCore 建立全球战略合作伙伴关系。协议涵盖两项不同内容。首先,Believe 将参与 Suno 与音乐行业共同开发的新音乐模型的设计。其次,也是对用户而言最实际的一点,使用这一全新合作模型创作的曲目将有资格通过 Believe 和 TuneCore 发行,从而进入 Spotify、Apple Music、Amazon Music 和 YouTube。
这项公告的背景凸显了其意义。Suno 直言不讳地指出,今年早些时候,Believe 和 TuneCore 曾宣布不会发行由不符合其标准的模型生成的音乐,其中也包括当时的 Suno 模型。此次转变被描述为双方讨论的成果;这些讨论揭示了共同价值观,即为艺人提供真正的选择,并开辟发行和创收渠道。
这项协议延续了一系列方向一致的举措。它拓展了 Suno 面向独立及新兴艺人的 Spark 计划,也在现有的 Warner Music Group 和 BMG 协议基础上,将独立厂牌和自主制作音乐的艺人纳入其中。Suno 还明确将其与近期推出的保障措施联系起来:通过音频水印和声学指纹识别平台之外的 Suno 曲目,以及自 9 月 3 日起实施的下载限制,以防止音乐被大规模上传至流媒体服务。这些保护措施同样适用于通过 Believe 和 TuneCore 发行的音乐。公告最后给出了时间安排:Suno 表示将很快推出其新模型,这一模型系列已于 9 月 4 日被命名为 v6。
Cohere 开源围绕 megakernel 构建的推理服务引擎,速度比 vLLM 快 1.58 倍
9 月 8 日 — Cohere 发布了一款完全围绕解码 megakernel 构建、采用 Apache 2.0 许可证的推理服务引擎。该公司声称实现了一项首创:这并非实验室中的速度演示,而是一台能够通过兼容 OpenAI 的端点处理真实请求的完整服务器,支持连续批处理、分页注意力、前缀缓存和工具调用。其提供服务的模型为 North Mini Code,这是一个拥有 300 亿参数的混合专家模型,但每个 token 仅激活 33 亿参数。
它要解决的问题可以概括为一句话:在解码期间,GPU 花在等待上的时间远多于计算。传统技术栈会为每项操作启动一个 kernel,而每个 kernel 边界都会在整个计算网格上施加一道屏障。自回归解码则受限于内存带宽:在每一步中,North Mini Code 都要从 HBM 内存传输 6.6 GB 权重,并在 8K 上下文下额外传输约 0.5 GB 键值缓存,因此在 H100 的 3.35 TB/s 带宽上,其理论上限约为每秒 470 个 token。megakernel 通过启动一个在整个解码步骤中持续驻留的单一持久化 kernel 来消除这些边界,并将依赖关系缩减为全局内存中的计数器。
| 指标 | Megakernel | vLLM v0.24 | 提升 |
|---|---|---|---|
| 解码,批量大小 1,上下文 8K(tok/s) | 292 | 185 | 1.58x |
| AIME 2025,端到端(tok/s) | 935 | 661 | 1.41x |
| SciCode,端到端(tok/s) | 711 | 560 | 1.37x |
| MMLU-Pro,计算机科学子集(tok/s) | 948 | 713 | 1.33x |
| LiveCodeBench v6,端到端(tok/s) | 803 | 625 | 1.28x |
| GPQA,端到端(tok/s) | 787 | 631 | 1.25x |
批量大小为 1 时,每秒 292 个 token 相当于理论上限的 62%,而 vLLM 为 39%。质量没有变化:SciCode 上为 38.9% 对 38.2%,LiveCodeBench v6 上双方均为 70.3%,结果均取七次运行的平均值。有一个细节值得关注:领先幅度取决于专家分布,在模型的真实路由下为 1.32x,而在模拟均匀路由下为 1.14x,这使得均匀测量成为不利情形。Cohere 最后还强调了一个反直觉的观点:编写 megakernel 可能没有传闻中那么困难,只需一个 CUDA 文件,其中十六个操作码即可覆盖整个解码步骤。其局限性也得到明确承认,并被归类为实现层面的限制:仅支持解码,预填充仍通过普通 PyTorch kernel 运行;仅支持 H100 和 BF16;批量大小为 1 至 8。
Anthropic 说明如何在不损失性能的情况下降低 Claude Platform 成本
9 月 8 日 — Anthropic 发布了一份工程指南,反驳了降低智能体成本就必须接受更差结果这一普遍看法。指南介绍了三个手段:最大化提示词缓存命中率、迁移到前沿模型时移除提示词中的反模式,以及根据任务校准推理强度。该方法以可在 Claude Code 中执行的命令形式提供,其中 /claude-api prompt-audit 和 /claude-api hillclimb 加入了 /claude-api cost-optimize。
| 基准测试,以 Sonnet 5 为基线 | 成本降幅 | 测量详情 |
|---|---|---|
| LegalBench | 约 58% | 推理 token 从 102 779 降至 8 284 |
| tau2-bench retail | 约 73% | 使用显式断点的提示词缓存 |
| OfficeQA Pro | 约 52% | 从 136.20 美元降至 64.87 美元 |
| SWE-bench Verified | 约 55% | 中位步骤数从 29 降至 17,提示词 token 减少一半以上 |
最具可操作性的数字并未出现在这张表中。在 CursorBench 3.2 上,采用 low 推理强度的 Claude Fable 5.1 与采用 high 推理强度的 Fable 5 表现相当,但成本仅为后者的三分之一,其中一部分得益于缓存读取价格:每百万 token 收费 0.25 美元,此前为 1.00 美元。相反,在不使用工具的 Humanity’s Last Exam 上,最高一级推理强度以增加 46% 的成本换来约半个百分点的提升,而这一增益淹没在基准测试的噪声之中。
Claude Code 2.1.265:插件目录、1 GB 上限与提示词缓存修复
9 月 8 日 — Claude Code 升级至 2.1.265,更新日志包含五十项内容,其中三十四项为修复;而两天前发布的 2.1.263 仅包含一项。--plugin-dir 选项现在可接受整个插件目录,凡带有清单文件的子目录都会被加载,运行期间发生的添加和删除也会被检测到。写入磁盘的工具结果设有 1 GB 上限,预览中会提示文件已被截断。
最密集的更新集中在提示词缓存上,与同日发布的指南相呼应。两项不同的修复解决了 Claude Code 自身破坏缓存复用的情况:恢复此前在前台启动的子智能体时,会改变其工具列表和系统提示词前缀;恢复智能体队友和子智能体时,则会将 SubagentStart hook 的上下文以及预加载的 skills 移出前缀。另有两项修复涉及安全问题:包含反斜杠的插件路径可在 macOS 和 Linux 上绕过符号链接的目录边界检查;在 Windows 上,读取和写入工具会拒绝访问 AppContainer 或受限 token 沙箱中的所有文件。读取由第三方写入的 artifact 现被视为处理不可信内容。
Amp 以实时引导取代消息队列
9 月 8 日 — Amp 改变了其智能体处理工作期间所发消息的默认行为。此前,当智能体正在运行时,用户输入的消息会进入队列,直到当前轮次结束后才会处理;现在,消息会在第一个可用时机送达。开发商提出了两项好处:智能体能够更早考虑反馈,也会停止执行因新指令而变得多余的验证步骤;在用户发现智能体走错方向这一常见场景中,这可以节省时间和 token。
这一变化并非没有副作用,Amp 也对此作了说明。如果实时引导显得过于突兀,开发商建议使用“完成后,再……”而非“现在,……”来表述请求,以明确表示该指令应在当前任务结束后执行。Ship、Review 和其他内置操作仍保留原有行为并继续进入队列,因为通常需要先完成工作,然后再交付或发起审查。应用程序和 CLI 中仍可手动将消息加入队列。
Muse Spark 1.3 登陆 Cursor,拥有 CursorBench 最佳得分成本比
9 月 8 日 — 在 Muse Spark 1.3 发布六天后,Cursor 加入了这款由 Meta Superintelligence Labs 推出的智能体模型。公布的数据所展现的并非绝对性能,而是成本优势。在 CursorBench 3.2 这一基于真实多文件任务构建的内部基准测试中,Max 档位取得 67.9% 的得分,每项任务成本为 1.31 美元,排名第十二。
| 模型与档位 | CursorBench 3.2 得分 | 每项任务成本(美元) | 每项任务 token 数 | 排名 |
|---|---|---|---|---|
| Fable 5.1 Max | 73.4% | 9.64 | 72 060 | 1 |
| Grok 4.6 Extra High | 70.8% | 2.81 | 41 136 | 3 |
| Opus 5 Max | 70.0% | 8.23 | 61 838 | 5 |
| Gemini 3.8 Flash High | 69.2% | 2.38 | 81 524 | 9 |
| Muse Spark 1.3 Max | 67.9% | 1.31 | 33 034 | 12 |
| GPT-5.6 Sol Max | 67.2% | 5.69 | 28 320 | 13 |
| Muse Spark 1.3 Low | 55.0% | 0.45 | 12 181 | 49 |
因此,Meta 的模型在得分上远落后于 Claude Fable 5.1 Max,但后者每项任务的成本高出七倍以上。更重要的是,它在 Max 档位上领先 GPT-5.6 Sol,而成本低了四倍以上。Cursor 延续了自己的做法:系统性地公布每个新增模型的得分和每项任务成本,而不只是简单宣布模型可用。
Grok Bot 可直接在聊天中填写表单和凭据,Grok Imagine 获得关键帧控制
9 月 8 日 — SpaceXAI 现在允许用户在不离开对话的情况下,为 Grok Bot 填写表单和登录页面,并宣称支持任何密码管理器。这项功能解决了持久型智能体特有的一个摩擦点:一旦智能体需要通过登录界面或提交包含个人信息的表单,它就必须使用已存储的凭据,或者要求用户介入。将这一环节置于对话线程中,而非单独的浏览器会话中,既是用户体验上的选择,也是安全层面的选择。
两小时后,Grok Imagine 获得了对视频场景起始与结束图像的控制能力,以及生成无缝循环视频的能力,同时宣称指令遵循能力和视频质量均有所提升。关键帧控制改变了该工具对于连续镜头创作者的意义:固定一个镜头的最后一帧后,即可将其复用为下一个镜头的第一帧,从而串联起连续性不再依赖生成随机性的序列。此项公告发布于 Grok Imagine Video 1.5 智能体上线三天后,后者由 Image 2.0 模型驱动。
🔗 在 Grok Bot 中填写表单 · 🔗 Grok Imagine 中的关键帧
Hugging Face 博客上的三篇研究文章
9 月 8 日 — Hugging Face 社区同日发布的三篇文章值得一读,主题分别涉及天气、模型安全和仿生模型。
无需 GPU 运行开放天气模型
Hugging Face 与 Earthmover 联合发布了一篇文章,讨论一个鲜少受到关注的问题:机器学习天气模型足够轻量,能够在笔记本电脑上运行,但几乎没有人真正运行它们。文章指出了三个障碍:计算能力——包括 AIFS 在内的多个模型依赖 flash attention,而后者仅限于某些显卡架构;存储;以及最重要的带宽——每次预报的初始条件数据约为 1 GB。解决方案由三项公开资源组成:一个演示 Space、一个存储 bucket,以及一个可复现的教程。该教程运行 Microsoft 的 Aurora 模型,使用分辨率为 0.25 度的预训练版本,初始条件采用由 Earthmover 数据市场提供的 ERA5 数据。整个过程不需要 GPU:在 CPU 上,每个计算步骤耗时两至三分钟;在显卡上则仅需几秒;执行四个六小时步骤即可生成二十四小时预报,随后再与 ERA5 进行比较。
一个号称更安全、却拒绝四分之三无害问题的模型
Multiverse Computing 发布了一项值得在对齐研究领域之外广泛传播的结果。团队训练 Qwen3-8B 拒绝政治操纵请求后,获得了一组看似大获全胜的数据:在 HarmBench、StrongREJECT 和 WildJailbreak 上,危险回答的平均比例从 26.26% 降至 0.14%。但在同一检查点上,XSTest 的过度拒绝率从 2.00% 升至 74.00%。换句话说,纸面上最安全的配置实际上是一台拒答机器,而常规指标完全无法揭示这一点。两项修正发挥了作用:用目标模型经过验证的回答替换外部合规回答,可将 XSTest 过度拒绝率从 15.20% 降至 5.20%;加入良性边界样本对后,应当回答一侧的过度拒绝率从 32.94% 降至 4.16%,而有害一侧的拒绝率仅下降四个百分点。
果蝇 connectome 未能胜过其自身的随机重连结构
Oruk 发布了一则方法论教训,其意义不限于受 connectome 启发的模型。团队从果蝇公开的 MaleCNS 重建数据中复制了 499 个高度互联的神经元,将其置入一个充当 reservoir 的循环网络,并仅在其上训练一个 ridge 读出层。果蝇原始连接结构的平均测试准确率为 16.84%,随机重连结构则为 16.88%;两者相差负 0.04 个百分点,置信区间跨越零。第二项实验本可能被视为相反证据,因为移除读出权重范数最大的 50 个神经元后,准确率从 16.91% 降至 10.83%。作者解释了为何这并不矛盾:一次效果显著的消融实验绝不能证明某种生物拓扑结构不可或缺。值得说明的是,文章自行注明由 AI 智能体根据一篇未经同行评审的论文整理而成,完整评估数据集仍未公开。
Runway 招募巴黎实验室 Kinetix 团队
9 月 8 日 — Runway 宣布,总部位于巴黎的 AI 研究实验室 Kinetix 团队将加入该公司。该实验室此前从事 3D 人体运动和基于物理约束的视频生成研究,Runway 将这两个主题直接关联到其面向机器人技术的世界模型研究。该团队将并入公司的巴黎部门,而 Runway 也正在当地招聘研究和工程人员。
公告中的一句话概括了其技术论点:真正有用的机器人必须理解并应对前所未见的环境、任务和情境,而 Runway 认为,大规模视频预训练是解决这些泛化问题最有效的途径。这是 Solaris 和 GWM Worlds 2 的直接延续:前者于 8 月 31 日发布,后者于 9 月 3 日发布;在教会模型模拟世界之后,Runway 希望进一步教会它们在世界中行动。Kinetix 首席执行官 Yassine Tahi 表示,实验室在六年前创立时就押注于此。公告没有披露交易金额或具体结构。
Sarah Friar 量化 OpenAI 的规模及其模型对成本的影响
9 月 8 日 — Sarah Friar 发表文章,介绍 OpenAI 如何将研究进展转化为经济活动。这篇文章的看点不在其论述,而在于三个此前未披露的数据。
| 指标 | 数值 |
|---|---|
| 每周活跃用户 | 超过 10 亿 |
| 企业客户 | 250 万 |
| 使用六个月时的每日消息量,个人套餐 | 比首月高约 50% |
| 使用六个月时尝试的不同任务数量 | 约为两倍 |
| 优化后的端到端服务成本 | 降低 20% |
| token 生成效率 | 提升超过 15% |
第三个数据形成了一个颇有意思的闭环。GPT-5.6 Sol 被用于改进 OpenAI 的生产服务软件,由此将服务成本降低了 20%,同时还使 token 生成效率提升了超过 15%。换言之,该模型通过优化为其提供服务的软件层,为自身的部分基础设施提供资金支持。此外,个人用户的使用轨迹也回答了一个经常被问到却鲜有数据佐证的问题:留存率。
OpenAI 投入 500 万美元支持青少年相关独立研究
9 月 8 日 — OpenAI 启动一项总额 500 万美元的资助计划,用于支持针对生成式 AI 对 13 至 17 岁青少年影响的独立研究,并明确聚焦社会与情感发展。每个项目最高可获 100 万美元资助。申请将于 2026 年 10 月 6 日截止,入选项目最迟于 2026 年 11 月 13 日收到通知,项目须在 2027 年第一季度提交阶段性进展,每笔资助的管理费用上限为 10%。
有两个细节值得注意。首先是其宣称的独立性:评审标准之一,是项目能否产出可靠的结果,无论这些结果是否有利于 AI 产品供应商;同时鼓励发表成果,但发表并非获得资助的必要条件。第二点属于行政安排,却同样重要:这些资助由商业实体 OpenAI Group PBC 出资并管理,而非 OpenAI Foundation。时间安排也并非无关紧要:OpenAI 曾于 8 月 31 日支持加利福尼亚州有关保护未成年人免受 AI 风险影响的法案,而文章也表示希望为监管机构的决策提供依据。
🔗 青少年研究资助
简讯
- Boris Cherny 公开评估其他实验室的 prompt injection 风险 — Claude Code 的创建者认为,OpenAI 新模型在 prompt injection 方面与 Gemini Flash 和 Opus 4.8 处于同一水平,并表示只要各实验室仍不更加严肃地对待安全问题,他就会继续公开点名。大约二十分钟后,他在回复自己的帖子时缓和了语气。🔗 帖子
- Anthropic 发布创始人使用 Claude Managed Agents 构建产品的视频 — 对 Wispr Flow、Actively 和 Pendo 创始人的访谈,讨论如何利用结果、sandbox 和 memory 实现规模化。🔗 帖子
- RelayShield 扫描指令文件而非代码仓库中的代码 — 一项付费服务,可读取 AGENTS.md、CLAUDE.md、.cursorrules 和 mcp.json,以检测静态分析无法发现的自然语言恶意指令。文章引用的恶意仓库数量与其自身来源不符。🔗 文章
- Ai2 宣布将参加 ECCV 2026 — 论文与演讲分布在整场会议期间,但尚未公布标题或日程。🔗 帖子
- Prismberry 发布有关企业 agent 工具层的文章 — 一篇定位文章,将工具分为信息、分析和操作三类,未公布任何新消息或指标,并推广其发行商的 Agent IQ 产品。🔗 文章
- Hugging Face 博客发布硬件维护记录 — 诊断一台 650 W 电源风扇的轴承磨损问题,不含任何与人工智能相关的内容。🔗 文章
- 密苏里州向 110 万名学生开放 Gemini for Education — 这项全州合作为近 10 万名教师和超过 110 万名学生免费提供 Gemini for Education、Gemini Notebook 和 Google 认证,其数据不会用于训练,各院校可自行决定是否采用。🔗 公告
- Dependabot 无需个人 token 即可读取 GitHub 私有 registry — Dependabot 的
GITHUB_TOKEN可以申请packages: read权限,并从私有 GitHub Packages registry 拉取内容。该功能在 6 月上线后被撤回,如今再次推出,并将自动凭据降为备用方案。🔗 更新日志 - GitHub 支持门户迁移至 help.github.com — 支持、文档、学习、社区和账户资源汇集于一处,并提供由 Copilot 驱动且无需登录的搜索功能。🔗 更新日志
- Genspark 在 SF Tech Week 期间开放 Spark House,并提供 GenTeam 抢先体验 — 一项社区活动,参与者可抢先体验 GenTeam,并参加创始人与投资者之间的非公开交流。🔗 帖子
- Ethan Tandowsky 出任 ElevenLabs 首席财务官 — 这是 ElevenLabs 六天内第二次任命高管,此前 Ashley Kramer 已于 9 月 2 日出任首席营收官。🔗 帖子
- MiniMax 在东京汇聚日本娱乐界代表与四家生成式 AI 企业 — 活动将于 9 月 11 日在涩谷举行,参与者包括制作人 Yasushi Akimoto、KADOKAWA、KAGAMIAI、Higgsfield、Krea、Runway 和 HeyGen,但没有产品发布或数据披露。🔗 帖子
- Nemotron Labs 同日进行两场直播,主题分别为 OpenShell 和 Domyn — 一场时长 49 分 44 秒,介绍如何通过 OpenShell 保护自主 agent;另一场时长 54 分 20 秒,介绍 Domyn 如何使用 Nemotron;均无文字说明或转录稿。🔗 帖子
- HeyGen 对比同一张脸的两个 avatar,但未说明工具或模型名称 — 一项营销对比,既未指明竞品工具,也未提及模型或衡量指标。🔗 帖子
- OpenAI 将新闻项目扩展至新闻学院 — 为 CUNY 的 Newmark J-School 和 Northwestern 的 Medill School 的硕士生及教师提供超过 400 个 ChatGPT Edu 订阅席位,覆盖 2026 至 2027 学年。🔗 公告
- Perplexity 发布 AI 集成投资回报指南 — 一篇没有产品公告的教学文章,其中所有数据均来自第三方或客户证言。🔗 文章
这意味着什么
个人 agent 正在成为一种基础设施产品,而其安全性也正在成为独立的产品。Meta 不仅发布了 Muse,还在同一天公开了迄今最详尽的说明,介绍如何约束一个拥有 shell、浏览器和邮箱访问权限的 agent。其中最具启发性的选择是替代 token:它让通过 prompt injection 窃取凭据变得毫无意义,不是因为模型的抵抗能力更强,而是因为模型从未接触过秘密信息。tainted egress 也遵循同样的逻辑:不信任模型,而是在 kernel 层进行监测和控制。高达 30 万美元的 bug bounty,以及结论中坦率承认 Muse 会犯错,都传递了与 Boris Cherny 公开评估其他实验室此类风险时相同的信息。agent 安全已不再是一个等待勾选的检查项,而是一个需要公开、并付费邀请他人攻破的工程领域。
这一天也是一堂 AI 经济学课程,其计价单位已不再是得分,而是每项任务的成本。Mistral 以超过 210 亿欧元的估值融资 30 亿欧元,Cognition 则以 480 亿美元的估值融资超过 20 亿美元;两笔交易中,坐上谈判桌的都不只是科技基金,还有产业企业和客户。与此同时,Cursor 公布的榜单显示,Muse Spark 1.3 以每项任务 1.31 美元的成本取得 67.9% 的成绩,而榜首仅高出六个百分点,每项任务却要花费 9.64 美元;Anthropic 则记录了在性能无损的情况下成本下降 52% 至 73% 的结果,并表明以较低 effort 运行的更强模型,往往优于被推至极限的较弱模型。Sarah Friar 则量化了产业链的另一端:通过让 GPT-5.6 Sol 优化为其提供服务的软件层,服务成本降低了 20%。这是从四个角度说明,权衡重点已经从能力本身转向了获得这种能力所需的价格。
在科学领域,问题已不再是 agent 能否产出结果,而是如何验证这些结果。OpenAI 宣布,大约 10,000 个 agent 在 88 小时内给出了 Navier-Stokes 奇点证明,并使用 Lean 将其形式化;但公告未提及同行评审或机构验证,而且采用了外界无人能够查询的内部模型。该公司的谨慎态度本身也是一种信息:它放弃争取千禧年大奖,并将结果称为“快照”。当天另外两项工作鲜明体现了这种差异:在 MIT,Codex 能够遵循定义明确的实验方案,却会在模糊信号面前受阻,而且经验丰富的研究人员仍然更快;在 Google DeepMind,AlphaGenome Atlas 并不声称证明任何结论,而是预先计算 90 亿项预测,并将工作重点转向实验验证。Oruk 的文章进一步完成了论证:如果没有配对比较,再惊人的 ablation 也无法证明任何事情;Multiverse Computing 的文章则提醒人们,只要没有以同等严谨程度衡量良性一侧,任何安全数据都毫无意义。
最后是底层,在这里,收益不再来自模型权重。Cohere 开源了一套完整的服务引擎,唯一的改变是消除 kernel 边界,从而在质量相同的情况下达到 vLLM 的 1.58 倍吞吐量;它还特别指出,编写 megakernel 的难度被高估了。NVIDIA 开辟了两条使用 Rust 编写 GPU kernel 的路径,其中一条已在其公司之外得到应用,包括 Hugging Face 的 Grout 推理引擎和 mistral.rs;同时它也坦承,这些方案尚未达到生产就绪状态。在 AI City Challenge 中,排名前五的视频方案有四个基于通过 LoRA 适配的 Cosmos 模型,冠军团队强调,这是一套适配方案,而非新的架构。Earthmover 的天气教程从另一个角度讲述了同样的故事:Aurora 模型可以在处理器上运行,真正的瓶颈并非计算,而是需要下载 1 GB 的初始条件数据。每一次,价值都存在于围绕模型的工程之中,而且这些工程成果正在被公开。
来源
- Muse 发布,Meta
- 通过 Muse 实现 agent 安全与保障,Meta
- Mistral D 轮融资
- X 上的 D 轮融资公告
- Navier-Stokes 问题解决方案,OpenAI
- OpenAI 关于内部模型的帖子串
- MIT 的 Codex 与量子计算实验
- ChatGPT Images 2.5,OpenAI
- Manus 集成 GPT-Image-2.5
- AlphaGenome Atlas,Google DeepMind
- CUDA Rust,NVIDIA
- ECCV 2026 AI City Challenge,NVIDIA
- Cognition E 轮融资
- Cognition 在 X 上的帖子串
- Suno、Believe 与 TuneCore 合作
- 解码 Megakernel,Cohere
- 降低 Claude Platform 成本,Anthropic
- Claude Code 2.1.265
- 实时操控 agent,Amp
- Cursor 中的 Muse Spark 1.3
- Grok Bot 中的表单填写
- Grok Imagine 中的关键帧与循环
- 使用 Earthmover 的开放天气模型,Hugging Face
- 安全是为了谁,Multiverse Computing
- 果蝇 connectome 与混合连线,Oruk
- Kinetix 加入 Runway
- Sarah Friar 的文章,OpenAI
- 青少年研究资助,OpenAI
- Boris Cherny 谈 prompt injection 风险
- 使用 Claude Managed Agents 构建产品的创始人
- RelayShield 与指令文件
- Ai2 参加 ECCV 2026
- agent 工具层,Prismberry
- 硬件维护记录
- 密苏里州的 Gemini for Education
- Dependabot 与 GitHub 私有 registry
- 全新 GitHub 支持门户
- SF Tech Week 期间的 Spark House,Genspark
- Ethan Tandowsky,ElevenLabs 首席财务官
- MiniMax 东京活动
- Nemotron Labs 直播
- HeyGen avatar 对比
- OpenAI 新闻项目
- AI 投资回报指南,Perplexity