ai-powered-markdown-translatorArtikel, übersetzt vom Französischen ins Deutsche mit gpt-5.6-sol.
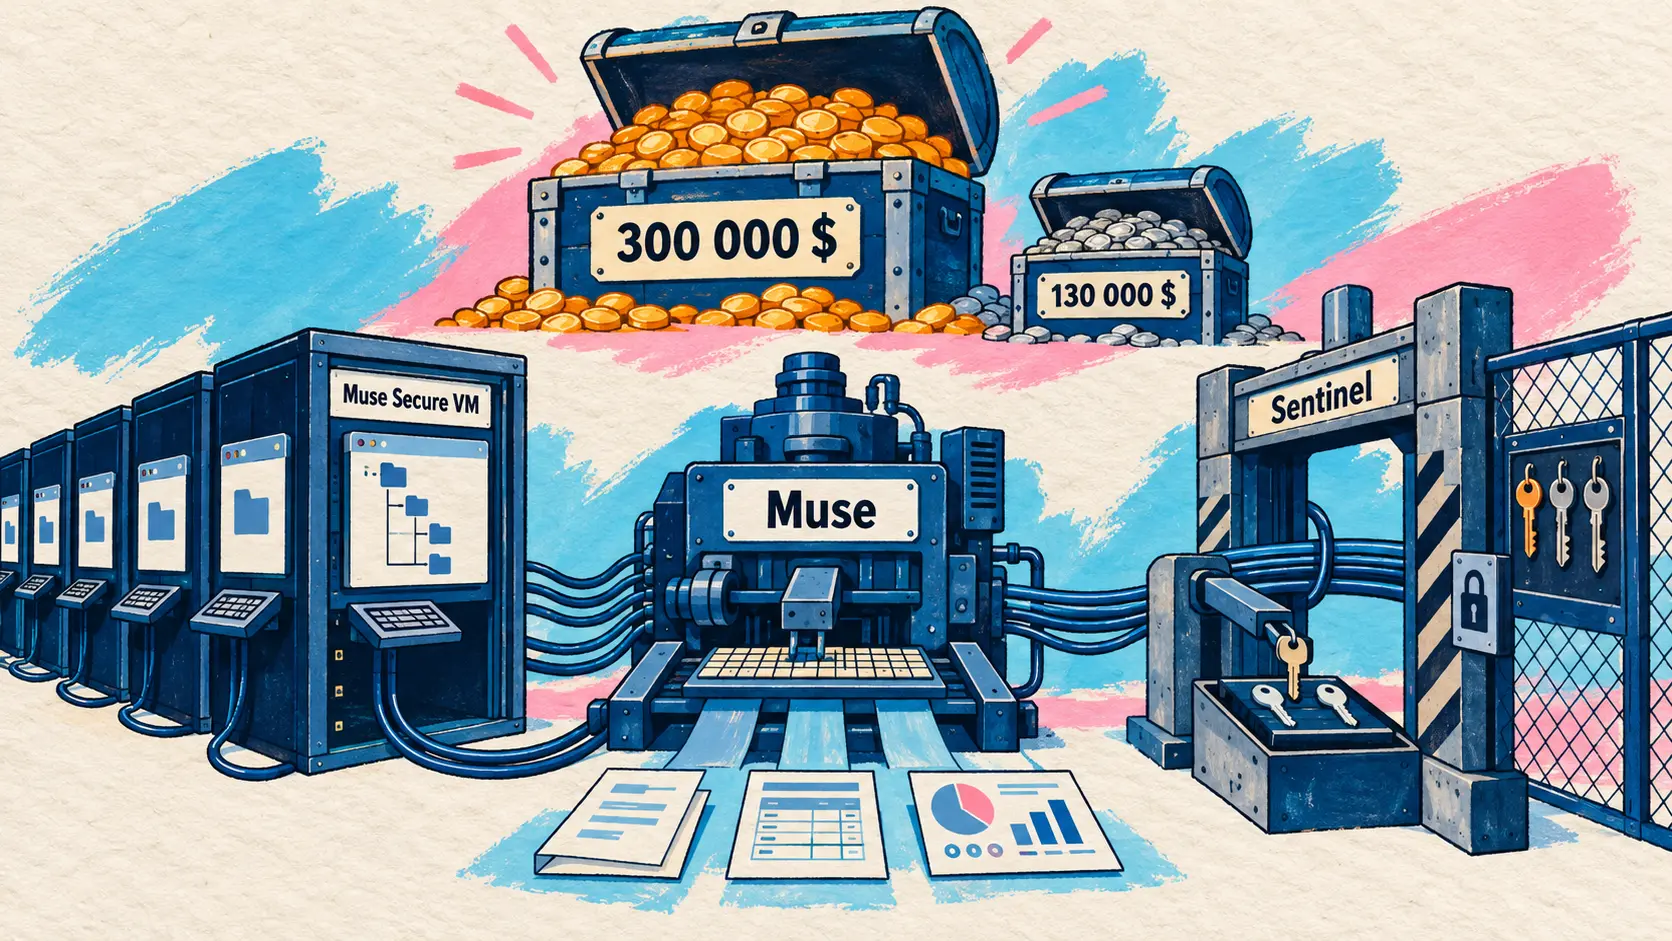
Meta startet Muse, einen persönlichen Agenten, der jedem Nutzer eine eigene Linux-Maschine in der Cloud zur Verfügung stellt, und veröffentlicht am selben Tag die zugrunde liegende Sicherheitsarchitektur sowie ein für alle offenes Bug-Bounty-Programm mit Prämien von bis zu 300.000 Dollar. Mistral kündigt eine Serie-D-Runde über 3 Milliarden Euro an, die größte Eigenkapitalfinanzierung, die je von einem europäischen Technologieunternehmen abgeschlossen wurde. OpenAI veröffentlicht seinerseits einen von einem Agentensystem erstellten Beweis für die Bildung einer Singularität in endlicher Zeit bei den Navier-Stokes-Gleichungen, und Google DeepMind berechnet die Auswirkungen der 9 Milliarden möglichen Mutationen der menschlichen DNA im Voraus.
Meta startet Muse, seinen persönlichen Agenten, und veröffentlicht dessen Sicherheitsarchitektur
8. September — Meta startet Muse, einen persönlichen Agenten, der als iOS- und Android-App, über eine Weboberfläche und in WhatsApp verfügbar ist und von Muse Spark 1.3 angetrieben wird. Das Modell ist nicht neu: Es erschien am 2. September in Muse Code und der Meta Model API, und seine höchste Reasoning-Stufe wurde am 4. September öffentlich zugänglich. Neu ist das darum herum entwickelte Produkt für die breite Öffentlichkeit.
Die Architektur beruht auf einer einfach zu formulierenden, aber aufwendig umzusetzenden Idee: Jeder Nutzer erhält einen eigenen Computer in der Cloud. Die Muse Secure VM ist eine persistente und isolierte Linux-Maschine mit Dateisystem, Terminal und vollständigem Browser sowie genügend Speicherplatz, Rechenleistung und Arbeitsspeicher, um Code zu kompilieren, maßgeschneiderte Skills zu entwickeln und Subagenten parallel auszuführen. Diese Maschine und nicht eine zentralisierte Meta-Infrastruktur dient als maßgebliches System für die Daten und Zugangsdaten verbundener Dienste. Fehlt für eine Aufgabe ein Tool, schreibt der Agent es selbst, und er erstellt bearbeitbare Objekte statt Textblöcken: Reiserouten, PDF-Dateien, Webseiten und Dashboards, die Meta als Artifacts bezeichnet.
Als zweiten grundlegenden Wandel führt Meta an, dass der Agent bei geschlossener Anwendung im Hintergrund arbeitet, nach Zeitplan und als Reaktion auf Ereignisse, und anschließend entscheidet, ob das Ergebnis eine Benachrichtigung rechtfertigt. Der Speicher ist persistent und kann vom Nutzer eingesehen und bearbeitet werden; ein Ziele-Tab bietet einen Überblick über alles, was der Agent verfolgt. Offen bleibt, was Meta nicht mitteilt: Es wurden weder Preise veröffentlicht noch Angaben dazu gemacht, in welchen Ländern Muse zum Start verfügbar ist.
Zwanzig Minuten nach der Produktankündigung veröffentlichte Meta ein technisches Dokument von Tarek Sheasha, Softwareingenieur und Vice President bei Meta Superintelligence Labs, über die Sicherheit dieses Systems. Das Leitprinzip wird gleich zu Beginn formuliert: Das System wurde unter der Annahme entwickelt, dass der Agent angegriffen wird. Das im Code Hatch genannte Agenten-Harness läuft in einem systemd-nspawn-Container, dessen root einem nicht privilegierten Nutzer des Hosts zugeordnet ist, wobei Systemaufrufe gefiltert und Kernel-Fähigkeiten entzogen werden. Vier Dienste laufen bewusst außerhalb dieses Containers, damit ein Angreifer, der den Agenten kompromittiert, sie nicht deaktivieren kann: die Sicherheitsklassifikatoren, Worker mit getrennten Berechtigungen, der Daemon zur Speicherung von Zugangsdaten und Sentinel.
Sentinel ist das zentrale Element: Als einzige Instanz, die eine Connector-Aktion oder ausgehenden Netzwerkverkehr autorisieren kann, bewertet es jede Anfrage auf den Schichten 4 und 7 und überprüft die tatsächlich aufgelöste Adresse. Vor allem verarbeitet der Agent nur Ersatz-Tokens, die an der Netzwerkgrenze durch die echten Zugangsdaten ersetzt werden. Der Versuch, dem Agenten durch Prompt Injection ein Geheimnis zu entlocken, läuft damit ins Leere, weil er es nie besessen hat. Hinzu kommt eine Datenflussverfolgung auf Kernel-Ebene, der sogenannte tainted egress: Jeder Prozess, der Nutzerdaten liest, wird markiert und verliert seine automatische Autorisierung. Die Implementierung kombiniert an cgroups angehängte eBPF-Programme mit von Meta hinzugefügten Linux Security Module Hooks.
| Element der Architektur | Gewählte Lösung |
|---|---|
| Container des Agenten-Harness | systemd-nspawn, root einem nicht privilegierten Nutzer zugeordnet |
| Autorisierungsinstanz | Sentinel, außerhalb des Containers, Schichten 4 und 7 |
| Vom Agenten verwendete Zugangsdaten | ausschließlich Ersatz-Tokens |
| E-Mail-Connector | Filterung von Einmalcodes und Links zum Zurücksetzen |
| Browser-Subagent | Accessibility Tree, kein rohes DOM, kein JavaScript innerhalb der Seite |
| Zahlungen | Stripe Link zum Start, anschließend Shop Pay, Karte zur einmaligen Verwendung |
| Bug Bounty, Höchstbetrag pro gültigem Bericht | 300.000 Dollar |
| Bug Bounty, Prompt Injection | bis zu 130.000 Dollar |
Das Dokument wird von zwei Ankündigungen begleitet. Das Bug-Bounty-Programm steht ab dem Start allen offen und bietet je nach nachgewiesener Auswirkung bis zu 300.000 Dollar pro gültigem Bericht, darunter bis zu 130.000 Dollar für eine erfolgreiche Prompt Injection, die einen Nutzer betrifft. Außerdem soll Muse Confidential VM bis Ende des Jahres kryptografisch und überprüfbar verhindern, dass Meta auf die Daten einer virtuellen Maschine zugreifen kann; Design und Quellcode wurden bereits externen Prüfern vorgelegt. Der Schluss des Textes ist für eine Unternehmensveröffentlichung ungewöhnlich offen: Prompt Injection bleibt ein ungelöstes Problem der Branche, und Muse wird Fehler machen.
🔗 Start von Muse · 🔗 Sicherheit und Schutz von Agenten, Meta
Mistral nimmt 3 Milliarden Euro auf, die größte Eigenkapitalfinanzierung der europäischen Technologiebranche
8. September — Mistral kündigt eine Serie-D-Runde über 3 Milliarden Euro bei einer Post-Money-Bewertung von mehr als 21 Milliarden Euro an. Das Unternehmen bezeichnet diese Runde als die größte Eigenkapitalfinanzierung, die je von einem europäischen Technologieunternehmen abgeschlossen wurde – nur drei Jahre nach seiner Gründung.
Samsung Electronics führt die Transaktion an. Der von EQT verwaltete Scaleup Europe Fund und der bereits beteiligte Anteilseigner PSG Equity fungieren als Co-Lead-Investoren. Drei neue Investoren kommen hinzu: Advent, von BlackRock verwaltete Fonds und Konten sowie das Großherzogtum Luxemburg. Die Liste der bestehenden Beteiligten ist lang und erstreckt sich über drei Kontinente, von a16z über ASML, BNP Paribas CIB, Bpifrance, DST Global, General Catalyst, Index Ventures, Korelya Capital und Lightspeed bis zu NVIDIA und Salesforce Ventures.
Bemerkenswert ist die Art der beiden aufeinanderfolgenden Lead-Investoren. ASML führte die Serie C an, Samsung Electronics die Serie D: zwei Unternehmen aus der fortschrittlichen Fertigungsindustrie und keine allgemeinen Technologiefonds. Mistral sieht darin ein Zeichen des Vertrauens in seine Fähigkeit, hochmoderne Modelle in komplexen Industrieumgebungen einzusetzen, in denen die Kontrolle über Daten und Infrastruktur entscheidend für die Akzeptanz ist.
| Kennzahl | Wert |
|---|---|
| Aufgenommenes Kapital | 3 Milliarden Euro |
| Post-Money-Bewertung | mehr als 21 Milliarden Euro |
| Alter des Unternehmens | 3 Jahre |
| Lead-Investor | Samsung Electronics |
| Co-Lead-Investoren | von EQT verwalteter Scaleup Europe Fund, PSG Equity |
| Länder mit Geschäftstätigkeit | 20 |
| Großkunden | mehr als 125, darunter Airbus, ASML und HSBC |
Bei der Verwendung der Mittel nennt das Unternehmen an erster Stelle die Frontier-Forschung, anschließend den Ausbau der Rechenkapazität für das Training, die Erweiterung der Infrastruktur und die Beschleunigung des internationalen Geschäfts. Die Argumentation greift die seit dem Sommer vertretene Linie auf: Für Organisationen gehe es nicht mehr darum, wer das leistungsfähigste Modell entwickelt, sondern darum, wie sie KI nutzen können, ohne die Kontrolle über ihre Infrastruktur abzugeben. Mistral beschreibt sich als einziges Unternehmen der Branche, das den gesamten erforderlichen Stack zusammenstellt – von Modellen mit offenen Gewichten über Produkte bis hin zur Rechenkapazität.
Today marks a major step for Mistral: we’re announcing a €3B Series D, the largest equity round ever raised by a European tech company, just three years after launch.
🇩🇪 Heute erreicht Mistral einen bedeutenden Meilenstein: Wir geben eine Serie-D-Runde über 3 Milliarden Euro bekannt, die größte Eigenkapitalfinanzierung, die je von einem europäischen Technologieunternehmen durchgeführt wurde – nur drei Jahre nach unserem Start. — @MistralAI auf X
Die wissenschaftlichen Agenten von OpenAI: ein Beweis zu Navier-Stokes und am MIT kalibrierte Qubits
8. September — OpenAI veröffentlicht einen Beweis für die Bildung einer Singularität in endlicher Zeit bei den dreidimensionalen Navier-Stokes-Gleichungen, begleitet von einer Formalisierung im Beweisassistenten Lean. Das bekannt gegebene Ergebnis besagt, dass bei einem anfangs glatten, ruhenden dreidimensionalen Fluid, das einer glatten äußeren Kraft ausgesetzt ist, die Geschwindigkeit innerhalb endlicher Zeit unbegrenzt anwachsen kann, obwohl die Viskosität dazu neigt, die Bewegung zu glätten, und die Energie des Systems endlich bleibt. In der offiziellen Formulierung des Clay Mathematics Institute entspricht dies den Aussagen „C“ und „D“, die eine Widerlegung und keinen Regularitätsbeweis darstellen.
Was OpenAI beansprucht und was nicht, muss genau dargelegt werden. Der Beweis wurde von einem koordinierten Agentensystem erstellt, das auf einem internen Modell ohne öffentlichen Namen basiert. Das Unternehmen beschreibt dieses als deutlich leistungsfähiger als GPT-6 Astra; sein Training läuft seit dem 28. August weiter. Die einzige beschriebene Überprüfung ist die Formalisierung in Lean, die GPT-6 Astra übertragen und 17 Stunden nach der Lösung abgeschlossen wurde. In der Ankündigung werden weder ein Peer-Review noch eine Validierung durch das Clay Mathematics Institute erwähnt. OpenAI erklärt außerdem, nicht die Absicht zu haben, den Millennium-Preis zu beanspruchen, und bezeichnet sein Ergebnis als Momentaufnahme statt als Endpunkt.
Die Methode ist mindestens ebenso bemerkenswert wie das Ergebnis. Die Arbeiten begannen am 1. September, nachdem Gerüchte aufgekommen waren, dass zwei Millennium-Probleme gelöst worden seien. Verschiedene Agentengruppen erhielten unterschiedliche Varianten der Aufgabenstellung: die auf einen Beweis ausgerichteten Versionen „A“ und „B“ sowie die auf eine Widerlegung ausgerichteten Versionen „C“ und „D“. Bei einem Nebenproblem, der Regularität der ungezwungenen Euler-Gleichungen, erstellten fast 100 Agenten innerhalb von rund fünfzig Stunden eine Widerlegung; dieses Ergebnis wurde anschließend in die Prompts der an Navier-Stokes arbeitenden Agenten eingespeist.
| Kennzahl | Wert |
|---|---|
| Gleichzeitig arbeitende Agenten, Navier-Stokes-Gruppe | in der Größenordnung von 10.000 |
| Zeit bis zur Lösung | etwa 88 Stunden |
| Formalisierung und Überprüfung in Lean | weitere 17 Stunden, über GPT-6 Astra |
| Ausgetauschte Nachrichten, Navier-Stokes | 2,7 Millionen |
| Ausgabe-Tokens, Navier-Stokes | etwa 130 Milliarden |
| Ausgetauschte Nachrichten, alle untersuchten Probleme | 4,9 Millionen |
| Ausgabe-Tokens, alle untersuchten Probleme | etwa 300 Milliarden |
| Widerlegung der Regularität der ungezwungenen Euler-Gleichungen | fast 100 Agenten, etwa 50 Stunden |
Eine parallele Arbeit verkompliziert das Bild. Levent Alpöge, Mitarbeiter von Anthropic, und Tristan Buckmaster, Mathematikprofessor an der NYU, verfügten über ein Ergebnis zu den Euler-Gleichungen in ihrer erzwungenen Variante. OpenAI kontaktierte sie am 6. September, nachdem das eigene Projekt abgeschlossen und überprüft worden war, um eine gemeinsame Veröffentlichung vorzuschlagen und ihre Priorität anzuerkennen, bevor sich herausstellte, dass sich ihr Ergebnis auf eine andere Aufgabenstellung bezog.
This model represents a step-function improvement on many benchmarks, and its training is ongoing. Our internal model group arrived at the Navier–Stokes solution in 88 hours, using around 10,000 coordinating AI agents. Throughout the effort, we maintained the strict safeguards—including monitoring and isolation—that we apply to all our frontier evaluations.
🇩🇪 Dieses Modell stellt bei zahlreichen Benchmarks eine sprunghafte Verbesserung dar, und sein Training wird fortgesetzt. Unsere interne Modellgruppe gelangte innerhalb von 88 Stunden zur Navier-Stokes-Lösung, wobei etwa 10.000 koordinierte KI-Agenten zum Einsatz kamen. Während der gesamten Arbeit hielten wir die strengen Schutzmaßnahmen ein, darunter Überwachung und Isolation, die wir bei allen unseren Bewertungen von Frontier-Modellen anwenden. — @OpenAI auf X
Am selben Tag veröffentlicht OpenAI eine deutlich bescheidenere und wesentlich besser überprüfbare Fallstudie. Beatriz Yankelevich, Doktorandin in der Gruppe Engineering Quantum Systems am MIT, verband den von GPT-5.6 Sol gesteuerten Codex mit der Software, die ihre Experimente koordiniert, um einen unkalibrierten Chip mit sechs supraleitenden Qubits zu kalibrieren. Die Agenten erhielten für jede Messart eigene Skills, in denen beschrieben wurde, wie die Messung durchzuführen und zu beurteilen ist. Bei eindeutigen Signalen führte Codex mit wenig menschlichem Eingreifen eine vollständige Abfolge durch: Identifizierung der Übergangsfrequenzen, Kalibrierung der Steuer- und Ausleseimpulse sowie Messung der Speicherdauer der Quanteninformation. Bei schwachen oder verrauschten Signalen braucht das System länger, um brauchbare Parameter zu finden, und benötigt bisweilen den Blick eines erfahrenen Forschers, der weiterhin schneller als das Modell ist. Der Vorteil liegt daher nicht in der Geschwindigkeit, sondern darin, dass keine dauerhafte Überwachung erforderlich ist: Die Charakterisierung eines solchen Standardchips kostet einen Forscher mehrere Tage, und die Gruppe überträgt Routinemessungen inzwischen Agenten.
🔗 Navier-Stokes-Lösung, OpenAI · 🔗 Codex und Quantenexperimente, OpenAI
ChatGPT Images 2.5 mit Sketch und zwei Bildmodellen in der API
8. September — OpenAI führt ChatGPT Images 2.5 in seinen Produkten und in der API ein. Die eingangs genannte Nutzungszahl verdeutlicht die Dimension: Jede Woche werden mit ChatGPT Images und den GPT-Image-Modellen der API mehr als 3 Milliarden Bilder erstellt. Der greifbarste Fortschritt ist die gegenüber Images 2.0 um bis zu 50 Prozent reduzierte Latenz; weitere Verbesserungen betreffen die Übereinstimmung mit Referenzfotos und die Konsistenz über längere Unterhaltungen hinweg, bei denen frühere Änderungen besser erhalten bleiben.
Auf ChatGPT-Seite kommen drei Funktionen hinzu. Mit Sketch lässt sich direkt in der Unterhaltung zeichnen, um eine visuelle Vorlage bereitzustellen, indem man „@Sketch“ eingibt. Templates decken gängige Formate wie Plakate oder Merchandising ab. Kommentare können auf dem Bild platziert werden, um eine Retusche gezielt vorzunehmen. Beim Teilen eines Bildes kann nun auch der Prompt einbezogen werden, mit dem es erzeugt wurde. Die Einführung umfasst alle Nutzer von ChatGPT, ChatGPT Work und Codex auf Desktop, Mobilgeräten und im Web sowie in allen Tarifstufen.
| Modell in der API | Angekündigte Positionierung | Latenz |
|---|---|---|
| GPT-Image-2.5 Flare | Standardwahl, Social-Media-Inhalte, Massengenerierung | bis zu 50 Prozent weniger als Images 2.0 |
| GPT-Image-2.5 Sunburst | Präzision, veröffentlichungsfertige Kampagnen | längere Generierungszeiten |
Beide Modelle unterstützen die neuen Qualitätseinstellungen xhigh und max und übernehmen die Token-Preise von GPT Image 2: Im Standard-Tarif sind das 8,00 Dollar pro Million Tokens für die Bildeingabe, 30,00 Dollar für die Bildausgabe und 5,00 Dollar für die Texteingabe. C2PA-Metadaten und das unsichtbare Wasserzeichen bleiben erhalten, und eine System Card begleitet die Veröffentlichung.
Manus integriert das Modell noch am selben Tag
Manus fügt GPT-Image-2.5 am Abend der Ankündigung seiner Plattform hinzu und verweist dabei auf die eineinhalb Stunden zuvor veröffentlichte Mitteilung von OpenAI. Das seit dem 1. September wieder unabhängige Agentenlabor nennt eine Zahl aus eigenen Bewertungen und nicht aus denen von OpenAI: Das von ihm als Flare bezeichnete Modell erzeugt hochwertige Bilder zwei- bis viermal so schnell wie GPT-Image-2. Für einen Agenten, der im Verlauf einer Unterhaltung visuelle Inhalte generiert, ist dieser Faktor wichtiger als ein marginaler Qualitätsgewinn, da er darüber entscheidet, ob die Generierung im Arbeitsfluss bleibt oder eine Wartezeit verursacht. Manus hebt außerdem die verbesserte Generierung transparenter Hintergründe hervor, die das manuelle Freistellen überflüssig macht, das eine vollständige Automatisierung unterbrechen würde.
AlphaGenome Atlas, die prädiktive Karte der 9 Milliarden Mutationen der menschlichen DNA
8. September — Google DeepMind führt AlphaGenome Atlas ein, eine Datenbank, die die molekulare Auswirkung jeder möglichen Ein-Buchstaben-Mutation in der menschlichen DNA vorhersagt. Das menschliche Genom umfasst etwa 3 Milliarden Basenpaare, von denen nur 2 Prozent für Proteine codieren; die übrigen 98 Prozent sind weitgehend unerforscht, obwohl dort bereits die Änderung eines einzigen Buchstabens einen wesentlichen biologischen Regulator deaktivieren kann.
Die Methode beruht auf einer Umkehrung der Rechenlast. Anstatt jedes Labor das Modell Variante für Variante abfragen zu lassen, hat Google DeepMind die Vorhersagen des AlphaGenome-Modells für alle 9 Milliarden möglichen Substitutionen vorausberechnet. Das Ergebnis ist ein Datensatz von 1 Petabyte, der mehr als dreißigmal so groß sein soll wie die AlphaFold Database. Um dieses Volumen nutzbar zu machen, führt der Atlas den AVI-Score (AlphaGenome Variant Impact) ein, eine einzelne Zahl, die Vorhersagen zu codierenden und nicht codierenden Regionen zusammenfasst und mit Zuordnungen nach Merkmal angibt, welche biologischen Prozesse eine Variante beeinträchtigt. Hinzu kommt ein Katalog von mehr als 2.500 wiederkehrenden Sequenzmotiven, den regulatorischen Einheiten, die Google als die „Wörter“ des Genoms beschreibt.
| Metrik | Wert |
|---|---|
| Vorausberechnete Varianten | 9 Milliarden, alle Ein-Buchstaben-Änderungen |
| Größe des Datensatzes | 1 Petabyte, mehr als 30-mal die AlphaFold Database |
| Katalogisierte Sequenzmotive | mehr als 2.500 |
| Analysierte Teilnehmer der UK Biobank | mehr als 54.000 |
| Zusätzliche nicht codierende Assoziationen | plus 22 Prozent |
| Identifizierte, mit dem BMI verbundene Genregionen | 19 |
Zwei dokumentierte Anwendungen verdeutlichen den Nutzen. Am Broad Institute nutzten Laura Covill und ihr Team den AVI-Score, um Kandidatenvarianten bei bislang nicht diagnostizierten seltenen Erkrankungen zu priorisieren: Das Werkzeug hob eine Variante des DNM1-Gens hervor, indem es vorhersagte, dass sie eine fehlerhafte Spleißstelle erzeugt, und lieferte damit den entscheidenden Hinweis zur Lösung des Falls. An der University of Exeter wandte Gareth Hawkes den Atlas auf Daten von mehr als 54.000 Teilnehmern der UK Biobank an und erhielt 22 Prozent mehr genetische Assoziationen in nicht codierenden Regionen; anschließend identifizierte er 19 mit dem Body-Mass-Index verbundene Genregionen, indem er sich auf das 1 Prozent der Varianten mit den stärksten Auswirkungen beschränkte.
Der Zugang ist der zweite bemerkenswerte Punkt. Der Atlas ist über ein Webportal ohne Programmieraufwand verfügbar und richtet sich damit an Kliniker und Biologen, die nicht programmieren, aber auch über die AlphaGenome API, in der Cloud über Model Garden sowie mit auf GitHub veröffentlichten Forschungsdaten. Ein Detail, das Entwickler interessieren dürfte, die Googles Agentenökosystem verfolgen: Der Atlas wird außerdem als Skill in Google Antigravity bereitgestellt und kann somit direkt von einem Coding-Agenten genutzt werden.
🔗 AlphaGenome Atlas, Google DeepMind
NVIDIA führt CUDA Rust ein, und Cosmos dominiert die AI City Challenge der ECCV
8. September — NVIDIA veröffentlicht CUDA Rust als Antwort auf eine zunehmend sichtbare Lücke: Die Systemschicht der KI wird immer häufiger in Rust geschrieben, doch der GPU-Kernel blieb die Ausnahme. Ein Kernel ließ sich bereits aus Rust starten, musste jedoch in einer anderen Sprache geschrieben werden. CUDA Rust schließt diese Lücke, indem es Rust-Kernel nativ nach PTX kompiliert, und zwar über zwei getrennte Ansätze, die den beiden Programmiermodellen entsprechen, die CUDA bereits für C++ und Python anbietet.
| Element | cuda-oxide, SIMT-Ansatz | cutile-rs, Tile-Ansatz |
|---|---|---|
| Reifegrad | frühe Alpha | auf crates.io veröffentlicht |
| Erforderliche Rust-Toolchain | festgelegte Nightly-Version (nightly-2026-04-03) | Stable 1.89 oder höher |
| CUDA-Version | 12.x oder höher | 13.3 |
| Bereitzustellendes LLVM | ja, zusätzlich clang und libclang | nein |
| Kompilierung | beim Build nach PTX | JIT über CUDA Tile IR |
| Genannte externe Anwendungen | keine | Grout von Hugging Face, mistral.rs |
NVIDIAs Empfehlung ist eindeutig: zunächst mit Tile beginnen, weil der Quellcode dann keine architekturspezifischen Entscheidungen enthält, und auf SIMT wechseln, wenn eine präzise Kontrolle über Threads und Speicher erforderlich wird. Diese Abwägung hat derzeit ihren Preis, denn bei SIMT erfordert der Shared Memory, die Grundlage schneller Kernel, noch immer unsafe. Das zentrale Argument ist die Speichersicherheit zur Kompilierzeit: Beide Ansätze verhindern klassisches Aliasing, bei dem ein Puffer gleichzeitig als Eingabe und Ausgabe dient, mit error[E0502] auf der SIMT-Seite und error[E0382] auf der Tile-Seite. Beim Reifegrad übertreibt NVIDIA nicht: Keines der beiden Projekte ist produktionsbereit, und das angekündigte Engagement erstreckt sich auf 2027 und darüber hinaus, einschließlich einer Zusammenarbeit mit den Betreuern von rust-cuda.
Am selben Tag veröffentlicht NVIDIA die Ergebnisse der AI City Challenge der ECCV 2026. In Track 5, der der generativen Videovorhersage von Verkehrsszenen gewidmet ist, verwenden vier der fünf besten Lösungen Versionen der Cosmos-Weltfundamentmodelle. Das Team Qyn gewinnt die öffentliche Rangliste mit CosmosAlign, das das eingefrorene Cosmos3-Nano-Modell mit 16 Milliarden Parametern über ein zweistufiges LoRA-Verfahren anpasst, vier Vorhersagen erzeugt, den Medoid auswählt und stabile Bereiche aus der beobachteten Historie wieder einsetzt: 76,39 gegenüber 76,04 für das Team SSUPER, also ein Vorsprung von 0,35 Punkten. NVIDIA weist ausdrücklich darauf hin, dass es sich um ein Verfahren zur Anpassung und Inferenz handelt und nicht um eine neue Architektur. Cosmos tritt auch als Prüfer auf: In beiden Out-of-Domain-Ranglisten von Track 3 gewinnt das Team UWIPL_ETRI mit UniTraffic, das strittige Aussagen durch einen unabhängigen Cosmos-Reason1-Prüfer kontrollieren lässt.
🔗 CUDA Rust, NVIDIA · 🔗 Ergebnisse der AI City Challenge
Cognition nimmt mehr als 2 Milliarden Dollar auf und erreicht eine Bewertung von 48 Milliarden
8. September — Cognition, der Entwickler des Entwicklungsagenten Devin, gibt eine Finanzierungsrunde von mehr als 2 Milliarden Dollar bei einer Bewertung von 48 Milliarden bekannt. Die Runde wird von den beiden neuen Investoren Andreessen Horowitz und Accel angeführt, gemeinsam mit den bereits beteiligten Investoren Founders Fund, General Catalyst und Avenir. Rund dreißig weitere Teilnehmer ergänzen die Investorenliste, darunter NVIDIA, Benchmark, Bessemer, Kleiner Perkins, Greylock, Lightspeed, T. Rowe Price und Bain Capital Ventures.
| Kennzahl | Mai 2026 | September 2026 |
|---|---|---|
| Aufgenommenes Kapital, kumuliert in der Runde | mehr als 1 Milliarde Dollar | mehr als 2 Milliarden |
| Bewertung | 26 Milliarden Dollar | 48 Milliarden |
| Annualisierter Umsatz | 492 Millionen Dollar | fast 900 Millionen |
| Führende Investoren | Lux Capital, General Catalyst, 8VC | Andreessen Horowitz, Accel |
Die Bewertung hat sich damit innerhalb von vier Monaten nahezu verdoppelt und binnen eines Jahres fast verfünffacht, wobei der annualisierte Umsatz demselben Trend folgt. Cognition erläutert die Anwendungen, die dieses Wachstum antreiben: Devin arbeitet bei NVIDIA am Chipdesign, bei GE Aerospace in der Luftfahrt, bei Citi an Finanzdienstleistungen, bei Mercedes-Benz im Automobilbereich und bei Modal an der KI-Infrastruktur. Dass NVIDIA zugleich Kunde und Investor dieser Runde ist, veranschaulicht, wie diese Unternehmen den Zugang zu den Werkzeugen absichern, die sie intern verwenden. Drei neue Fähigkeiten verlagern Devin von der Ausführung von Aufgaben hin zu autonomem Handeln: Auto-Triage für die erste Phase der Untersuchung von Vorfällen, Security Swarm für die Triage von Schwachstellen und Automations, ausgelöst durch Ereignisse in Slack, GitHub oder Linear. Innerhalb eines Jahres wurden sechs Büros eröffnet, davon fünf außerhalb der Vereinigten Staaten, zusätzlich zu den Standorten in San Francisco, New York und Austin.
In the next chapter of software engineering, agents will become proactive by default, software will improve itself, and compute will automatically get allocated toward the highest impact use cases. We’re still at the dawn of the self-driving software era.
🇩🇪 Im nächsten Kapitel der Softwareentwicklung werden Agenten standardmäßig proaktiv sein, Software wird sich selbst verbessern, und Rechenleistung wird automatisch den Anwendungen mit der größten Wirkung zugewiesen werden. Wir stehen noch am Beginn des Zeitalters autonomer Software. — @cognition auf X
Suno schließt eine Vereinbarung mit Believe und TuneCore, die seine Musik zuvor nicht vertreiben wollten
8. September — Suno gibt eine weltweite strategische Partnerschaft mit dem Künstlerentwicklungsunternehmen Believe und dessen Selbstvertriebsplattform TuneCore bekannt. Die Vereinbarung umfasst zwei unterschiedliche Aspekte. Erstens wird Believe an der Konzeption der neuen Musikmodelle beteiligt, die Suno gemeinsam mit der Branche entwickelt. Zweitens, und das ist der konkrete Punkt für Nutzer, werden mit diesem neuen Partnermodell erstellte Titel für den Vertrieb über Believe und TuneCore und damit an Spotify, Apple Music, Amazon Music und YouTube zugelassen.
Der Kontext verdeutlicht die Tragweite der Ankündigung. Suno erinnert ohne Umschweife daran, dass Believe und TuneCore Anfang dieses Jahres angekündigt hatten, keine Musik zu vertreiben, die mit Modellen erstellt wurde, die ihre Kriterien nicht erfüllen, einschließlich der damaligen Modelle von Suno. Der Kurswechsel wird als Ergebnis von Gesprächen dargestellt, bei denen gemeinsame Werte zutage traten: Künstlern echte Wahlmöglichkeiten zu geben und Wege zu Vertrieb und Einnahmen zu eröffnen.
Die Vereinbarung fügt sich in eine konsequente Entwicklung ein. Sie erweitert Spark, Sunos Programm für unabhängige und aufstrebende Künstler, und ergänzt die bestehenden Vereinbarungen mit Warner Music Group und BMG um unabhängige Labels und selbstproduzierende Künstler. Suno verknüpft sie außerdem ausdrücklich mit seinen jüngsten Schutzmaßnahmen: dem Audio-Wasserzeichen und dem akustischen Fingerabdruck zur Identifizierung seiner Titel außerhalb der Plattform sowie den am 3. September in Kraft getretenen Download-Beschränkungen, die eine massenhafte Verbreitung an Streamingdienste verhindern sollen. Diese Schutzmaßnahmen werden auch für die über Believe und TuneCore vertriebene Musik gelten. Die Ankündigung endet mit einem Zeitplan: Suno kündigt die baldige Einführung seiner neuen Modelle an, deren Familie am 4. September den Namen v6 erhalten hatte.
Cohere veröffentlicht eine auf einem Megakernel basierende Serving-Engine, die 1,58-mal schneller als vLLM ist
8. September — Cohere veröffentlicht eine Inferenz-Serving-Engine, die vollständig um einen Decoding-Megakernel herum aufgebaut ist und unter der Apache-2.0-Lizenz steht. Das Unternehmen beansprucht eine Premiere: keine Geschwindigkeitsdemonstration unter Laborbedingungen, sondern einen vollständigen Server, der echte Anfragen hinter einem OpenAI-kompatiblen Endpunkt verarbeiten kann, mit Continuous Batching, Paged Attention, Prefix Cache und Tool-Aufrufen. Als Modell dient North Mini Code, ein Mixture-of-Experts-Modell mit 30 Milliarden Parametern, von denen pro Token nur 3,3 Milliarden aktiv sind.
Das angegangene Problem lässt sich in einem Satz zusammenfassen: Während des Decodings verbringt die GPU viel Zeit mit Warten statt mit Rechnen. Ein klassischer Stack startet pro Operation einen Kernel, und jede Kernel-Grenze erzwingt eine Barriere über das gesamte Rechengitter hinweg. Autoregressives Decoding wird jedoch durch die Speicherbandbreite begrenzt: Bei jedem Schritt überträgt North Mini Code 6,6 GB an Gewichten aus dem HBM-Speicher sowie bei einem Kontext von 8K etwa 0,5 GB Key-Value-Cache, wodurch die theoretische Obergrenze bei den 3,35 TB/s einer H100 bei rund 470 Tokens pro Sekunde liegt. Ein Megakernel beseitigt diese Grenzen, indem er einen einzigen persistenten Kernel startet, der während des gesamten Decoding-Schritts resident bleibt, wobei Abhängigkeiten auf Zähler im globalen Speicher reduziert werden.
| Messung | Megakernel | vLLM v0.24 | Steigerung |
|---|---|---|---|
| Decoding, Batchgröße 1, Kontext 8K (Tok./s) | 292 | 185 | 1,58x |
| AIME 2025, End-to-End (Tok./s) | 935 | 661 | 1,41x |
| SciCode, End-to-End (Tok./s) | 711 | 560 | 1,37x |
| MMLU-Pro, Informatik-Teilmenge (Tok./s) | 948 | 713 | 1,33x |
| LiveCodeBench v6, End-to-End (Tok./s) | 803 | 625 | 1,28x |
| GPQA, End-to-End (Tok./s) | 787 | 631 | 1,25x |
Die 292 Tokens pro Sekunde bei Batchgröße 1 entsprechen 62 Prozent der theoretischen Obergrenze, gegenüber 39 Prozent bei vLLM. Die Qualität bleibt unverändert: 38,9 Prozent gegenüber 38,2 bei SciCode und auf beiden Seiten 70,3 Prozent bei LiveCodeBench v6, jeweils als Durchschnitt aus sieben Durchläufen. Ein Detail verdient Aufmerksamkeit: Der Vorsprung hängt von der Verteilung der Experten ab, mit 1,32x beim tatsächlichen Routing des Modells gegenüber 1,14x bei simuliertem gleichmäßigem Routing, wodurch gleichmäßige Messungen zum ungünstigsten Fall werden. Cohere betont schließlich einen kontraintuitiven Punkt: Einen Megakernel zu schreiben sei einfacher, als sein Ruf vermuten lasse, mit einer einzigen CUDA-Datei, in der sechzehn Operationscodes den gesamten Decoding-Schritt abdecken. Die Einschränkungen werden eingeräumt und als Implementierungsgrenzen bezeichnet: nur Decoding, während das Prefilling weiterhin mit gewöhnlichen PyTorch-Kernels läuft, ausschließlich H100 und BF16 sowie Batchgrößen von 1 bis 8.
Anthropic dokumentiert, wie sich die Kosten für Claude Platform ohne Leistungsverlust senken lassen
8. September — Anthropic veröffentlicht einen Engineering-Leitfaden, der der verbreiteten Annahme widerspricht, dass eine niedrigere Agentenrechnung zwangsläufig schlechtere Ergebnisse bedeutet. Drei Hebel werden darin dokumentiert: die Trefferquote des Prompt Cache maximieren, beim Wechsel zu einem Frontier-Modell Prompt-Anti-Patterns entfernen und den Aufwand an die Aufgabe anpassen. Die Methode wird in Form ausführbarer Befehle für Claude Code bereitgestellt, wobei /claude-api prompt-audit und /claude-api hillclimb zu /claude-api cost-optimize hinzukommen.
| Benchmark, Sonnet-5-Basis | Kostensenkung | Gemessenes Detail |
|---|---|---|
| LegalBench | etwa 58 Prozent | Reasoning-Tokens von 102 779 auf 8 284 |
| tau2-bench retail | etwa 73 Prozent | Prompt Cache mit expliziten Breakpoints |
| OfficeQA Pro | etwa 52 Prozent | von 136,20 auf 64,87 Dollar |
| SWE-bench Verified | etwa 55 Prozent | mediane Schritte von 29 auf 17, Prompt-Tokens um mehr als die Hälfte reduziert |
Die praktisch relevanteste Zahl steht nicht in dieser Tabelle. Bei CursorBench 3.2 erreicht Claude Fable 5.1 mit niedrigem Aufwand dieselbe Leistung wie Fable 5 mit hohem Aufwand, und das zu einem Drittel der Kosten. Ein Teil davon ist auf den Preis für Cache-Lesevorgänge zurückzuführen, die mit 0,25 Dollar pro Million Tokens statt zuvor 1,00 Dollar abgerechnet werden. Umgekehrt bringt die höchste Aufwandsstufe bei Humanity’s Last Exam ohne Tools für 46 Prozent Mehrkosten etwa einen halben Punkt, ein Gewinn, der im Rauschen des Benchmarks untergeht.
🔗 Kosten auf Claude Platform senken
Claude Code 2.1.265: Plugin-Ordner, 1-GB-Obergrenze und Reparatur des Prompt Cache
8. September — Claude Code wird auf Version 2.1.265 aktualisiert und enthält fünfzig Changelog-Einträge, darunter vierunddreißig Fehlerbehebungen, zwei Tage nach einer Version 2.1.263 mit nur einem Eintrag. Die Option --plugin-dir akzeptiert nun einen vollständigen Plugin-Ordner; jeder Unterordner mit einem Manifest wird geladen, und während der Ausführung vorgenommene Ergänzungen und Löschungen werden erkannt. Für auf die Festplatte geschriebene Tool-Ergebnisse gilt eine Obergrenze von 1 GB, wobei die Vorschau darauf hinweist, wenn eine Datei gekürzt wurde.
Der umfangreichste Teil betrifft den Prompt Cache und knüpft an den am selben Tag veröffentlichten Leitfaden an. Zwei separate Korrekturen beheben Fälle, in denen Claude Code die Wiederverwendung des Cache selbst unterbrach: Beim Fortsetzen eines im Vordergrund gestarteten Sub-Agenten änderten sich dessen Tool-Liste und sein System-Prompt-Präfix, während Agententeammitglieder und fortgesetzte Sub-Agenten den Kontext der SubagentStart-Hooks und die vorgeladenen Skills aus dem Präfix verschoben. Zwei Korrekturen betreffen die Sicherheit: Ein Plugin-Pfad mit einem Backslash umging unter macOS und Linux die Prüfung der Symlink-Eingrenzung, und unter Windows verweigerten die Lese- und Schreib-Tools sämtliche Dateien in einem AppContainer oder einer Sandbox mit eingeschränktem Token. Das Lesen eines von Dritten geschriebenen Artefakts wird nun als nicht vertrauenswürdiger Inhalt behandelt.
Amp ersetzt die Nachrichtenwarteschlange durch direkte Steuerung
8. September — Amp ändert das Standardverhalten seines Agenten gegenüber Nachrichten, die während der Arbeit gesendet werden. Bisher wurde eine eingegebene Nachricht, während der Agent lief, in eine Warteschlange gestellt und erst nach Abschluss des Durchlaufs verarbeitet; nun wird sie bei der nächstmöglichen Gelegenheit zugestellt. Der Anbieter nennt zwei Vorteile: Der Agent berücksichtigt Feedback früher und beginnt keine Überprüfungsschritte mehr, die durch die neue Anweisung überflüssig geworden sind. Das spart Zeit und Tokens in dem häufigen Fall, dass man sieht, wie der Agent in die falsche Richtung läuft.
Die Änderung ist nicht ohne Nebenwirkungen, und Amp dokumentiert sie. Falls sich die Steuerung als zu abrupt erweist, empfiehlt der Anbieter, Anfragen als „When done, then…“ statt als „Now, …“ zu formulieren, um ausdrücklich anzugeben, dass die Anweisung nach der aktuellen Aufgabe gelten soll. Ship, Review und die anderen integrierten Aktionen behalten das bisherige Verhalten bei und bleiben in der Warteschlange, da die Arbeit im Allgemeinen abgeschlossen sein soll, bevor sie ausgeliefert oder eine Überprüfung gestartet wird. Das manuelle Einreihen bleibt sowohl in der Anwendung als auch im CLI verfügbar.
🔗 Steuern statt einreihen, Amp
Muse Spark 1.3 kommt zu Cursor und bietet das beste Verhältnis von Punktzahl zu Kosten bei CursorBench
8. September — Cursor fügt Muse Spark 1.3 hinzu, das agentische Modell von Meta Superintelligence Labs, sechs Tage nach seiner Vorstellung. Die veröffentlichten Zahlen erzählen keine Geschichte roher Leistung, sondern eine der Kosten. Bei CursorBench 3.2, dem hauseigenen Benchmark auf Grundlage realer Aufgaben mit mehreren Dateien, erreicht die Max-Stufe 67,9 Prozent bei 1,31 Dollar pro Aufgabe und belegt Rang zwölf.
| Modell und Stufe | CursorBench-3.2-Punktzahl | Kosten pro Aufgabe in Dollar | Tokens pro Aufgabe | Rang |
|---|---|---|---|---|
| Fable 5.1 Max | 73,4 Prozent | 9,64 | 72 060 | 1 |
| Grok 4.6 Extra High | 70,8 Prozent | 2,81 | 41 136 | 3 |
| Opus 5 Max | 70,0 Prozent | 8,23 | 61 838 | 5 |
| Gemini 3.8 Flash High | 69,2 Prozent | 2,38 | 81 524 | 9 |
| Muse Spark 1.3 Max | 67,9 Prozent | 1,31 | 33 034 | 12 |
| GPT-5.6 Sol Max | 67,2 Prozent | 5,69 | 28 320 | 13 |
| Muse Spark 1.3 Low | 55,0 Prozent | 0,45 | 12 181 | 49 |
Das Modell von Meta liegt bei der Punktzahl somit weit hinter Claude Fable 5.1 Max, doch Letzteres kostet pro Aufgabe mehr als siebenmal so viel. Vor allem liegt es vor GPT-5.6 Sol in dessen Max-Stufe und kostet dabei mehr als viermal weniger. Cursor hält an seiner Methode fest, für jedes neu hinzugefügte Modell systematisch Punktzahl und Kosten pro Aufgabe zu veröffentlichen, statt lediglich dessen Verfügbarkeit bekannt zu geben.
Grok Bot lässt Formulare und Anmeldedaten direkt im Chat ausfüllen, Grok Imagine erhält Keyframe-Steuerung
8. September — SpaceXAI ermöglicht es nun, Formulare und Anmeldeseiten für seinen Grok Bot auszufüllen, ohne die Unterhaltung zu verlassen, und kündigt Unterstützung für jeden Passwortmanager an. Die Funktion adressiert einen Reibungspunkt, der für persistente Agenten typisch ist: Sobald der Agent einen Anmeldebildschirm überwinden oder ein Formular mit personenbezogenen Daten absenden muss, benötigt er entweder gespeicherte Anmeldedaten oder einen Eingriff des Nutzers. Diesen Schritt in den Gesprächsverlauf statt in eine separate Browsersitzung zu verlagern, ist sowohl eine Entscheidung für die Benutzerfreundlichkeit als auch für die Sicherheit.
Zwei Stunden später erhält Grok Imagine die Kontrolle über die Anfangs- und Endbilder einer Videoszene sowie die Generierung nahtloser Schleifen, zusammen mit einer verbesserten Befolgung von Anweisungen und einer nach eigenen Angaben höheren Videoqualität. Die Keyframe-Steuerung verändert das Werkzeug für diejenigen, die aufeinanderfolgende Einstellungen produzieren: Wird das letzte Bild einer Einstellung festgelegt, kann es als erstes Bild der nächsten wiederverwendet werden. So lassen sich Sequenzen aneinanderreihen, deren Kontinuität nicht mehr vom Zufall der Generierung abhängt. Die Ankündigung erfolgt drei Tage nach der Inbetriebnahme des vom Modell Image 2.0 angetriebenen Agenten Grok Imagine Video 1.5.
🔗 Formulare in Grok Bot ausfüllen · 🔗 Keyframes in Grok Imagine
Drei Forschungsbeiträge im Hugging-Face-Blog
8. September — Drei Veröffentlichungen aus der Hugging-Face-Community sind am selben Tag lesenswert und behandeln Wetter, Modellsicherheit und von Lebewesen inspirierte Modelle.
Ein offenes Wettermodell ohne GPU ausführen
Hugging Face und Earthmover veröffentlichen einen gemeinsamen Beitrag zu einem selten behandelten Problem: Wettermodelle auf Basis maschinellen Lernens sind leichtgewichtig genug, um auf einem Laptop zu laufen, und dennoch führt sie fast niemand aus. Drei Hindernisse werden identifiziert: die Rechenleistung — mehrere Modelle, darunter AIFS, hängen von Flash Attention ab, das auf bestimmte Grafikkartenarchitekturen beschränkt ist —, der Speicherplatz und vor allem die Bandbreite, da pro Vorhersage etwa 1 GB an Anfangsbedingungen anfällt. Die Antwort besteht aus drei öffentlichen Artefakten: einem Demo-Space, einem Speicher-Bucket und einem reproduzierbaren Tutorial, das Aurora, das Modell von Microsoft, in der auf 0,25 Grad vortrainierten Version mit ERA5-Anfangsbedingungen ausführt, die über den Earthmover-Datenmarktplatz bereitgestellt werden. Eine GPU ist nicht erforderlich: zwei bis drei Minuten pro Rechenschritt auf einem Prozessor, wenige Sekunden auf einer Grafikkarte und vier Sechs-Stunden-Schritte für eine 24-Stunden-Vorhersage, die anschließend mit ERA5 verglichen wird.
🔗 Offene Wettermodelle mit Earthmover
Ein vermeintlich sichereres Modell, das drei Viertel der harmlosen Fragen ablehnt
Multiverse Computing veröffentlicht ein Ergebnis, das weit über die Alignment-Forschung hinaus Beachtung finden sollte. Durch das Training von Qwen3-8B darauf, Anfragen zur politischen Manipulation abzulehnen, erzielt das Team Zahlen, die wie ein eindeutiger Erfolg aussehen: Die durchschnittliche Rate gefährlicher Antworten bei HarmBench, StrongREJECT und WildJailbreak sinkt von 26,26 auf 0,14 Prozent. Am selben Checkpoint steigt die übermäßige Ablehnung bei XSTest von 2,00 auf 74,00 Prozent. Anders gesagt ist die auf dem Papier sicherste Konfiguration eine Ablehnungsmaschine, und keine der üblichen Messungen macht dies sichtbar. Zwei Korrekturen schaffen Abhilfe: Werden externe konforme Antworten durch verifizierte Antworten des Zielmodells ersetzt, sinkt die übermäßige Ablehnung bei XSTest von 15,20 auf 5,20 Prozent; durch das Hinzufügen gutartiger Grenzfallpaare fällt die übermäßige Ablehnung auf der zu beantwortenden Seite von 32,94 auf 4,16 Prozent, während die Ablehnung auf der schädlichen Seite nur vier Punkte verliert.
🔗 Sicherheit für wen, Multiverse Computing
Ein Fliegenkonnektom schlägt nicht seine eigene durchmischte Verdrahtung
Oruk veröffentlicht eine methodische Lektion, die über von Konnektomen inspirierte Modelle hinausreicht. Das Team kopierte 499 stark vernetzte Neuronen aus der öffentlichen MaleCNS-Rekonstruktion einer Fliege in ein rekurrentes Netzwerk, das als Reservoir dient, und trainierte darüber nur einen einzigen Ridge-Readout. Die Verdrahtung der Fliege erreicht im Test eine durchschnittliche Genauigkeit von 16,84 Prozent, eine durchmischte Verdrahtung 16,88 Prozent: Der Unterschied beträgt minus 0,04 Punkte, mit einem Konfidenzintervall, das null einschließt. Das zweite Experiment hätte als Beweis des Gegenteils erscheinen können, da die Entfernung der 50 Neuronen mit den größten Normen der Readout-Gewichte die Genauigkeit von 16,91 auf 10,83 Prozent fallen lässt. Die Autoren erklären, warum darin kein Widerspruch liegt: Eine spektakuläre Ablation beweist niemals, dass eine biologische Topologie notwendig war. Erwähnenswert ist, dass der Beitrag selbst angibt, von einem KI-Agenten auf Grundlage eines nicht begutachteten Artikels erstellt worden zu sein, und dass der vollständige Evaluierungsdatensatz privat bleibt.
🔗 Konnektom und durchmischte Verdrahtung, Oruk
Runway holt das Team des Pariser Labors Kinetix
8. September — Runway gibt bekannt, dass das Team von Kinetix, einem in Paris ansässigen KI-Forschungslabor, zum Unternehmen stößt. Das Labor arbeitete an menschlicher Bewegung in 3D und an physikbasierter Videogenerierung, zwei Themen, die Runway unmittelbar mit seiner Forschung an Weltmodellen für die Robotik verknüpft. Das Team wird in den Pariser Standort des Unternehmens integriert, der außerdem vor Ort Mitarbeiter für Forschung und Engineering sucht.
Das technische Argument lässt sich auf einen Satz aus der Ankündigung reduzieren: Ein wirklich nützlicher Roboter muss neuartige Umgebungen, Aufgaben und Situationen verstehen und bewältigen, und groß angelegtes Video-Pretraining bietet laut Runway den effizientesten Weg, diese Generalisierungsprobleme zu lösen. Dies ist die direkte Fortsetzung von Solaris, das am 31. August vorgestellt wurde, und GWM Worlds 2, das am 3. September präsentiert wurde: Nachdem Runway Modellen beigebracht hat, die Welt zu simulieren, will das Unternehmen ihnen nun beibringen, darin zu handeln. Yassine Tahi, Geschäftsführer von Kinetix, datiert die Gründungswette des Labors auf sechs Jahre zurück. Zur Höhe oder Struktur der Transaktion werden keine Angaben gemacht.
🔗 Kinetix schließt sich Runway an
Sarah Friar beziffert die Größenordnung von OpenAI und die Auswirkungen seiner Modelle auf die Kosten
8. September — Sarah Friar veröffentlicht einen Gastbeitrag darüber, wie OpenAI seine Forschungsfortschritte in wirtschaftliche Aktivität umwandelt. Interessant ist der Text eher wegen dreier neuer Zahlen als wegen seiner Argumentation.
| Kennzahl | Wert |
|---|---|
| Wöchentlich aktive Nutzer | mehr als eine Milliarde |
| Unternehmenskunden | 2,5 Millionen |
| Tägliche Nachrichten nach sechs Monaten, Einzeltarife | rund 50 Prozent mehr als im ersten Monat |
| Nach sechs Monaten ausprobierte unterschiedliche Aufgaben | etwa doppelt so viele |
| End-to-End-Betriebskosten nach der Optimierung | 20 Prozent weniger |
| Effizienz der Token-Generierung | mehr als 15 Prozent |
Die dritte Zahl schließt einen interessanten Kreis. GPT-5.6 Sol wurde eingesetzt, um OpenAIs produktive Betriebssoftware zu verbessern, wodurch die Betriebskosten um 20 Prozent sanken und die Effizienz der Token-Generierung um mehr als 15 Prozent stieg. Anders gesagt finanziert das Modell einen Teil seiner eigenen Infrastruktur, indem es die Schicht optimiert, über die es bereitgestellt wird. Die Entwicklung der individuellen Nutzung beantwortet zudem eine häufig gestellte und selten dokumentierte Frage: die nach der Nutzerbindung.
🔗 Arbeit jetzt in Reichweite, OpenAI
OpenAI stellt 5 Millionen Dollar für unabhängige Forschung zu Jugendlichen bereit
8. September — OpenAI startet ein mit 5 Millionen Dollar ausgestattetes Förderprogramm für unabhängige Forschung zu den Auswirkungen generativer KI auf 13- bis 17-Jährige, mit einem ausdrücklichen Schwerpunkt auf der sozialen und emotionalen Entwicklung. Einzelne Förderungen betragen bis zu 1 Million Dollar pro Projekt. Die Bewerbungsfrist endet am 6. Oktober 2026, ausgewählte Projekte werden spätestens am 13. November 2026 benachrichtigt, ein Zwischenbericht wird im ersten Quartal 2027 erwartet, und die Gemeinkosten sind auf 10 Prozent je Förderung begrenzt.
Zwei Details verdienen Beachtung. Das erste betrifft die beanspruchte Unabhängigkeit: Zu den Bewertungskriterien gehört die Fähigkeit des Projekts, verlässliche Ergebnisse hervorzubringen, unabhängig davon, ob sie für Anbieter von KI-Produkten günstig ausfallen oder nicht; eine Veröffentlichung wird gefördert, ist aber keine Voraussetzung für die Finanzierung. Das zweite ist administrativer Natur, aber bedeutsam: Die Förderungen werden von OpenAI Group PBC, der kommerziellen Einheit, und nicht von der OpenAI Foundation finanziert und verwaltet. Der Zeitplan ist nicht neutral: OpenAI hatte am 31. August seine Unterstützung für den kalifornischen Gesetzentwurf zum Schutz Minderjähriger vor KI erklärt, und der Beitrag gibt als Ziel an, Entscheidungsgrundlagen für Regulierungsbehörden bereitzustellen.
🔗 Forschungsförderungen zu Jugendlichen
Kurzmeldungen
- Boris Cherny bewertet andere Labore öffentlich hinsichtlich des Risikos von Prompt Injection — der Schöpfer von Claude Code sieht das neue Modell von OpenAI bei Prompt Injection auf dem Niveau von Gemini Flash und Opus 4.8 und steht dazu, die Labore öffentlich beim Namen zu nennen, solange sie Sicherheit nicht ernster nehmen. Rund zwanzig Minuten später mäßigt er den Ton in einer Antwort auf seinen eigenen Thread. 🔗 Beitrag
- Anthropic veröffentlicht ein Video über Gründer, die auf Claude Managed Agents aufbauen — Gespräche mit den Gründern von Wispr Flow, Actively und Pendo über die Nutzung von Outcomes, Sandbox und Speicher für die Skalierung. 🔗 Beitrag
- RelayShield scannt Anweisungsdateien statt des Codes von Repositories — ein kostenpflichtiger Dienst, der AGENTS.md, CLAUDE.md, .cursorrules und mcp.json liest, um feindselige Anweisungen in natürlicher Sprache zu erkennen, die eine statische Analyse nicht erfasst. Eine im Beitrag genannte Zahl bösartiger Repositories stimmt nicht mit der eigenen Quelle überein. 🔗 Artikel
- Ai2 kündigt seine Teilnahme an der ECCV 2026 an — über die Konferenz verteilte Fachartikel und Vorträge, ohne dass Titel oder Programm mitgeteilt wurden. 🔗 Beitrag
- Prismberry veröffentlicht einen Essay über die Werkzeugschicht von Unternehmensagenten — ein Positionierungstext, der zwischen Informations-, Analyse- und Aktionswerkzeugen unterscheidet, ohne Ankündigung oder Messwerte, und das Produkt Agent IQ seines Herausgebers bewirbt. 🔗 Artikel
- Ein Wartungsprotokoll für Hardware im Blog von Hugging Face — Diagnose des Verschleißes eines Lagers am Lüfter eines 650-W-Netzteils, ohne Bezug zu künstlicher Intelligenz. 🔗 Artikel
- Missouri stellt Gemini for Education 1,1 Millionen Schülern und Studierenden zur Verfügung — eine landesweite Partnerschaft, die fast 100.000 Lehrkräften und mehr als 1,1 Millionen Schülern und Studierenden kostenlosen Zugang zu Gemini for Education, Gemini Notebook und Google-Zertifizierungen gewährt, wobei die Daten vom Training ausgeschlossen sind und jede Bildungseinrichtung selbst über die Einführung entscheidet. 🔗 Ankündigung
- Dependabot liest private GitHub-Registrys ohne persönlichen Token — das
GITHUB_TOKENvon Dependabot kann die Berechtigungpackages: readanfordern und Pakete aus privaten GitHub-Packages-Registrys abrufen. Die im Juni eingeführte und anschließend zurückgenommene Funktion kehrt zurück, wobei automatische Zugangsdaten nur noch als Ausweichlösung dienen. 🔗 Changelog - Das Supportportal von GitHub zieht zu help.github.com um — Support, Dokumentation, Lernangebote, Community und Kontoressourcen werden an einem Ort gebündelt, einschließlich einer von Copilot unterstützten Suche, für die keine Anmeldung erforderlich ist. 🔗 Changelog
- Genspark eröffnet während der SF Tech Week das Spark House mit frühem Zugang zu GenTeam — eine Community-Aktion, die Teilnehmern frühen Zugang zu GenTeam und vertrauliche Gespräche zwischen Gründern und Investoren bietet. 🔗 Beitrag
- Ethan Tandowsky wird Finanzvorstand von ElevenLabs — die zweite Ernennung einer Führungskraft binnen sechs Tagen bei ElevenLabs, nachdem Ashley Kramer am 2. September zur Umsatzchefin ernannt worden war. 🔗 Beitrag
- MiniMax bringt in Tokio japanische Stimmen aus der Unterhaltungsbranche und vier Akteure der generativen KI zusammen — Veranstaltung am 11. September in Shibuya mit dem Produzenten Yasushi Akimoto, KADOKAWA, KAGAMIAI, Higgsfield, Krea, Runway und HeyGen, ohne Produkteinführung oder Kennzahlen. 🔗 Beitrag
- Zwei Übertragungen von Nemotron Labs am selben Tag, zu OpenShell und Domyn — 49 Minuten 44 Sekunden über die Absicherung autonomer Agenten durch OpenShell, 54 Minuten 20 Sekunden über die Nutzung von Nemotron durch Domyn, ohne Beschreibungstext oder Transkript. 🔗 Beitrag
- HeyGen stellt zwei Avatare desselben Gesichts gegenüber, ohne ein Werkzeug oder Modell zu nennen — Marketingvergleich ohne genanntes Konkurrenzwerkzeug, angeführtes Modell oder Messwerte. 🔗 Beitrag
- OpenAI weitet sein Journalismusprogramm auf Journalistenschulen aus — mehr als 400 ChatGPT-Edu-Abonnements für Masterstudierende und Lehrkräfte der Newmark J-School von CUNY und der Medill School von Northwestern für 2026–2027. 🔗 Ankündigung
- Perplexity veröffentlicht einen Leitfaden zur Kapitalrendite der KI-Integration — ein pädagogischer Beitrag ohne Produktankündigung, dessen sämtliche Zahlen von Dritten oder aus Kundenberichten stammen. 🔗 Artikel
Was das bedeutet
Der persönliche Agent wird zu einem Infrastrukturprodukt, und seine Sicherheit wird zu einem eigenständigen Produkt. Meta liefert nicht nur Muse aus: Das Unternehmen veröffentlicht am selben Tag die bislang detaillierteste Beschreibung dazu, wie sich ein Agent eindämmen lässt, der über eine Shell, einen Browser und Zugriff auf ein E-Mail-Postfach verfügt. Am aufschlussreichsten ist die Entscheidung für Ersatztoken, durch die Prompt Injection beim Diebstahl von Zugangsdaten ins Leere läuft – nicht weil das Modell widerstandsfähiger wäre, sondern weil es das Geheimnis nie besessen hat. Tainted Egress folgt derselben Logik: Man vertraut nicht dem Modell, sondern instrumentiert den Kernel. Das Bug-Bounty-Programm mit einer Prämie von 300.000 Dollar und die Offenheit des Fazits, das einräumt, dass Muse Fehler machen wird, sagen dasselbe aus wie Boris Cherny, wenn er andere Labore öffentlich hinsichtlich dieses Risikos bewertet. Die Sicherheit von Agenten ist kein Kästchen mehr, das man abhakt, sondern eine technische Angriffsfläche, die man offenlegt und für deren Aufbrechen man bezahlt.
Der Tag ist auch eine Lektion in der Ökonomie der KI, und die Recheneinheit ist nicht mehr der Score, sondern die Kosten pro Aufgabe. Mistral nimmt 3 Milliarden Euro bei einer Bewertung von mehr als 21 Milliarden auf, Cognition mehr als 2 Milliarden bei einer Bewertung von 48 Milliarden, wobei in beiden Fällen Industrieunternehmen und Kunden statt ausschließlich Technologiefonds mit am Tisch sitzen. Gleichzeitig veröffentlicht Cursor eine Übersicht, in der Muse Spark 1.3 für 1,31 Dollar pro Aufgabe 67,9 Prozent erreicht, während der Spitzenreiter für sechs Prozentpunkte mehr 9,64 Dollar bezahlt. Anthropic dokumentiert Kostensenkungen von 52 bis 73 Prozent ohne Leistungsverlust und zeigt, dass ein stärkeres Modell bei geringerem Aufwand häufig ein schwächeres Modell schlägt, das bis an seine Grenzen getrieben wird. Sarah Friar beziffert das andere Ende der Kette: Die Betriebskosten wurden um 20 Prozent gesenkt, indem GPT-5.6 Sol die Schicht optimierte, über die es bereitgestellt wird. Das sind vier Arten auszudrücken, dass sich die Abwägung von der Leistungsfähigkeit hin zu deren Preis verschoben hat.
Auf wissenschaftlichem Gebiet lautet die Frage nicht mehr, ob Agenten Ergebnisse produzieren, sondern wie diese überprüft werden. OpenAI kündigt einen Singularitätsbeweis für Navier-Stokes an, der von rund 10.000 Agenten in 88 Stunden erstellt und in Lean formalisiert wurde, ohne erwähnte Begutachtung durch Fachkollegen oder institutionelle Validierung und unter Einsatz eines internen Modells, das niemand außerhalb des Unternehmens befragen kann. Die Zurückhaltung des Unternehmens, das auf den Millennium-Preis verzichtet und von einer Momentaufnahme spricht, ist selbst eine Information. Die beiden anderen Arbeiten des Tages verdeutlichen den Kontrast: Am MIT bewältigt Codex klar definierte Protokolle, scheitert aber an mehrdeutigen Signalen, und ein erfahrener Forscher bleibt schneller; bei Google DeepMind erhebt AlphaGenome Atlas nicht den Anspruch, etwas zu beweisen, sondern berechnet 9 Milliarden Vorhersagen vorab und verlagert den Aufwand auf die experimentelle Validierung. Oruks Beitrag rundet die Demonstration ab, indem er zeigt, dass eine spektakuläre Ablation ohne einen paarweisen Vergleich nichts beweist, und der Beitrag von Multiverse Computing erinnert daran, dass eine Sicherheitskennzahl nichts aussagt, solange die gutartige Seite nicht mit derselben Strenge gemessen wird.
Bleibt die unterste Schicht, in der die Fortschritte nicht mehr aus den Gewichten kommen. Cohere öffnet eine vollständige Serving-Engine, deren einzige Änderung in der Beseitigung der Kernel-Grenzen besteht und die bei identischer Qualität den 1,58-fachen Durchsatz von vLLM erreicht. Dabei betont das Unternehmen, dass die Schwierigkeit, einen Megakernel zu schreiben, überschätzt werde. NVIDIA eröffnet zwei Wege, GPU-Kernel in Rust zu schreiben. Einer davon wird außerhalb des Unternehmens bereits in der Inferenz-Engine Grout von Hugging Face und in mistral.rs eingesetzt, wobei NVIDIA offen einräumt, dass nichts davon produktionsreif ist. Bei der AI City Challenge beruhen vier der fünf besten Videolösungen auf mit LoRA angepassten Cosmos-Modellen; das Siegerteam betont, dass es sich um ein Anpassungsrezept und nicht um eine neue Architektur handelt. Das Wetter-Tutorial von Earthmover erzählt vom anderen Ende her dieselbe Geschichte: Das Modell Aurora läuft auf einem Prozessor; der Engpass war nicht die Rechenleistung, sondern das Gigabyte an Anfangsbedingungen, das heruntergeladen werden musste. In jedem Fall liegt der Wert in der Technik rund um das Modell, und sie wird veröffentlicht.
Quellen
- Einführung von Muse, Meta
- Sicherheit und Schutz von Agenten mit Muse, Meta
- Serie D von Mistral
- Ankündigung der Serie D auf X
- Lösung des Navier-Stokes-Problems, OpenAI
- OpenAI-Thread zum internen Modell
- Codex und Quantencomputerexperimente am MIT
- ChatGPT Images 2.5, OpenAI
- Manus integriert GPT-Image-2.5
- AlphaGenome Atlas, Google DeepMind
- CUDA Rust, NVIDIA
- AI City Challenge der ECCV 2026, NVIDIA
- Serie E von Cognition
- Cognition-Thread auf X
- Partnerschaft zwischen Suno, Believe und TuneCore
- Decoding-Megakernel, Cohere
- Kosten auf der Claude Platform senken, Anthropic
- Claude Code 2.1.265
- Live-Steuerung des Agenten, Amp
- Muse Spark 1.3 in Cursor
- Ausfüllen von Formularen in Grok Bot
- Keyframes und Schleifen in Grok Imagine
- Offene Wettermodelle mit Earthmover, Hugging Face
- Sicherheit für wen, Multiverse Computing
- Fliegenkonnektom und vermischte Verdrahtung, Oruk
- Kinetix schließt sich Runway an
- Gastbeitrag von Sarah Friar, OpenAI
- Forschungsförderungen zu Jugendlichen, OpenAI
- Boris Cherny über das Risiko von Prompt Injection
- Gründer, die auf Claude Managed Agents aufbauen
- RelayShield und Anweisungsdateien
- Ai2 auf der ECCV 2026
- Die Werkzeugschicht von Agenten, Prismberry
- Wartungsprotokoll für Hardware
- Gemini for Education in Missouri
- Dependabot und private GitHub-Registrys
- Neues GitHub-Supportportal
- Spark House während der SF Tech Week, Genspark
- Ethan Tandowsky, Finanzvorstand von ElevenLabs
- MiniMax-Veranstaltung in Tokio
- Übertragungen von Nemotron Labs
- Vergleich von HeyGen-Avataren
- Journalismusprogramm von OpenAI
- Leitfaden zur Kapitalrendite der KI, Perplexity