ai-powered-markdown-translatorArtigo traduzido do fr para o pt com gpt-5.6-sol.
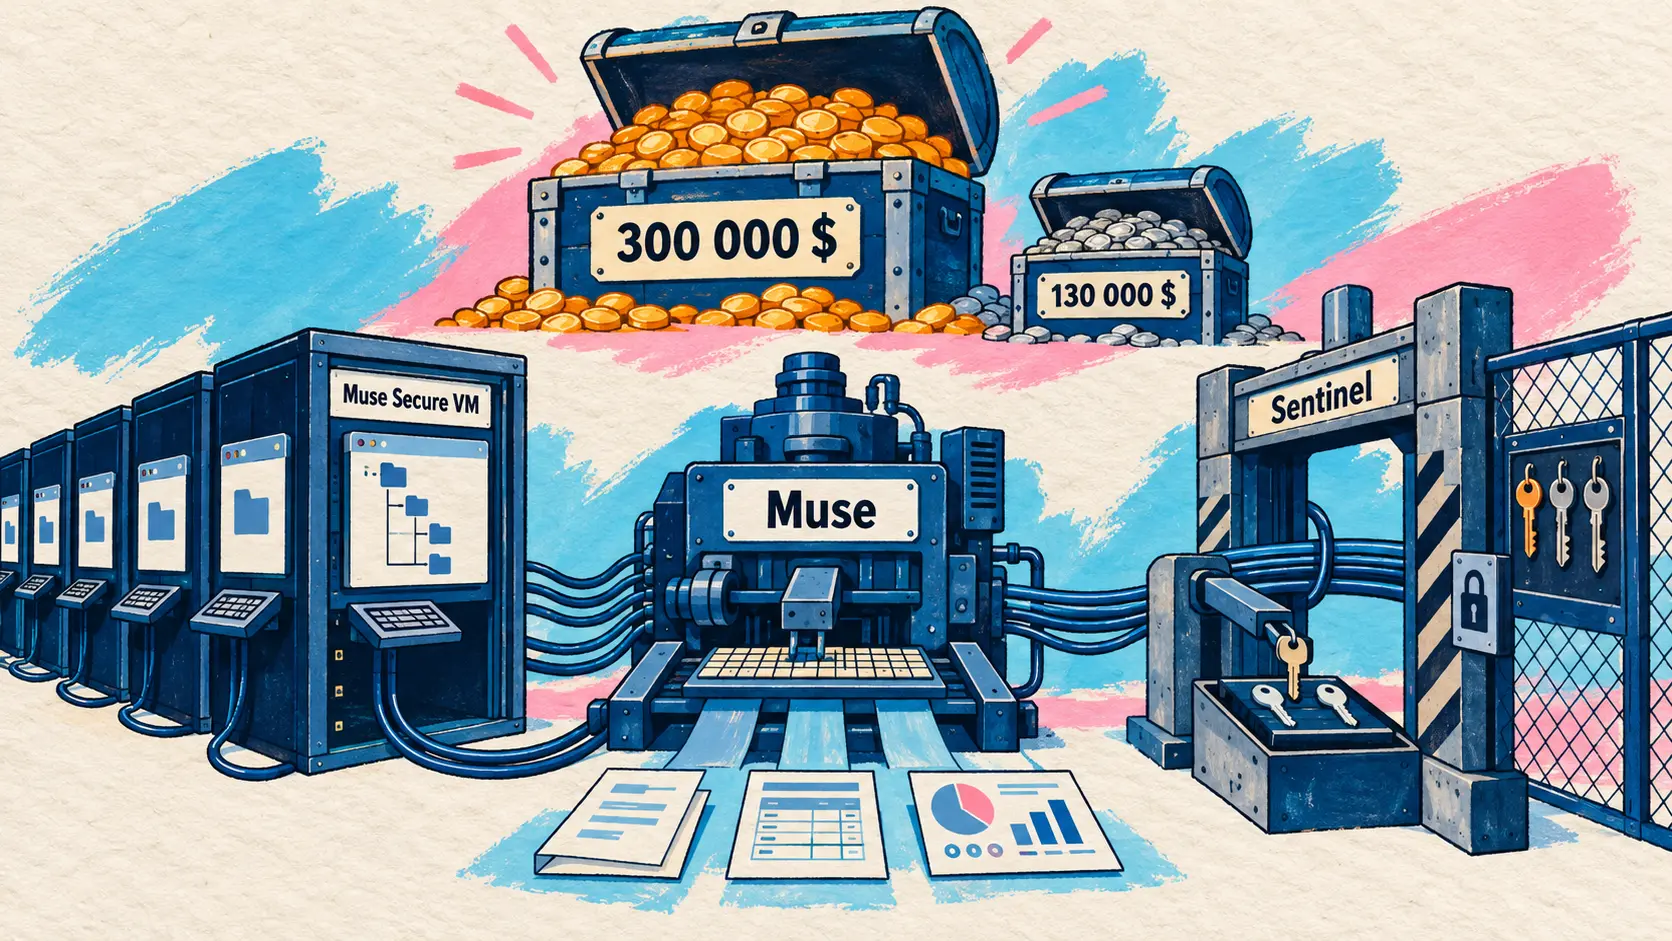
A Meta lança o Muse, um agente pessoal que dá a cada utilizador a sua própria máquina Linux na cloud, e publica no mesmo dia a arquitetura de segurança que o protege, com um programa de recompensas por vulnerabilidades (bug bounty) aberto a todos, com prémios até 300 000 dólares. A Mistral anuncia uma Série D de 3 mil milhões de euros, a maior captação de capital alguma vez concluída por uma empresa tecnológica europeia. Por seu lado, a OpenAI publica uma prova de singularidade em tempo finito para as equações de Navier-Stokes, produzida por um sistema de agentes, e a Google DeepMind calcula antecipadamente o efeito das 9 mil milhões de mutações possíveis do ADN humano.
Meta lança o Muse, o seu agente pessoal, e publica a respetiva arquitetura de segurança
8 de setembro — A Meta lança o Muse, um agente pessoal disponível em aplicações iOS e Android, numa interface web e no WhatsApp, equipado com o Muse Spark 1.3. O modelo não é novo: chegou a 2 de setembro ao Muse Code e à Meta Model API, e o seu nível máximo de raciocínio foi disponibilizado ao público a 4 de setembro. A novidade é o produto destinado ao grande público que foi construído em torno dele.
A arquitetura assenta numa ideia simples de enunciar e difícil de implementar: cada utilizador recebe o seu próprio computador na cloud. A Muse Secure VM é uma máquina Linux persistente e isolada, dotada de um sistema de ficheiros, um terminal e um navegador completo, com armazenamento, processador e memória suficientes para compilar código, desenvolver skills personalizadas e executar subagentes em paralelo. É esta máquina, e não uma infraestrutura centralizada da Meta, que serve como sistema de referência para os dados e as credenciais dos serviços ligados. Quando falta uma ferramenta para uma tarefa, o próprio agente escreve-a e produz objetos manipuláveis em vez de blocos de texto: itinerários, PDF, páginas web e painéis, a que a Meta chama Artifacts.
A segunda rutura reivindicada é o facto de o agente trabalhar em segundo plano com a aplicação fechada, mediante agendamento e em reação a eventos, decidindo depois se o resultado merece uma notificação. A memória é persistente, legível e modificável pelo utilizador, e um separador Objetivos oferece uma visão geral daquilo que o agente acompanha. Resta aquilo que a Meta não diz: não foi publicado qualquer preço nem o lançamento é acompanhado por uma lista dos países onde estará disponível.
Vinte minutos depois do anúncio do produto, a Meta publicou um documento de engenharia assinado por Tarek Sheasha, engenheiro de software e vice-presidente da Meta Superintelligence Labs, sobre a segurança deste sistema. O princípio orientador é estabelecido desde o início: o sistema foi concebido partindo do pressuposto de que o agente será atacado. O agent harness, chamado Hatch no código, é executado num contentor systemd-nspawn cujo root é mapeado para um utilizador não privilegiado do anfitrião, com chamadas de sistema filtradas e capacidades do kernel removidas. Quatro serviços funcionam deliberadamente fora deste contentor, para que um atacante que comprometa o agente não possa desativá-los: os classificadores de segurança, os workers com privilégios separados, o daemon de armazenamento de credenciais e o Sentinel.
O Sentinel é a peça central: enquanto única autoridade capaz de autorizar uma ação de conector ou uma saída de rede, avalia cada pedido nas camadas 4 e 7 e verifica o endereço efetivamente resolvido. Acima de tudo, o agente apenas manipula tokens substitutos, que são trocados pelas credenciais reais na fronteira da rede. Fazer com que o agente revele um segredo através de prompt injection torna-se irrelevante, pois ele nunca teve acesso a esse segredo. A isto junta-se um acompanhamento de fluxos ao nível do kernel, o tainted egress: qualquer processo que leia dados do utilizador é marcado e perde a sua autorização automática. A implementação combina programas eBPF associados a cgroups e hooks do Linux Security Module adicionados pela Meta.
| Elemento da arquitetura | Opção adotada |
|---|---|
| Contentor do agent harness | systemd-nspawn, root mapeado para um utilizador não privilegiado |
| Autoridade de autorização | Sentinel, fora do contentor, camadas 4 e 7 |
| Credenciais vistas pelo agente | apenas tokens substitutos |
| Conector de e-mail | filtragem de códigos de utilização única e de ligações de reposição |
| Subagente de navegação | árvore de acessibilidade, sem DOM bruto nem JavaScript na página |
| Pagamentos | Stripe Link no lançamento, Shop Pay posteriormente, cartão de utilização única |
| Bug bounty, limite por relatório válido | 300 000 dólares |
| Bug bounty, prompt injection | até 130 000 dólares |
O documento é acompanhado por dois anúncios. O programa de recompensas por vulnerabilidades abre a todos logo no lançamento, com prémios até 300 000 dólares por relatório válido, em função do impacto demonstrado, incluindo até 130 000 dólares por uma prompt injection bem-sucedida que afete um utilizador. Além disso, a Muse Confidential VM, prevista até ao final do ano, deverá impedir de forma criptográfica e verificável que a Meta aceda aos dados de uma máquina virtual, estando a conceção e o código-fonte já submetidos a auditores externos. A conclusão do texto é invulgarmente franca para uma publicação empresarial: a prompt injection continua a ser um problema em aberto no setor e o Muse cometerá erros.
🔗 Lançamento do Muse · 🔗 Segurança e proteção dos agentes, Meta
Mistral capta 3 mil milhões de euros, a maior captação de capital da tecnologia europeia
8 de setembro — A Mistral anuncia uma Série D de 3 mil milhões de euros, com uma avaliação post-money superior a 21 mil milhões de euros. A empresa apresenta esta ronda como a maior captação de capital alguma vez concluída por uma empresa tecnológica europeia, três anos após a sua criação.
A Samsung Electronics lidera a operação. O Scaleup Europe Fund, gerido pela EQT, e a PSG Equity, já acionista, colideram-na. Três novos investidores juntam-se à estrutura acionista: a Advent, fundos e contas geridos pela BlackRock e o Grão-Ducado do Luxemburgo. A lista de investidores existentes é extensa e abrange três continentes, desde a a16z à Salesforce Ventures, passando pela ASML, BNP Paribas CIB, Bpifrance, DST Global, General Catalyst, Index Ventures, Korelya Capital, Lightspeed e NVIDIA.
O pormenor que merece atenção é a natureza dos dois líderes sucessivos. A ASML liderou a Série C e a Samsung Electronics lidera a Série D: duas empresas de fabrico avançado, não fundos tecnológicos generalistas. A Mistral interpreta este facto como um sinal de confiança na sua capacidade de implementar modelos de ponta em ambientes industriais complexos, nos quais o controlo dos dados e da infraestrutura condiciona a adoção.
| Indicador | Valor |
|---|---|
| Montante captado | 3 mil milhões de euros |
| Avaliação post-money | mais de 21 mil milhões de euros |
| Idade da empresa | 3 anos |
| Líder | Samsung Electronics |
| Colíderes | Scaleup Europe Fund gerido pela EQT, PSG Equity |
| Países de operação | 20 |
| Grandes clientes empresariais | mais de 125, incluindo Airbus, ASML e HSBC |
Quanto à utilização dos fundos, a empresa cita em primeiro lugar a investigação de fronteira, seguida pelo aumento da capacidade computacional para o treino, pela expansão da infraestrutura e pela aceleração comercial a nível internacional. A argumentação retoma a linha defendida desde o verão: a questão colocada pelas organizações já não seria saber quem constrói o modelo mais poderoso, mas sim como explorar a IA sem ceder o controlo da sua infraestrutura. A Mistral descreve-se como a única empresa do setor que reúne toda a stack necessária, desde modelos com pesos abertos até aos produtos, passando pela capacidade computacional.
Today marks a major step for Mistral: we’re announcing a €3B Series D, the largest equity round ever raised by a European tech company, just three years after launch.
🇵🇹 Hoje assinala uma etapa importante para a Mistral: anunciamos uma Série D de 3 mil milhões de euros, a maior captação de capital alguma vez realizada por uma empresa tecnológica europeia, apenas três anos após o nosso lançamento. — @MistralAI no X
Os agentes científicos da OpenAI: uma prova sobre Navier-Stokes e qubits calibrados no MIT
8 de setembro — A OpenAI publica uma prova da formação de uma singularidade em tempo finito para as equações tridimensionais de Navier-Stokes, acompanhada por uma formalização no assistente de provas Lean. O resultado anunciado é que um fluido tridimensional inicialmente liso e em repouso, sujeito a uma força externa lisa, pode ver a sua velocidade crescer sem limite num tempo finito, embora a viscosidade tenda a suavizar o movimento e a energia do sistema permaneça finita. Na formulação oficial do Clay Mathematics Institute, isto corresponde aos enunciados «C» e «D», que constituem uma refutação, e não uma prova de regularidade.
Importa expor com precisão aquilo que a OpenAI reivindica e aquilo que não reivindica. A prova foi produzida por um sistema de agentes coordenados apoiado por um modelo interno sem nome público, descrito pela empresa como significativamente mais capaz do que o GPT-6 Astra e cujo treino prossegue desde 28 de agosto. A única verificação descrita é a formalização em Lean, entregue ao GPT-6 Astra e concluída 17 horas após a resolução. O anúncio não menciona qualquer revisão por pares nem qualquer validação pelo Clay Mathematics Institute, e a OpenAI afirma não pretender reclamar o Prémio do Milénio, apresentando o seu resultado como um instantâneo e não como uma conclusão definitiva.
O método é pelo menos tão notável como o resultado. O esforço começou a 1 de setembro, após rumores de que dois problemas do milénio tinham acabado de ser resolvidos. Grupos distintos de agentes receberam diferentes variantes do enunciado, com as versões «A» e «B» orientadas para uma prova e as versões «C» e «D» para uma refutação. Num problema relacionado, a regularidade das equações de Euler sem forçamento, cerca de 100 agentes produziram uma refutação em aproximadamente cinquenta horas; este resultado foi reinjetado nos prompts dos agentes que trabalhavam em Navier-Stokes.
| Métrica | Valor |
|---|---|
| Agentes concorrentes, grupo Navier-Stokes | cerca de 10 000 |
| Tempo até à resolução | cerca de 88 horas |
| Formalização e verificação em Lean | mais 17 horas, através do GPT-6 Astra |
| Mensagens trocadas, Navier-Stokes | 2,7 milhões |
| Tokens de saída, Navier-Stokes | cerca de 130 mil milhões |
| Mensagens trocadas, todos os problemas tentados | 4,9 milhões |
| Tokens de saída, todos os problemas tentados | cerca de 300 mil milhões |
| Refutação da regularidade de Euler sem forçamento | cerca de 100 agentes, aproximadamente 50 horas |
Um trabalho concorrente torna o panorama mais complexo. Levent Alpöge, funcionário da Anthropic, e Tristan Buckmaster, professor de matemática na NYU, tinham obtido um resultado sobre as equações de Euler na sua versão forçada. A OpenAI contactou-os a 6 de setembro, depois de o seu projeto estar concluído e verificado, para propor uma publicação conjunta e reconhecer a sua precedência, antes de descobrir que o resultado deles incidia sobre um enunciado diferente do seu.
This model represents a step-function improvement on many benchmarks, and its training is ongoing. Our internal model group arrived at the Navier–Stokes solution in 88 hours, using around 10,000 coordinating AI agents. Throughout the effort, we maintained the strict safeguards—including monitoring and isolation—that we apply to all our frontier evaluations.
🇵🇹 Este modelo representa uma melhoria em degrau em muitos benchmarks, e o seu treino prossegue. O nosso grupo de modelos internos chegou à solução de Navier-Stokes em 88 horas, com cerca de 10 000 agentes de IA coordenados. Ao longo de todo o esforço, mantivemos as salvaguardas rigorosas, incluindo a monitorização e o isolamento, que aplicamos a todas as nossas avaliações de modelos de fronteira. — @OpenAI no X
No mesmo dia, a OpenAI publica um estudo de caso muito mais modesto e muito mais verificável. Beatriz Yankelevich, doutoranda do grupo Engineering Quantum Systems do MIT, ligou o Codex, operado pelo GPT-5.6 Sol, ao software que coordena as suas experiências, para calibrar um chip não calibrado com seis qubits supercondutores. Os agentes receberam skills específicas para cada tipo de medição, descrevendo como realizá-la e como avaliá-la. Perante sinais claros, o Codex realizou uma sequência completa com pouca intervenção: identificação das frequências de transição, calibração dos impulsos de controlo e leitura e medição do tempo de conservação da informação quântica. Perante sinais fracos ou ruidosos, demora mais tempo a encontrar parâmetros utilizáveis e, por vezes, requer o olhar de um investigador experiente, que continua a ser mais rápido do que o modelo. O ganho não reside, portanto, na velocidade, mas na ausência de supervisão permanente: a caracterização de um destes chips comuns custa vários dias de trabalho a um investigador, e o grupo confia agora as medições de rotina a agentes.
🔗 Solução de Navier-Stokes, OpenAI · 🔗 Codex e experiências quânticas, OpenAI
ChatGPT Images 2.5, com Sketch e dois modelos de imagem na API
8 de setembro — A OpenAI lança o ChatGPT Images 2.5 nos seus produtos e na API. O número de utilização apresentado de início revela a dimensão do desafio: mais de 3 mil milhões de imagens são criadas todas as semanas no ChatGPT Images e nos modelos GPT-Image da API. O ganho mais concreto está na latência, reduzida em até 50 por cento relativamente ao Images 2.0, enquanto o restante diz respeito à fidelidade às fotografias de referência e à coerência ao longo de uma conversa extensa, na qual as alterações anteriores são mais bem preservadas.
Três funcionalidades chegam ao ChatGPT. O Sketch permite desenhar diretamente na conversa para servir de guia visual, escrevendo « @Sketch ». Os templates abrangem formatos comuns, como cartazes ou merchandising. É possível adicionar comentários à imagem para indicar uma edição específica. A partilha de uma imagem pode agora incluir o prompt que a produziu. A implementação abrange todos os utilizadores do ChatGPT, ChatGPT Work e Codex, em desktop, dispositivos móveis e web, em todos os planos.
| Modelo na API | Posicionamento anunciado | Latência |
|---|---|---|
| GPT-Image-2.5 Flare | opção predefinida, conteúdo social, geração em volume | até 50 por cento menos que o Images 2.0 |
| GPT-Image-2.5 Sunburst | precisão, campanhas prontas para divulgação | tempos de geração mais longos |
Os dois modelos suportam as novas definições de qualidade xhigh e max e mantêm os preços de tokens do GPT Image 2, ou seja, no plano Standard, 8,00 dólares por milhão de tokens de entrada de imagem, 30,00 dólares de saída de imagem e 5,00 dólares de entrada de texto. Os metadados C2PA e a marca de água invisível são mantidos, e uma system card acompanha o lançamento.
Manus integra o modelo no próprio dia
A Manus adiciona o GPT-Image-2.5 à sua plataforma na noite do anúncio, citando a mensagem da OpenAI publicada uma hora e meia antes. O laboratório de agentes, que voltou a ser independente em 1 de setembro, apresenta um número resultante das suas próprias avaliações, e não das avaliações da OpenAI: o modelo a que chama Flare produz imagens de alta qualidade a uma velocidade duas a quatro vezes superior à do GPT-Image-2. Para um agente que gera elementos visuais ao longo de uma conversa, este fator é mais importante do que um ganho marginal de qualidade, pois determina se a geração permanece integrada no fluxo de trabalho ou exige uma espera. A Manus destaca também a geração melhorada de fundos transparentes, que evita a etapa de recorte manual que interrompe a automatização completa.
AlphaGenome Atlas, o mapa preditivo das 9 mil milhões de mutações do ADN humano
8 de setembro — A Google DeepMind lança o AlphaGenome Atlas, uma base de dados que prevê o efeito molecular de cada possível mutação de uma única letra no ADN humano. O genoma humano contém cerca de 3 mil milhões de pares de bases, dos quais apenas 2 por cento codificam proteínas; os restantes 98 por cento continuam amplamente inexplorados, embora uma simples alteração de uma letra possa desativar um regulador biológico essencial.
O método assenta numa inversão da carga de trabalho. Em vez de deixar cada laboratório consultar o modelo variante a variante, a Google DeepMind pré-calculou as previsões do modelo AlphaGenome para a totalidade das 9 mil milhões de substituições possíveis. O resultado é um conjunto de dados de 1 petabyte, apresentado como tendo mais de trinta vezes o tamanho da AlphaFold Database. Para tornar este volume utilizável, o Atlas introduz a pontuação AVI (AlphaGenome Variant Impact), um número único que agrega as previsões sobre as regiões codificantes e não codificantes e indica que processos biológicos são perturbados por uma variante, com atribuições por característica. A isto acrescenta-se um catálogo de mais de 2 500 padrões de sequência recorrentes, as unidades reguladoras que a Google descreve como as «palavras» do genoma.
| Métrica | Valor |
|---|---|
| Variantes pré-calculadas | 9 mil milhões, todas as alterações de uma letra |
| Tamanho do conjunto de dados | 1 petabyte, mais de 30 vezes a AlphaFold Database |
| Padrões de sequência catalogados | mais de 2 500 |
| Participantes do UK Biobank analisados | mais de 54 000 |
| Associações não codificantes adicionais | mais 22 por cento |
| Regiões genéticas ligadas ao IMC identificadas | 19 |
Duas utilizações documentadas demonstram a dimensão do ganho. No Broad Institute, Laura Covill e a sua equipa utilizaram a pontuação AVI para priorizar variantes candidatas em doenças raras que continuavam sem diagnóstico: a ferramenta destacou uma variante do gene DNM1 ao prever que esta criava um local de splicing incorreto, fornecendo assim o elemento decisivo para resolver o caso. Na University of Exeter, Gareth Hawkes aplicou o Atlas aos dados de mais de 54 000 participantes do UK Biobank e obteve mais 22 por cento de associações genéticas não codificantes, tendo depois identificado 19 regiões genéticas ligadas ao índice de massa corporal ao limitar-se ao 1 por cento das variantes com maior impacto.
O acesso é o segundo ponto digno de nota. O Atlas está disponível através de um portal web que dispensa a escrita de código, destinado a médicos e biólogos que não programam, mas também através da API AlphaGenome, na Cloud via Model Garden, com os dados de investigação publicados no GitHub. Um detalhe que interessará aos programadores que acompanham o ecossistema de agentes da Google: o Atlas também é distribuído como competência (skill) no Google Antigravity, podendo, portanto, ser utilizado diretamente por um agente de programação.
🔗 AlphaGenome Atlas, Google DeepMind
NVIDIA lança CUDA Rust, e Cosmos domina o AI City Challenge da ECCV
8 de setembro — A NVIDIA publica o CUDA Rust, a sua resposta a uma lacuna que se tornou evidente: a camada de sistemas da IA é cada vez mais escrita em Rust, mas o kernel de GPU continuava a ser a exceção. Já era possível executar um kernel a partir de Rust; era necessário escrevê-lo noutra linguagem. O CUDA Rust elimina esta lacuna ao compilar nativamente os kernels Rust para PTX, através de duas abordagens distintas alinhadas com os dois modelos de programação que o CUDA já oferece em C++ e Python.
| Elemento | cuda-oxide, abordagem SIMT | cutile-rs, abordagem Tile |
|---|---|---|
| Maturidade | alpha inicial | publicado no crates.io |
| Toolchain Rust necessária | nightly fixada (nightly-2026-04-03) | stable 1.89 ou posterior |
| Versão do CUDA | 12.x ou posterior | 13.3 |
| LLVM a fornecer | sim, além de clang e libclang | não |
| Compilação | para PTX durante a construção | JIT via CUDA Tile IR |
| Utilizações externas citadas | nenhuma | Grout da Hugging Face, mistral.rs |
A recomendação da NVIDIA é explícita: começar por Tile, porque o código-fonte não codifica então nenhuma escolha específica de uma arquitetura, e passar para SIMT quando se tornar necessário um controlo preciso dos threads e da memória. Atualmente, esta decisão tem um custo, pois, em SIMT, a memória partilhada, base dos kernels rápidos, ainda exige unsafe. O argumento fundamental é a segurança da memória em tempo de compilação: as duas abordagens rejeitam o aliasing clássico, no qual um buffer serve simultaneamente de entrada e de saída, com error[E0502] no lado SIMT e error[E0382] no lado Tile. Quanto à maturidade, a NVIDIA não exagera: nenhum dos dois projetos está pronto para produção, e o compromisso anunciado estende-se a 2027 e além, com um trabalho conjunto com os responsáveis pela manutenção do rust-cuda.
No mesmo dia, a NVIDIA publica os resultados do AI City Challenge da ECCV 2026. Na pista 5, dedicada à previsão generativa em vídeo de cenas de trânsito, quatro das cinco melhores soluções utilizam versões dos modelos de fundação de mundo Cosmos. A equipa Qyn vence a classificação pública com o CosmosAlign, que adapta o modelo congelado Cosmos3-Nano de 16 mil milhões de parâmetros através de uma receita LoRA em duas etapas, gera quatro previsões, seleciona o medoide e reinjeta as regiões estáveis do histórico observado: 76,39 contra 76,04 da equipa SSUPER, uma vantagem de 0,35 pontos. A NVIDIA faz questão de esclarecer que se trata de uma receita de adaptação e inferência, e não de uma nova arquitetura. O Cosmos também surge como juiz: nas duas classificações fora do domínio da pista 3, a equipa UWIPL_ETRI vence com o UniTraffic, que faz com que as afirmações contestadas sejam verificadas por um verificador Cosmos-Reason1 independente.
🔗 CUDA Rust, NVIDIA · 🔗 Resultados do AI City Challenge
Cognition angaria mais de 2 mil milhões de dólares e atinge uma avaliação de 48 mil milhões
8 de setembro — A Cognition, empresa responsável pelo agente de desenvolvimento Devin, anuncia uma angariação de mais de 2 mil milhões de dólares, com uma avaliação de 48 mil milhões. A ronda é liderada por dois novos investidores, Andreessen Horowitz e Accel, juntamente com os investidores já presentes Founders Fund, General Catalyst e Avenir. Cerca de trinta participantes completam a ronda, incluindo NVIDIA, Benchmark, Bessemer, Kleiner Perkins, Greylock, Lightspeed, T. Rowe Price e Bain Capital Ventures.
| Indicador | Maio de 2026 | Setembro de 2026 |
|---|---|---|
| Montante angariado, total da ronda | mais de 1 mil milhão de dólares | mais de 2 mil milhões |
| Avaliação | 26 mil milhões de dólares | 48 mil milhões |
| Receita anualizada | 492 milhões de dólares | cerca de 900 milhões |
| Principais investidores | Lux Capital, General Catalyst, 8VC | Andreessen Horowitz, Accel |
A avaliação quase duplicou em quatro meses e foi multiplicada por quase cinco num ano, com uma receita anualizada que segue a mesma trajetória. A Cognition detalha as utilizações que impulsionam este crescimento: o Devin trabalha na conceção de chips na NVIDIA, na aviação na GE Aerospace, nos serviços financeiros no Citi, no setor automóvel na Mercedes-Benz e na infraestrutura de IA na Modal. O facto de a NVIDIA ser simultaneamente cliente e investidora nesta ronda ilustra a forma como estas empresas garantem o acesso às ferramentas que utilizam internamente. Três funcionalidades recentes levam o Devin da execução de tarefas para a ação autónoma: Auto-Triage para a primeira fase da investigação de incidentes, Security Swarm para a triagem de vulnerabilidades e Automations acionado por eventos do Slack, GitHub ou Linear. Foram abertos seis escritórios num ano, cinco dos quais fora dos Estados Unidos, além dos polos de São Francisco, Nova Iorque e Austin.
In the next chapter of software engineering, agents will become proactive by default, software will improve itself, and compute will automatically get allocated toward the highest impact use cases. We’re still at the dawn of the self-driving software era.
🇵🇹 No próximo capítulo da engenharia de software, os agentes tornar-se-ão proativos por predefinição, o software melhorará a si próprio e a capacidade computacional será automaticamente atribuída às utilizações de maior impacto. Ainda estamos no início da era do software autónomo. — @cognition no X
Suno assina acordo com Believe e TuneCore, que ainda ontem se recusavam a distribuir a sua música
8 de setembro — A Suno anuncia uma parceria estratégica mundial com a Believe, empresa de desenvolvimento de artistas, e a sua plataforma de autodistribuição TuneCore. O acordo abrange duas vertentes distintas. Primeiro, a Believe passa a participar na conceção dos novos modelos musicais que a Suno desenvolve com a indústria. Depois, e este é o ponto concreto para os utilizadores, as faixas criadas com este novo modelo parceiro passarão a ser elegíveis para distribuição através da Believe e da TuneCore e, portanto, para Spotify, Apple Music, Amazon Music e YouTube.
O contexto dá dimensão ao anúncio. A Suno recorda sem rodeios que, no início deste ano, a Believe e a TuneCore tinham anunciado que não distribuiriam música produzida com modelos que não satisfizessem os seus critérios, incluindo os modelos da Suno existentes na altura. A mudança de posição é apresentada como resultado de conversações que revelaram valores comuns: oferecer opções reais aos artistas e abrir vias de distribuição e de receitas.
O acordo integra-se numa sequência coerente. Prolonga o Spark, o programa da Suno destinado a artistas independentes e emergentes, e complementa os acordos existentes com a Warner Music Group e a BMG, acrescentando-lhes as editoras independentes e os artistas autoproduzidos. A Suno também o associa explicitamente às suas medidas de proteção recentes: a marca de água de áudio e a impressão digital acústica destinadas a identificar as suas faixas fora da plataforma, bem como os limites de transferência que entraram em vigor em 3 de setembro para impedir a difusão em massa nos serviços de streaming. Estas proteções serão aplicadas à música distribuída pela Believe e pela TuneCore. O anúncio termina com um calendário: a Suno anuncia para muito em breve o lançamento dos seus novos modelos, cuja família tinha recebido o nome v6 em 4 de setembro.
🔗 Parceria com a Believe, Suno
Cohere lança um mecanismo de serviço (serving) construído em torno de um megakernel, 1,58x mais rápido que o vLLM
8 de setembro — A Cohere publica um mecanismo de serviço de inferência inteiramente construído em torno de um megakernel de decodificação, sob a licença Apache 2.0. A empresa reivindica uma estreia: não uma demonstração de velocidade em laboratório, mas um servidor completo capaz de processar solicitações reais por trás de um endpoint compatível com OpenAI, com processamento contínuo em lotes, atenção paginada, cache de prefixo e chamada de ferramentas. O modelo servido é o North Mini Code, uma mistura de especialistas com 30 bilhões de parâmetros, dos quais apenas 3,3 bilhões estão ativos por token.
O problema abordado resume-se a uma frase: durante a decodificação, a GPU passa muito tempo à espera em vez de calcular. Uma pilha clássica inicia um núcleo (kernel) por operação, e cada fronteira entre núcleos impõe uma barreira em toda a grelha de cálculo. Ora, a decodificação autorregressiva é limitada pela largura de banda da memória: a cada etapa, o North Mini Code transfere 6,6 GB de pesos da memória HBM, além de cerca de 0,5 GB de cache de chave-valor com 8K de contexto, o que coloca o limite teórico em cerca de 470 tokens por segundo nos 3,35 TB/s de uma H100. Um megakernel elimina essas fronteiras ao iniciar um único núcleo persistente que permanece residente durante toda a etapa de decodificação, com dependências reduzidas a contadores na memória global.
| Medida | Megakernel | vLLM v0.24 | Ganho |
|---|---|---|---|
| Decodificação, lote de tamanho 1, contexto 8K (tok/s) | 292 | 185 | 1,58x |
| AIME 2025, de ponta a ponta (tok/s) | 935 | 661 | 1,41x |
| SciCode, de ponta a ponta (tok/s) | 711 | 560 | 1,37x |
| MMLU-Pro, subconjunto de informática (tok/s) | 948 | 713 | 1,33x |
| LiveCodeBench v6, de ponta a ponta (tok/s) | 803 | 625 | 1,28x |
| GPQA, de ponta a ponta (tok/s) | 787 | 631 | 1,25x |
Os 292 tokens por segundo com lote de tamanho 1 representam 62 por cento do limite teórico, contra 39 por cento para o vLLM. A qualidade permanece inalterada: 38,9 por cento contra 38,2 no SciCode, 70,3 por cento de ambos os lados no LiveCodeBench v6, em médias de sete execuções. Um detalhe merece atenção: a vantagem depende da distribuição dos especialistas, com 1,32x sob o roteamento real do modelo contra 1,14x sob roteamento uniforme simulado, o que torna as medições uniformes o cenário desfavorável. Por fim, a Cohere insiste num ponto contraintuitivo: escrever um megakernel seria mais simples do que sugere a sua reputação, com um único ficheiro CUDA no qual dezasseis códigos de operação cobrem toda a etapa de decodificação. As limitações são reconhecidas e descritas como limitações de implementação: apenas decodificação, com o pré-preenchimento ainda executado em núcleos PyTorch comuns, somente H100 e BF16, e lotes de tamanho 1 a 8.
Anthropic documenta como reduzir a fatura da Claude Platform sem perder desempenho
8 de setembro — A Anthropic publica um guia de engenharia que contraria a ideia comum de que reduzir a fatura de um agente implica aceitar resultados piores. São documentadas três alavancas: maximizar a taxa de acerto do cache de prompt, remover os anti-patterns de prompt ao migrar para um modelo de fronteira e calibrar o esforço de acordo com a tarefa. O método é apresentado sob a forma de comandos executáveis no Claude Code, com /claude-api prompt-audit e /claude-api hillclimb que se juntam a /claude-api cost-optimize.
| Benchmark, base Sonnet 5 | Redução de custo | Detalhe medido |
|---|---|---|
| LegalBench | cerca de 58 por cento | tokens de raciocínio de 102 779 para 8 284 |
| tau2-bench retail | cerca de 73 por cento | cache de prompt com pontos de interrupção explícitos |
| OfficeQA Pro | cerca de 52 por cento | de 136,20 para 64,87 dólares |
| SWE-bench Verified | cerca de 55 por cento | mediana de etapas de 29 para 17, tokens de prompt reduzidos a menos de metade |
O número mais útil para agir não aparece nesta tabela. No CursorBench 3.2, o Claude Fable 5.1 com esforço low iguala o Fable 5 com esforço high por um terço do custo, parte do qual resulta do preço das leituras de cache, faturadas a 0,25 dólar por milhão de tokens contra 1,00 dólar anteriormente. Em contrapartida, no Humanity’s Last Exam sem ferramentas, o último nível de esforço proporciona cerca de meio ponto por um custo 46 por cento superior, um ganho diluído no ruído do benchmark.
🔗 Reduzir os custos na Claude Platform
Claude Code 2.1.265: pastas de plugins, limite de 1 GB e reparação do cache de prompt
8 de setembro — O Claude Code passa para a versão 2.1.265 com cinquenta entradas no changelog, incluindo trinta e quatro correções, dois dias depois de uma versão 2.1.263 que continha apenas uma. A opção --plugin-dir aceita agora uma pasta inteira de plugins, sendo carregada cada subpasta que contenha um manifesto e detetadas as adições e remoções feitas durante a execução. Aplica-se um limite de 1 GB aos resultados de ferramentas gravados no disco, com a pré-visualização a indicar quando um ficheiro foi truncado.
A parte mais densa diz respeito ao cache de prompt, em consonância com o guia publicado no mesmo dia. Duas correções distintas resolvem casos em que o próprio Claude Code quebrava a reutilização do cache: retomar um subagente iniciado em primeiro plano alterava a sua lista de ferramentas e o prefixo do prompt de sistema, enquanto os colegas de equipa dos agentes e os subagentes retomados deslocavam para fora do prefixo o contexto dos hooks SubagentStart e as skills pré-carregadas. Duas correções dizem respeito à segurança: um caminho de plugin que continha uma barra invertida contornava a verificação de confinamento dos links simbólicos no macOS e Linux, e no Windows as ferramentas de leitura e escrita recusavam qualquer ficheiro num AppContainer ou numa sandbox com token restrito. A leitura de um artifact escrito por terceiros é agora tratada como conteúdo não fiável.
Amp substitui a fila de mensagens por orientação em direto
8 de setembro — A Amp altera o comportamento predefinido do seu agente perante mensagens enviadas durante o trabalho. Até agora, uma mensagem escrita enquanto o agente estava em execução era colocada numa fila e só era processada depois de o turno terminar; agora, é entregue na primeira oportunidade possível. O editor aponta dois benefícios: o agente considera o feedback mais cedo e deixa de iniciar etapas de verificação que a nova instrução torna desnecessárias, poupando tempo e tokens no caso comum em que se vê o agente seguir na direção errada.
A mudança não está isenta de efeitos secundários, e a Amp documenta-os. Se a orientação se revelar demasiado abrupta, o editor aconselha formular os pedidos como «When done, then…» em vez de «Now, …», para indicar explicitamente que a instrução se aplica após a tarefa atual. Ship, Review e as outras ações integradas mantêm o comportamento anterior e continuam em fila, uma vez que geralmente se pretende que o trabalho esteja concluído antes da entrega ou do início de uma revisão. A colocação manual em fila continua disponível, tanto na aplicação como no CLI.
🔗 Orientar, não colocar em fila, Amp
Muse Spark 1.3 chega ao Cursor com a melhor relação entre pontuação e custo do CursorBench
8 de setembro — O Cursor adiciona o Muse Spark 1.3, o modelo agêntico da Meta Superintelligence Labs, seis dias após a sua apresentação. Os números publicados não contam uma história de desempenho bruto, mas de custo. No CursorBench 3.2, o benchmark interno construído a partir de tarefas reais com múltiplos ficheiros, o nível Max obtém 67,9 por cento por 1,31 dólar por tarefa e ocupa o décimo segundo lugar.
| Modelo e nível | Pontuação no CursorBench 3.2 | Custo por tarefa, em dólares | Tokens por tarefa | Posição |
|---|---|---|---|---|
| Fable 5.1 Max | 73,4 por cento | 9,64 | 72 060 | 1 |
| Grok 4.6 Extra High | 70,8 por cento | 2,81 | 41 136 | 3 |
| Opus 5 Max | 70,0 por cento | 8,23 | 61 838 | 5 |
| Gemini 3.8 Flash High | 69,2 por cento | 2,38 | 81 524 | 9 |
| Muse Spark 1.3 Max | 67,9 por cento | 1,31 | 33 034 | 12 |
| GPT-5.6 Sol Max | 67,2 por cento | 5,69 | 28 320 | 13 |
| Muse Spark 1.3 Low | 55,0 por cento | 0,45 | 12 181 | 49 |
O modelo da Meta fica, portanto, muito atrás do Claude Fable 5.1 Max na pontuação, mas este último custa mais de sete vezes mais por tarefa. Sobretudo, supera o GPT-5.6 Sol no nível Max custando mais de quatro vezes menos. O Cursor mantém o seu método, que consiste em publicar sistematicamente a pontuação e o custo por tarefa de cada modelo adicionado, em vez de anunciar apenas a sua disponibilidade.
Grok Bot permite preencher formulários e credenciais a partir do chat, e Grok Imagine ganha controlo por imagens-chave
8 de setembro — A SpaceXAI permite agora preencher formulários e páginas de início de sessão para o seu Grok Bot sem sair da conversa, com suporte anunciado para qualquer gestor de palavras-passe. A funcionalidade responde a um ponto de fricção próprio dos agentes persistentes: assim que o agente precisa de atravessar um ecrã de início de sessão ou enviar um formulário com informações pessoais, necessita de credenciais armazenadas ou de uma intervenção do utilizador. Trazer esta etapa para o fio da conversa, em vez de a realizar numa sessão separada do navegador, é uma escolha tanto de ergonomia como de segurança.
Duas horas depois, o Grok Imagine ganha controlo sobre as imagens inicial e final de uma cena de vídeo, bem como a geração de loops contínuos, com melhor seguimento das instruções e uma qualidade de vídeo anunciada como superior. O controlo por imagens-chave muda a natureza da ferramenta para quem produz planos sucessivos: fixar a última imagem de um plano permite reutilizá-la como primeira imagem do seguinte e, assim, encadear sequências cuja continuidade já não depende do acaso da geração. O anúncio chega três dias após a entrada em funcionamento do agente Grok Imagine Video 1.5, impulsionado pelo modelo Image 2.0.
🔗 Preenchimento de formulários no Grok Bot · 🔗 Imagens-chave no Grok Imagine
Três artigos de investigação no blog da Hugging Face
8 de setembro — Três publicações da comunidade Hugging Face merecem ser lidas no mesmo dia, sobre meteorologia, segurança dos modelos e modelos inspirados em seres vivos.
Executar um modelo meteorológico aberto sem GPU
A Hugging Face e a Earthmover publicam um artigo conjunto sobre um problema raramente abordado: os modelos meteorológicos baseados em aprendizagem são suficientemente leves para serem executados num computador portátil e, ainda assim, quase ninguém os executa. São identificados três obstáculos: o cálculo — vários modelos, incluindo o AIFS, dependem de flash attention, limitada a determinadas arquiteturas de placas gráficas —, o armazenamento e, sobretudo, a largura de banda, com cerca de 1 GB de condições iniciais por previsão. A resposta consiste em três artefactos públicos: um espaço de demonstração, um compartimento de armazenamento (bucket) e um tutorial reproduzível que executa o Aurora, o modelo da Microsoft, na versão pré-treinada com resolução de 0,25 grau, utilizando condições iniciais ERA5 fornecidas pelo mercado de dados Earthmover. Não é necessária nenhuma GPU: dois a três minutos por etapa de cálculo no processador, alguns segundos na placa gráfica e quatro etapas de seis horas para uma previsão de vinte e quatro horas, posteriormente comparada com o ERA5.
🔗 Modelos meteorológicos abertos com a Earthmover
Um modelo considerado mais seguro que recusa três quartos das perguntas inofensivas
A Multiverse Computing publica um resultado que deveria circular muito além da investigação sobre alinhamento. Ao treinar o Qwen3-8B para recusar pedidos de manipulação política, a equipa obtém números que parecem uma vitória inequívoca: a taxa média de respostas perigosas no HarmBench, StrongREJECT e WildJailbreak cai de 26,26 para 0,14 por cento. No mesmo checkpoint, a recusa excessiva no XSTest sobe de 2,00 para 74,00 por cento. Por outras palavras, a configuração mais segura no papel é uma máquina de recusar, e nada nas medições habituais permite percebê-lo. Duas correções resolvem o problema: substituir as respostas de conformidade externas por respostas verificadas do modelo-alvo reduz a recusa excessiva no XSTest de 15,20 para 5,20 por cento, e a adição de pares de fronteira benignos reduz a recusa excessiva do lado que deve ser atendido de 32,94 para 4,16 por cento, enquanto a recusa do lado nocivo perde apenas quatro pontos.
🔗 Segurança para quem, Multiverse Computing
Um connectome de mosca não supera a sua própria cablagem misturada
A Oruk publica uma lição metodológica válida para além dos modelos inspirados em connectomes. A equipa copiou 499 neurónios fortemente interligados da reconstrução pública MaleCNS de uma mosca para uma rede recorrente que funciona como reservatório, com uma única leitura ridge treinada por cima. A cablagem da mosca obtém 16,84 por cento de precisão média no teste, e uma cablagem misturada, 16,88 por cento: a diferença é de menos 0,04 ponto, com um intervalo de confiança que atravessa o zero. A segunda experiência poderia ter parecido uma prova do contrário, uma vez que remover os 50 neurónios com as maiores normas de peso de leitura faz a precisão cair de 16,91 para 10,83 por cento. Os autores explicam por que não há contradição: uma ablação espetacular nunca demonstra que uma topologia biológica era necessária. Convém assinalar que o próprio artigo indica ter sido preparado por um agente de IA a partir de um artigo sem revisão por pares, e o conjunto completo de avaliação continua privado.
🔗 Connectome e cablagem misturada, Oruk
Runway recruta a equipa do laboratório parisiense Kinetix
8 de setembro — A Runway anuncia que a equipa da Kinetix, um laboratório de investigação em IA sediado em Paris, passa a integrar a empresa. O laboratório trabalhava no movimento humano em 3D e na geração de vídeo fundamentada na física, dois temas que a Runway associa diretamente à sua investigação sobre modelos de mundo aplicados à robótica. A equipa integra o polo parisiense da empresa, que também está a contratar localmente nas áreas de investigação e engenharia.
O argumento técnico resume-se a uma frase do anúncio: um robô verdadeiramente útil deve compreender e gerir ambientes, tarefas e situações inéditas, e o pré-treino de vídeo em grande escala oferece, segundo a Runway, o caminho mais eficaz para resolver esses problemas de generalização. É a continuação direta do Solaris, apresentado em 31 de agosto, e do GWM Worlds 2, apresentado em 3 de setembro: depois de ensinar os modelos a simular o mundo, a Runway quer ensiná-los a agir nele. Yassine Tahi, diretor-geral da Kinetix, situa a aposta fundadora do laboratório há seis anos. Não foi divulgado qualquer valor nem estrutura da operação.
Sarah Friar quantifica a escala da OpenAI e o efeito dos seus modelos nos custos
8 de setembro — Sarah Friar publica um artigo de opinião sobre a forma como a OpenAI converte os seus avanços de investigação em atividade económica. O interesse do texto reside mais em três números inéditos do que na sua argumentação.
| Indicador | Valor |
|---|---|
| Utilizadores ativos semanais | mais de mil milhões |
| Empresas clientes | 2,5 milhões |
| Mensagens diárias aos seis meses, planos individuais | cerca de 50 por cento mais do que no primeiro mês |
| Tarefas distintas experimentadas aos seis meses | cerca do dobro |
| Custos de serviço de ponta a ponta após otimização | menos 20 por cento |
| Eficiência da geração de tokens | mais de 15 por cento |
O terceiro número fecha um ciclo interessante. O GPT-5.6 Sol foi usado para melhorar o software de serviço em produção da OpenAI, resultando numa redução de 20 por cento nos custos de serviço, à qual se somam mais de 15 por cento de eficiência obtida na geração de tokens. Por outras palavras, o modelo financia parte da sua própria infraestrutura ao otimizar a camada que o serve. A trajetória de utilização individual responde ainda a uma pergunta frequentemente colocada e raramente documentada: a da retenção.
🔗 O trabalho agora ao alcance, OpenAI
OpenAI investe 5 milhões de dólares em investigação independente sobre adolescentes
8 de setembro — A OpenAI lança um programa de bolsas de 5 milhões de dólares destinado à investigação independente sobre os efeitos da IA generativa em jovens dos 13 aos 17 anos, com ênfase explícita no desenvolvimento social e emocional. As bolsas individuais chegam a 1 milhão de dólares por projeto. As candidaturas encerram a 6 de outubro de 2026, os projetos selecionados serão notificados até 13 de novembro de 2026, espera-se um ponto de situação no primeiro trimestre de 2027 e os custos indiretos estão limitados a 10 por cento por bolsa.
Dois pormenores merecem destaque. O primeiro diz respeito à independência reivindicada: entre os critérios de avaliação encontra-se a capacidade do projeto de produzir resultados fiáveis, sejam ou não favoráveis aos fornecedores de produtos de IA, e a publicação é incentivada sem constituir uma condição do financiamento. O segundo é administrativo, mas relevante, uma vez que as bolsas são financiadas e geridas pela OpenAI Group PBC, a entidade comercial, e não pela OpenAI Foundation. O calendário não é neutro: a OpenAI tinha manifestado, a 31 de agosto, o seu apoio ao projeto de lei da Califórnia sobre a segurança dos menores perante a IA, e a publicação indica que pretende contribuir para as decisões dos reguladores.
🔗 Bolsas de investigação sobre adolescentes
Breves
- Boris Cherny avalia publicamente os outros laboratórios quanto ao risco de prompt injection — o criador do Claude Code coloca o novo modelo da OpenAI ao nível do Gemini Flash e do Opus 4.8 em matéria de prompt injection e assume que continuará a nomear publicamente os laboratórios enquanto estes não levarem a segurança mais a sério. Cerca de vinte minutos depois, modera o tom numa resposta à sua própria thread. 🔗 Publicação
- Anthropic publica um vídeo de fundadores que desenvolvem com Claude Managed Agents — entrevistas com os fundadores da Wispr Flow, Actively e Pendo sobre a utilização de outcomes, sandbox e memória para ganhar escala. 🔗 Publicação
- RelayShield analisa os ficheiros de instruções em vez do código dos repositórios — serviço pago que lê AGENTS.md, CLAUDE.md, .cursorrules e mcp.json para detetar instruções hostis em linguagem natural que a análise estática não identifica. Um número de repositórios maliciosos citado na publicação não coincide com a respetiva fonte. 🔗 Artigo
- Ai2 anuncia a sua presença na ECCV 2026 — artigos e intervenções distribuídos pela conferência, sem títulos nem programa divulgados. 🔗 Publicação
- Prismberry publica um ensaio sobre a camada de ferramentas dos agentes empresariais — texto de posicionamento que distingue ferramentas de informação, análise e ação, sem anúncio nem medição, e que promove o produto Agent IQ do seu editor. 🔗 Artigo
- Um diário de manutenção de hardware publicado no blog da Hugging Face — diagnóstico do desgaste de um rolamento na ventoinha de uma fonte de alimentação de 650 W, sem conteúdo relacionado com inteligência artificial. 🔗 Artigo
- Missouri disponibiliza o Gemini for Education a 1,1 milhão de alunos e estudantes — parceria à escala estadual que oferece a cerca de 100 000 professores e mais de 1,1 milhão de alunos acesso gratuito ao Gemini for Education, Gemini Notebook e às certificações Google, com os dados excluídos do treino e a adoção deixada à escolha de cada instituição. 🔗 Anúncio
- Dependabot lê registos GitHub privados sem token pessoal — o
GITHUB_TOKENdo Dependabot pode solicitar a permissãopackages: reade descarregar a partir de registos privados do GitHub Packages. A funcionalidade, lançada e depois revertida em junho, regressa com as credenciais automáticas reduzidas à função de recurso. 🔗 Changelog - O portal de suporte do GitHub muda-se para help.github.com — suporte, documentação, aprendizagem, comunidade e recursos de conta reunidos no mesmo local, com pesquisa baseada no Copilot e sem necessidade de iniciar sessão. 🔗 Changelog
- Genspark abre a Spark House durante a SF Tech Week com acesso antecipado ao GenTeam — iniciativa comunitária que oferece aos participantes acesso antecipado ao GenTeam e a conversas privadas entre fundadores e investidores. 🔗 Publicação
- Ethan Tandowsky torna-se diretor financeiro da ElevenLabs — segunda nomeação para a direção em seis dias na ElevenLabs, após a nomeação de Ashley Kramer como diretora de receitas a 2 de setembro. 🔗 Publicação
- MiniMax reúne em Tóquio as vozes japonesas do entretenimento e quatro empresas de IA generativa — evento de 11 de setembro em Shibuya com o produtor Yasushi Akimoto, KADOKAWA, KAGAMIAI, Higgsfield, Krea, Runway e HeyGen, sem lançamento nem números. 🔗 Publicação
- Duas transmissões do Nemotron Labs no mesmo dia, sobre OpenShell e Domyn — 49 minutos e 44 segundos sobre a proteção de agentes autónomos através do OpenShell, 54 minutos e 20 segundos sobre a utilização do Nemotron pela Domyn, sem texto descritivo nem transcrição. 🔗 Publicação
- HeyGen contrapõe dois avatares do mesmo rosto sem nomear qualquer ferramenta ou modelo — comparação de marketing sem ferramenta concorrente identificada, sem modelo citado e sem medição. 🔗 Publicação
- OpenAI alarga o seu programa de jornalismo às escolas de jornalismo — mais de 400 subscrições do ChatGPT Edu para estudantes de mestrado e docentes da Newmark J-School da CUNY e da Medill School da Northwestern, para 2026-2027. 🔗 Anúncio
- Perplexity publica um guia sobre o retorno do investimento na integração da IA — artigo pedagógico sem anúncio de produto, cujos números provêm todos de terceiros ou de testemunhos de clientes. 🔗 Artigo
O que isto significa
O agente pessoal está a tornar-se um produto de infraestrutura, e a sua segurança está a tornar-se um produto por direito próprio. A Meta não se limita a disponibilizar o Muse: publica, no mesmo dia, a descrição mais detalhada até à data de como conter um agente que dispõe de uma shell, um navegador e acesso a uma caixa de correio eletrónico. A escolha mais instrutiva é a dos tokens de substituição, que torna irrelevante a prompt injection para o roubo de credenciais, não porque o modelo resista melhor, mas porque nunca teve acesso ao segredo. O tainted egress segue a mesma lógica: não se confia no modelo, instrumenta-se o kernel. O bug bounty de 300 000 dólares e a franqueza da conclusão, que reconhece que o Muse cometerá erros, dizem o mesmo que Boris Cherny quando avalia publicamente os outros laboratórios quanto a este risco. A segurança dos agentes deixou de ser uma caixa a assinalar: é uma superfície de engenharia que se publica e que se paga para tentar quebrar.
O dia é também uma lição de economia da IA, e a unidade de medida já não é a pontuação, mas o custo por tarefa. A Mistral capta 3 mil milhões de euros com uma valorização superior a 21 mil milhões, e a Cognition mais de 2 mil milhões com uma valorização de 48 mil milhões, em ambos os casos com empresas industriais e clientes à mesa, em vez de apenas fundos tecnológicos. Ao mesmo tempo, a Cursor publica uma tabela em que o Muse Spark 1.3 obtém 67,9 por cento por 1,31 dólar por tarefa, enquanto o primeiro classificado paga 9,64 dólares por mais seis pontos, e a Anthropic documenta reduções de custos entre 52 e 73 por cento sem perda de desempenho, demonstrando que um modelo mais potente com menos esforço supera frequentemente um modelo mais fraco levado ao limite. Sarah Friar quantifica a outra extremidade da cadeia, com uma redução de 20 por cento nos custos de serviço obtida ao fazer o GPT-5.6 Sol otimizar a camada que o serve. São quatro formas de dizer que a decisão passou da capacidade para o preço dessa capacidade.
No domínio científico, a questão já não é saber se os agentes produzem resultados, mas como verificá-los. A OpenAI anuncia uma prova de singularidade para Navier-Stokes produzida por cerca de 10 000 agentes em 88 horas, formalizada em Lean, sem revisão por pares nem validação institucional mencionadas e com um modelo interno que ninguém no exterior pode consultar. A prudência da empresa, que abdica do prémio do milénio e fala de um resultado preliminar, constitui por si só uma informação. Os outros dois trabalhos do dia revelam bem o contraste: no MIT, o Codex cumpre protocolos bem definidos, mas tropeça em sinais ambíguos, e um investigador experiente continua a ser mais rápido; na Google DeepMind, o AlphaGenome Atlas não pretende demonstrar nada, pré-calcula 9 mil milhões de previsões e transfere o esforço para a validação experimental. O artigo de Oruk fecha a demonstração ao mostrar que uma ablação espetacular não prova nada sem uma comparação emparelhada, e o da Multiverse Computing recorda que um número de segurança nada significa enquanto o lado benigno não for medido com o mesmo rigor.
Resta a camada inferior, onde os ganhos já não provêm dos pesos. A Cohere disponibiliza um motor de serviço completo em que a única alteração é a eliminação das fronteiras entre kernels, alcançando 1,58x o throughput do vLLM com qualidade idêntica, e faz questão de dizer que a dificuldade de escrever um megakernel é sobrestimada. A NVIDIA abre duas vias para escrever kernels de GPU em Rust, uma das quais já é utilizada externamente no motor de inferência Grout da Hugging Face e no mistral.rs, e reconhece que nada está pronto para produção. No AI City Challenge, quatro das cinco melhores soluções de vídeo baseiam-se em modelos Cosmos adaptados com LoRA, com a equipa vencedora a salientar que se trata de uma receita de adaptação e não de uma nova arquitetura. O tutorial meteorológico da Earthmover conta a mesma história a partir da outra extremidade: o modelo Aurora funciona num processador; o que bloqueava o processo não era a computação, mas o gigabyte de condições iniciais que era necessário descarregar. Em todos os casos, o valor encontra-se na engenharia que envolve o modelo, e essa engenharia é publicada.
Fontes
- Lançamento do Muse, Meta
- Segurança e proteção dos agentes com o Muse, Meta
- Série D da Mistral
- Anúncio da Série D no X
- Solução do problema de Navier-Stokes, OpenAI
- Thread da OpenAI sobre o modelo interno
- Codex e experiências de computação quântica no MIT
- ChatGPT Images 2.5, OpenAI
- Manus integra o GPT-Image-2.5
- AlphaGenome Atlas, Google DeepMind
- CUDA Rust, NVIDIA
- AI City Challenge da ECCV 2026, NVIDIA
- Série E da Cognition
- Thread da Cognition no X
- Parceria entre Suno, Believe e TuneCore
- Megakernel de descodificação, Cohere
- Reduzir os custos na Claude Platform, Anthropic
- Claude Code 2.1.265
- Controlo em direto do agente, Amp
- Muse Spark 1.3 no Cursor
- Preenchimento de formulários no Grok Bot
- Keyframes e loops no Grok Imagine
- Modelos meteorológicos abertos com a Earthmover, Hugging Face
- Segurança para quem, Multiverse Computing
- Connectome de mosca e ligações baralhadas, Oruk
- Kinetix junta-se à Runway
- Artigo de opinião de Sarah Friar, OpenAI
- Bolsas de investigação sobre adolescentes, OpenAI
- Boris Cherny sobre o risco de prompt injection
- Fundadores que desenvolvem com Claude Managed Agents
- RelayShield e os ficheiros de instruções
- Ai2 na ECCV 2026
- A camada de ferramentas dos agentes, Prismberry
- Diário de manutenção de hardware
- Gemini for Education no Missouri
- Dependabot e os registos GitHub privados
- Novo portal de suporte do GitHub
- Spark House durante a SF Tech Week, Genspark
- Ethan Tandowsky, diretor financeiro da ElevenLabs
- Evento MiniMax em Tóquio
- Transmissões do Nemotron Labs
- Comparação de avatares da HeyGen
- Programa de jornalismo da OpenAI
- Guia sobre o retorno do investimento em IA, Perplexity