ai-powered-markdown-translatorArticol tradus din fr în ro cu gpt-5.6-sol.
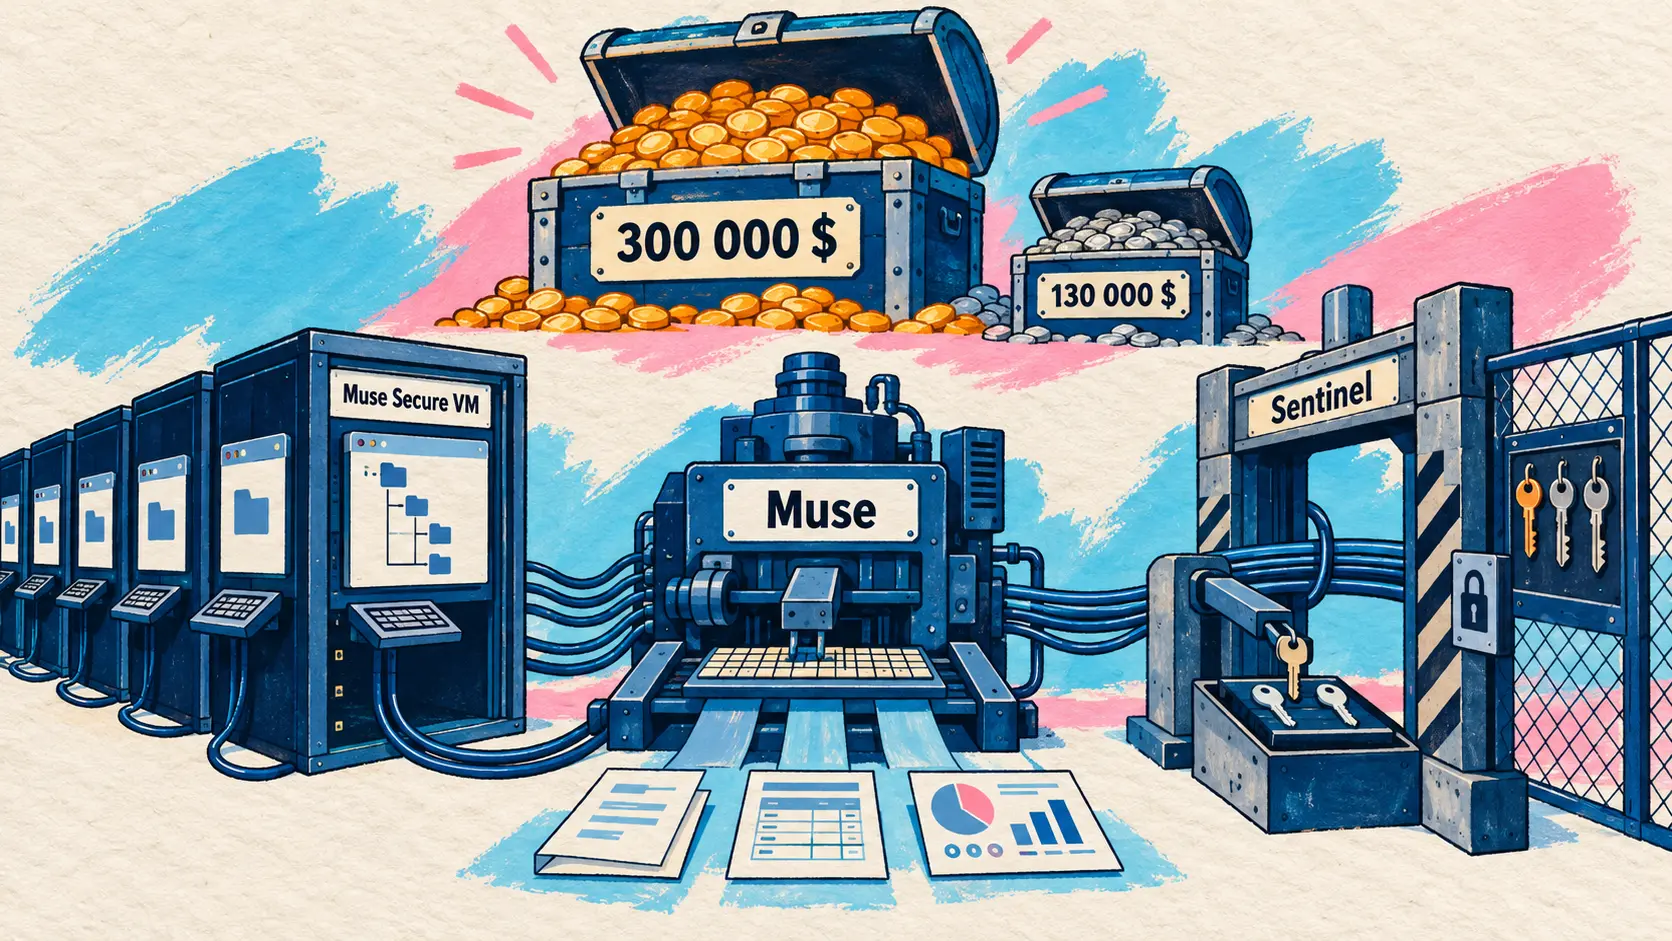
Meta lansează Muse, un agent personal care îi oferă fiecărui utilizator propria mașină Linux în cloud, și publică în aceeași zi arhitectura de securitate din jurul acestuia, cu un program de recompense pentru vulnerabilități (bug bounty) deschis tuturor, cu premii de până la 300.000 de dolari. Mistral anunță o rundă de finanțare Seria D de 3 miliarde de euro, cea mai mare finanțare prin acțiuni încheiată vreodată de o companie tehnologică europeană. La rândul său, OpenAI publică o demonstrație privind singularitatea în timp finit pentru ecuațiile Navier-Stokes, realizată de un sistem de agenți, iar Google DeepMind precalculează efectul celor 9 miliarde de mutații posibile ale ADN-ului uman.
Meta lansează Muse, agentul său personal, și îi publică arhitectura de securitate
8 septembrie — Meta lansează Muse, un agent personal disponibil în aplicațiile iOS și Android, într-o interfață web și în WhatsApp, propulsat de Muse Spark 1.3. Modelul nu este nou: a sosit pe 2 septembrie în Muse Code și Meta Model API, iar nivelul său maxim de raționament a devenit public pe 4 septembrie. Noutatea este produsul destinat publicului larg construit în jurul său.
Arhitectura se bazează pe o idee simplu de formulat și dificil de pus în practică: fiecare utilizator primește propriul computer în cloud. Muse Secure VM este o mașină Linux persistentă și izolată, dotată cu un sistem de fișiere, un terminal și un browser complet, cu suficient spațiu de stocare, putere de procesare și memorie pentru a compila cod, a dezvolta skill-uri personalizate și a rula subagenți în paralel. Această mașină, și nu o infrastructură Meta centralizată, servește drept sistem de referință pentru datele și credențialele serviciilor conectate. Când lipsește un instrument necesar unei sarcini, agentul îl scrie singur și produce obiecte manipulabile, nu blocuri de text: itinerare, PDF-uri, pagini web și panouri de control, pe care Meta le numește Artifacts.
A doua schimbare fundamentală revendicată este că agentul lucrează în fundal cu aplicația închisă, conform unui program și ca reacție la evenimente, apoi decide dacă rezultatul merită o notificare. Memoria este persistentă, poate fi citită și modificată de utilizator, iar o filă Obiective oferă o imagine de ansamblu asupra lucrurilor pe care agentul le urmărește. Rămâne însă ceea ce Meta nu spune: nu a fost publicat niciun tarif, iar lansarea nu este însoțită de nicio listă a țărilor în care produsul este disponibil.
La douăzeci de minute după anunțarea produsului, Meta a publicat un document tehnic semnat de Tarek Sheasha, inginer software și vicepreședinte la Meta Superintelligence Labs, despre securitatea acestui sistem. Principiul director este formulat de la bun început: sistemul este proiectat presupunând că agentul va fi atacat. Harness-ul agentic, numit Hatch în cod, rulează într-un container systemd-nspawn al cărui root este mapat la un utilizator fără privilegii al gazdei, cu apeluri de sistem filtrate și capabilități ale kernelului eliminate. Patru servicii se află în mod deliberat în afara acestui container, astfel încât un atacator care ar compromite agentul să nu le poată dezactiva: clasificatoarele de securitate, workerii cu privilegii separate, daemonul de stocare a credențialelor și Sentinel.
Sentinel este componenta centrală: fiind singura autoritate capabilă să autorizeze o acțiune a unui conector sau un trafic de ieșire din rețea, acesta evaluează fiecare solicitare la nivelurile 4 și 7 și verifică adresa rezolvată efectiv. Mai presus de toate, agentul manipulează numai tokenuri surogat, înlocuite cu credențialele reale la limita rețelei. Extragerea unui secret de la agent prin prompt injection devine lipsită de obiect, deoarece acesta nu l-a deținut niciodată. La aceasta se adaugă urmărirea fluxurilor la nivelul kernelului, numită tainted egress: orice proces care citește datele utilizatorului este marcat și își pierde autorizarea automată. Implementarea combină programe eBPF atașate la cgroups și hook-uri Linux Security Module adăugate de Meta.
| Element al arhitecturii | Soluția aleasă |
|---|---|
| Containerul harness-ului agentic | systemd-nspawn, root mapat la un utilizator fără privilegii |
| Autoritatea de autorizare | Sentinel, în afara containerului, nivelurile 4 și 7 |
| Credențialele văzute de agent | numai tokenuri surogat |
| Conectorul de e-mail | filtrarea codurilor de unică folosință și a linkurilor de resetare |
| Subagentul pentru browser | arbore de accesibilitate, fără DOM brut, fără JavaScript în pagină |
| Plăți | Stripe Link la lansare, apoi Shop Pay, card de unică folosință |
| Bug bounty, plafon per raport valid | 300.000 de dolari |
| Bug bounty, prompt injection | până la 130.000 de dolari |
Documentul este însoțit de două anunțuri. Programul de recompense pentru vulnerabilități este deschis tuturor chiar de la lansare, cu premii de până la 300.000 de dolari pentru fiecare raport valid, în funcție de impactul demonstrat, inclusiv până la 130.000 de dolari pentru un prompt injection reușit care afectează un utilizator. Iar Muse Confidential VM, prevăzut până la sfârșitul anului, ar trebui să împiedice Meta, în mod criptografic și verificabil, să acceseze datele unei mașini virtuale, proiectarea și codul-sursă fiind deja prezentate unor auditori externi. Concluzia textului este neobișnuit de sinceră pentru o publicație corporativă: prompt injection rămâne o problemă nerezolvată în industrie, iar Muse va face greșeli.
🔗 Lansarea Muse · 🔗 Securitatea și siguranța agenților, Meta
Mistral atrage 3 miliarde de euro, cea mai mare finanțare prin acțiuni din industria tehnologică europeană
8 septembrie — Mistral anunță o rundă de finanțare Seria D de 3 miliarde de euro, la o evaluare post-money de peste 21 de miliarde de euro. Compania prezintă această rundă drept cea mai mare finanțare prin acțiuni încheiată vreodată de o companie tehnologică europeană, la trei ani de la înființare.
Samsung Electronics conduce operațiunea. Scaleup Europe Fund, administrat de EQT, și PSG Equity, deja acționar, sunt coconducători. Trei investitori noi se alătură: Advent, fonduri și conturi administrate de BlackRock și Marele Ducat al Luxemburgului. Lista investitorilor existenți este lungă și acoperă trei continente, de la a16z la Salesforce Ventures, trecând prin ASML, BNP Paribas CIB, Bpifrance, DST Global, General Catalyst, Index Ventures, Korelya Capital, Lightspeed și NVIDIA.
Detaliul care merită atenție este natura celor doi investitori principali succesivi. ASML a condus Seria C, iar Samsung Electronics conduce Seria D: două companii din industria producției avansate, nu fonduri tehnologice generaliste. Mistral vede în aceasta un semn de încredere în capacitatea sa de a implementa modele de ultimă generație în medii industriale complexe, unde controlul asupra datelor și infrastructurii condiționează adoptarea.
| Indicator | Valoare |
|---|---|
| Suma atrasă | 3 miliarde de euro |
| Evaluare post-money | peste 21 de miliarde de euro |
| Vechimea companiei | 3 ani |
| Investitor principal | Samsung Electronics |
| Coconducători | Scaleup Europe Fund administrat de EQT, PSG Equity |
| Țări în care operează | 20 |
| Clienți corporativi majori | peste 125, inclusiv Airbus, ASML și HSBC |
În privința utilizării fondurilor, compania menționează în primul rând cercetarea de frontieră, apoi creșterea capacității de calcul pentru antrenare, extinderea infrastructurii și accelerarea comercială la nivel internațional. Argumentația reia poziția susținută încă din vară: întrebarea organizațiilor nu ar mai fi cine construiește cel mai puternic model, ci cum pot utiliza AI fără să cedeze controlul asupra infrastructurii proprii. Mistral se descrie drept singura companie din sector care asamblează întregul stack necesar, de la modele cu ponderi deschise până la produse și capacitate de calcul.
Today marks a major step for Mistral: we’re announcing a €3B Series D, the largest equity round ever raised by a European tech company, just three years after launch.
🇷🇴 Astăzi marchează o etapă majoră pentru Mistral: anunțăm o rundă de finanțare Seria D de 3 miliarde de euro, cea mai mare finanțare prin acțiuni realizată vreodată de o companie tehnologică europeană, la numai trei ani după lansarea noastră. — @MistralAI pe X
Agenții științifici ai OpenAI: o demonstrație despre Navier-Stokes, qubiți calibrați la MIT
8 septembrie — OpenAI publică o demonstrație a formării unei singularități în timp finit pentru ecuațiile Navier-Stokes tridimensionale, însoțită de o formalizare în asistentul de demonstrare Lean. Rezultatul anunțat este că un fluid tridimensional, inițial neted și în repaus, supus unei forțe exterioare netede, poate avea o viteză care crește fără limită într-un timp finit, chiar dacă viscozitatea tinde să netezească mișcarea, iar energia sistemului rămâne finită. În formularea oficială a Clay Mathematics Institute, acest lucru corespunde enunțurilor „C” și „D”, cele care constituie o infirmare, nu o demonstrație a regularității.
Ceea ce revendică și ceea ce nu revendică OpenAI merită precizat cu exactitate. Demonstrația a fost realizată de un sistem de agenți coordonați bazat pe un model intern fără denumire publică, descris de companie ca fiind semnificativ mai capabil decât GPT-6 Astra și a cărui antrenare continuă din 28 august. Singura verificare descrisă este formalizarea în Lean, încredințată lui GPT-6 Astra și finalizată în 17 ore după rezolvare. Anunțul nu menționează nicio evaluare inter pares și nicio validare din partea Clay Mathematics Institute, iar OpenAI declară că nu intenționează să revendice premiul mileniului, prezentând rezultatul drept o imagine de moment, nu un rezultat final.
Metoda este cel puțin la fel de remarcabilă ca rezultatul. Efortul a început pe 1 septembrie, după apariția unor zvonuri potrivit cărora două probleme ale mileniului tocmai fuseseră rezolvate. Grupuri distincte de agenți au primit variante diferite ale enunțului: versiunile „A” și „B” orientate spre demonstrație, iar versiunile „C” și „D” spre infirmare. Pentru o problemă conexă, regularitatea ecuațiilor Euler neforțate, aproape 100 de agenți au produs o infirmare în aproximativ cincizeci de ore; acest rezultat a fost reinjectat în prompturile agenților care lucrau la Navier-Stokes.
| Metrică | Valoare |
|---|---|
| Agenți concurenți, grupul Navier-Stokes | de ordinul a 10.000 |
| Durata până la rezolvare | aproximativ 88 de ore |
| Formalizare și verificare în Lean | încă 17 ore, prin GPT-6 Astra |
| Mesaje schimbate, Navier-Stokes | 2,7 milioane |
| Tokenuri de ieșire, Navier-Stokes | aproximativ 130 de miliarde |
| Mesaje schimbate, toate problemele abordate | 4,9 milioane |
| Tokenuri de ieșire, toate problemele abordate | aproximativ 300 de miliarde |
| Infirmarea regularității Euler neforțate | aproape 100 de agenți, aproximativ 50 de ore |
O cercetare concurentă complică situația. Levent Alpöge, angajat al Anthropic, și Tristan Buckmaster, profesor de matematică la NYU, obținuseră un rezultat privind ecuațiile Euler în versiunea lor forțată. OpenAI i-a contactat pe 6 septembrie, după ce proiectul său fusese finalizat și verificat, pentru a propune o publicare comună și pentru a le recunoaște prioritatea, înainte de a descoperi că rezultatul lor privea un enunț diferit de al său.
This model represents a step-function improvement on many benchmarks, and its training is ongoing. Our internal model group arrived at the Navier–Stokes solution in 88 hours, using around 10,000 coordinating AI agents. Throughout the effort, we maintained the strict safeguards—including monitoring and isolation—that we apply to all our frontier evaluations.
🇷🇴 Acest model reprezintă o îmbunătățire în salturi pe numeroase benchmark-uri, iar antrenarea sa continuă. Grupul nostru intern de modele a ajuns la soluția Navier-Stokes în 88 de ore, cu aproximativ 10.000 de agenți AI coordonați. Pe tot parcursul efortului, am menținut măsurile stricte de protecție, inclusiv monitorizarea și izolarea, pe care le aplicăm tuturor evaluărilor modelelor noastre de frontieră. — @OpenAI pe X
În aceeași zi, OpenAI publică un studiu de caz mult mai modest și mult mai ușor de verificat. Beatriz Yankelevich, doctorandă în grupul Engineering Quantum Systems de la MIT, a conectat Codex, controlat de GPT-5.6 Sol, la software-ul care îi coordonează experimentele, pentru a calibra un cip necalibrat cu șase qubiți supraconductori. Agenții au primit skill-uri specifice fiecărui tip de măsurătoare, care descriau cum trebuie efectuată și cum trebuie evaluată. În cazul semnalelor clare, Codex a realizat o secvență completă cu puține intervenții: identificarea frecvențelor de tranziție, calibrarea impulsurilor de control și citire, măsurarea duratei de păstrare a informației cuantice. În cazul semnalelor slabe sau zgomotoase, are nevoie de mai mult timp pentru a găsi parametri utilizabili și solicită uneori intervenția unui cercetător experimentat, care rămâne mai rapid decât modelul. Câștigul nu este, așadar, viteza, ci eliminarea nevoii de supraveghere permanentă: caracterizarea unuia dintre aceste cipuri standard îi ocupă unui cercetător mai multe zile, iar grupul încredințează acum măsurătorile de rutină agenților.
🔗 Soluția Navier-Stokes, OpenAI · 🔗 Codex și experimentele cuantice, OpenAI
ChatGPT Images 2.5, cu Sketch și două modele de imagine în API
8 septembrie — OpenAI lansează ChatGPT Images 2.5 în produsele sale și în API. Cifra de utilizare menționată la început arată miza: peste 3 miliarde de imagini sunt create în fiecare săptămână cu ChatGPT Images și modelele GPT-Image din API. Cel mai concret câștig este latența, redusă cu până la 50 la sută față de Images 2.0, restul îmbunătățirilor vizând fidelitatea față de fotografiile de referință și coerența pe parcursul unei conversații lungi, în care modificările anterioare sunt păstrate mai bine.
Trei funcționalități ajung în ChatGPT. Sketch permite desenarea direct în conversație pentru a oferi un ghid vizual, tastând „@Sketch”. Template-urile acoperă formatele obișnuite, precum afișele sau produsele promoționale. Comentariile pot fi plasate pe imagine pentru a indica precis o retușare. Partajarea unei imagini poate include acum promptul care a produs-o. Lansarea îi acoperă pe toți utilizatorii ChatGPT, ChatGPT Work și Codex, pe desktop, mobil și web, indiferent de abonament.
| Model în API | Poziționare anunțată | Latență |
|---|---|---|
| GPT-Image-2.5 Flare | alegere implicită, conținut social, generare la scară | cu până la 50 la sută mai mică decât Images 2.0 |
| GPT-Image-2.5 Sunburst | precizie, campanii gata de difuzare | timpi de generare mai lungi |
Ambele modele acceptă noile setări de calitate xhigh și max și păstrează tarifele pentru tokeni ale GPT Image 2, adică, pentru nivelul Standard, 8,00 dolari per milion de tokeni de intrare imagine, 30,00 dolari pentru ieșirea imagine și 5,00 dolari pentru intrarea text. Metadatele C2PA și filigranul invizibil sunt păstrate, iar lansarea este însoțită de un system card.
Manus integrează modelul chiar în aceeași zi
Manus adaugă GPT-Image-2.5 pe platforma sa în seara anunțului, citând mesajul OpenAI publicat cu o oră și jumătate mai devreme. Laboratorul de agenți, redevenit independent pe 1 septembrie, prezintă o cifră rezultată din propriile evaluări, nu din cele ale OpenAI: modelul pe care îl numește Flare produce imagini de înaltă calitate cu o viteză de două până la patru ori mai mare decât GPT-Image-2. Pentru un agent care generează elemente vizuale pe parcursul unei conversații, acest factor contează mai mult decât un câștig marginal de calitate, deoarece stabilește dacă generarea rămâne în fluxul de lucru sau impune o perioadă de așteptare. Manus evidențiază și generarea îmbunătățită a fundalurilor transparente, care elimină etapa decupării manuale ce întrerupe automatizarea completă.
AlphaGenome Atlas, harta predictivă a celor 9 miliarde de mutații ale ADN-ului uman
8 septembrie — Google DeepMind lansează AlphaGenome Atlas, o bază de date care prezice efectul molecular al fiecărei mutații posibile a unei singure litere din ADN-ul uman. Genomul uman conține aproximativ 3 miliarde de perechi de baze, dintre care doar 2 la sută codifică proteine; cele 98 la sută rămase sunt în mare parte neexplorate, deși o simplă schimbare a unei litere poate dezactiva un regulator biologic esențial.
Metoda constă într-o inversare a sarcinii. În loc să lase fiecare laborator să interogheze modelul variantă cu variantă, Google DeepMind a precalculat predicțiile modelului AlphaGenome pentru toate cele 9 miliarde de substituții posibile. Rezultatul este un set de date de 1 petaoctet, prezentat ca având de peste treizeci de ori dimensiunea AlphaFold Database. Pentru ca acest volum să poată fi utilizat, Atlas introduce scorul AVI (AlphaGenome Variant Impact), un număr unic care agregă predicțiile privind regiunile codante și necodante și indică procesele biologice perturbate de o variantă, cu atribuiri pentru fiecare caracteristică. Acestuia i se adaugă un catalog cu peste 2 500 de motive de secvență recurente, unitățile de reglare pe care Google le descrie drept „cuvintele” genomului.
| Metrică | Valoare |
|---|---|
| Variante precalculate | 9 miliarde, toate schimbările unei singure litere |
| Dimensiunea setului de date | 1 petaoctet, de peste 30 de ori AlphaFold Database |
| Motive de secvență catalogate | peste 2 500 |
| Participanți UK Biobank analizați | peste 54 000 |
| Asocieri necodante suplimentare | plus 22 la sută |
| Regiuni genetice asociate cu IMC identificate | 19 |
Două utilizări documentate arată amploarea câștigului. La Broad Institute, Laura Covill și echipa sa au utilizat scorul AVI pentru a prioritiza variante candidate în cazul unor boli rare rămase nediagnosticate: instrumentul a evidențiat o variantă a genei DNM1, prezicând că aceasta crea un situs de splicing incorect, ceea ce a furnizat elementul decisiv pentru rezolvarea cazului. La University of Exeter, Gareth Hawkes a aplicat Atlas datelor a peste 54 000 de participanți din UK Biobank și a obținut cu 22 la sută mai multe asocieri genetice necodante, apoi a identificat 19 regiuni genetice asociate cu indicele de masă corporală, limitându-se la 1 la sută dintre variantele cu cel mai mare impact.
Accesul este al doilea aspect remarcabil. Atlas este disponibil printr-un portal web care nu necesită scrierea de cod, destinat clinicienilor și biologilor care nu programează, dar și prin API-ul AlphaGenome, în Cloud prin Model Garden, iar datele de cercetare sunt publicate pe GitHub. Un detaliu care îi va interesa pe dezvoltatorii ce urmăresc ecosistemul agentic Google: Atlas este distribuit și ca skill în Google Antigravity, putând fi utilizat direct de un agent de programare.
🔗 AlphaGenome Atlas, Google DeepMind
NVIDIA lansează CUDA Rust, iar Cosmos domină AI City Challenge de la ECCV
8 septembrie — NVIDIA publică CUDA Rust, răspunsul său la o lacună devenită vizibilă: nivelul de sisteme al AI este scris tot mai mult în Rust, însă kernel-ul GPU rămânea excepția. Un kernel putea fi deja lansat din Rust, dar trebuia scris în altă parte. CUDA Rust elimină această discrepanță compilând nativ kernel-urile Rust în PTX, prin două direcții distincte, aliniate celor două modele de programare pe care CUDA le oferă deja în C++ și Python.
| Element | cuda-oxide, direcția SIMT | cutile-rs, direcția Tile |
|---|---|---|
| Maturitate | alpha timpurie | publicat pe crates.io |
| Toolchain Rust necesar | nightly fixat (nightly-2026-04-03) | stable 1.89 sau mai recent |
| Versiunea CUDA | 12.x sau mai recentă | 13.3 |
| LLVM necesar | da, plus clang și libclang | nu |
| Compilare | în PTX la build | JIT prin CUDA Tile IR |
| Utilizări externe citate | niciuna | Grout de la Hugging Face, mistral.rs |
Recomandarea NVIDIA este explicită: să se înceapă cu Tile, deoarece codul-sursă nu încorporează astfel nicio alegere specifică unei arhitecturi, și să se coboare la SIMT atunci când devine necesar controlul fin al thread-urilor și al memoriei. În prezent, acest compromis are un cost, deoarece în SIMT memoria partajată, fundamentul kernel-urilor rapide, necesită încă unsafe. Argumentul de fond este siguranța memoriei la compilare: ambele direcții resping aliasing-ul clasic, în care un buffer este folosit simultan ca intrare și ieșire, prin error[E0502] în SIMT și error[E0382] în Tile. În privința maturității, NVIDIA nu exagerează promisiunile: niciunul dintre cele două proiecte nu este pregătit pentru producție, iar angajamentul anunțat vizează anul 2027 și perioada ulterioară, printr-o colaborare cu responsabilii de întreținere ai rust-cuda.
În aceeași zi, NVIDIA publică rezultatele AI City Challenge de la ECCV 2026. Pe pista 5, dedicată predicției video generative a scenelor de trafic, patru dintre cele mai bune cinci soluții utilizează versiuni ale modelelor fundamentale de lume Cosmos. Echipa Qyn câștigă clasamentul public cu CosmosAlign, care adaptează modelul înghețat Cosmos3-Nano cu 16 miliarde de parametri printr-o rețetă LoRA în două etape, generează patru predicții, păstrează medoidul și reinjectează regiunile stabile din istoricul observat: 76,39 față de 76,04 pentru echipa SSUPER, adică un avans de 0,35 puncte. NVIDIA precizează că este vorba despre o rețetă de adaptare și inferență, nu despre o arhitectură nouă. Cosmos apare și în rol de arbitru: în cele două clasamente din afara domeniului ale pistei 3, echipa UWIPL_ETRI câștigă cu UniTraffic, care solicită unui verificator independent Cosmos-Reason1 să controleze afirmațiile contestate.
🔗 CUDA Rust, NVIDIA · 🔗 Rezultatele AI City Challenge
Cognition atrage peste 2 miliarde de dolari și ajunge la o evaluare de 48 de miliarde
8 septembrie — Cognition, compania care dezvoltă agentul de programare Devin, anunță o finanțare de peste 2 miliarde de dolari la o evaluare de 48 de miliarde. Runda este condusă de doi noi investitori, Andreessen Horowitz și Accel, alături de investitorii existenți Founders Fund, General Catalyst și Avenir. Aproximativ treizeci de participanți completează lista, printre care NVIDIA, Benchmark, Bessemer, Kleiner Perkins, Greylock, Lightspeed, T. Rowe Price și Bain Capital Ventures.
| Indicator | Mai 2026 | Septembrie 2026 |
|---|---|---|
| Suma atrasă, totalul rundei | peste 1 miliard de dolari | peste 2 miliarde |
| Evaluare | 26 de miliarde de dolari | 48 de miliarde |
| Venit anualizat | 492 de milioane de dolari | aproape 900 de milioane |
| Investitori principali | Lux Capital, General Catalyst, 8VC | Andreessen Horowitz, Accel |
Evaluarea aproape s-a dublat în patru luni și a crescut de aproape cinci ori într-un an, iar venitul anualizat urmează aceeași traiectorie. Cognition detaliază utilizările care susțin această creștere: Devin lucrează la proiectarea cipurilor în cadrul NVIDIA, în aviație la GE Aerospace, în servicii financiare la Citi, în industria auto la Mercedes-Benz și la infrastructura AI la Modal. Faptul că NVIDIA este atât client, cât și investitor în rundă ilustrează modul în care aceste companii își securizează accesul la instrumentele pe care le folosesc intern. Trei capabilități recente mută Devin de la executarea sarcinilor la acțiunea autonomă: Auto-Triage pentru prima etapă a investigării incidentelor, Security Swarm pentru trierea vulnerabilităților și Automations declanșat de evenimente Slack, GitHub sau Linear. Într-un an au fost deschise șase birouri, dintre care cinci în afara Statelor Unite, pe lângă centrele din San Francisco, New York și Austin.
In the next chapter of software engineering, agents will become proactive by default, software will improve itself, and compute will automatically get allocated toward the highest impact use cases. We’re still at the dawn of the self-driving software era.
🇷🇴 În următorul capitol al ingineriei software, agenții vor deveni proactivi în mod implicit, software-ul se va îmbunătăți singur, iar puterea de calcul va fi alocată automat utilizărilor cu cel mai mare impact. Ne aflăm încă în zorii erei software-ului autonom. — @cognition pe X
Suno semnează cu Believe și TuneCore, care ieri refuzau să-i distribuie muzica
8 septembrie — Suno anunță un parteneriat strategic mondial cu Believe, o companie de dezvoltare a artiștilor, și cu platforma sa de autodistribuție TuneCore. Acordul vizează două aspecte distincte. Mai întâi, Believe participă la conceperea noilor modele muzicale pe care Suno le dezvoltă împreună cu industria. Apoi, iar acesta este aspectul concret pentru utilizatori, piesele create cu acest nou model partener vor deveni eligibile pentru distribuție prin Believe și TuneCore, așadar către Spotify, Apple Music, Amazon Music și YouTube.
Contextul arată amploarea anunțului. Suno amintește direct că, la începutul acestui an, Believe și TuneCore anunțaseră că nu vor distribui muzică produsă cu modele care nu îndeplinesc criteriile lor, inclusiv modelele Suno de la acea vreme. Schimbarea de poziție este prezentată ca rezultatul unor discuții care au scos la iveală valori comune: oferirea unor opțiuni reale artiștilor și deschiderea unor căi de distribuție și de obținere a veniturilor.
Acordul se înscrie într-o succesiune coerentă. Acesta extinde Spark, programul Suno destinat artiștilor independenți și emergenți, și completează acordurile existente cu Warner Music Group și BMG, adăugând casele de discuri independente și artiștii care își produc singuri muzica. Suno îl leagă explicit și de mecanismele sale recente de protecție: filigranul audio și amprenta acustică destinate identificării pieselor sale în afara platformei, precum și limitele de descărcare intrate în vigoare pe 3 septembrie pentru a împiedica distribuirea în masă către serviciile de streaming. Aceste protecții se vor aplica muzicii distribuite de Believe și TuneCore. Anunțul se încheie cu un calendar: Suno anunță lansarea foarte curând a noilor sale modele, a căror familie fusese denumită v6 pe 4 septembrie.
Cohere lansează un motor de serving construit în jurul unui megakernel, de 1,58x mai rapid decât vLLM
8 septembrie — Cohere publică un motor de serving pentru inferență construit integral în jurul unui megakernel de decodare, sub licența Apache 2.0. Compania susține că este o premieră: nu o demonstrație de viteză în laborator, ci un server complet capabil să proceseze cereri reale în spatele unui endpoint compatibil cu OpenAI, cu procesare continuă în loturi, atenție paginată, cache de prefix și apelare de instrumente. Modelul servit este North Mini Code, un mixture of experts cu 30 de miliarde de parametri, dintre care numai 3,3 miliarde sunt activi per token.
Problema abordată poate fi rezumată într-o singură propoziție: în timpul decodării, GPU-ul petrece mult timp așteptând, în loc să calculeze. O stivă clasică lansează câte un kernel pentru fiecare operație, iar fiecare graniță dintre kerneluri impune o barieră asupra întregii grile de calcul. Însă decodarea autoregresivă este limitată de lățimea de bandă a memoriei: la fiecare etapă, North Mini Code transferă 6,6 Go de ponderi din memoria HBM, plus aproximativ 0,5 Go de cache key-value la un context de 8K, ceea ce plasează plafonul teoretic în jurul valorii de 470 de tokeni pe secundă pe cei 3,35 To/s ai unui H100. Un megakernel elimină aceste granițe prin lansarea unui singur kernel persistent, care rămâne rezident pe durata întregii etape de decodare, cu dependențe reduse la contoare în memoria globală.
| Măsurătoare | Megakernel | vLLM v0.24 | Câștig |
|---|---|---|---|
| Decodare, lot de mărimea 1, context 8K (tok/s) | 292 | 185 | 1,58x |
| AIME 2025, cap-coadă (tok/s) | 935 | 661 | 1,41x |
| SciCode, cap-coadă (tok/s) | 711 | 560 | 1,37x |
| MMLU-Pro, subset informatică (tok/s) | 948 | 713 | 1,33x |
| LiveCodeBench v6, cap-coadă (tok/s) | 803 | 625 | 1,28x |
| GPQA, cap-coadă (tok/s) | 787 | 631 | 1,25x |
Cei 292 de tokeni pe secundă la un lot de mărimea 1 reprezintă 62 la sută din plafonul teoretic, față de 39 la sută pentru vLLM. Calitatea rămâne neschimbată: 38,9 la sută față de 38,2 pe SciCode și 70,3 la sută de ambele părți pe LiveCodeBench v6, ca medii pe șapte rulări. Un detaliu merită atenție: avantajul depinde de distribuția experților, cu 1,32x în condițiile rutării reale a modelului, față de 1,14x în condițiile unei rutări uniforme simulate, ceea ce face ca măsurătorile uniforme să reprezinte cazul nefavorabil. În cele din urmă, Cohere insistă asupra unui aspect contraintuitiv: scrierea unui megakernel ar fi mai simplă decât lasă să se înțeleagă reputația sa, cu un singur fișier CUDA în care șaisprezece coduri de operație acoperă întreaga etapă de decodare. Limitările sunt asumate și descrise drept limite de implementare: numai decodare, prefill-ul rulând încă în kerneluri PyTorch obișnuite, exclusiv H100 și BF16, cu loturi de mărimi între 1 și 8.
Anthropic documentează cum poate fi redusă factura Claude Platform fără pierderi de performanță
8 septembrie — Anthropic publică un ghid de inginerie care contrazice ideea încetățenită potrivit căreia reducerea facturii unui agent presupune acceptarea unor rezultate mai slabe. Sunt documentate trei pârghii: maximizarea ratei de succes a cache-ului de prompturi, eliminarea anti-patternurilor din prompturi la trecerea la un model de frontieră și calibrarea efortului în funcție de sarcină. Metoda este oferită sub forma unor comenzi executabile în Claude Code, cu /claude-api prompt-audit și /claude-api hillclimb care se alătură /claude-api cost-optimize.
| Benchmark, bază Sonnet 5 | Reducerea costului | Detaliu măsurat |
|---|---|---|
| LegalBench | aproximativ 58 la sută | tokeni de raționament de la 102 779 la 8 284 |
| tau2-bench retail | aproximativ 73 la sută | cache de prompturi cu puncte de întrerupere explicite |
| OfficeQA Pro | aproximativ 52 la sută | de la 136,20 la 64,87 dolari |
| SWE-bench Verified | aproximativ 55 la sută | număr median de pași de la 29 la 17, tokenii de prompt reduși la mai puțin de jumătate |
Cifra cea mai ușor de pus în practică nu apare în acest tabel. Pe CursorBench 3.2, Claude Fable 5.1 cu efort low egalează Fable 5 cu efort high la o treime din cost, o parte a economiei provenind din tariful citirilor din cache, facturate cu 0,25 dolari per milion de tokeni, față de 1,00 dolar anterior. În schimb, pe Humanity’s Last Exam fără instrumente, ultimul nivel de efort cumpără aproximativ o jumătate de punct pentru un cost cu 46 la sută mai mare, un câștig pierdut în zgomotul benchmarkului.
🔗 Reducerea costurilor pe Claude Platform
Claude Code 2.1.265: directoare de pluginuri, plafon de 1 Go și repararea cache-ului de prompturi
8 septembrie — Claude Code trece la versiunea 2.1.265 cu cincizeci de intrări în changelog, dintre care treizeci și patru sunt remedieri, la două zile după versiunea 2.1.263, care avea doar una. Opțiunea --plugin-dir acceptă acum un director întreg de pluginuri, fiind încărcat fiecare subdirector dotat cu un manifest, iar adăugările și ștergerile efectuate în timpul rulării sunt detectate. Rezultatelor instrumentelor scrise pe disc li se aplică un plafon de 1 Go, iar previzualizarea semnalează când un fișier a fost trunchiat.
Partea cea mai densă privește cache-ul de prompturi, făcând ecou ghidului publicat în aceeași zi. Două remedieri distincte repară situații în care Claude Code împiedica el însuși reutilizarea cache-ului: reluarea unui subagent lansat în prim-plan îi modifica lista de instrumente și prefixul promptului de sistem, în timp ce coechipierii agenților și subagenții reluați mutau în afara prefixului contextul hookurilor SubagentStart și skillurile preîncărcate. Alte două remedieri țin de securitate: o cale de plugin care conținea un backslash ocolea verificarea izolării linkurilor simbolice pe macOS și Linux, iar pe Windows instrumentele de citire și scriere refuzau orice fișier aflat într-un AppContainer sau într-un sandbox cu token restricționat. Citirea unui artifact scris de o terță parte este tratată acum drept conținut nefiabil.
Amp înlocuiește coada de mesaje cu ghidarea în timp real
8 septembrie — Amp modifică comportamentul implicit al agentului său față de mesajele trimise în timpul lucrului. Până acum, un mesaj introdus în timp ce agentul rula era pus în coadă și procesat abia după încheierea turei; acum este livrat cu prima ocazie posibilă. Editorul evidențiază două beneficii: agentul ia în considerare mai devreme feedbackul și încetează să inițieze etape de verificare devenite inutile în urma noii instrucțiuni, economisind timp și tokeni în situația obișnuită în care observăm că agentul pornește într-o direcție greșită.
Schimbarea nu este lipsită de efecte secundare, iar Amp le documentează. Dacă ghidarea se dovedește prea abruptă, editorul recomandă formularea solicitărilor ca „When done, then…” în loc de „Now, …”, pentru a indica explicit că instrucțiunea se aplică după sarcina în curs. Ship, Review și celelalte acțiuni integrate păstrează comportamentul anterior și rămân în coadă, deoarece, de regulă, se dorește ca lucrul să fie terminat înainte de livrare sau de lansarea unei revizuiri. Punerea manuală în coadă rămâne disponibilă atât în aplicație, cât și în CLI.
🔗 Ghidează, nu pune în coadă, Amp
Muse Spark 1.3 sosește în Cursor cu cel mai bun raport scor-cost din CursorBench
8 septembrie — Cursor adaugă Muse Spark 1.3, modelul agentic al Meta Superintelligence Labs, la șase zile după prezentarea sa. Cifrele publicate nu descriu o poveste despre performanță brută, ci despre cost. Pe CursorBench 3.2, benchmarkul intern construit din sarcini reale cu mai multe fișiere, nivelul Max obține 67,9 la sută pentru 1,31 dolari per sarcină și se clasează pe locul al doisprezecelea.
| Model și nivel | Scor CursorBench 3.2 | Cost per sarcină, în dolari | Tokeni per sarcină | Loc |
|---|---|---|---|---|
| Fable 5.1 Max | 73,4 la sută | 9,64 | 72 060 | 1 |
| Grok 4.6 Extra High | 70,8 la sută | 2,81 | 41 136 | 3 |
| Opus 5 Max | 70,0 la sută | 8,23 | 61 838 | 5 |
| Gemini 3.8 Flash High | 69,2 la sută | 2,38 | 81 524 | 9 |
| Muse Spark 1.3 Max | 67,9 la sută | 1,31 | 33 034 | 12 |
| GPT-5.6 Sol Max | 67,2 la sută | 5,69 | 28 320 | 13 |
| Muse Spark 1.3 Low | 55,0 la sută | 0,45 | 12 181 | 49 |
Modelul Meta se situează astfel mult în urma Claude Fable 5.1 Max ca scor, însă acesta din urmă costă de peste șapte ori mai mult per sarcină. Mai ales, îl depășește pe GPT-5.6 Sol la nivelul Max, costând de peste patru ori mai puțin. Cursor își menține metoda, care constă în publicarea sistematică a scorului și a costului per sarcină pentru fiecare model adăugat, nu doar a disponibilității sale.
Grok Bot permite completarea formularelor și a datelor de autentificare direct din chat, iar Grok Imagine primește control prin imagini-cheie
8 septembrie — SpaceXAI permite acum completarea formularelor și a paginilor de autentificare pentru Grok Bot fără părăsirea conversației, cu compatibilitate anunțată cu orice manager de parole. Funcția răspunde unui punct de fricțiune specific agenților persistenți: când agentul trebuie să treacă de un ecran de autentificare sau să trimită un formular care conține informații personale, are nevoie fie de date de autentificare stocate, fie de intervenția utilizatorului. Aducerea acestei etape în firul conversației, în locul unei sesiuni separate de browser, este atât o alegere ergonomică, cât și una de securitate.
Două ore mai târziu, Grok Imagine primește control asupra imaginilor de început și de sfârșit ale unei scene video, precum și generarea de bucle fără întreruperi, cu o respectare mai bună a instrucțiunilor și o calitate video anunțată ca fiind superioară. Controlul prin imagini-cheie schimbă natura instrumentului pentru cei care produc cadre succesive: fixarea ultimei imagini a unui cadru permite reutilizarea acesteia ca primă imagine a următorului, făcând astfel posibilă înlănțuirea unor secvențe a căror continuitate nu mai depinde de hazardul generării. Anunțul vine la trei zile după lansarea agentului Grok Imagine Video 1.5, propulsat de modelul Image 2.0.
🔗 Completarea formularelor în Grok Bot · 🔗 Imagini-cheie în Grok Imagine
Trei articole de cercetare pe blogul Hugging Face
8 septembrie — Trei publicații ale comunității Hugging Face merită citite în aceeași zi, despre meteorologie, siguranța modelelor și modelele inspirate de organisme vii.
Rularea unui model meteorologic deschis fără GPU
Hugging Face și Earthmover publică un articol comun despre o problemă rareori abordată: modelele meteorologice bazate pe machine learning sunt suficient de ușoare pentru a rula pe un laptop și, totuși, aproape nimeni nu le rulează. Sunt identificate trei obstacole: calculul — mai multe modele, printre care AIFS, depind de flash attention, limitată la anumite arhitecturi de plăci grafice —, stocarea și, mai ales, lățimea de bandă, cu aproximativ 1 Go de condiții inițiale per prognoză. Răspunsul constă în trei artifacte publice: un spațiu demonstrativ, un bucket de stocare și un tutorial reproductibil care rulează Aurora, modelul Microsoft, în versiunea preantrenată la 0,25 grade, cu condiții inițiale ERA5 furnizate de marketplace-ul de date Earthmover. Nu este necesar niciun GPU: două-trei minute per pas de calcul pe procesor, câteva secunde pe placa grafică și patru pași de câte șase ore pentru o prognoză la douăzeci și patru de ore, comparată apoi cu ERA5.
🔗 Modele meteorologice deschise cu Earthmover
Un model considerat mai sigur care refuză trei sferturi dintre întrebările inofensive
Multiverse Computing publică un rezultat care ar trebui să circule mult dincolo de cercetarea privind alignmentul. Prin antrenarea Qwen3-8B să refuze solicitările de manipulare politică, echipa obține cifre care par să indice o victorie clară: rata medie a răspunsurilor periculoase pe HarmBench, StrongREJECT și WildJailbreak scade de la 26,26 la 0,14 la sută. La același checkpoint, suprarefuzul pe XSTest crește de la 2,00 la 74,00 la sută. Cu alte cuvinte, configurația cea mai sigură pe hârtie este o mașină de refuzat, iar nimic din măsurătorile obișnuite nu permite observarea acestui lucru. Două remedieri rezolvă problema: înlocuirea răspunsurilor externe de conformare cu răspunsuri verificate ale modelului-țintă reduce suprarefuzul XSTest de la 15,20 la 5,20 la sută, iar adăugarea perechilor de frontieră benigne reduce suprarefuzul în cazurile care trebuie satisfăcute de la 32,94 la 4,16 la sută, în timp ce refuzul în cazurile nocive pierde doar patru puncte.
🔗 Siguranță pentru cine, Multiverse Computing
Un connectome de muscă nu își depășește propria cablare amestecată
Oruk publică o lecție de metodă valabilă dincolo de modelele inspirate de connectome. Echipa a copiat 499 de neuroni puternic conectați din reconstrucția publică MaleCNS a unei muște într-o rețea recurentă folosită drept reservoir, cu un singur strat de citire ridge antrenat deasupra. Cablarea muștei obține o precizie medie de 16,84 la sută la test, iar o cablare amestecată, 16,88 la sută: diferența este de minus 0,04 puncte, cu un interval de încredere care traversează zero. Al doilea experiment ar fi putut părea o dovadă contrară, deoarece eliminarea celor 50 de neuroni cu cele mai mari norme ale ponderilor de citire reduce precizia de la 16,91 la 10,83 la sută. Autorii explică de ce nu există nicio contradicție: o ablație spectaculoasă nu demonstrează niciodată că o topologie biologică era necesară. De remarcat că articolul indică el însuși că a fost pregătit de un agent AI pe baza unei lucrări care nu a fost evaluată inter pares, iar setul complet de evaluare rămâne privat.
🔗 Connectome și cablare amestecată, Oruk
Runway recrutează echipa laboratorului parizian Kinetix
8 septembrie — Runway anunță că echipa Kinetix, un laborator de cercetare AI cu sediul la Paris, i se alătură. Laboratorul lucra la mișcarea umană 3D și la generarea video ancorată în fizică, două teme pe care Runway le leagă direct de cercetarea sa privind modelele lumii aplicate roboticii. Echipa se alătură centrului parizian al companiei, care recrutează, de asemenea, local pentru posturi de cercetare și inginerie.
Argumentul tehnic este concentrat într-o propoziție din anunț: un robot cu adevărat util trebuie să înțeleagă și să gestioneze medii, sarcini și situații nemaivăzute, iar preantrenarea video la scară largă oferă, potrivit Runway, cea mai eficientă cale de rezolvare a acestor probleme de generalizare. Aceasta este continuarea directă a Solaris, prezentat pe 31 august, și a GWM Worlds 2, prezentat pe 3 septembrie: după ce a învățat modelele să simuleze lumea, Runway vrea să le învețe să acționeze în ea. Yassine Tahi, director general al Kinetix, plasează pariul fondator al laboratorului cu șase ani în urmă. Nu este comunicată nicio sumă și nicio structură a tranzacției.
Sarah Friar cuantifică amploarea OpenAI și efectul modelelor sale asupra costurilor
8 septembrie — Sarah Friar publică un articol de opinie despre modul în care OpenAI își transformă progresele din cercetare în activitate economică. Interesul textului constă mai degrabă în trei cifre inedite decât în argumentația sa.
| Indicator | Valoare |
|---|---|
| Utilizatori activi săptămânal | peste un miliard |
| Companii cliente | 2,5 milioane |
| Mesaje zilnice după șase luni, planuri individuale | cu aproximativ 50 la sută mai multe decât în prima lună |
| Sarcini distincte încercate după șase luni | aproximativ dublu |
| Costuri de operare de la un capăt la altul după optimizare | cu 20 la sută mai mici |
| Eficiența generării de tokeni | cu peste 15 la sută mai mare |
A treia cifră închide un cerc interesant. GPT-5.6 Sol a fost folosit pentru a îmbunătăți software-ul de operare în producție al OpenAI, ceea ce a dus la costuri de operare cu 20 la sută mai mici, la care se adaugă un câștig de peste 15 la sută în eficiența generării de tokeni. Altfel spus, modelul își finanțează o parte din propria infrastructură optimizând stratul care îl deservește. Evoluția utilizării individuale răspunde, de asemenea, unei întrebări puse frecvent și rareori documentate: cea a retenției.
🔗 Munca, acum la îndemână, OpenAI
OpenAI alocă 5 milioane de dolari cercetării independente privind adolescenții
8 septembrie — OpenAI lansează un program de granturi în valoare de 5 milioane de dolari, destinat cercetării independente asupra efectelor inteligenței artificiale generative în rândul adolescenților cu vârste între 13 și 17 ani, cu un accent explicit pe dezvoltarea socială și emoțională. Granturile individuale ajung până la 1 milion de dolari per proiect. Înscrierile se încheie la 6 octombrie 2026, proiectele selectate sunt anunțate cel târziu la 13 noiembrie 2026, un raport intermediar este așteptat în primul trimestru din 2027, iar cheltuielile generale sunt plafonate la 10 la sută per grant.
Două detalii merită remarcate. Primul privește independența declarată: printre criteriile de evaluare se numără capacitatea proiectului de a produce rezultate fiabile, indiferent dacă acestea sunt sau nu favorabile furnizorilor de produse de inteligență artificială, iar publicarea este încurajată fără a constitui o condiție a finanțării. Al doilea este administrativ, dar contează, deoarece granturile sunt finanțate și gestionate de OpenAI Group PBC, entitatea comercială, și nu de OpenAI Foundation. Calendarul nu este neutru: OpenAI își exprimase la 31 august sprijinul pentru proiectul de lege din California privind siguranța minorilor în raport cu inteligența artificială, iar articolul precizează că programul urmărește să contribuie la deciziile autorităților de reglementare.
🔗 Granturi de cercetare privind adolescenții
Pe scurt
- Boris Cherny evaluează public celelalte laboratoare în privința riscului de prompt injection — creatorul Claude Code plasează noul model OpenAI la nivelul Gemini Flash și Opus 4.8 în privința prompt injection și își asumă să numească public laboratoarele până când acestea vor trata securitatea cu mai multă seriozitate. Își temperează tonul aproximativ douăzeci de minute mai târziu, într-un răspuns la propriul fir. 🔗 Publicare
- Anthropic publică un videoclip cu fondatori care construiesc pe Claude Managed Agents — interviuri cu fondatorii Wispr Flow, Actively și Pendo despre folosirea outcomes, sandbox-ului și memoriei pentru scalare. 🔗 Publicare
- RelayShield scanează fișierele de instrucțiuni, nu codul repository-urilor — serviciu contra cost care citește AGENTS.md, CLAUDE.md, .cursorrules și mcp.json pentru a detecta instrucțiunile ostile în limbaj natural pe care analiza statică nu le observă. O cifră privind repository-urile rău intenționate, citată în articol, nu concordă cu propria sursă. 🔗 Articol
- Ai2 își anunță prezența la ECCV 2026 — articole și intervenții distribuite pe parcursul conferinței, fără titluri sau program comunicate. 🔗 Publicare
- Prismberry publică un eseu despre stratul de instrumente al agenților pentru companii — text de poziționare care diferențiază instrumentele de informare, analiză și acțiune, fără anunț sau măsurători, și care promovează produsul Agent IQ al editorului său. 🔗 Articol
- Un jurnal de mentenanță hardware publicat pe blogul Hugging Face — diagnosticarea uzurii unui rulment al ventilatorului unei surse de alimentare de 650 W, fără conținut referitor la inteligența artificială. 🔗 Articol
- Missouri oferă Gemini for Education unui număr de 1,1 milioane de elevi și studenți — parteneriat la nivel de stat care le oferă unui număr de aproape 100.000 de profesori și de peste 1,1 milioane de elevi și studenți acces gratuit la Gemini for Education, Gemini Notebook și certificările Google, datele fiind excluse de la antrenare, iar adoptarea rămânând la alegerea fiecărei instituții. 🔗 Anunț
- Dependabot citește registrele GitHub private fără token personal —
GITHUB_TOKENdin Dependabot poate solicita permisiuneapackages: readși poate prelua date din registrele private GitHub Packages. Funcționalitatea, lansată și apoi retrasă în iunie, revine, acreditările automate fiind reduse la rolul de soluție de rezervă. 🔗 Jurnal de modificări - Portalul de asistență GitHub se mută pe help.github.com — asistența, documentația, materialele de învățare, comunitatea și resursele pentru cont sunt reunite în același loc, cu o căutare bazată pe Copilot care nu necesită autentificare. 🔗 Jurnal de modificări
- Genspark deschide Spark House în timpul SF Tech Week, cu acces anticipat la GenTeam — inițiativă comunitară care le oferă participanților acces anticipat la GenTeam și la conversații private între fondatori și investitori. 🔗 Publicare
- Ethan Tandowsky devine director financiar al ElevenLabs — a doua numire în conducerea ElevenLabs în șase zile, după numirea lui Ashley Kramer în funcția de directoare de venituri la 2 septembrie. 🔗 Publicare
- MiniMax reunește la Tokyo personalități japoneze din divertisment și patru companii din domeniul inteligenței artificiale generative — eveniment organizat la 11 septembrie în Shibuya, cu producătorul Yasushi Akimoto, KADOKAWA, KAGAMIAI, Higgsfield, Krea, Runway și HeyGen, fără lansări sau cifre. 🔗 Publicare
- Două transmisiuni Nemotron Labs în aceeași zi, despre OpenShell și Domyn — 49 de minute și 44 de secunde despre securizarea agenților autonomi prin OpenShell, 54 de minute și 20 de secunde despre utilizarea Nemotron de către Domyn, fără text descriptiv sau transcriere. 🔗 Publicare
- HeyGen pune față în față două avataruri ale aceluiași chip fără a numi vreun instrument sau model — comparație de marketing fără un instrument concurent numit, fără un model citat și fără măsurători. 🔗 Publicare
- OpenAI își extinde programul de jurnalism la școlile de jurnalism — peste 400 de abonamente ChatGPT Edu pentru masteranzii și cadrele didactice de la Newmark J-School din cadrul CUNY și de la Medill School din cadrul Northwestern, pentru perioada 2026-2027. 🔗 Anunț
- Perplexity publică un ghid despre rentabilitatea integrării inteligenței artificiale — articol educativ fără anunț de produs, în care toate cifrele provin de la terți sau din mărturii ale clienților. 🔗 Articol
Ce înseamnă acest lucru
Agentul personal devine un produs de infrastructură, iar securitatea sa devine un produs de sine stătător. Meta nu se limitează la livrarea Muse: în aceeași zi publică cea mai detaliată descriere de până acum a modului în care poate fi izolat un agent care dispune de un shell, un browser și acces la o căsuță de e-mail. Cea mai instructivă alegere este cea a tokenilor de substituție, care face ca prompt injection să devină irelevant în cazul furtului acreditărilor, nu pentru că modelul rezistă mai bine, ci pentru că nu a deținut niciodată secretul. Tainted egress urmează aceeași logică: nu se acordă încredere modelului, ci se instrumentează kernelul. Bug bounty-ul de 300.000 de dolari și sinceritatea concluziei, care recunoaște că Muse va face greșeli, transmit același lucru ca Boris Cherny atunci când evaluează public celelalte laboratoare în privința acestui risc. Securitatea agenților nu mai este o simplă căsuță de bifat, ci o suprafață de inginerie care este publicată și pentru a cărei compromitere se oferă recompense.
Ziua oferă și o lecție despre economia inteligenței artificiale, iar unitatea de măsură nu mai este scorul, ci costul per sarcină. Mistral atrage 3 miliarde de euro la o evaluare de peste 21 de miliarde, iar Cognition peste 2 miliarde la o evaluare de 48 de miliarde, în ambele cazuri cu companii industriale și clienți la masă, nu doar cu fonduri de tehnologie. În același timp, Cursor publică un clasament în care Muse Spark 1.3 obține 67,9 la sută pentru 1,31 dolari per sarcină, în timp ce primul clasat plătește 9,64 dolari pentru șase puncte în plus, iar Anthropic documentează reduceri de costuri între 52 și 73 la sută fără pierderi de performanță, arătând că un model mai puternic, folosit cu un nivel mai redus de efort, depășește adesea un model mai slab împins la maximum. Sarah Friar cuantifică celălalt capăt al lanțului, cu costuri de operare cu 20 la sută mai mici, obținute prin folosirea GPT-5.6 Sol pentru optimizarea stratului care îl deservește. Acestea sunt patru moduri de a spune că alegerea s-a mutat de la capacitate la prețul acestei capacități.
În domeniul științific, întrebarea nu mai este dacă agenții produc rezultate, ci cum sunt acestea verificate. OpenAI anunță o demonstrație a singularității pentru Navier-Stokes, realizată de aproximativ 10.000 de agenți în 88 de ore și formalizată în Lean, fără evaluare inter pares sau validare instituțională menționate și folosind un model intern pe care nimeni din exterior nu îl poate interoga. Prudența companiei, care renunță la premiul mileniului și vorbește despre un instantaneu, constituie în sine o informație. Celelalte două lucrări ale zilei evidențiază contrastul: la MIT, Codex respectă protocoale bine definite, dar se împiedică de semnalele ambigue, iar un cercetător experimentat rămâne mai rapid; la Google DeepMind, AlphaGenome Atlas nu pretinde că demonstrează nimic, ci precalculează 9 miliarde de predicții și mută efortul către validarea experimentală. Articolul Oruk încheie demonstrația arătând că o ablation spectaculoasă nu dovedește nimic fără o comparație pereche, iar cel al Multiverse Computing amintește că o cifră privind securitatea nu înseamnă nimic atât timp cât latura benignă nu este măsurată cu aceeași rigoare.
Rămâne stratul inferior, cel în care câștigurile nu mai provin din weights. Cohere publică un motor complet de operare în care singura schimbare este eliminarea granițelor dintre kerneluri, obținând un debit de 1,58x față de vLLM la aceeași calitate, și subliniază că dificultatea scrierii unui megakernel este supraestimată. NVIDIA deschide două direcții pentru scrierea kernelurilor GPU în Rust, dintre care una este deja utilizată în afara companiei, în motorul de inferență Grout al Hugging Face și în mistral.rs, și recunoaște că nimic nu este pregătit pentru producție. În cadrul AI City Challenge, patru dintre cele mai bune cinci soluții video se bazează pe modele Cosmos adaptate prin LoRA, echipa câștigătoare insistând că este vorba despre o rețetă de adaptare, nu despre o arhitectură nouă. Tutorialul meteo al Earthmover spune același lucru din cealaltă extremă: modelul Aurora rulează pe un procesor, iar obstacolul nu era calculul, ci gigabyte-ul de condiții inițiale care trebuia descărcat. De fiecare dată, valoarea se află în ingineria care înconjoară modelul, iar aceasta este publicată.
Surse
- Lansarea Muse, Meta
- Securitatea și siguranța agenților cu Muse, Meta
- Runda Series D a Mistral
- Anunțul rundei Series D pe X
- Soluția problemei Navier-Stokes, OpenAI
- Firul OpenAI despre modelul intern
- Codex și experimentele de calcul cuantic la MIT
- ChatGPT Images 2.5, OpenAI
- Manus integrează GPT-Image-2.5
- AlphaGenome Atlas, Google DeepMind
- CUDA Rust, NVIDIA
- AI City Challenge de la ECCV 2026, NVIDIA
- Runda Series E a Cognition
- Firul Cognition pe X
- Parteneriatul dintre Suno, Believe și TuneCore
- Megakernelul de decodare, Cohere
- Reducerea costurilor pe Claude Platform, Anthropic
- Claude Code 2.1.265
- Controlul în direct al agentului, Amp
- Muse Spark 1.3 în Cursor
- Completarea formularelor în Grok Bot
- Cadre-cheie și bucle în Grok Imagine
- Modele meteo open-source cu Earthmover, Hugging Face
- Securitate pentru cine, Multiverse Computing
- Conectomul muștei și cablarea amestecată, Oruk
- Kinetix se alătură Runway
- Articolul de opinie al lui Sarah Friar, OpenAI
- Granturi de cercetare privind adolescenții, OpenAI
- Boris Cherny despre riscul de prompt injection
- Fondatori care construiesc pe Claude Managed Agents
- RelayShield și fișierele de instrucțiuni
- Ai2 la ECCV 2026
- Stratul de instrumente al agenților, Prismberry
- Jurnal de mentenanță hardware
- Gemini for Education în Missouri
- Dependabot și registrele GitHub private
- Noul portal de asistență GitHub
- Spark House în timpul SF Tech Week, Genspark
- Ethan Tandowsky, director financiar al ElevenLabs
- Evenimentul MiniMax de la Tokyo
- Transmisiuni Nemotron Labs
- Comparația avatarurilor HeyGen
- Programul de jurnalism al OpenAI
- Ghid despre rentabilitatea inteligenței artificiale, Perplexity