ai-powered-markdown-translatorArtykuł przetłumaczony z fr na pl za pomocą gpt-5.6-sol.
Meta uruchamia Muse, osobistego agenta, który zapewnia każdemu użytkownikowi własną maszynę Linux w chmurze, i tego samego dnia publikuje otaczającą go architekturę bezpieczeństwa wraz z otwartym dla wszystkich programem nagród za wykryte luki (bug bounty) w wysokości do 300 000 dolarów. Mistral ogłasza rundę Series D o wartości 3 miliardów euro, największą rundę finansowania kapitałowego, jaką kiedykolwiek zamknęła europejska firma technologiczna. OpenAI publikuje z kolei dowód powstawania osobliwości w skończonym czasie dla równań Naviera-Stokesa, opracowany przez system agentów, a Google DeepMind wstępnie oblicza skutki 9 miliardów możliwych mutacji ludzkiego DNA.
Meta uruchamia Muse, swojego osobistego agenta, i publikuje jego architekturę bezpieczeństwa
8 września — Meta uruchamia Muse, osobistego agenta dostępnego w aplikacjach na iOS i Androida, w interfejsie internetowym oraz w WhatsAppie, napędzanego przez Muse Spark 1.3. Model nie jest nowy: pojawił się 2 września w Muse Code i Meta Model API, a jego najwyższy poziom rozumowania udostępniono publicznie 4 września. Nowością jest zbudowany wokół niego produkt konsumencki.
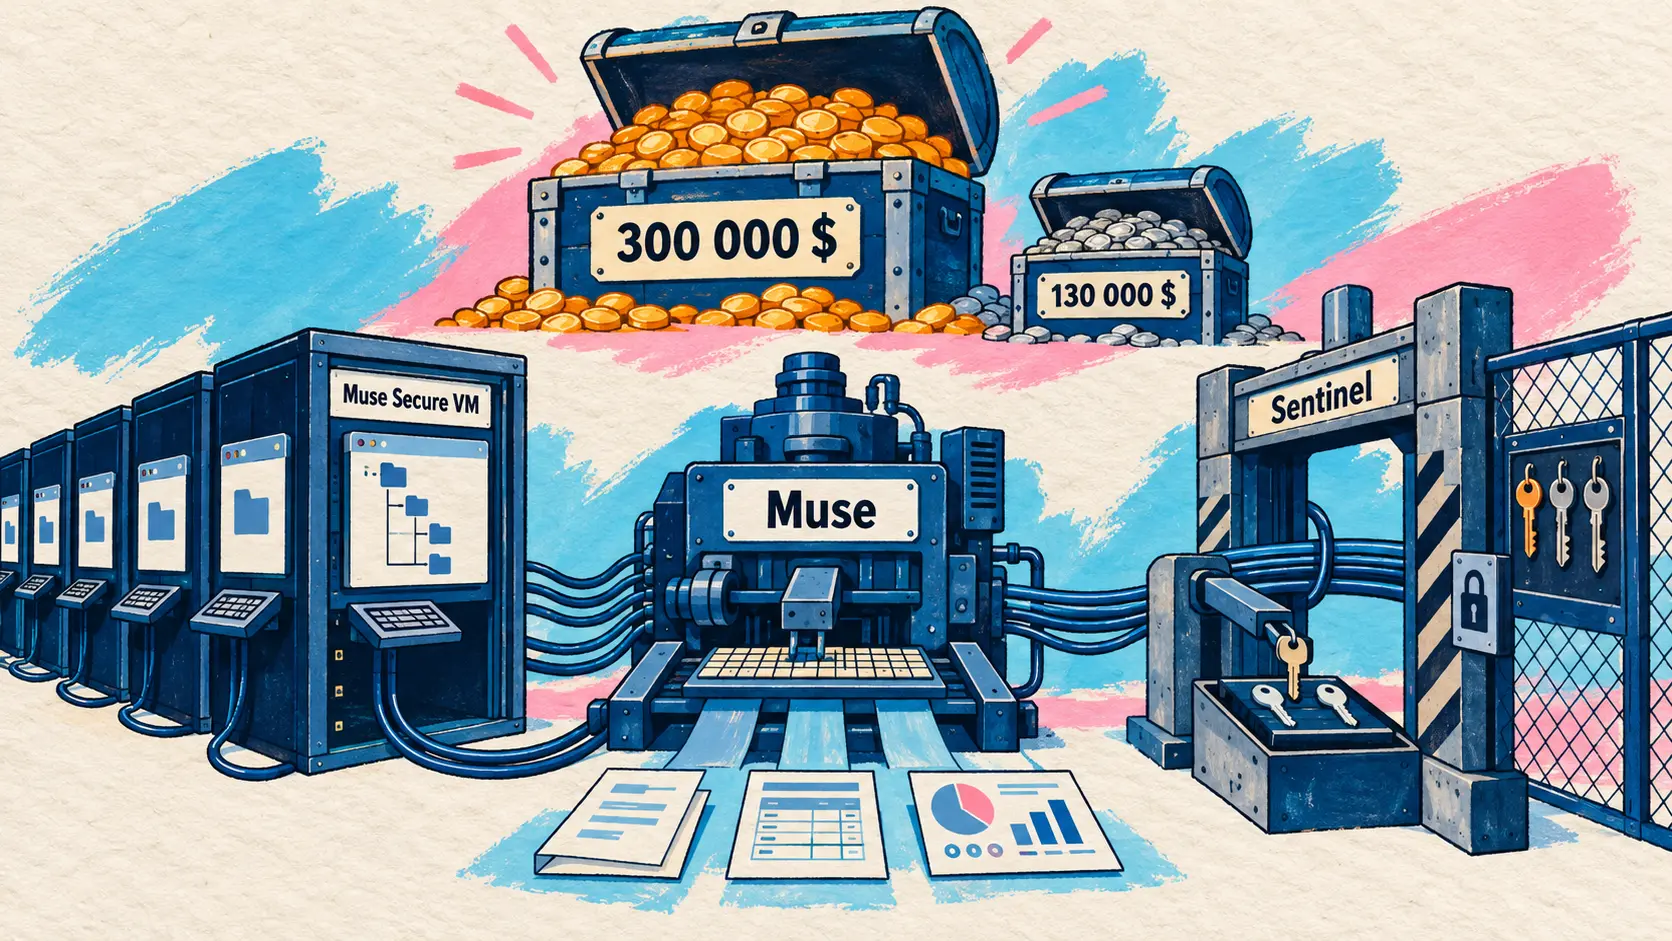
Architektura opiera się na koncepcji, którą łatwo sformułować, ale trudno wdrożyć: każdy użytkownik otrzymuje własny komputer w chmurze. Muse Secure VM to trwała i odizolowana maszyna Linux wyposażona w system plików, terminal oraz pełną przeglądarkę, z wystarczającą ilością przestrzeni dyskowej, mocy obliczeniowej i pamięci do kompilowania kodu, tworzenia niestandardowych umiejętności i równoległego uruchamiania podagentów. To właśnie ta maszyna, a nie scentralizowana infrastruktura Meta, stanowi system referencyjny dla danych i danych uwierzytelniających połączonych usług. Gdy do wykonania zadania brakuje narzędzia, agent sam je tworzy, a zamiast bloków tekstu generuje obiekty, którymi można dalej operować: plany podróży, pliki PDF, strony internetowe i pulpity nawigacyjne, nazywane przez Meta Artifacts.
Drugim deklarowanym przełomem jest to, że agent działa w tle przy zamkniętej aplikacji, zgodnie z harmonogramem i w reakcji na zdarzenia, a następnie decyduje, czy rezultat zasługuje na powiadomienie. Pamięć jest trwała, użytkownik może ją odczytywać i modyfikować, a karta Cele zapewnia całościowy wgląd w to, czym zajmuje się agent. Pozostaje kwestia, o której Meta nie mówi: nie opublikowano żadnego cennika, a premierze nie towarzyszy lista krajów, w których usługa jest dostępna.
Dwadzieścia minut po ogłoszeniu produktu Meta opublikowała dokument techniczny poświęcony bezpieczeństwu tego rozwiązania, podpisany przez Tareka Sheashę, inżyniera oprogramowania i wiceprezesa Meta Superintelligence Labs. Naczelna zasada została określona od razu: system zaprojektowano przy założeniu, że agent zostanie zaatakowany. Środowisko agentowe, nazywane w kodzie Hatch, działa w kontenerze systemd-nspawn, którego konto root jest mapowane na nieuprzywilejowanego użytkownika hosta, z filtrowanymi wywołaniami systemowymi i odebranymi uprawnieniami jądra. Cztery usługi celowo działają poza tym kontenerem, aby napastnik, który przejmie kontrolę nad agentem, nie mógł ich wyłączyć: klasyfikatory bezpieczeństwa, procesy robocze z odseparowanymi uprawnieniami, demon przechowujący dane uwierzytelniające oraz Sentinel.
Sentinel jest centralnym elementem: jako jedyny może autoryzować działanie konektora lub wychodzący ruch sieciowy, ocenia każde żądanie w warstwach 4 i 7 oraz sprawdza faktycznie rozpoznany adres. Co najważniejsze, agent operuje wyłącznie na tokenach zastępczych, które są zamieniane na rzeczywiste dane uwierzytelniające na granicy sieci. Próba wydobycia sekretu z agenta za pomocą prompt injection traci sens, ponieważ agent nigdy go nie posiadał. Uzupełnia to śledzenie przepływu na poziomie jądra, tainted egress: każdy proces, który odczytuje dane użytkownika, zostaje oznaczony i traci automatyczną autoryzację. Implementacja łączy programy eBPF dołączone do cgroups z hookami Linux Security Module dodanymi przez Meta.
| Element architektury | Wybrane rozwiązanie |
|---|---|
| Kontener środowiska agentowego | systemd-nspawn, root mapowany na nieuprzywilejowanego użytkownika |
| Organ autoryzacyjny | Sentinel, poza kontenerem, warstwy 4 i 7 |
| Dane uwierzytelniające widoczne dla agenta | wyłącznie tokeny zastępcze |
| Konektor poczty elektronicznej | filtrowanie kodów jednorazowych i linków do resetowania |
| Podagent przeglądarkowy | drzewo dostępności, bez surowego DOM-u i bez JavaScriptu na stronie |
| Płatności | Stripe Link w chwili premiery, później Shop Pay, karta jednorazowa |
| Bug bounty, maksymalna nagroda za ważne zgłoszenie | 300 000 dolarów |
| Bug bounty, prompt injection | do 130 000 dolarów |
Dokumentowi towarzyszą dwa ogłoszenia. Program nagród za wykryte luki jest od chwili premiery otwarty dla wszystkich i oferuje do 300 000 dolarów za ważne zgłoszenie, zależnie od wykazanego wpływu, w tym do 130 000 dolarów za skuteczny atak prompt injection oddziałujący na użytkownika. Z kolei Muse Confidential VM, planowane do końca roku, ma w sposób kryptograficzny i możliwy do zweryfikowania uniemożliwić Meta dostęp do danych maszyny wirtualnej, a jego projekt i kod źródłowy zostały już przekazane zewnętrznym audytorom. Konkluzja tekstu jest niezwykle szczera jak na publikację korporacyjną: prompt injection pozostaje nierozwiązanym problemem w branży, a Muse będzie popełniać błędy.
🔗 Premiera Muse · 🔗 Bezpieczeństwo agentów, Meta
Mistral pozyskuje 3 miliardy euro, największe finansowanie kapitałowe europejskiego sektora technologicznego
8 września — Mistral ogłasza rundę Series D o wartości 3 miliardów euro przy wycenie post-money przekraczającej 21 miliardów euro. Firma przedstawia ją jako największą rundę finansowania kapitałowego, jaką kiedykolwiek zamknęła europejska spółka technologiczna, zaledwie trzy lata po swoim powstaniu.
Rundzie przewodzi Samsung Electronics. Współprzewodzą jej Scaleup Europe Fund, zarządzany przez EQT, oraz dotychczasowy akcjonariusz PSG Equity. Do grona inwestorów dołączają trzy nowe podmioty: Advent, fundusze i rachunki zarządzane przez BlackRock oraz Wielkie Księstwo Luksemburga. Lista dotychczasowych inwestorów jest długa i obejmuje trzy kontynenty: od a16z po Salesforce Ventures, a także ASML, BNP Paribas CIB, Bpifrance, DST Global, General Catalyst, Index Ventures, Korelya Capital, Lightspeed i NVIDIA.
Szczególnej uwagi wymaga charakter dwóch kolejnych głównych inwestorów. Rundzie Series C przewodziło ASML, a rundzie Series D przewodzi Samsung Electronics: są to dwie firmy z sektora zaawansowanej produkcji, a nie ogólne fundusze technologiczne. Mistral postrzega to jako oznakę zaufania do swojej zdolności wdrażania najnowocześniejszych modeli w złożonych środowiskach przemysłowych, gdzie kontrola nad danymi i infrastrukturą warunkuje ich przyjęcie.
| Wskaźnik | Wartość |
|---|---|
| Pozyskana kwota | 3 miliardy euro |
| Wycena post-money | ponad 21 miliardów euro |
| Wiek firmy | 3 lata |
| Główny inwestor | Samsung Electronics |
| Współprzewodzący rundzie | Scaleup Europe Fund zarządzany przez EQT, PSG Equity |
| Kraje działalności | 20 |
| Duzi klienci korporacyjni | ponad 125, w tym Airbus, ASML i HSBC |
Jeśli chodzi o wykorzystanie środków, firma wymienia w pierwszej kolejności badania nad modelami frontier, następnie zwiększenie mocy obliczeniowej do trenowania, rozbudowę infrastruktury i przyspieszenie ekspansji handlowej na rynkach międzynarodowych. Argumentacja powtarza stanowisko prezentowane od lata: pytanie zadawane przez organizacje nie miałoby już dotyczyć tego, kto tworzy najpotężniejszy model, lecz tego, jak korzystać z AI bez oddawania kontroli nad własną infrastrukturą. Mistral określa się jako jedyna firma w branży, która składa cały niezbędny stos: od modeli z otwartymi wagami, przez moc obliczeniową, aż po produkty.
Today marks a major step for Mistral: we’re announcing a €3B Series D, the largest equity round ever raised by a European tech company, just three years after launch.
🇵🇱 Dzisiejszy dzień stanowi ważny kamień milowy dla Mistral: ogłaszamy rundę Series D o wartości 3 miliardów euro, największą rundę finansowania kapitałowego, jaką kiedykolwiek przeprowadziła europejska firma technologiczna, zaledwie trzy lata po naszym starcie. — @MistralAI na X
Agenci naukowi OpenAI: dowód dotyczący Naviera-Stokesa i kalibracja kubitów na MIT
8 września — OpenAI publikuje dowód powstawania osobliwości w skończonym czasie dla trójwymiarowych równań Naviera-Stokesa wraz z formalizacją w asystencie dowodzenia Lean. Ogłoszony wynik wskazuje, że początkowo gładki i pozostający w spoczynku trójwymiarowy płyn, poddany działaniu gładkiej siły zewnętrznej, może w skończonym czasie osiągnąć nieograniczony wzrost prędkości, mimo że lepkość dąży do wygładzenia ruchu, a energia układu pozostaje skończona. W oficjalnym sformułowaniu Clay Mathematics Institute odpowiada to twierdzeniom „C” i „D”, które stanowią obalenie, a nie dowód regularności.
Warto precyzyjnie określić, co OpenAI deklaruje, a czego nie. Dowód został opracowany przez skoordynowany system agentów oparty na wewnętrznym modelu bez publicznej nazwy, opisywanym przez firmę jako znacznie bardziej zaawansowany niż GPT-6 Astra i trenowany nieprzerwanie od 28 sierpnia. Jedyną opisaną metodą weryfikacji jest formalizacja w Lean, powierzona GPT-6 Astra i ukończona 17 godzin po rozwiązaniu problemu. W ogłoszeniu nie ma mowy ani o recenzji naukowej, ani o zatwierdzeniu przez Clay Mathematics Institute, a OpenAI oświadcza, że nie zamierza ubiegać się o Nagrodę Milenijną, przedstawiając swój wynik jako migawkę, a nie ostateczne osiągnięcie.
Metoda jest co najmniej równie niezwykła jak sam wynik. Prace rozpoczęły się 1 września po pojawieniu się pogłosek, że właśnie rozwiązano dwa problemy milenijne. Odrębne grupy agentów otrzymały różne warianty problemu: wersje „A” i „B” ukierunkowane na dowód oraz wersje „C” i „D” ukierunkowane na obalenie. W przypadku problemu pobocznego, regularności niewymuszonych równań Eulera, blisko 100 agentów opracowało obalenie w ciągu około pięćdziesięciu godzin; wynik ten wprowadzono następnie do promptów agentów pracujących nad równaniami Naviera-Stokesa.
| Metryka | Wartość |
|---|---|
| Równolegle działający agenci, grupa Naviera-Stokesa | około 10 000 |
| Czas do rozwiązania | około 88 godzin |
| Formalizacja i weryfikacja w Lean | kolejne 17 godzin, za pomocą GPT-6 Astra |
| Wymienione wiadomości, Navier-Stokes | 2,7 miliona |
| Tokeny wyjściowe, Navier-Stokes | około 130 miliardów |
| Wymienione wiadomości, wszystkie podjęte problemy | 4,9 miliona |
| Tokeny wyjściowe, wszystkie podjęte problemy | około 300 miliardów |
| Obalenie regularności niewymuszonych równań Eulera | blisko 100 agentów, około 50 godzin |
Równoległe prace komplikują sytuację. Levent Alpöge, pracownik Anthropic, oraz Tristan Buckmaster, profesor matematyki na NYU, uzyskali wynik dotyczący wymuszonej wersji równań Eulera. OpenAI skontaktowała się z nimi 6 września, po ukończeniu i zweryfikowaniu swojego projektu, aby zaproponować wspólną publikację i uznać ich pierwszeństwo, po czym odkryła, że ich wynik dotyczył innego sformułowania problemu.
This model represents a step-function improvement on many benchmarks, and its training is ongoing. Our internal model group arrived at the Navier–Stokes solution in 88 hours, using around 10,000 coordinating AI agents. Throughout the effort, we maintained the strict safeguards—including monitoring and isolation—that we apply to all our frontier evaluations.
🇵🇱 Model ten zapewnia skokową poprawę w wielu benchmarkach, a jego trening nadal trwa. Nasza wewnętrzna grupa modelowa znalazła rozwiązanie problemu Naviera-Stokesa w ciągu 88 godzin, wykorzystując około 10 000 skoordynowanych agentów AI. Przez cały czas utrzymywaliśmy rygorystyczne zabezpieczenia, w tym monitoring i izolację, które stosujemy we wszystkich ocenach modeli frontier. — @OpenAI na X
Tego samego dnia OpenAI publikuje studium przypadku o znacznie skromniejszej skali, ale zdecydowanie łatwiejsze do zweryfikowania. Beatriz Yankelevich, doktorantka w grupie Engineering Quantum Systems na MIT, połączyła Codex sterowany przez GPT-5.6 Sol z oprogramowaniem koordynującym jej eksperymenty, aby skalibrować nieskalibrowany układ zawierający sześć nadprzewodzących kubitów. Agenci otrzymali skills właściwe dla każdego rodzaju pomiaru, opisujące sposób jego przeprowadzenia i oceny. W przypadku wyraźnych sygnałów Codex przeprowadził pełną sekwencję przy niewielkiej ingerencji: zidentyfikował częstotliwości przejść, skalibrował impulsy sterujące i odczytowe oraz zmierzył czas zachowania informacji kwantowej. W przypadku słabych lub zaszumionych sygnałów potrzebuje więcej czasu na znalezienie użytecznych parametrów i czasami wymaga oceny doświadczonego badacza, który nadal działa szybciej niż model. Korzyścią nie jest więc szybkość, lecz brak potrzeby stałego nadzoru: scharakteryzowanie jednego z takich standardowych układów zajmuje badaczowi kilka dni, dlatego grupa powierza obecnie rutynowe pomiary agentom.
🔗 Rozwiązanie problemu Naviera-Stokesa, OpenAI · 🔗 Codex i eksperymenty kwantowe, OpenAI
ChatGPT Images 2.5 ze Sketch i dwoma modelami obrazu w API
8 września — OpenAI wprowadza ChatGPT Images 2.5 w swoich produktach oraz w API. Podana na wstępie liczba dotycząca użytkowania pokazuje skalę: co tydzień w ChatGPT Images i modelach GPT-Image dostępnych przez API powstają ponad 3 miliardy obrazów. Najbardziej wymierną korzyścią jest opóźnienie zmniejszone nawet o 50 procent w porównaniu z Images 2.0; pozostałe ulepszenia dotyczą zgodności ze zdjęciami referencyjnymi oraz spójności podczas długiej rozmowy, w której wcześniejsze modyfikacje są lepiej zachowywane.
Do ChatGPT trafiają trzy funkcje. Sketch pozwala rysować bezpośrednio w rozmowie, aby utworzyć wizualną wskazówkę, po wpisaniu „@Sketch”. Templates obejmują popularne formaty, takie jak plakaty czy merchandising. Komentarze można umieszczać na obrazie, aby precyzyjnie wskazać obszar retuszu. Udostępniany obraz może teraz zawierać prompt, za pomocą którego został utworzony. Wdrożenie obejmuje wszystkich użytkowników ChatGPT, ChatGPT Work i Codex, na komputerach, urządzeniach mobilnych i w przeglądarce, we wszystkich planach.
| Model w API | Deklarowane zastosowanie | Opóźnienie |
|---|---|---|
| GPT-Image-2.5 Flare | wybór domyślny, treści społecznościowe, generowanie masowe | nawet o 50 procent niższe niż w Images 2.0 |
| GPT-Image-2.5 Sunburst | precyzja, kampanie gotowe do publikacji | dłuższy czas generowania |
Oba modele obsługują nowe ustawienia jakości xhigh i max oraz zachowują ceny tokenów z GPT Image 2, czyli w planie Standard 8,00 dolarów za milion tokenów wejściowych obrazu, 30,00 dolarów za tokeny wyjściowe obrazu i 5,00 dolarów za tokeny wejściowe tekstu. Metadane C2PA i niewidoczny znak wodny pozostają dostępne, a wydaniu towarzyszy system card.
Manus integruje model jeszcze tego samego dnia
Manus dodaje GPT-Image-2.5 do swojej platformy wieczorem w dniu ogłoszenia, przywołując wiadomość OpenAI opublikowaną półtorej godziny wcześniej. Laboratorium agentów, które 1 września ponownie stało się niezależne, podaje liczbę pochodzącą z własnych testów, a nie z testów OpenAI: model określany przez nie jako Flare tworzy obrazy wysokiej jakości od dwóch do czterech razy szybciej niż GPT-Image-2. W przypadku agenta generującego materiały wizualne w toku rozmowy ten współczynnik ma większe znaczenie niż marginalna poprawa jakości, ponieważ decyduje o tym, czy generowanie pozostaje częścią płynnego procesu pracy, czy wymusza oczekiwanie. Manus podkreśla również ulepszone generowanie przezroczystych teł, które eliminuje etap ręcznego wycinania zakłócający pełną automatyzację.
AlphaGenome Atlas, predykcyjna mapa 9 miliardów mutacji ludzkiego DNA
8 września — Google DeepMind uruchamia AlphaGenome Atlas, bazę danych przewidującą molekularny wpływ każdej możliwej jednoliterowej mutacji w ludzkim DNA. Ludzki genom zawiera około 3 miliardów par zasad, z których tylko 2 procent koduje białka; pozostałe 98 procent pozostaje w dużej mierze niezbadane, choć pojedyncza zmiana litery może wyłączyć w nich kluczowy regulator biologiczny.
Metoda opiera się na odwróceniu obciążenia. Zamiast pozwalać każdemu laboratorium odpytywać model wariant po wariancie, Google DeepMind wstępnie obliczyło przewidywania modelu AlphaGenome dla wszystkich 9 miliardów możliwych substytucji. Rezultatem jest zbiór danych o rozmiarze 1 petabajta, przedstawiany jako ponad trzydziestokrotnie większy od AlphaFold Database. Aby umożliwić praktyczne wykorzystanie takiej ilości danych, Atlas wprowadza wynik AVI (AlphaGenome Variant Impact), pojedynczą liczbę agregującą przewidywania dla regionów kodujących i niekodujących oraz wskazującą, które procesy biologiczne zaburza dany wariant, wraz z przypisaniem wpływu do poszczególnych cech. Uzupełnia go katalog ponad 2 500 powtarzających się motywów sekwencji — jednostek regulatorowych, które Google opisuje jako „słowa” genomu.
| Wskaźnik | Wartość |
|---|---|
| Wstępnie obliczone warianty | 9 miliardów, wszystkie zmiany jednej litery |
| Rozmiar zbioru danych | 1 petabajt, ponad 30 razy więcej niż AlphaFold Database |
| Skatalogowane motywy sekwencji | ponad 2 500 |
| Przeanalizowani uczestnicy UK Biobank | ponad 54 000 |
| Dodatkowe powiązania w regionach niekodujących | o 22 procent więcej |
| Zidentyfikowane regiony genetyczne związane z BMI | 19 |
Dwa udokumentowane zastosowania pokazują skalę korzyści. W Broad Institute Laura Covill i jej zespół wykorzystali wynik AVI do ustalenia priorytetów wśród wariantów kandydujących w przypadkach rzadkich chorób, które pozostawały niezdiagnozowane: narzędzie wskazało wariant genu DNM1, przewidując, że tworzy on nieprawidłowe miejsce splicingu, co dostarczyło rozstrzygającego dowodu potrzebnego do wyjaśnienia przypadku. Na University of Exeter Gareth Hawkes zastosował Atlas do danych ponad 54 000 uczestników UK Biobank i uzyskał o 22 procent więcej powiązań genetycznych w regionach niekodujących, a następnie zidentyfikował 19 regionów genetycznych związanych ze wskaźnikiem masy ciała, ograniczając analizę do 1 procenta wariantów o największym wpływie.
Drugą istotną kwestią jest dostęp. Atlas jest dostępny przez niewymagający pisania kodu portal internetowy, przeznaczony dla klinicystów i biologów, którzy nie programują, ale również przez AlphaGenome API, w Cloud za pośrednictwem Model Garden, a dane badawcze opublikowano na GitHub. Szczegół interesujący deweloperów śledzących ekosystem agentów Google: Atlas jest także udostępniany jako umiejętność (skill) w Google Antigravity, dzięki czemu agent programistyczny może bezpośrednio z niego korzystać.
🔗 AlphaGenome Atlas, Google DeepMind
NVIDIA wprowadza CUDA Rust, a Cosmos triumfuje w AI City Challenge na ECCV
8 września — NVIDIA publikuje CUDA Rust, odpowiadając na coraz bardziej widoczną lukę: warstwa systemowa AI jest coraz częściej pisana w Rust, ale kernele GPU pozostawały wyjątkiem. Kernel można było już uruchomić z poziomu Rust, lecz trzeba było napisać go gdzie indziej. CUDA Rust wypełnia tę lukę, natywnie kompilując kernele Rust do PTX za pomocą dwóch odrębnych ścieżek odpowiadających dwóm modelom programowania, które CUDA oferuje już w C++ i Python.
| Element | cuda-oxide, ścieżka SIMT | cutile-rs, ścieżka Tile |
|---|---|---|
| Dojrzałość | wczesna wersja alpha | opublikowany na crates.io |
| Wymagany toolchain Rust | przypięta wersja nightly (nightly-2026-04-03) | stable 1.89 lub nowszy |
| Wersja CUDA | 12.x lub nowsza | 13.3 |
| Wymagany LLVM | tak, wraz z clang i libclang | nie |
| Kompilacja | do PTX podczas budowania | JIT przez CUDA Tile IR |
| Wymienione zastosowania zewnętrzne | brak | Grout od Hugging Face, mistral.rs |
Zalecenie NVIDIA jest jednoznaczne: zacząć od Tile, ponieważ kod źródłowy nie zawiera wtedy żadnych decyzji charakterystycznych dla konkretnej architektury, a po SIMT sięgnąć, gdy konieczna stanie się precyzyjna kontrola wątków i pamięci. Obecnie ten wybór ma swoją cenę, ponieważ w SIMT pamięć współdzielona, będąca podstawą szybkich kerneli, nadal wymaga unsafe. Głównym argumentem jest bezpieczeństwo pamięci na etapie kompilacji: obie ścieżki odrzucają klasyczny aliasing, w którym jeden bufor służy jednocześnie jako wejście i wyjście, z error[E0502] po stronie SIMT i error[E0382] po stronie Tile. NVIDIA nie wyolbrzymia dojrzałości rozwiązań: żaden z projektów nie jest gotowy do zastosowań produkcyjnych, a zapowiedziane zobowiązanie obejmuje rok 2027 i kolejne lata oraz wspólne prace z opiekunami rust-cuda.
Tego samego dnia NVIDIA publikuje wyniki AI City Challenge na ECCV 2026. W ścieżce 5, poświęconej generatywnemu prognozowaniu wideo scen drogowych, cztery z pięciu najlepszych rozwiązań wykorzystują wersje modeli fundacyjnych świata Cosmos. Zespół Qyn wygrywa klasyfikację publiczną dzięki CosmosAlign, który dostosowuje zamrożony model Cosmos3-Nano o 16 miliardach parametrów za pomocą dwuetapowej procedury LoRA, generuje cztery prognozy, wybiera medoid i ponownie wprowadza stabilne regiony z obserwowanej historii: 76,39 wobec 76,04 zespołu SSUPER, czyli przewaga 0,35 punktu. NVIDIA zaznacza, że jest to metoda adaptacji i inferencji, a nie nowa architektura. Cosmos występuje również w roli sędziego: w obu klasyfikacjach poza domeną w ścieżce 3 zwycięża zespół UWIPL_ETRI z UniTraffic, który przekazuje sporne twierdzenia do sprawdzenia niezależnemu weryfikatorowi Cosmos-Reason1.
🔗 CUDA Rust, NVIDIA · 🔗 Wyniki AI City Challenge
Cognition pozyskuje ponad 2 miliardy dolarów i osiąga wycenę 48 miliardów
8 września — Cognition, twórca agenta programistycznego Devin, ogłasza pozyskanie ponad 2 miliardów dolarów przy wycenie wynoszącej 48 miliardów. Rundzie przewodzą dwaj nowi inwestorzy, Andreessen Horowitz i Accel, wraz z dotychczasowymi inwestorami Founders Fund, General Catalyst i Avenir. Grono uzupełnia około trzydziestu uczestników, w tym NVIDIA, Benchmark, Bessemer, Kleiner Perkins, Greylock, Lightspeed, T. Rowe Price i Bain Capital Ventures.
| Wskaźnik | Maj 2026 | Wrzesień 2026 |
|---|---|---|
| Łączna kwota pozyskana w rundzie | ponad 1 miliard dolarów | ponad 2 miliardy |
| Wycena | 26 miliardów dolarów | 48 miliardów |
| Roczne przychody | 492 miliony dolarów | blisko 900 milionów |
| Główni inwestorzy | Lux Capital, General Catalyst, 8VC | Andreessen Horowitz, Accel |
Wycena niemal podwoiła się więc w ciągu czterech miesięcy i wzrosła prawie pięciokrotnie w ciągu roku, a roczne przychody podążają podobną trajektorią. Cognition opisuje zastosowania napędzające ten wzrost: Devin pracuje nad projektowaniem układów scalonych w NVIDIA, lotnictwem w GE Aerospace, usługami finansowymi w Citi, motoryzacją w Mercedes-Benz oraz infrastrukturą AI w Modal. Fakt, że NVIDIA jest jednocześnie klientem i inwestorem w tej rundzie, pokazuje, w jaki sposób firmy te zabezpieczają sobie dostęp do narzędzi używanych wewnętrznie. Trzy niedawno wprowadzone funkcje przesuwają Devin od wykonywania zadań w stronę autonomicznego działania: Auto-Triage do pierwszego etapu analizy incydentów, Security Swarm do segregowania luk w zabezpieczeniach oraz Automations uruchamiane przez zdarzenia w Slack, GitHub lub Linear. W ciągu roku otwarto sześć biur, w tym pięć poza Stanami Zjednoczonymi, obok ośrodków w San Francisco, Nowym Jorku i Austin.
In the next chapter of software engineering, agents will become proactive by default, software will improve itself, and compute will automatically get allocated toward the highest impact use cases. We’re still at the dawn of the self-driving software era.
🇵🇱 W kolejnym rozdziale inżynierii oprogramowania agenci staną się domyślnie proaktywni, oprogramowanie będzie samodzielnie się ulepszać, a moc obliczeniowa będzie automatycznie przydzielana do zastosowań o największym wpływie. Wciąż znajdujemy się u zarania ery autonomicznego oprogramowania. — @cognition na X
Suno zawiera umowę z Believe i TuneCore, które jeszcze niedawno odmawiały dystrybucji jego muzyki
8 września — Suno ogłasza globalne partnerstwo strategiczne z Believe, firmą zajmującą się rozwojem artystów, oraz jej platformą samodzielnej dystrybucji TuneCore. Umowa obejmuje dwie odrębne kwestie. Po pierwsze, Believe włącza się w projektowanie nowych modeli muzycznych rozwijanych przez Suno wspólnie z branżą. Po drugie — i jest to konkretna korzyść dla użytkowników — utwory stworzone za pomocą tego nowego modelu partnerskiego będą mogły być dystrybuowane przez Believe i TuneCore, a więc trafiać do Spotify, Apple Music, Amazon Music i YouTube.
Kontekst pokazuje znaczenie tego ogłoszenia. Suno bez ogródek przypomina, że wcześniej w tym roku Believe i TuneCore zapowiedziały, iż nie będą dystrybuować muzyki stworzonej za pomocą modeli niespełniających ich kryteriów, w tym ówczesnych modeli Suno. Zmiana stanowiska jest przedstawiana jako rezultat rozmów, które ujawniły wspólne wartości: zapewnienie artystom rzeczywistego wyboru oraz otwarcie dróg dystrybucji i uzyskiwania przychodów.
Umowa wpisuje się w spójny ciąg działań. Rozszerza Spark, program Suno przeznaczony dla niezależnych i wschodzących artystów, oraz uzupełnia istniejące umowy z Warner Music Group i BMG o niezależne wytwórnie i artystów wydających muzykę samodzielnie. Suno wyraźnie wiąże ją również ze swoimi niedawno wprowadzonymi zabezpieczeniami: audio watermarkingiem i acoustic fingerprintingiem służącymi do identyfikowania jego utworów poza platformą oraz limitami pobierania, które weszły w życie 3 września, aby zapobiec masowemu rozpowszechnianiu ich w serwisach streamingowych. Zabezpieczenia te będą stosowane do muzyki dystrybuowanej przez Believe i TuneCore. Ogłoszenie kończy się informacją o harmonogramie: Suno zapowiada rychłą premierę swoich nowych modeli, których rodzina 4 września otrzymała nazwę v6.
Cohere udostępnia silnik obsługi (serving) zbudowany wokół megakernela, 1,58x szybszy niż vLLM
8 września — Cohere publikuje silnik obsługi inferencji w całości zbudowany wokół megakernela dekodowania, na licencji Apache 2.0. Firma twierdzi, że jest to pierwsze takie rozwiązanie: nie laboratoryjna demonstracja szybkości, lecz kompletny serwer zdolny do obsługi rzeczywistych żądań za pośrednictwem punktu końcowego zgodnego z OpenAI, z ciągłym przetwarzaniem wsadowym, stronicowaną uwagą, pamięcią podręczną prefiksów i wywoływaniem narzędzi. Obsługiwanym modelem jest North Mini Code, mieszanka ekspertów o 30 miliardach parametrów, z których tylko 3,3 miliarda jest aktywnych na token.
Problem można ująć w jednym zdaniu: podczas dekodowania GPU spędza dużo czasu na czekaniu zamiast na obliczeniach. Klasyczny stos uruchamia jedno jądro (kernel) na operację, a każda granica między jądrami narzuca barierę na całej siatce obliczeniowej. Dekodowanie autoregresyjne jest jednak ograniczone przepustowością pamięci: na każdym etapie North Mini Code przesyła z pamięci HBM 6,6 GB wag oraz około 0,5 GB pamięci podręcznej klucz-wartość przy kontekście 8K, co wyznacza teoretyczny pułap na poziomie około 470 tokenów na sekundę przy przepustowości 3,35 TB/s układu H100. Megakernel usuwa te granice, uruchamiając jedno trwałe jądro, które pozostaje aktywne przez cały etap dekodowania, a zależności ogranicza do liczników w pamięci globalnej.
| Pomiar | Megakernel | vLLM v0.24 | Przyspieszenie |
|---|---|---|---|
| Dekodowanie, rozmiar partii 1, kontekst 8K (tok/s) | 292 | 185 | 1,58x |
| AIME 2025, całościowo (tok/s) | 935 | 661 | 1,41x |
| SciCode, całościowo (tok/s) | 711 | 560 | 1,37x |
| MMLU-Pro, podzbiór informatyczny (tok/s) | 948 | 713 | 1,33x |
| LiveCodeBench v6, całościowo (tok/s) | 803 | 625 | 1,28x |
| GPQA, całościowo (tok/s) | 787 | 631 | 1,25x |
292 tokeny na sekundę przy rozmiarze partii 1 stanowią 62 procent teoretycznego pułapu, wobec 39 procent w przypadku vLLM. Jakość pozostaje bez zmian: 38,9 procent wobec 38,2 w SciCode oraz 70,3 procent po obu stronach w LiveCodeBench v6, jako średnie z siedmiu uruchomień. Jeden szczegół zasługuje na uwagę: przewaga zależy od rozkładu ekspertów — wynosi 1,32x przy rzeczywistym routingu modelu wobec 1,14x przy symulowanym routingu równomiernym, co czyni równomierne pomiary niekorzystnym przypadkiem. Cohere podkreśla wreszcie nieintuicyjną kwestię: napisanie megakernela ma być prostsze, niż sugeruje jego reputacja, dzięki jednemu plikowi CUDA, w którym szesnaście kodów operacji obejmuje cały etap dekodowania. Ograniczenia są jawne i określane jako ograniczenia implementacyjne: wyłącznie dekodowanie, podczas gdy wstępne wypełnianie nadal działa na zwykłych jądrach PyTorch, tylko H100 i BF16 oraz rozmiary partii od 1 do 8.
Anthropic wyjaśnia, jak obniżyć rachunki za Claude Platform bez utraty wydajności
8 września — Anthropic publikuje przewodnik inżynieryjny, który podważa powszechne przekonanie, że obniżenie kosztów agenta oznacza konieczność zaakceptowania gorszych wyników. Opisano w nim trzy dźwignie: maksymalizację współczynnika trafień pamięci podręcznej promptów, usuwanie antywzorców promptów przy przejściu na model graniczny oraz dostosowanie wysiłku do zadania. Metodę przedstawiono w postaci poleceń wykonywalnych w Claude Code, przy czym /claude-api prompt-audit i /claude-api hillclimb dołączają do /claude-api cost-optimize.
| Benchmark, baza Sonnet 5 | Spadek kosztu | Zmierzony szczegół |
|---|---|---|
| LegalBench | około 58 procent | tokeny rozumowania od 102 779 do 8 284 |
| tau2-bench retail | około 73 procent | pamięć podręczna promptów z jawnymi punktami odcięcia |
| OfficeQA Pro | około 52 procent | od 136,20 do 64,87 dolara |
| SWE-bench Verified | około 55 procent | mediana kroków od 29 do 17, liczba tokenów promptu zmniejszona ponad dwukrotnie |
Najbardziej praktyczna liczba nie znajduje się w tej tabeli. W CursorBench 3.2 Claude Fable 5.1 przy poziomie wysiłku low dorównuje Fable 5 przy poziomie high za jedną trzecią kosztu, co częściowo wynika z ceny odczytów z pamięci podręcznej, rozliczanych po 0,25 dolara za milion tokenów wobec wcześniejszego 1,00 dolara. Z kolei w Humanity’s Last Exam bez narzędzi najwyższy poziom wysiłku daje około pół punktu za cenę wyższą o 46 procent — zysk ginący w szumie benchmarku.
🔗 Obniżanie kosztów w Claude Platform
Claude Code 2.1.265: foldery pluginów, limit 1 GB i naprawa pamięci podręcznej promptów
8 września — Claude Code przechodzi na wersję 2.1.265 z pięćdziesięcioma pozycjami w changelogu, w tym trzydziestoma czterema poprawkami, dwa dni po wersji 2.1.263, która zawierała tylko jedną. Opcja --plugin-dir przyjmuje teraz cały folder pluginów; każdy podfolder zawierający manifest jest wczytywany, a dodania i usunięcia dokonane podczas działania są wykrywane. Do wyników narzędzi zapisywanych na dysku stosowany jest limit 1 GB, a podgląd informuje o skróceniu pliku.
Najobszerniejsza część dotyczy pamięci podręcznej promptów, nawiązując do przewodnika opublikowanego tego samego dnia. Dwie osobne poprawki naprawiają przypadki, w których Claude Code sam uniemożliwiał ponowne użycie pamięci podręcznej: wznowienie subagenta uruchomionego na pierwszym planie zmieniało jego listę narzędzi i prefiks promptu systemowego, natomiast członkowie zespołów agentów oraz wznawiani subagenci przenosili kontekst hooków SubagentStart i wstępnie załadowane skills poza prefiks. Dwie poprawki dotyczą bezpieczeństwa: ścieżka pluginu zawierająca ukośnik odwrotny omijała kontrolę ograniczenia dowiązań symbolicznych w macOS i Linux, a w Windows narzędzia do odczytu i zapisu odrzucały każdy plik znajdujący się w AppContainer lub sandboxie z ograniczonym tokenem. Odczyt artefaktu zapisanego przez podmiot zewnętrzny jest teraz traktowany jako niezaufana treść.
🔗 Informacje o wydaniu 2.1.265
Amp zastępuje kolejkę wiadomości sterowaniem na żywo
8 września — Amp zmienia domyślne zachowanie swojego agenta wobec wiadomości wysyłanych w trakcie pracy. Dotychczas wiadomość wpisana podczas działania agenta trafiała do kolejki i była przetwarzana dopiero po zakończeniu tury; teraz jest dostarczana przy pierwszej możliwej okazji. Twórca wskazuje dwie korzyści: agent wcześniej uwzględnia informację zwrotną i przestaje podejmować kroki weryfikacyjne, które nowe polecenie czyni zbędnymi, co oszczędza czas i tokeny w częstym przypadku, gdy widać, że agent zmierza w niewłaściwym kierunku.
Zmiana nie jest pozbawiona skutków ubocznych i Amp je opisuje. Jeśli sterowanie okaże się zbyt gwałtowne, twórca zaleca formułowanie próśb jako „When done, then…” zamiast „Now, …”, aby wyraźnie zaznaczyć, że instrukcja ma zostać zastosowana po zakończeniu bieżącego zadania. Ship, Review i pozostałe wbudowane działania zachowują wcześniejsze zachowanie i nadal trafiają do kolejki, ponieważ zwykle oczekuje się zakończenia pracy przed jej dostarczeniem lub rozpoczęciem przeglądu. Ręczne kolejkowanie pozostaje dostępne zarówno w aplikacji, jak i w CLI.
Muse Spark 1.3 trafia do Cursor z najlepszym stosunkiem wyniku do kosztu w CursorBench
8 września — Cursor dodaje Muse Spark 1.3, model agentowy od Meta Superintelligence Labs, sześć dni po jego prezentacji. Opublikowane liczby nie opowiadają historii o surowej wydajności, lecz o kosztach. W CursorBench 3.2, autorskim benchmarku zbudowanym na podstawie rzeczywistych zadań obejmujących wiele plików, poziom Max osiąga 67,9 procent za 1,31 dolara na zadanie i zajmuje dwunaste miejsce.
| Model i poziom | Wynik CursorBench 3.2 | Koszt zadania w dolarach | Tokeny na zadanie | Miejsce |
|---|---|---|---|---|
| Fable 5.1 Max | 73,4 procent | 9,64 | 72 060 | 1 |
| Grok 4.6 Extra High | 70,8 procent | 2,81 | 41 136 | 3 |
| Opus 5 Max | 70,0 procent | 8,23 | 61 838 | 5 |
| Gemini 3.8 Flash High | 69,2 procent | 2,38 | 81 524 | 9 |
| Muse Spark 1.3 Max | 67,9 procent | 1,31 | 33 034 | 12 |
| GPT-5.6 Sol Max | 67,2 procent | 5,69 | 28 320 | 13 |
| Muse Spark 1.3 Low | 55,0 procent | 0,45 | 12 181 | 49 |
Model Meta plasuje się więc pod względem wyniku daleko za Claude Fable 5.1 Max, ale ten ostatni kosztuje ponad siedem razy więcej na zadanie. Przede wszystkim wyprzedza GPT-5.6 Sol na poziomie Max, kosztując ponad cztery razy mniej. Cursor podtrzymuje swoją metodę polegającą na systematycznym publikowaniu wyniku i kosztu zadania dla każdego dodanego modelu, zamiast ograniczać się do informacji o jego dostępności.
Grok Bot umożliwia wypełnianie formularzy i danych logowania z poziomu czatu, a Grok Imagine zyskuje sterowanie obrazami kluczowymi
8 września — SpaceXAI pozwala teraz uzupełniać formularze i strony logowania dla Grok Bot bez opuszczania rozmowy, zapowiadając obsługę dowolnego menedżera haseł. Funkcja odpowiada na problem charakterystyczny dla trwałych agentów: gdy tylko agent musi przejść przez ekran logowania lub przesłać formularz zawierający dane osobowe, potrzebuje albo zapisanych danych logowania, albo interwencji użytkownika. Przeniesienie tego etapu do wątku rozmowy zamiast do osobnej sesji przeglądarki jest wyborem dotyczącym zarówno ergonomii, jak i bezpieczeństwa.
Dwie godziny później Grok Imagine otrzymuje możliwość sterowania obrazami początkowym i końcowym sceny wideo, a także generowania płynnych pętli, z lepszym wykonywaniem instrukcji i deklarowaną wyższą jakością wideo. Sterowanie obrazami kluczowymi zmienia charakter narzędzia dla osób tworzących kolejne ujęcia: ustalenie ostatniego obrazu jednego ujęcia pozwala ponownie wykorzystać go jako pierwszy obraz następnego, a tym samym łączyć sekwencje, których ciągłość nie zależy już od losowości generowania. Ogłoszenie pojawia się trzy dni po uruchomieniu agenta Grok Imagine Video 1.5 napędzanego modelem Image 2.0.
🔗 Wypełnianie formularzy w Grok Bot · 🔗 Obrazy kluczowe w Grok Imagine
Trzy artykuły badawcze na blogu Hugging Face
8 września — Trzy publikacje społeczności Hugging Face zasługują tego samego dnia na uwagę: dotyczą pogody, bezpieczeństwa modeli oraz modeli inspirowanych organizmami żywymi.
Uruchamianie otwartego modelu pogodowego bez GPU
Hugging Face i Earthmover publikują wspólny artykuł o rzadko omawianym problemie: modele pogodowe oparte na uczeniu maszynowym są na tyle lekkie, że mogą działać na laptopie, a mimo to prawie nikt ich nie uruchamia. Wskazano trzy przeszkody: obliczenia — kilka modeli, w tym AIFS, zależy od flash attention, ograniczonego do określonych architektur kart graficznych — pamięć masową, a przede wszystkim przepustowość, ponieważ każda prognoza wymaga około 1 GB warunków początkowych. Odpowiedź składa się z trzech publicznych artefaktów: przestrzeni demonstracyjnej, zasobnika pamięci masowej (bucket) oraz odtwarzalnego samouczka, który uruchamia Aurora, model Microsoft, w wersji wstępnie wytrenowanej z rozdzielczością 0,25 stopnia, korzystającej z warunków początkowych ERA5 udostępnianych przez platformę danych Earthmover. GPU nie jest wymagany: od dwóch do trzech minut na krok obliczeniowy na procesorze, kilka sekund na karcie graficznej oraz cztery sześciogodzinne kroki dla prognozy na dwadzieścia cztery godziny, następnie porównywanej z ERA5.
🔗 Otwarte modele pogodowe z Earthmover
Model uznawany za bezpieczniejszy, który odrzuca trzy czwarte nieszkodliwych pytań
Multiverse Computing publikuje wynik, który powinien odbić się szerokim echem daleko poza badaniami nad alignmentem. Trenując Qwen3-8B do odrzucania próśb o manipulację polityczną, zespół uzyskuje liczby wyglądające na wyraźne zwycięstwo: średni wskaźnik niebezpiecznych odpowiedzi w HarmBench, StrongREJECT i WildJailbreak spada z 26,26 do 0,14 procent. W tym samym punkcie kontrolnym nadmierne odrzucanie w XSTest rośnie z 2,00 do 74,00 procent. Innymi słowy, konfiguracja najbezpieczniejsza na papierze jest maszyną do odrzucania, a standardowe pomiary w żaden sposób tego nie pokazują. Pomagają dwie korekty: zastąpienie zewnętrznych odpowiedzi zgodności zweryfikowanymi odpowiedziami modelu docelowego obniża nadmierne odrzucanie w XSTest z 15,20 do 5,20 procent, a dodanie nieszkodliwych par granicznych zmniejsza nadmierne odrzucanie po stronie żądań, które należy spełnić, z 32,94 do 4,16 procent, podczas gdy odrzucanie po stronie szkodliwej traci zaledwie cztery punkty.
🔗 Bezpieczeństwo dla kogo, Multiverse Computing
Konektom muchy nie przewyższa własnego przemieszanego okablowania
Oruk publikuje lekcję metodologiczną, która ma znaczenie wykraczające poza modele inspirowane konektomami. Zespół skopiował 499 silnie połączonych neuronów z publicznej rekonstrukcji MaleCNS muchy do rekurencyjnej sieci pełniącej funkcję rezerwuaru, nad którą wytrenowano tylko jeden odczyt ridge. Okablowanie muchy osiąga średnią dokładność testową 16,84 procent, a okablowanie przemieszane 16,88 procent: różnica wynosi minus 0,04 punktu, z przedziałem ufności obejmującym zero. Drugi eksperyment mógłby uchodzić za dowód przeciwny, ponieważ usunięcie 50 neuronów o największych normach wag odczytu obniża dokładność z 16,91 do 10,83 procent. Autorzy wyjaśniają, dlaczego nie ma tu sprzeczności: spektakularna ablacja nigdy nie dowodzi, że topologia biologiczna była konieczna. Warto zaznaczyć, że sam artykuł informuje, iż został przygotowany przez agenta AI na podstawie publikacji, która nie przeszła recenzji naukowej, a pełny zestaw ewaluacyjny pozostaje prywatny.
🔗 Konektom i przemieszane okablowanie, Oruk
Runway zatrudnia zespół paryskiego laboratorium Kinetix
8 września — Runway ogłasza, że dołącza do niego zespół Kinetix, laboratorium badawczego AI z siedzibą w Paryżu. Laboratorium pracowało nad ruchem człowieka w 3D oraz generowaniem wideo zakotwiczonym w fizyce — dwoma tematami, które Runway bezpośrednio łączy ze swoimi badaniami nad modelami świata stosowanymi w robotyce. Zespół dołącza do paryskiego oddziału firmy, który prowadzi również lokalną rekrutację w obszarze badań i inżynierii.
Argument techniczny sprowadza się do jednego zdania z ogłoszenia: naprawdę użyteczny robot musi rozumieć i obsługiwać nieznane środowiska, zadania oraz sytuacje, a według Runway wstępne trenowanie na materiałach wideo na dużą skalę oferuje najskuteczniejszą drogę do rozwiązania tych problemów z generalizacją. Jest to bezpośrednia kontynuacja Solaris, zaprezentowanego 31 sierpnia, oraz GWM Worlds 2, zaprezentowanego 3 września: po nauczeniu modeli symulowania świata Runway chce nauczyć je działania w nim. Yassine Tahi, dyrektor generalny Kinetix, datuje założycielski zakład laboratorium na sześć lat wstecz. Nie podano kwoty ani struktury transakcji.
Sarah Friar przedstawia skalę OpenAI i wpływ jego modeli na koszty
8 września — Sarah Friar publikuje artykuł o tym, jak OpenAI przekształca swoje postępy badawcze w działalność gospodarczą. Tekst jest interesujący bardziej ze względu na trzy wcześniej niepublikowane liczby niż na samą argumentację.
| Wskaźnik | Wartość |
|---|---|
| Aktywni użytkownicy tygodniowo | ponad miliard |
| Firmy będące klientami | 2,5 miliona |
| Codzienne wiadomości po sześciu miesiącach, plany osobiste | około 50 procent więcej niż w pierwszym miesiącu |
| Odrębne zadania wypróbowane po sześciu miesiącach | około dwa razy więcej |
| Kompleksowe koszty obsługi po optymalizacji | spadek o 20 procent |
| Wydajność generowania tokenów | wzrost o ponad 15 procent |
Trzecia liczba domyka interesującą pętlę. GPT-5.6 Sol posłużył do ulepszenia produkcyjnego oprogramowania obsługowego OpenAI, co przełożyło się na obniżenie kosztów obsługi o 20 procent, a dodatkowo na wzrost wydajności generowania tokenów o ponad 15 procent. Innymi słowy, model finansuje część własnej infrastruktury, optymalizując warstwę, która go obsługuje. Trajektoria indywidualnego użytkowania odpowiada ponadto na często zadawane, lecz rzadko dokumentowane pytanie o retencję.
🔗 Praca teraz w zasięgu ręki, OpenAI
OpenAI przeznacza 5 milionów dolarów na niezależne badania dotyczące nastolatków
8 września — OpenAI uruchamia program grantowy o wartości 5 milionów dolarów, przeznaczony na niezależne badania nad wpływem generatywnej AI na osoby w wieku 13–17 lat, ze szczególnym uwzględnieniem rozwoju społecznego i emocjonalnego. Pojedynczy grant może wynieść do 1 miliona dolarów na projekt. Nabór wniosków kończy się 6 października 2026 roku, wybrane projekty zostaną powiadomione najpóźniej 13 listopada 2026 roku, sprawozdanie okresowe jest oczekiwane w pierwszym kwartale 2027 roku, a koszty ogólne są ograniczone do 10 procent wartości każdego grantu.
Na uwagę zasługują dwa szczegóły. Pierwszy dotyczy deklarowanej niezależności: wśród kryteriów oceny znajduje się zdolność projektu do uzyskania wiarygodnych wyników niezależnie od tego, czy będą one korzystne dla dostawców produktów AI, a publikacja wyników jest zalecana, lecz nie stanowi warunku finansowania. Drugi ma charakter administracyjny, ale jest istotny: granty finansuje i zarządza nimi OpenAI Group PBC, czyli podmiot komercyjny, a nie OpenAI Foundation. Harmonogram nie jest przypadkowy: 31 sierpnia OpenAI poparło kalifornijski projekt ustawy dotyczący ochrony nieletnich przed zagrożeniami związanymi z AI, a wpis wskazuje, że program ma dostarczyć wiedzy potrzebnej regulatorom przy podejmowaniu decyzji.
🔗 Granty na badania dotyczące nastolatków
W skrócie
- Boris Cherny publicznie ocenia inne laboratoria pod względem ryzyka prompt injection — twórca Claude Code stawia nowy model OpenAI na równi z Gemini Flash i Opus 4.8 pod względem prompt injection oraz otwarcie deklaruje, że będzie publicznie wymieniał laboratoria z nazwy, dopóki nie zaczną traktować bezpieczeństwa poważniej. Około dwudziestu minut później łagodzi ton w odpowiedzi we własnym wątku. 🔗 Publikacja
- Anthropic publikuje film z założycielami tworzącymi rozwiązania na Claude Managed Agents — rozmowy z założycielami Wispr Flow, Actively i Pendo o wykorzystywaniu outcomes, sandboxa i pamięci do skalowania działalności. 🔗 Publikacja
- RelayShield skanuje pliki instrukcji zamiast kodu repozytoriów — płatna usługa odczytująca AGENTS.md, CLAUDE.md, .cursorrules i mcp.json w celu wykrywania złośliwych instrukcji w języku naturalnym, których nie dostrzega analiza statyczna. Podana we wpisie liczba złośliwych repozytoriów nie zgadza się z jego własnym źródłem. 🔗 Wpis
- Ai2 zapowiada swoją obecność na ECCV 2026 — artykuły i wystąpienia rozłożone na całą konferencję, bez podanych tytułów ani programu. 🔗 Publikacja
- Prismberry publikuje esej o warstwie narzędzi agentów korporacyjnych — tekst pozycjonujący, który rozróżnia narzędzia informacyjne, analityczne i wykonawcze, bez zapowiedzi ani pomiarów, promujący produkt Agent IQ jego wydawcy. 🔗 Wpis
- Dziennik konserwacji sprzętu opublikowany na blogu Hugging Face — diagnoza zużycia łożyska w wentylatorze zasilacza o mocy 650 W, bez treści związanych ze sztuczną inteligencją. 🔗 Wpis
- Missouri udostępnia Gemini for Education 1,1 miliona uczniów i studentów — partnerstwo obejmujące cały stan, które zapewnia niemal 100 000 nauczycieli oraz ponad 1,1 miliona uczniów i studentów bezpłatny dostęp do Gemini for Education, Gemini Notebook i certyfikatów Google, przy czym dane są wyłączone z treningu, a decyzję o wdrożeniu pozostawiono każdej placówce. 🔗 Ogłoszenie
- Dependabot odczytuje prywatne rejestry GitHub bez tokena osobistego —
GITHUB_TOKENDependabota może poprosić o uprawnieniepackages: readi pobierać dane z prywatnych rejestrów GitHub Packages. Funkcja, którą udostępniono, a następnie wycofano w czerwcu, powraca z automatycznymi poświadczeniami ograniczonymi do roli rozwiązania awaryjnego. 🔗 Dziennik zmian - Portal pomocy technicznej GitHub przenosi się na help.github.com — pomoc techniczna, dokumentacja, materiały edukacyjne, społeczność i zasoby dotyczące konta zostały zgromadzone w jednym miejscu, z wyszukiwarką wspieraną przez Copilot, która nie wymaga logowania. 🔗 Dziennik zmian
- Genspark otwiera Spark House podczas SF Tech Week, oferując wcześniejszy dostęp do GenTeam — inicjatywa społecznościowa zapewniająca uczestnikom wcześniejszy dostęp do GenTeam oraz prywatnych rozmów między założycielami i inwestorami. 🔗 Publikacja
- Ethan Tandowsky zostaje dyrektorem finansowym ElevenLabs — druga nominacja na stanowisko kierownicze w ElevenLabs w ciągu sześciu dni, po mianowaniu Ashley Kramer dyrektorką ds. przychodów 2 września. 🔗 Publikacja
- MiniMax gromadzi w Tokio przedstawicieli japońskiej branży rozrywkowej i cztery podmioty zajmujące się generatywną AI — wydarzenie 11 września w Shibuyi z udziałem producenta Yasushiego Akimoto, KADOKAWA, KAGAMIAI, Higgsfield, Krea, Runway i HeyGen, bez premiery ani danych liczbowych. 🔗 Publikacja
- Dwie transmisje Nemotron Labs tego samego dnia, o OpenShell i Domyn — 49 minut i 44 sekundy o zabezpieczaniu autonomicznych agentów za pomocą OpenShell oraz 54 minuty i 20 sekund o wykorzystywaniu Nemotron przez Domyn, bez opisu tekstowego ani transkrypcji. 🔗 Publikacja
- HeyGen zestawia dwa awatary tej samej twarzy, nie podając nazwy narzędzia ani modelu — porównanie marketingowe bez nazwanego konkurencyjnego narzędzia, wskazanego modelu i pomiarów. 🔗 Publikacja
- OpenAI rozszerza swój program dziennikarski na szkoły dziennikarskie — ponad 400 subskrypcji ChatGPT Edu dla studentów studiów magisterskich i wykładowców Newmark J-School przy CUNY oraz Medill School przy Northwestern na lata 2026–2027. 🔗 Ogłoszenie
- Perplexity publikuje przewodnik po zwrocie z inwestycji we wdrażanie AI — wpis edukacyjny bez zapowiedzi produktu, w którym wszystkie dane liczbowe pochodzą od podmiotów trzecich lub z opinii klientów. 🔗 Wpis
Co to oznacza
Osobisty agent staje się produktem infrastrukturalnym, a jego bezpieczeństwo — osobnym produktem. Meta nie ogranicza się do udostępnienia Muse: tego samego dnia publikuje najbardziej szczegółowy jak dotąd opis sposobu kontrolowania agenta, który dysponuje shellem, przeglądarką i dostępem do skrzynki pocztowej. Najbardziej pouczającym rozwiązaniem są tokeny zastępcze, dzięki którym prompt injection przestaje mieć znaczenie w kontekście kradzieży poświadczeń — nie dlatego, że model lepiej się przed nim broni, lecz dlatego, że nigdy nie otrzymuje sekretu. Tainted egress opiera się na tej samej logice: zamiast ufać modelowi, instrumentuje się jądro. Bug bounty w wysokości 300 000 dolarów oraz szczerość podsumowania, które przyznaje, że Muse będzie popełniać błędy, przekazują to samo co Boris Cherny, gdy publicznie ocenia inne laboratoria pod względem tego ryzyka. Bezpieczeństwo agentów nie jest już polem do odhaczenia, lecz obszarem inżynierii, który się publikuje i za którego przełamywanie się płaci.
Ten dzień stanowi również lekcję ekonomii AI, a jednostką rozliczeniową nie jest już wynik, lecz koszt zadania. Mistral pozyskuje 3 miliardy euro przy wycenie przekraczającej 21 miliardów, a Cognition ponad 2 miliardy przy wycenie wynoszącej 48 miliardów; w obu przypadkach przy stole zasiadają przedsiębiorstwa przemysłowe i klienci, a nie wyłącznie fundusze technologiczne. Jednocześnie Cursor publikuje zestawienie, w którym Muse Spark 1.3 osiąga 67,9 procent za 1,31 dolara na zadanie, podczas gdy lider rankingu płaci 9,64 dolara za wynik wyższy o sześć punktów, a Anthropic dokumentuje obniżki kosztów od 52 do 73 procent bez utraty wydajności, pokazując, że mocniejszy model działający z mniejszym wysiłkiem często pokonuje słabszy model wykorzystany do granic możliwości. Sarah Friar przedstawia liczby z drugiego końca łańcucha: koszty obsługi spadły o 20 procent dzięki wykorzystaniu GPT-5.6 Sol do optymalizacji warstwy, która go obsługuje. To cztery sposoby na powiedzenie, że przedmiotem kompromisu nie są już możliwości, lecz ich cena.
W nauce pytanie nie brzmi już, czy agenci generują wyniki, lecz jak je weryfikować. OpenAI ogłasza dowód dotyczący osobliwości w równaniach Naviera-Stokesa, uzyskany przez około 10 000 agentów w ciągu 88 godzin i sformalizowany w Lean, bez wspomnianej recenzji naukowej ani walidacji instytucjonalnej, przy użyciu wewnętrznego modelu, którego nikt spoza firmy nie może sprawdzić. Ostrożność przedsiębiorstwa, które rezygnuje z ubiegania się o Nagrodę Milenijną i mówi o „migawce”, sama w sobie jest informacją. Dwie pozostałe prace z tego dnia pokazują skalę kontrastu: na MIT Codex radzi sobie z dobrze zdefiniowanymi protokołami, lecz zawodzi przy niejednoznacznych sygnałach, a doświadczony badacz nadal pracuje szybciej; w Google DeepMind AlphaGenome Atlas nie twierdzi, że czegokolwiek dowodzi — wstępnie oblicza 9 miliardów prognoz i przenosi ciężar pracy na walidację eksperymentalną. Wpis Oruk domyka ten wywód, pokazując, że spektakularna ablacja niczego nie dowodzi bez dopasowanego porównania, a tekst Multiverse Computing przypomina, że wskaźnik bezpieczeństwa nic nie znaczy, dopóki przypadki nieszkodliwe nie zostaną zmierzone z taką samą rygorystycznością.
Pozostaje warstwa niskopoziomowa, w której korzyści nie wynikają już z wag modelu. Cohere udostępnia kompletny silnik obsługowy, gdzie jedyną zmianą jest usunięcie granic między kernelami, co zapewnia przepustowość 1,58x większą niż vLLM przy identycznej jakości, i podkreśla, że trudność napisania megakernela jest przeceniana. NVIDIA otwiera dwie ścieżki tworzenia kerneli GPU w Rust, z których jedna jest już wykorzystywana poza firmą w silniku inferencyjnym Grout od Hugging Face oraz w mistral.rs, przyznając jednocześnie, że żadne z tych rozwiązań nie jest gotowe do produkcji. W AI City Challenge cztery z pięciu najlepszych rozwiązań wideo opierają się na modelach Cosmos dostosowanych za pomocą LoRA, a zwycięski zespół podkreśla, że jest to metoda adaptacji, a nie nowa architektura. Samouczek pogodowy Earthmover opowiada tę samą historię od drugiej strony: model Aurora działa na procesorze, a przeszkodą nie były obliczenia, lecz konieczność pobrania gigabajta warunków początkowych. Za każdym razem wartość tkwi w inżynierii otaczającej model — i jest ona publikowana.
Źródła
- Premiera Muse, Meta
- Bezpieczeństwo i ochrona agentów z Muse, Meta
- Runda D Mistral
- Ogłoszenie rundy D na X
- Rozwiązanie problemu Naviera-Stokesa, OpenAI
- Wątek OpenAI o modelu wewnętrznym
- Codex i eksperymenty z obliczeniami kwantowymi na MIT
- ChatGPT Images 2.5, OpenAI
- Manus integruje GPT-Image-2.5
- AlphaGenome Atlas, Google DeepMind
- CUDA Rust, NVIDIA
- AI City Challenge na ECCV 2026, NVIDIA
- Runda E Cognition
- Wątek Cognition na X
- Partnerstwo Suno, Believe i TuneCore
- Megakernel dekodujący, Cohere
- Obniżanie kosztów na Claude Platform, Anthropic
- Claude Code 2.1.265
- Sterowanie agentem na żywo, Amp
- Muse Spark 1.3 w Cursor
- Wypełnianie formularzy w Grok Bot
- Klatki kluczowe i pętle w Grok Imagine
- Otwarte modele pogodowe z Earthmover, Hugging Face
- Bezpieczeństwo dla kogo, Multiverse Computing
- Konektom muchy i przemieszane połączenia, Oruk
- Kinetix dołącza do Runway
- Artykuł Sarah Friar, OpenAI
- Granty na badania dotyczące nastolatków, OpenAI
- Boris Cherny o ryzyku prompt injection
- Założyciele tworzący rozwiązania na Claude Managed Agents
- RelayShield i pliki instrukcji
- Ai2 na ECCV 2026
- Warstwa narzędzi agentów, Prismberry
- Dziennik konserwacji sprzętu
- Gemini for Education w Missouri
- Dependabot i prywatne rejestry GitHub
- Nowy portal pomocy technicznej GitHub
- Spark House podczas SF Tech Week, Genspark
- Ethan Tandowsky, dyrektor finansowy ElevenLabs
- Wydarzenie MiniMax w Tokio
- Transmisje Nemotron Labs
- Porównanie awatarów HeyGen
- Program dziennikarski OpenAI
- Przewodnik po zwrocie z inwestycji w AI, Perplexity