ai-powered-markdown-translatorمقال مترجم من الفرنسية إلى العربية باستخدام gpt-5.6-sol.
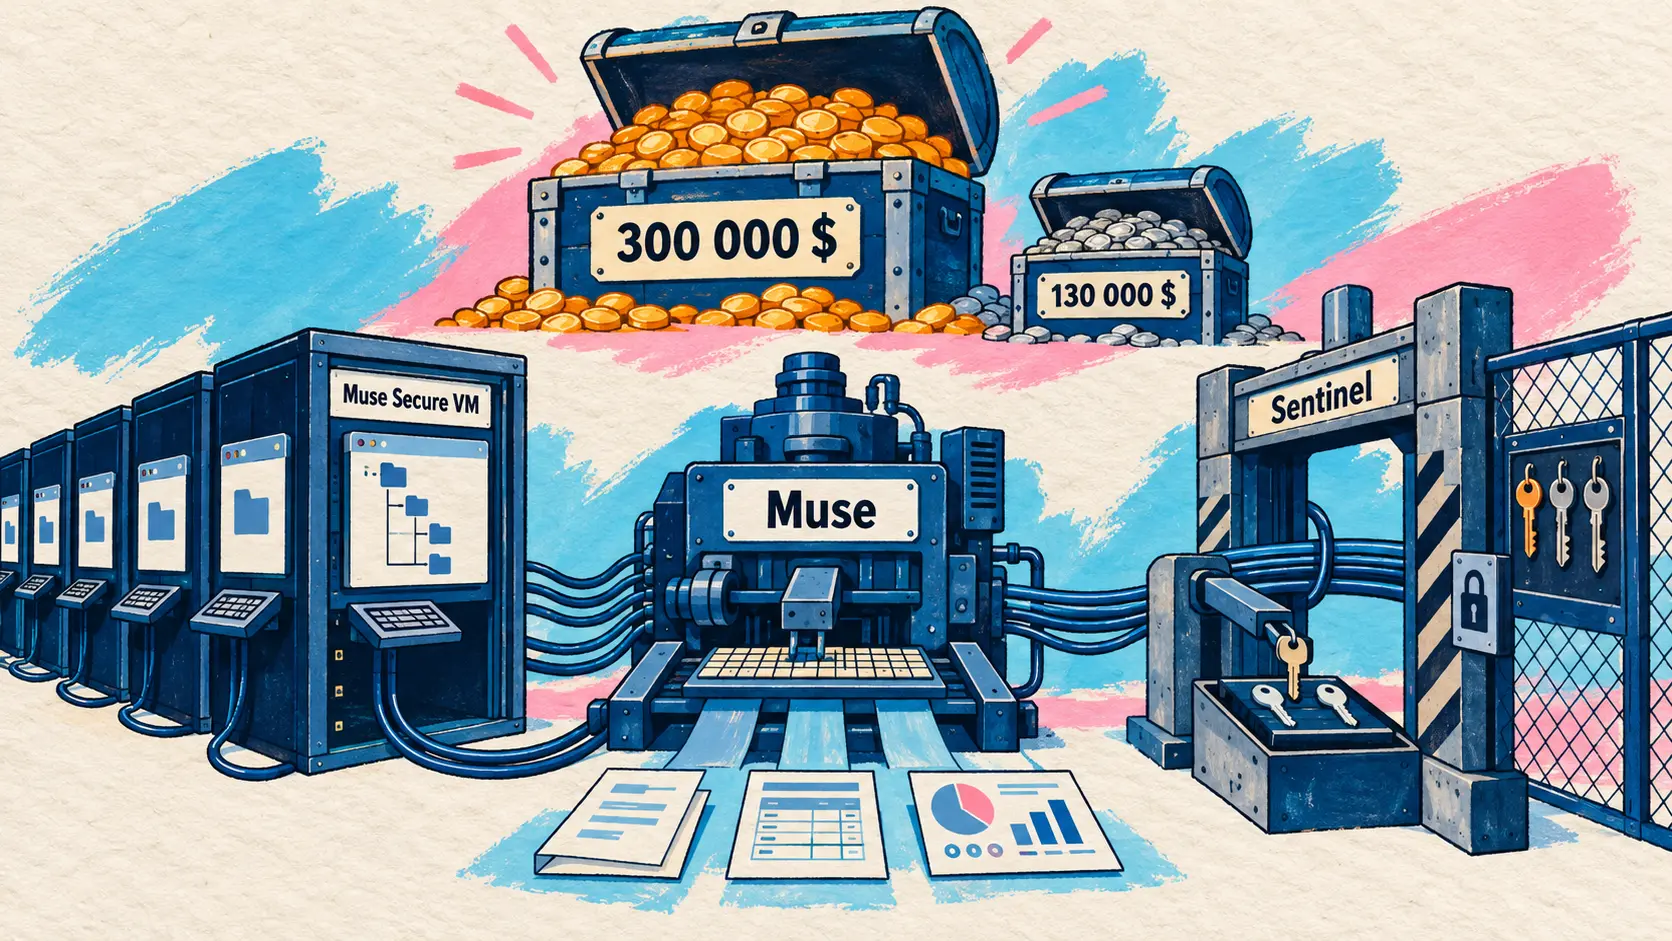
تطلق Meta وكيلًا شخصيًا باسم Muse يمنح كل مستخدم جهاز Linux خاصًا به في السحابة، وتنشر في اليوم نفسه البنية الأمنية المحيطة به، مع برنامج مكافآت لاكتشاف الثغرات (bug bounty) مفتوح للجميع بقيمة تصل إلى 300 ألف دولار. وتعلن Mistral عن جولة Series D بقيمة 3 مليارات يورو، وهي أكبر جولة تمويل بالأسهم تُتمّها شركة تكنولوجيا أوروبية على الإطلاق. أما OpenAI فتنشر برهانًا على تشكّل تفرد خلال زمن منتهٍ في معادلات Navier-Stokes، أنتجه نظام من الوكلاء، فيما تجري Google DeepMind حسابًا مسبقًا لتأثير 9 مليارات طفرة محتملة في الحمض النووي البشري.
Meta تطلق وكيلها الشخصي Muse وتنشر بنيته الأمنية
8 سبتمبر — تطلق Meta وكيلًا شخصيًا باسم Muse، متاحًا عبر تطبيقي iOS وAndroid وواجهة ويب وداخل WhatsApp، ومدعومًا بنموذج Muse Spark 1.3. النموذج ليس جديدًا؛ فقد وصل في 2 سبتمبر إلى Muse Code وMeta Model API، وأصبحت أعلى درجة استدلال فيه متاحة للعامة في 4 سبتمبر. الجديد هو المنتج الموجّه إلى عامة المستخدمين والمبني حوله.
تعتمد البنية على فكرة بسيطة في صياغتها وثقيلة في تنفيذها: يحصل كل مستخدم على حاسوب خاص به في السحابة. وMuse Secure VM عبارة عن جهاز Linux دائم ومعزول، مزود بنظام ملفات وطرفية ومتصفح كامل، وبمساحة تخزين وقدرة معالجة وذاكرة تكفي لتجميع الشيفرات وتطوير مهارات مخصصة وتشغيل وكلاء فرعيين بالتوازي. وهذا الجهاز، لا بنية Meta المركزية، هو الذي يمثّل النظام المرجعي لبيانات الخدمات المتصلة وبيانات اعتمادها. وعندما تفتقر مهمة إلى أداة ما، يكتبها الوكيل بنفسه، وينتج عناصر قابلة للتعامل معها بدلًا من كتل نصية: مسارات رحلات وملفات PDF وصفحات ويب ولوحات معلومات، تطلق عليها Meta اسم Artifacts.
أما التحول الثاني الذي تعلن عنه الشركة، فهو أن الوكيل يعمل في الخلفية حتى بعد إغلاق التطبيق، وفق جدول زمني واستجابةً للأحداث، ثم يقرر ما إذا كانت النتيجة تستحق إرسال إشعار. والذاكرة دائمة وقابلة للقراءة والتعديل من جانب المستخدم، فيما توفر علامة تبويب الأهداف نظرة شاملة إلى ما يتابعه الوكيل. لكن يبقى ما لم تفصح عنه Meta: لم تُنشر أي أسعار، ولم ترافق الإطلاقَ أي قائمة بالدول التي سيتوفر فيها المنتج.
بعد عشرين دقيقة من إعلان المنتج، نشرت Meta وثيقة هندسية موقعة من Tarek Sheasha، مهندس برمجيات ونائب رئيس في Meta Superintelligence Labs، حول أمن هذا النظام. وقد وُضع المبدأ التوجيهي منذ البداية: صُمم النظام على افتراض أن الوكيل سيتعرض للهجوم. ويعمل إطار تشغيل الوكيل، المسمى Hatch في الشيفرة، داخل حاوية systemd-nspawn يُربط فيها المستخدم الجذر بمستخدم غير ذي امتيازات على المضيف، مع تصفية استدعاءات النظام وسحب صلاحيات النواة. وتعمل أربع خدمات عمدًا خارج هذه الحاوية حتى لا يستطيع مهاجم يخترق الوكيل تعطيلها: مصنفات الأمان، وعمال بامتيازات منفصلة، وبرنامج إدارة تخزين بيانات الاعتماد، وSentinel.
يمثّل Sentinel العنصر المحوري؛ فهو السلطة الوحيدة القادرة على السماح بإجراء موصل أو باتصال صادر إلى الشبكة، ويقيّم كل طلب في الطبقتين 4 و7 ويتحقق من العنوان الذي جرى حله فعليًا. والأهم أن الوكيل لا يتعامل إلا مع رموز بديلة، تُستبدل ببيانات الاعتماد الحقيقية عند حدود الشبكة. وبذلك يصبح إجبار الوكيل على إفشاء سر عبر حقن الأوامر غير ذي موضوع، لأنه لم يمتلكه أصلًا. ويُضاف إلى ذلك تتبع للتدفق على مستوى النواة يُسمى tainted egress: إذ تُعلَّم أي عملية تقرأ بيانات المستخدم وتفقد إذنها التلقائي. ويجمع التنفيذ بين برامج eBPF المرتبطة بمجموعات cgroups وخطافات Linux Security Module أضافتها Meta.
| عنصر البنية | الخيار المعتمد |
|---|---|
| حاوية إطار تشغيل الوكيل | systemd-nspawn، مع ربط المستخدم الجذر بمستخدم غير ذي امتيازات |
| سلطة منح الأذونات | Sentinel، خارج الحاوية، في الطبقتين 4 و7 |
| بيانات الاعتماد التي يراها الوكيل | رموز بديلة فقط |
| موصل البريد الإلكتروني | تصفية الرموز أحادية الاستخدام وروابط إعادة التعيين |
| الوكيل الفرعي للمتصفح | شجرة إمكانية الوصول، من دون DOM خام، ومن دون JavaScript داخل الصفحة |
| المدفوعات | Stripe Link عند الإطلاق، ثم Shop Pay، وبطاقة أحادية الاستخدام |
| الحد الأقصى لمكافأة الثغرات لكل تقرير صالح | 300 ألف دولار |
| مكافأة حقن الأوامر | ما يصل إلى 130 ألف دولار |
يرافق الوثيقة إعلانان. يُفتح برنامج مكافآت اكتشاف الثغرات للجميع منذ الإطلاق، مع مكافأة تصل إلى 300 ألف دولار لكل تقرير صالح بحسب الأثر المثبت، منها ما يصل إلى 130 ألف دولار لعملية حقن أوامر ناجحة تؤثر في مستخدم. ومن المفترض أن تمنع Muse Confidential VM، المقرر إطلاقها بحلول نهاية العام، Meta من الوصول إلى بيانات الجهاز الافتراضي بطريقة مشفرة وقابلة للتحقق، وقد عُرض تصميمها وشيفرتها المصدرية بالفعل على مدققين خارجيين. وتأتي خاتمة النص بصراحة غير معتادة في منشور لشركة: يظل حقن الأوامر مشكلة مفتوحة في القطاع، وسوف يرتكب Muse أخطاء.
🔗 إطلاق Muse · 🔗 أمن الوكلاء وسلامتهم، Meta
Mistral تجمع 3 مليارات يورو في أكبر جولة تمويل بالأسهم في قطاع التكنولوجيا الأوروبي
8 سبتمبر — تعلن Mistral عن جولة Series D بقيمة 3 مليارات يورو، وبتقييم لاحق للاستثمار يتجاوز 21 مليار يورو. وتصف الشركة هذه الجولة بأنها أكبر جولة تمويل بالأسهم تُتمّها شركة تكنولوجيا أوروبية على الإطلاق، وذلك بعد ثلاث سنوات من تأسيسها.
تقود Samsung Electronics العملية. ويشارك في قيادتها Scaleup Europe Fund، الذي تديره EQT، وPSG Equity، المساهم بالفعل في الشركة. كما ينضم ثلاثة مستثمرين جدد: Advent، وصناديق وحسابات تديرها BlackRock، ودوقية Luxembourg الكبرى. وتطول قائمة المستثمرين الحاليين لتشمل ثلاث قارات، من a16z إلى Salesforce Ventures، مرورًا بـASML وBNP Paribas CIB وBpifrance وDST Global وGeneral Catalyst وIndex Ventures وKorelya Capital وLightspeed وNVIDIA.
التفصيل الجدير بالاهتمام هو طبيعة المستثمرين الرئيسيين المتعاقبين. فقد قادت ASML جولة Series C، وتقود Samsung Electronics جولة Series D: وهما شركتان صناعيتان في مجال التصنيع المتقدم، وليستا صندوقين عامين للاستثمار التكنولوجي. وترى Mistral في ذلك مؤشرًا إلى الثقة بقدرتها على نشر نماذج متقدمة داخل بيئات صناعية معقدة، حيث تتحكم السيادة على البيانات والبنية التحتية في وتيرة التبني.
| المؤشر | القيمة |
|---|---|
| المبلغ المجموع | 3 مليارات يورو |
| التقييم اللاحق للاستثمار | أكثر من 21 مليار يورو |
| عمر الشركة | 3 سنوات |
| المستثمر الرئيسي | Samsung Electronics |
| المستثمران المشاركان في القيادة | Scaleup Europe Fund الذي تديره EQT، وPSG Equity |
| دول التشغيل | 20 |
| كبار العملاء | أكثر من 125، منهم Airbus وASML وHSBC |
وفي ما يتعلق باستخدام الأموال، تذكر الشركة أولًا أبحاث النماذج المتقدمة، ثم زيادة القدرة الحاسوبية المخصصة للتدريب، وتوسيع البنية التحتية، وتسريع النشاط التجاري دوليًا. ويكرر خطابها النهج الذي تدافع عنه منذ الصيف: لم يعد السؤال الذي تطرحه المؤسسات هو من يبني أقوى نموذج، بل كيف تستفيد من الذكاء الاصطناعي من دون التخلي عن السيطرة على بنيتها التحتية. وتصف Mistral نفسها بأنها الشركة الوحيدة في القطاع التي تجمع المجموعة التقنية الكاملة المطلوبة، من النماذج ذات الأوزان المفتوحة إلى المنتجات، مرورًا بالقدرة الحاسوبية.
Today marks a major step for Mistral: we’re announcing a €3B Series D, the largest equity round ever raised by a European tech company, just three years after launch.
🇸🇦 يمثّل اليوم محطة بارزة لـMistral: نعلن عن جولة Series D بقيمة 3 مليارات يورو، وهي أكبر جولة تمويل بالأسهم تنفذها شركة تكنولوجيا أوروبية على الإطلاق، بعد ثلاث سنوات فقط من إطلاقنا. — @MistralAI على X
وكلاء OpenAI العلميون: برهان حول Navier-Stokes ومعايرة وحدات qubit في MIT
8 سبتمبر — تنشر OpenAI برهانًا على تشكّل تفرد خلال زمن منتهٍ في معادلات Navier-Stokes ثلاثية الأبعاد، مصحوبًا بصياغة رسمية داخل مساعد البرهنة Lean. والنتيجة المعلنة هي أن مائعًا ثلاثي الأبعاد، أملسًا وساكنًا في البداية وخاضعًا لقوة خارجية ملساء، يمكن أن تزداد سرعته بلا حدود خلال زمن منتهٍ، رغم أن اللزوجة تميل إلى تنعيم الحركة وأن طاقة النظام تظل منتهية. ووفق الصياغة الرسمية لـClay Mathematics Institute، يتوافق ذلك مع العبارتين «C» و«D»، وهما اللتان تشكلان تفنيدًا لا برهانًا على الانتظام.
من الجدير توضيح ما تدّعيه OpenAI وما لا تدّعيه بدقة. أنتج البرهانَ نظامٌ من الوكلاء المنسقين يستند إلى نموذج داخلي لم يُعلن اسمه، وتصفه الشركة بأنه أقدر بكثير من GPT-6 Astra، ولا يزال تدريبه مستمرًا منذ 28 أغسطس. والتحقق الوحيد الموصوف هو الصياغة الرسمية في Lean، التي أُسندت إلى GPT-6 Astra واكتملت خلال 17 ساعة بعد التوصل إلى الحل. ولا يشير الإعلان إلى أي مراجعة من الأقران أو أي اعتماد من Clay Mathematics Institute، كما تعلن OpenAI أنها لا تنوي المطالبة بجائزة الألفية، وتقدم نتيجتها بوصفها لقطة مرحلية لا إنجازًا نهائيًا.
ولا تقل الطريقة تميزًا عن النتيجة. بدأ العمل في 1 سبتمبر، عقب شائعات زعمت أن مسألتين من مسائل الألفية قد حُلّتا للتو. وتلقت مجموعات منفصلة من الوكلاء صيغًا مختلفة للمسألة؛ إذ وُجّهت الصيغتان «A» و«B» نحو إثباتها، والصيغتان «C» و«D» نحو تفنيدها. وفي مسألة جانبية تتعلق بانتظام معادلات Euler غير القسرية، أنتج نحو 100 وكيل تفنيدًا في قرابة خمسين ساعة؛ ثم أُضيفت هذه النتيجة إلى أوامر الوكلاء العاملين على Navier-Stokes.
| المقياس | القيمة |
|---|---|
| الوكلاء المتزامنون، مجموعة Navier-Stokes | نحو 10 000 |
| المدة حتى التوصل إلى الحل | نحو 88 ساعة |
| الصياغة الرسمية والتحقق في Lean | 17 ساعة إضافية، عبر GPT-6 Astra |
| الرسائل المتبادلة، Navier-Stokes | 2,7 مليون |
| رموز الخرج، Navier-Stokes | نحو 130 مليارًا |
| الرسائل المتبادلة، جميع المسائل المجربة | 4,9 ملايين |
| رموز الخرج، جميع المسائل المجربة | نحو 300 مليار |
| تفنيد انتظام Euler غير القسري | قرابة 100 وكيل، ونحو 50 ساعة |
يزيد عمل موازٍ المشهد تعقيدًا. فقد كان لدى Levent Alpöge، الموظف في Anthropic، وTristan Buckmaster، أستاذ الرياضيات في NYU، نتيجة تتعلق بمعادلات Euler في نسختها القسرية. وتواصلت OpenAI معهما في 6 سبتمبر، بعد اكتمال مشروعها والتحقق منه، لاقتراح نشر مشترك والإقرار بأسبقيتهما، قبل أن تكتشف أن نتيجتهما تتعلق بعبارة مختلفة عن عبارتها.
This model represents a step-function improvement on many benchmarks, and its training is ongoing. Our internal model group arrived at the Navier–Stokes solution in 88 hours, using around 10,000 coordinating AI agents. Throughout the effort, we maintained the strict safeguards—including monitoring and isolation—that we apply to all our frontier evaluations.
🇸🇦 يمثّل هذا النموذج تحسنًا متدرجًا وملحوظًا في العديد من الاختبارات المعيارية، ولا يزال تدريبه مستمرًا. وتمكنت مجموعة نموذجنا الداخلي من التوصل إلى حل Navier-Stokes خلال 88 ساعة، باستخدام نحو 10 000 وكيل ذكاء اصطناعي منسق. وطوال هذا العمل، حافظنا على الضوابط الصارمة، بما فيها المراقبة والعزل، التي نطبقها في جميع تقييماتنا للنماذج المتقدمة. — @OpenAI على X
في اليوم نفسه، تنشر OpenAI دراسة حالة أكثر تواضعًا بكثير وأسهل بكثير في التحقق. فقد ربطت Beatriz Yankelevich، طالبة الدكتوراه في مجموعة Engineering Quantum Systems في MIT، برنامج Codex المدعوم بـGPT-5.6 Sol بالبرمجيات التي تنسق تجاربها، لمعايرة رقاقة غير معايرة تضم ست وحدات qubit فائقة التوصيل. وتلقى الوكلاء skills خاصة بكل نوع من القياسات، تصف كيفية إجرائه والحكم على نتائجه. ومع الإشارات الواضحة، نفذ Codex تسلسلًا كاملًا بتدخل محدود: تحديد ترددات الانتقال، ومعايرة نبضات التحكم والقراءة، وقياس مدة الاحتفاظ بالمعلومات الكمّية. أما مع الإشارات الضعيفة أو المشوشة، فيستغرق وقتًا أطول للعثور على معاملات قابلة للاستخدام، ويحتاج أحيانًا إلى عين باحث متمرس، يظل أسرع من النموذج. ولذلك لا تكمن الفائدة في السرعة، بل في الاستغناء عن الإشراف الدائم: إذ يتطلب توصيف إحدى هذه الرقاقات القياسية عدة أيام من عمل باحث، وقد باتت المجموعة تسند القياسات الروتينية إلى الوكلاء.
🔗 حل Navier-Stokes، من OpenAI · 🔗 Codex والتجارب الكمّية، من OpenAI
ChatGPT Images 2.5، مع Sketch ونموذجين للصور في API
8 سبتمبر — تطلق OpenAI إصدار ChatGPT Images 2.5 في منتجاتها وفي API. ويُظهر رقم الاستخدام المذكور في البداية حجم الرهان: يُنشأ أكثر من 3 مليارات صورة أسبوعيًا عبر ChatGPT Images ونماذج GPT-Image في API. أما التحسن الأكثر وضوحًا فهو زمن الاستجابة، الذي انخفض بنسبة تصل إلى 50 في المئة مقارنةً بـ Images 2.0، بينما تتركز بقية التحسينات على مطابقة الصور المرجعية والحفاظ على الاتساق طوال المحادثات الطويلة، بحيث تُصان التعديلات السابقة بصورة أفضل.
تصل ثلاث ميزات إلى ChatGPT. تتيح Sketch الرسم مباشرةً داخل المحادثة لتوفير دليل مرئي، عبر كتابة «@Sketch». وتغطي القوالب التنسيقات الشائعة، مثل الملصقات والمنتجات الترويجية. كما يمكن وضع التعليقات على الصورة لتحديد موضع التعديل المطلوب. وأصبح من الممكن الآن تضمين الـ prompt الذي أنتج الصورة عند مشاركتها. يشمل الطرح جميع مستخدمي ChatGPT وChatGPT Work وCodex، على سطح المكتب والأجهزة المحمولة والويب، وفي جميع الباقات.
| النموذج في API | الاستخدام المعلن | زمن الاستجابة |
|---|---|---|
| GPT-Image-2.5 Flare | الخيار الافتراضي، والمحتوى الاجتماعي، والتوليد واسع النطاق | أقل بنسبة تصل إلى 50 في المئة من Images 2.0 |
| GPT-Image-2.5 Sunburst | الدقة، والحملات الجاهزة للنشر | أزمنة توليد أطول |
يدعم النموذجان إعدادَي الجودة الجديدين xhigh وmax، ويعتمدان أسعار tokens الخاصة بـ GPT Image 2، أي ضمن باقة Standard مبلغ 8.00 دولارات لكل مليون token لإدخال الصور، و30.00 دولارًا لإخراج الصور، و5.00 دولارات لإدخال النصوص. ويستمر استخدام بيانات C2PA الوصفية والعلامة المائية غير المرئية، كما تصدر system card بالتزامن مع الإطلاق.
🔗 ChatGPT Images 2.5، من OpenAI
Manus يدمج النموذج في اليوم نفسه
تضيف Manus نموذج GPT-Image-2.5 إلى منصتها مساء يوم الإعلان، مستشهدةً برسالة OpenAI المنشورة قبل ذلك بساعة ونصف. ويطرح مختبر الوكلاء، الذي استعاد استقلاله في 1 سبتمبر، رقمًا مستمدًا من تقييماته الخاصة لا من تقييمات OpenAI: فالنموذج الذي يسميه Flare ينتج صورًا عالية الجودة بسرعة تفوق GPT-Image-2 بما يتراوح بين مرتين وأربع مرات. وبالنسبة إلى وكيل يولد العناصر المرئية أثناء المحادثة، يُعد هذا العامل أهم من تحسن هامشي في الجودة، لأنه يحدد ما إذا كان التوليد سيظل ضمن سير العمل أم سيفرض فترة انتظار. وتبرز Manus أيضًا تحسن توليد الخلفيات الشفافة، ما يلغي خطوة القص اليدوي التي تعيق الأتمتة الكاملة.
AlphaGenome Atlas، الخريطة التنبؤية لـ9 مليارات طفرة في الحمض النووي البشري
8 سبتمبر — تطلق Google DeepMind قاعدة بيانات AlphaGenome Atlas، التي تتنبأ بالتأثير الجزيئي لكل طفرة محتملة تتكون من تغيير حرف واحد في الحمض النووي البشري. يضم الجينوم البشري نحو 3 مليارات زوج قاعدي، لا يشفّر البروتينات منها سوى 2 في المئة؛ أما الـ98 في المئة المتبقية فما تزال غير مستكشفة إلى حد بعيد، رغم أن تغيير حرف واحد فيها قد يعطل منظمًا بيولوجيًا أساسيًا.
تقوم المنهجية على قلب عبء المعالجة. فبدلًا من ترك كل مختبر يستعلم من النموذج عن كل متغير على حدة، حسبت Google DeepMind مسبقًا تنبؤات نموذج AlphaGenome لجميع الاستبدالات الممكنة البالغ عددها 9 مليارات. والنتيجة مجموعة بيانات بحجم 1 بيتابايت، قُدّمت بوصفها أكبر بأكثر من ثلاثين مرة من AlphaFold Database. ولجعل هذا الحجم قابلًا للاستخدام، يقدم Atlas درجة AVI (AlphaGenome Variant Impact)، وهي قيمة واحدة تجمع التنبؤات المتعلقة بالمناطق المشفّرة وغير المشفّرة، وتوضح العمليات البيولوجية التي يعطلها المتغير، مع إسناد التأثيرات بحسب الخاصية. ويضاف إلى ذلك دليل يضم أكثر من 2,500 نمط تسلسلي متكرر، وهي الوحدات التنظيمية التي تصفها Google بأنها «كلمات» الجينوم.
| المقياس | القيمة |
|---|---|
| المتغيرات المحسوبة مسبقًا | 9 مليارات، تشمل جميع تغييرات الحرف الواحد |
| حجم مجموعة البيانات | 1 بيتابايت، أي أكثر من 30 ضعف حجم AlphaFold Database |
| أنماط التسلسل المفهرسة | أكثر من 2,500 |
| مشاركو UK Biobank الذين شملهم التحليل | أكثر من 54,000 |
| الارتباطات الإضافية في المناطق غير المشفّرة | أكثر بنسبة 22 في المئة |
| المناطق الجينية المرتبطة بمؤشر كتلة الجسم | 19 |
يوضح استخدامان موثقان حجم المكاسب. ففي Broad Institute، استخدمت Laura Covill وفريقها درجة AVI لترتيب المتغيرات المرشحة المرتبطة بأمراض نادرة ظلت بلا تشخيص؛ وسلطت الأداة الضوء على متغير في جين DNM1 عبر التنبؤ بأنه ينشئ موقع تضفير غير صحيح، ما وفر العنصر الحاسم لحل الحالة. وفي University of Exeter، طبّق Gareth Hawkes الـAtlas على بيانات أكثر من 54,000 مشارك في UK Biobank، وحصل على زيادة بنسبة 22 في المئة في الارتباطات الجينية ضمن المناطق غير المشفّرة، ثم حدد 19 منطقة جينية مرتبطة بمؤشر كتلة الجسم عبر الاقتصار على الـ1 في المئة من المتغيرات الأشد تأثيرًا.
يمثل الوصول إلى الأداة النقطة البارزة الثانية. يتوفر Atlas عبر بوابة ويب لا تتطلب كتابة تعليمات برمجية، ومخصصة للأطباء وعلماء الأحياء الذين لا يبرمجون، كما يتوفر من خلال AlphaGenome API، وعلى Cloud عبر Model Garden، مع نشر بيانات البحث على GitHub. وثمة تفصيل يهم المطورين المتابعين لمنظومة الوكلاء لدى Google: يُوزّع Atlas أيضًا بصفته مهارة (skill) ضمن Google Antigravity، ما يتيح لوكيل برمجي استخدامه مباشرةً.
🔗 AlphaGenome Atlas، من Google DeepMind
NVIDIA تطلق CUDA Rust، وCosmos تهيمن على AI City Challenge في ECCV
8 سبتمبر — تنشر NVIDIA مشروع CUDA Rust استجابةً لنقص أصبح واضحًا: فطبقة الأنظمة في الذكاء الاصطناعي تُكتب بصورة متزايدة بلغة Rust، لكن kernel الخاص بوحدة GPU ظل استثناءً. كان من الممكن سابقًا تشغيل kernel من Rust، لكن كان لا بد من كتابته في مكان آخر. يسد CUDA Rust هذه الفجوة من خلال تجميع kernels المكتوبة بلغة Rust مباشرةً إلى PTX، عبر مسارين منفصلين يتوافقان مع نموذجي البرمجة اللذين توفرهما CUDA بالفعل في C++ وPython.
| العنصر | cuda-oxide، مسار SIMT | cutile-rs، مسار Tile |
|---|---|---|
| مستوى النضج | إصدار alpha مبكر | منشور على crates.io |
| سلسلة أدوات Rust المطلوبة | إصدار nightly مثبت (nightly-2026-04-03) | الإصدار stable 1.89 أو أحدث |
| إصدار CUDA | 12.x أو أحدث | 13.3 |
| ضرورة توفير LLVM | نعم، إضافةً إلى clang وlibclang | لا |
| التجميع | إلى PTX أثناء البناء | JIT عبر CUDA Tile IR |
| الاستخدامات الخارجية المذكورة | لا يوجد | Grout من Hugging Face، وmistral.rs |
توصية NVIDIA واضحة: البدء بـTile، لأن الشيفرة المصدرية لا تتضمن عندئذٍ أي خيار خاص ببنية معينة، ثم الانتقال إلى SIMT عندما تصبح السيطرة الدقيقة على threads والذاكرة ضرورية. ولهذه المفاضلة تكلفة في الوقت الراهن، إذ لا تزال الذاكرة المشتركة، التي تشكل أساس kernels السريعة، تتطلب unsafe في SIMT. أما الحجة الأساسية فهي ضمان أمان الذاكرة أثناء التجميع: يرفض المساران نمط aliasing التقليدي الذي تُستخدم فيه منطقة تخزين مؤقتة بوصفها دخلًا وخرجًا في الوقت نفسه، وذلك باستخدام error[E0502] في جانب SIMT وerror[E0382] في جانب Tile. وفيما يتعلق بالنضج، لا تبالغ NVIDIA في الوعود: لا يُعد أي من المشروعين جاهزًا للإنتاج، ويمتد الالتزام المعلن إلى عام 2027 وما بعده، مع عمل مشترك مع القائمين على صيانة rust-cuda.
وفي اليوم نفسه، تنشر NVIDIA نتائج AI City Challenge ضمن ECCV 2026. في المسار 5 المخصص للتنبؤ التوليدي بالفيديو لمشاهد حركة المرور، تستخدم أربعة من أفضل خمسة حلول إصدارات من نماذج تأسيس العالم Cosmos. يتصدر فريق Qyn الترتيب العام باستخدام CosmosAlign، الذي يكيّف نموذج Cosmos3-Nano المجمد ذا الـ16 مليار parameter من خلال وصفة LoRA من مرحلتين، ثم يولد أربعة تنبؤات ويختار الـmedoid ويعيد حقن المناطق المستقرة من السجل المرصود: نتيجة 76.39 مقابل 76.04 لفريق SSUPER، أي بفارق 0.35 نقطة. وتحرص NVIDIA على توضيح أن هذه وصفة للتكييف والاستدلال، وليست بنية جديدة. ويظهر Cosmos أيضًا بصفته حكمًا: ففي ترتيبي الأداء خارج النطاق ضمن المسار 3، يفوز فريق UWIPL_ETRI باستخدام UniTraffic، الذي يجعل مدققًا مستقلًا من Cosmos-Reason1 يتحقق من الادعاءات المتنازع عليها.
🔗 CUDA Rust، من NVIDIA · 🔗 نتائج AI City Challenge
Cognition تجمع أكثر من ملياري دولار وتصل قيمتها إلى 48 مليارًا
8 سبتمبر — تعلن Cognition، مطورة وكيل البرمجة Devin، عن جمع أكثر من ملياري دولار بتقييم يبلغ 48 مليار دولار. تقود الجولة جهتان جديدتان هما Andreessen Horowitz وAccel، إلى جانب المستثمرين الحاليين Founders Fund وGeneral Catalyst وAvenir. ويكمل نحو ثلاثين مشاركًا قائمة المستثمرين، من بينهم NVIDIA وBenchmark وBessemer وKleiner Perkins وGreylock وLightspeed وT. Rowe Price وBain Capital Ventures.
| المؤشر | مايو 2026 | سبتمبر 2026 |
|---|---|---|
| المبلغ المجمع، إجمالي الجولة | أكثر من مليار دولار | أكثر من ملياري دولار |
| التقييم | 26 مليار دولار | 48 مليار دولار |
| الإيرادات السنوية المحسوبة | 492 مليون دولار | نحو 900 مليون دولار |
| المستثمرون الرئيسيون | Lux Capital، وGeneral Catalyst، و8VC | Andreessen Horowitz، وAccel |
وهكذا تضاعف التقييم تقريبًا خلال أربعة أشهر، وارتفع إلى نحو خمسة أمثاله خلال عام واحد، مع نمو الإيرادات السنوية المحسوبة بالوتيرة نفسها. وتعرض Cognition الاستخدامات التي تقود هذا النمو: يعمل Devin على تصميم الشرائح لدى NVIDIA، وعلى الطيران لدى GE Aerospace، وعلى الخدمات المالية لدى Citi، وعلى السيارات لدى Mercedes-Benz، وعلى البنية التحتية للذكاء الاصطناعي لدى Modal. ويوضح كون NVIDIA عميلًا ومستثمرًا في الجولة في آن واحد الكيفية التي تضمن بها هذه الشركات الوصول إلى الأدوات التي تستخدمها داخليًا. وتنقل ثلاث قدرات حديثة Devin من تنفيذ المهام إلى العمل الذاتي: Auto-Triage لإجراء الجولة الأولى من التحقيق في الحوادث، وSecurity Swarm لفرز الثغرات، وAutomations التي تُشغّلها أحداث Slack أو GitHub أو Linear. وافتُتحت ستة مكاتب خلال عام واحد، خمسة منها خارج الولايات المتحدة، إلى جانب مراكز San Francisco وNew York وAustin.
In the next chapter of software engineering, agents will become proactive by default, software will improve itself, and compute will automatically get allocated toward the highest impact use cases. We’re still at the dawn of the self-driving software era.
🇸🇦 في الفصل المقبل من هندسة البرمجيات، ستصبح الوكلاء استباقية بصورة افتراضية، وستحسّن البرمجيات نفسها، وستُخصص القدرة الحاسوبية تلقائيًا للاستخدامات ذات الأثر الأكبر. وما زلنا في فجر عصر البرمجيات الذاتية. — @cognition على X
Suno تبرم اتفاقًا مع Believe وTuneCore، اللتين كانتا ترفضان بالأمس توزيع موسيقاها
8 سبتمبر — تعلن Suno عن شراكة استراتيجية عالمية مع Believe، شركة تطوير الفنانين، ومنصتها للتوزيع الذاتي TuneCore. ويتناول الاتفاق أمرين منفصلين. أولًا، تشارك Believe في تصميم النماذج الموسيقية الجديدة التي تطورها Suno بالتعاون مع قطاع الموسيقى. وثانيًا، وهذه هي النقطة العملية للمستخدمين، ستصبح المقطوعات المنشأة باستخدام هذا النموذج المشترك مؤهلة للتوزيع عبر Believe وTuneCore، وبالتالي إلى Spotify وApple Music وAmazon Music وYouTube.
يمنح السياق الإعلان أهميته. تذكّر Suno بصراحة بأن Believe وTuneCore أعلنتا في وقت سابق من هذا العام أنهما لن توزعا الموسيقى المنتجة باستخدام نماذج لا تستوفي معاييرهما، بما في ذلك نماذج Suno آنذاك. ويُعرض هذا التحول بوصفه ثمرة نقاشات كشفت عن قيم مشتركة: منح الفنانين خيارات حقيقية وفتح مسارات للتوزيع وتحقيق الإيرادات.
يندرج الاتفاق ضمن سلسلة متسقة. فهو يمدد برنامج Spark المخصص من Suno للفنانين المستقلين والناشئين، ويكمل الاتفاقات القائمة مع Warner Music Group وBMG عبر إضافة شركات التسجيل المستقلة والفنانين ذوي الإنتاج الذاتي. كما تربطه Suno صراحةً بضوابطها الوقائية الأخيرة: العلامة المائية الصوتية والبصمة الصوتية المصممتان للتعرف على مقطوعاتها خارج المنصة، وحدود التنزيل التي دخلت حيز التنفيذ في 3 سبتمبر لمنع التوزيع واسع النطاق إلى خدمات البث. وستُطبق وسائل الحماية هذه على الموسيقى الموزعة عبر Believe وTuneCore. ويختتم الإعلان بجدول زمني: تعلن Suno أن نماذجها الجديدة ستُطلق قريبًا جدًا، بعدما حملت عائلتها اسم v6 في 4 سبتمبر.
Cohere تفتح مصدر محرّك خدمة (serving) مبني حول megakernel، أسرع بـ1,58x من vLLM
8 سبتمبر — تنشر Cohere محرّكًا لخدمة الاستدلال مبنيًا بالكامل حول megakernel لفك الترميز، بموجب ترخيص Apache 2.0. وتزعم الشركة تحقيق سابقة: ليست مجرد تجربة سرعة مخبرية، بل خادم متكامل قادر على معالجة طلبات حقيقية خلف نقطة وصول متوافقة مع OpenAI، مع معالجة مستمرة على دفعات، وانتباه مُرقّم الصفحات، وذاكرة مؤقتة للبادئات، واستدعاء الأدوات. النموذج المقدَّم هو North Mini Code، وهو مزيج خبراء يضم 30 مليار مُعامِل، لا ينشط منها سوى 3,3 مليارات لكل token.
يمكن تلخيص المشكلة المستهدفة في جملة واحدة: أثناء فك الترميز، يقضي GPU وقتًا طويلًا في الانتظار بدلًا من الحساب. تطلق الحزمة التقليدية نواة (kernel) لكل عملية، وتفرض كل حدود بين النوى حاجزًا على شبكة الحساب بأكملها. غير أن فك الترميز التلقائي الانحدار مقيّد بعرض نطاق الذاكرة: ففي كل خطوة، ينقل North Mini Code مقدار 6,6 Go من الأوزان من ذاكرة HBM، إضافة إلى نحو 0,5 Go من ذاكرة المفتاح والقيمة المؤقتة عند سياق 8K، ما يضع السقف النظري عند نحو 470 token في الثانية باستخدام معدل 3,35 To/s الذي يقدمه H100. يزيل megakernel هذه الحدود عبر تشغيل نواة مستمرة واحدة تبقى مقيمة طوال خطوة فك الترميز، مع اختزال التبعيات إلى عدّادات في الذاكرة العامة.
| المقياس | Megakernel | vLLM v0.24 | التحسّن |
|---|---|---|---|
| فك الترميز، حجم الدفعة 1، سياق 8K (tok/s) | 292 | 185 | 1,58x |
| AIME 2025، من البداية إلى النهاية (tok/s) | 935 | 661 | 1,41x |
| SciCode، من البداية إلى النهاية (tok/s) | 711 | 560 | 1,37x |
| MMLU-Pro، المجموعة الفرعية للحوسبة (tok/s) | 948 | 713 | 1,33x |
| LiveCodeBench v6، من البداية إلى النهاية (tok/s) | 803 | 625 | 1,28x |
| GPQA، من البداية إلى النهاية (tok/s) | 787 | 631 | 1,25x |
تمثّل سرعة 292 token في الثانية عند حجم دفعة 1 نسبة 62 في المئة من السقف النظري، مقابل 39 في المئة لـvLLM. ولا تتغير الجودة: 38,9 في المئة مقابل 38,2 على SciCode، و70,3 في المئة لدى الطرفين على LiveCodeBench v6، بمتوسط سبع عمليات تشغيل. وهناك تفصيل يستحق الانتباه: يتوقف التفوق على توزيع الخبراء، إذ يبلغ 1,32x مع التوجيه الحقيقي للنموذج مقابل 1,14x مع توجيه موحّد مُحاكى، ما يجعل القياسات الموحّدة الحالة الأسوأ. وتشدد Cohere أخيرًا على نقطة غير بديهية: كتابة megakernel أسهل مما توحي به سمعته، مع ملف CUDA واحد تغطي فيه ستة عشر شفرة عملية خطوة فك الترميز بأكملها. أما القيود فهي معلنة وموصوفة بأنها قيود تنفيذية: فك الترميز فقط، إذ لا تزال مرحلة الملء الأولي تعمل بنوى PyTorch عادية، ودعم H100 وBF16 فقط، وأحجام دفعات من 1 إلى 8.
Anthropic توثّق كيفية خفض فاتورة Claude Platform من دون خسارة الأداء
8 سبتمبر — تنشر Anthropic دليلًا هندسيًا يناقض الفكرة الشائعة القائلة إن خفض فاتورة وكيل يعني القبول بنتائج أسوأ. ويوثّق الدليل ثلاث وسائل: تعظيم معدل نجاح ذاكرة prompt المؤقتة، وإزالة الأنماط المضادة في prompt عند الانتقال إلى نموذج حدودي، ومعايرة الجهد وفقًا للمهمة. وتُقدَّم الطريقة في صورة أوامر قابلة للتنفيذ داخل Claude Code، حيث ينضم /claude-api prompt-audit و/claude-api hillclimb إلى /claude-api cost-optimize.
| معيار الاختبار، خط أساس Sonnet 5 | انخفاض التكلفة | التفاصيل المقاسة |
|---|---|---|
| LegalBench | نحو 58 في المئة | tokens الاستدلال من 102 779 إلى 8 284 |
| tau2-bench retail | نحو 73 في المئة | ذاكرة prompt مؤقتة مع نقاط فصل صريحة |
| OfficeQA Pro | نحو 52 في المئة | من 136,20 إلى 64,87 دولار |
| SWE-bench Verified | نحو 55 في المئة | الخطوات الوسيطة من 29 إلى 17، وتقليص tokens الخاصة بـprompt بأكثر من النصف |
لا يظهر الرقم الأكثر قابلية للتطبيق في هذا الجدول. ففي CursorBench 3.2، يعادل Claude Fable 5.1 عند مستوى جهد low أداء Fable 5 عند مستوى جهد high مقابل ثلث التكلفة، ويعود جزء من ذلك إلى تسعير قراءات الذاكرة المؤقتة، الذي أصبح 0,25 دولار لكل مليون token مقابل 1,00 دولار سابقًا. وعلى العكس، في Humanity’s Last Exam من دون أدوات، يشتري مستوى الجهد الأخير نحو نصف نقطة مقابل زيادة في التكلفة قدرها 46 في المئة، وهي مكاسب تضيع وسط ضوضاء benchmark.
🔗 خفض التكاليف على Claude Platform
Claude Code 2.1.265: مجلدات plugins، وحدّ أقصى يبلغ 1 Go، وإصلاح ذاكرة prompt المؤقتة
8 سبتمبر — ينتقل Claude Code إلى الإصدار 2.1.265 مع خمسين بندًا في changelog، منها أربعة وثلاثون إصلاحًا، بعد يومين من الإصدار 2.1.263 الذي لم يتضمن سوى بند واحد. يقبل الخيار --plugin-dir الآن مجلدًا كاملًا من plugins، ويُحمَّل كل مجلد فرعي يحتوي على manifest، مع اكتشاف الإضافات وعمليات الحذف التي تُجرى أثناء التشغيل. ويُطبَّق حد أقصى يبلغ 1 Go على نتائج الأدوات المكتوبة على القرص، مع إشارة المعاينة إلى تعرّض الملف للاقتطاع.
يتعلق الجزء الأكثر كثافة بذاكرة prompt المؤقتة، بالتوازي مع الدليل المنشور في اليوم نفسه. ويصلح تحديثان منفصلان حالات كان فيها Claude Code يعطّل بنفسه إعادة استخدام الذاكرة المؤقتة: فقد كان استئناف وكيل فرعي أُطلق في الواجهة الأمامية يغيّر قائمة أدواته وبادئة prompt النظام، بينما كان زملاء الوكلاء والوكلاء الفرعيون المستأنفون ينقلون سياق hooks الخاصة بـSubagentStart وskills المحمّلة مسبقًا إلى خارج البادئة. ويتعلق إصلاحان بالأمان: كان مسار plugin يحتوي على شرطة مائلة عكسية يتجاوز التحقق من احتواء الروابط الرمزية على macOS وLinux، وكانت أدوات القراءة والكتابة على Windows ترفض أي ملف داخل AppContainer أو بيئة معزولة تستخدم رمزًا مقيّدًا. وتُعامل الآن قراءة artifact كتبه طرف ثالث على أنها محتوى غير موثوق.
Amp يستبدل قائمة انتظار الرسائل بالتوجيه المباشر
8 سبتمبر — يغيّر Amp السلوك الافتراضي لوكيله تجاه الرسائل المرسلة أثناء العمل. فحتى الآن، كانت الرسالة المكتوبة أثناء تشغيل الوكيل توضع في قائمة الانتظار ولا تُعالج إلا بعد انتهاء الدورة؛ أما الآن فتُسلَّم في أول فرصة ممكنة. ويطرح الناشر فائدتين: يأخذ الوكيل الملاحظات في الحسبان في وقت أبكر، ويتوقف عن بدء خطوات تحقق تجعلها التعليمات الجديدة غير ضرورية، ما يوفر الوقت وtokens في الحالة الشائعة التي يُلاحظ فيها أن الوكيل يسير في الاتجاه الخطأ.
لا يخلو التغيير من آثار جانبية، وقد وثّقها Amp. فإذا بدا التوجيه مفاجئًا أكثر من اللازم، ينصح الناشر بصياغة الطلبات على نمط «When done, then…» بدلًا من «Now, …»، للإشارة صراحة إلى أن التعليمات تنطبق بعد المهمة الجارية. وتحتفظ Ship وReview والإجراءات المدمجة الأخرى بالسلوك القديم، وتظل في قائمة الانتظار، إذ يُراد عمومًا إتمام العمل قبل التسليم أو بدء المراجعة. ويظل الإدراج اليدوي في قائمة الانتظار متاحًا، سواء في التطبيق أو في CLI.
🔗 وجّه ولا تضع في قائمة الانتظار، Amp
وصول Muse Spark 1.3 إلى Cursor بأفضل نسبة بين النتيجة والتكلفة في CursorBench
8 سبتمبر — تضيف Cursor نموذج Muse Spark 1.3، النموذج الوكيلي من Meta Superintelligence Labs، بعد ستة أيام من تقديمه. ولا ترسم الأرقام المنشورة صورة عن الأداء الخام، بل عن التكلفة. ففي CursorBench 3.2، معيار الاختبار الداخلي المبني على مهام حقيقية متعددة الملفات، يحقق مستوى Max نسبة 67,9 في المئة مقابل 1,31 دولار لكل مهمة، ويحتل المرتبة الثانية عشرة.
| النموذج والمستوى | نتيجة CursorBench 3.2 | التكلفة لكل مهمة، بالدولار | Tokens لكل مهمة | الترتيب |
|---|---|---|---|---|
| Fable 5.1 Max | 73,4 في المئة | 9,64 | 72 060 | 1 |
| Grok 4.6 Extra High | 70,8 في المئة | 2,81 | 41 136 | 3 |
| Opus 5 Max | 70,0 في المئة | 8,23 | 61 838 | 5 |
| Gemini 3.8 Flash High | 69,2 في المئة | 2,38 | 81 524 | 9 |
| Muse Spark 1.3 Max | 67,9 في المئة | 1,31 | 33 034 | 12 |
| GPT-5.6 Sol Max | 67,2 في المئة | 5,69 | 28 320 | 13 |
| Muse Spark 1.3 Low | 55,0 في المئة | 0,45 | 12 181 | 49 |
وهكذا يأتي نموذج Meta متأخرًا كثيرًا عن Claude Fable 5.1 Max في النتيجة، لكن الأخير يكلّف أكثر من سبعة أضعاف لكل مهمة. والأهم أنه يتقدم على GPT-5.6 Sol في مستوى Max مع تكلفة تقل بأكثر من أربعة أضعاف. وتحافظ Cursor على منهجها القائم على نشر النتيجة والتكلفة لكل مهمة بصورة منهجية لكل نموذج مضاف، بدلًا من الاكتفاء بالإعلان عن إتاحته.
Grok Bot يتيح ملء النماذج وبيانات الاعتماد من الدردشة، وGrok Imagine يكتسب التحكم عبر الإطارات الرئيسية
8 سبتمبر — تتيح SpaceXAI الآن إدخال بيانات النماذج وصفحات تسجيل الدخول إلى Grok Bot من دون مغادرة المحادثة، مع دعم مُعلن لأي مدير كلمات مرور. وتعالج هذه الميزة نقطة احتكاك خاصة بالوكلاء المستمرين: فبمجرد اضطرار الوكيل إلى تجاوز شاشة تسجيل دخول أو إرسال نموذج يحتوي على معلومات شخصية، يحتاج إما إلى بيانات اعتماد مخزّنة وإما إلى تدخل المستخدم. وإعادة هذه الخطوة إلى سلسلة المحادثة بدلًا من جلسة متصفح منفصلة خيار يتعلق بسهولة الاستخدام بقدر ما يتعلق بالأمان.
وبعد ساعتين، اكتسب Grok Imagine التحكم في صورتي بداية المشهد المرئي ونهايته، إلى جانب توليد حلقات سلسة، مع تحسين اتباع التعليمات وجودة فيديو يُعلن أنها أعلى. ويغيّر التحكم عبر الإطارات الرئيسية طبيعة الأداة لمن ينتج لقطات متتابعة: فتثبيت الصورة الأخيرة من لقطة يتيح إعادة استخدامها كالصورة الأولى في اللقطة التالية، ومن ثم ربط تسلسلات لم تعد استمراريتها تعتمد على عشوائية التوليد. ويأتي الإعلان بعد ثلاثة أيام من إطلاق وكيل Grok Imagine Video 1.5 المدعوم بنموذج Image 2.0.
🔗 ملء النماذج في Grok Bot · 🔗 الإطارات الرئيسية في Grok Imagine
ثلاث تدوينات بحثية على مدونة Hugging Face
8 سبتمبر — تستحق ثلاثة منشورات من مجتمع Hugging Face القراءة في اليوم نفسه، وهي تتناول الطقس وأمان النماذج والنماذج المستوحاة من الكائنات الحية.
تشغيل نموذج طقس مفتوح من دون GPU
تنشر Hugging Face وEarthmover تدوينة مشتركة عن مشكلة نادرًا ما تُناقش: نماذج الطقس المعتمدة على التعلّم خفيفة بما يكفي لتعمل على حاسوب محمول، ومع ذلك لا يشغّلها أحد تقريبًا. وقد حُددت ثلاث عقبات: الحوسبة، إذ تعتمد عدة نماذج، منها AIFS، على flash attention المحصور في معماريات معينة لبطاقات الرسوميات؛ والتخزين؛ وعلى وجه الخصوص عرض النطاق، مع نحو 1 Go من الشروط الأولية لكل تنبؤ. وتأتي الإجابة في ثلاثة artifacts عامة: مساحة تجريبية، وحاوية تخزين (bucket)، ودليل تعليمي قابل لإعادة الإنتاج يشغّل Aurora، نموذج Microsoft، في نسخته المدرّبة مسبقًا بدقة 0,25 درجة، مع شروط أولية من ERA5 يوفّرها سوق بيانات Earthmover. ولا يلزم أي GPU: دقيقتان إلى ثلاث دقائق لكل خطوة حسابية على المعالج، وبضع ثوانٍ على بطاقة الرسوميات، وأربع خطوات مدة كل منها ست ساعات لإنتاج تنبؤ لأربع وعشرين ساعة، ثم مقارنته بـERA5.
🔗 نماذج طقس مفتوحة مع Earthmover
نموذج يُفترض أنه أكثر أمانًا يرفض ثلاثة أرباع الأسئلة غير الضارة
تنشر Multiverse Computing نتيجة ينبغي أن تنتشر إلى ما هو أبعد بكثير من أبحاث المواءمة. فمن خلال تدريب Qwen3-8B على رفض طلبات التلاعب السياسي، يحصل الفريق على أرقام تبدو انتصارًا واضحًا: ينخفض متوسط معدل الاستجابة الخطرة على HarmBench وStrongREJECT وWildJailbreak من 26,26 إلى 0,14 في المئة. وعند نقطة الفحص نفسها، يرتفع الرفض المفرط على XSTest من 2,00 إلى 74,00 في المئة. وبعبارة أخرى، فإن الإعداد الأكثر أمانًا على الورق هو آلة للرفض، ولا شيء في القياسات المعتادة يتيح رؤية ذلك. ويحقق إصلاحان النتيجة المطلوبة: استبدال استجابات الامتثال الخارجية باستجابات متحقق منها من النموذج المستهدف يخفض الرفض المفرط على XSTest من 15,20 إلى 5,20 في المئة، وإضافة أزواج حدودية حميدة تخفض الرفض المفرط في الجانب الذي ينبغي تلبيته من 32,94 إلى 4,16 في المئة، بينما لا يتراجع الرفض في الجانب الضار سوى أربع نقاط.
🔗 الأمان لمن؟، Multiverse Computing
الشبكة العصبية لذبابة لا تتفوق على توصيلاتها المخلوطة
تنشر Oruk درسًا منهجيًا تتجاوز أهميته النماذج المستوحاة من الشبكات العصبية للكائنات الحية. فقد نسخ الفريق 499 عصبونًا شديد الترابط من إعادة البناء العامة MaleCNS لذبابة إلى شبكة تكرارية تعمل بوصفها خزانًا، مع طبقة قراءة ridge واحدة مدرّبة فوقها. وتحقق توصيلات الذبابة متوسط دقة اختباريًا قدره 16,84 في المئة، مقابل 16,88 في المئة للتوصيلات المخلوطة: أي فارق سالب قدره 0,04 نقطة، مع فاصل ثقة يعبر الصفر. وكان يمكن اعتبار التجربة الثانية دليلًا على العكس، إذ يؤدي حذف أكثر 50 عصبونًا امتلاكًا لمعايير أوزان قراءة مرتفعة إلى انخفاض الدقة من 16,91 إلى 10,83 في المئة. ويوضح المؤلفون سبب عدم وجود تناقض: فالاستئصال ذو الأثر الكبير لا يثبت أبدًا أن بنية بيولوجية كانت ضرورية. وتجدر الإشارة إلى أن التدوينة نفسها تفيد بأنها أُعدت بواسطة وكيل ذكاء اصطناعي استنادًا إلى ورقة لم تخضع لمراجعة الأقران، كما تظل مجموعة التقييم الكاملة خاصة.
🔗 الشبكة العصبية والتوصيلات المخلوطة، Oruk
Runway توظّف فريق مختبر Kinetix الباريسي
8 سبتمبر — تعلن Runway انضمام فريق Kinetix، وهو مختبر أبحاث في الذكاء الاصطناعي مقره باريس، إليها. وكان المختبر يعمل على الحركة البشرية ثلاثية الأبعاد وعلى توليد الفيديو المرتكز إلى الفيزياء، وهما موضوعان تربطهما Runway مباشرة بأبحاثها حول نماذج العالم المطبقة على الروبوتات. وينضم الفريق إلى مركز الشركة في باريس، الذي يوظف أيضًا باحثين ومهندسين للعمل هناك.
تتلخص الحجة التقنية في جملة من الإعلان: يجب على الروبوت المفيد حقًا أن يفهم البيئات والمهام والمواقف الجديدة ويتعامل معها، ويوفر التدريب المسبق واسع النطاق على الفيديو، وفقًا لـRunway، أكثر السبل فعالية لحل مشكلات التعميم هذه. وهذا امتداد مباشر لـSolaris، الذي قُدّم في 31 أغسطس، وGWM Worlds 2، الذي قُدّم في 3 سبتمبر: فبعد تعليم النماذج محاكاة العالم، تريد Runway تعليمها التصرف فيه. ويعيد Yassine Tahi، المدير العام لـKinetix، الرهان التأسيسي للمختبر إلى ست سنوات مضت. ولم يُعلَن عن أي مبلغ أو هيكل للصفقة.
سارة فريار تكشف بالأرقام حجم OpenAI وتأثير نماذجها في تكاليفها
8 سبتمبر — تنشر سارة فريار مقالًا عن كيفية تحويل OpenAI إنجازاتها البحثية إلى نشاط اقتصادي. وتكمن أهمية النص في ثلاثة أرقام غير مسبوقة، أكثر مما تكمن في حججه.
| المؤشر | القيمة |
|---|---|
| المستخدمون النشطون أسبوعيًا | أكثر من مليار |
| الشركات العميلة | 2.5 مليون |
| الرسائل اليومية بعد ستة أشهر، في الخطط الفردية | أكثر بنحو 50 في المئة مقارنة بالشهر الأول |
| المهام المختلفة المجرّبة بعد ستة أشهر | نحو الضعف |
| تكاليف الخدمة الشاملة بعد التحسين | أقل بنسبة 20 في المئة |
| كفاءة توليد tokens | أكثر من 15 في المئة |
يُكمل الرقم الثالث حلقة مثيرة للاهتمام. فقد استُخدم GPT-5.6 Sol لتحسين برمجيات الخدمة المستخدمة في بيئة الإنتاج لدى OpenAI، ما أدى إلى خفض تكاليف الخدمة بنسبة 20 في المئة، إلى جانب تحقيق زيادة تتجاوز 15 في المئة في كفاءة توليد tokens. بعبارة أخرى، يموّل النموذج جزءًا من بنيته التحتية بنفسه عبر تحسين الطبقة التي تشغّله. كما يجيب مسار الاستخدام الفردي عن سؤال كثيرًا ما يُطرح ونادرًا ما يُوثَّق، وهو مسألة الاحتفاظ بالمستخدمين.
🔗 العمل أصبح الآن في متناول اليد، OpenAI
OpenAI تخصص 5 ملايين دولار للبحث المستقل المتعلق بالمراهقين
8 سبتمبر — تطلق OpenAI برنامج منح بقيمة 5 ملايين دولار مخصصًا للبحث المستقل في آثار الذكاء الاصطناعي التوليدي لدى الفئة العمرية من 13 إلى 17 عامًا، مع تركيز صريح على النمو الاجتماعي والعاطفي. وتصل قيمة المنحة الفردية إلى مليون دولار لكل مشروع. يُغلق باب التقديم في 6 أكتوبر 2026، ويُبلَّغ أصحاب المشاريع المختارة في موعد أقصاه 13 نوفمبر 2026، ويُنتظر تقديم تقرير مرحلي في الربع الأول من عام 2027، فيما تُحدَّد النفقات العامة بحد أقصى قدره 10 في المئة لكل منحة.
يستحق تفصيلان التوقف عندهما. يتعلق الأول بالاستقلالية المُعلنة: فمن بين معايير التقييم قدرة المشروع على إنتاج نتائج موثوقة، سواء كانت مؤيدة لموردي منتجات الذكاء الاصطناعي أم لا، كما يُشجَّع النشر من دون أن يكون شرطًا للحصول على التمويل. أما الثاني فهو إداري، لكنه مهم، إذ تُموَّل المنح وتُدار بواسطة OpenAI Group PBC، الكيان التجاري، وليس بواسطة OpenAI Foundation. كما أن الجدول الزمني ليس محايدًا: فقد دعمت OpenAI في 31 أغسطس مشروع قانون في كاليفورنيا بشأن حماية القاصرين من مخاطر الذكاء الاصطناعي، وتشير التدوينة إلى رغبتها في رفد قرارات الجهات التنظيمية بالمعلومات.
🔗 منح الأبحاث المتعلقة بالمراهقين
أخبار موجزة
- بوريس تشيرني يقيس علنًا أداء المختبرات الأخرى في مواجهة مخاطر حقن prompt — يضع مبتكر Claude Code نموذج OpenAI الجديد في مستوى Gemini Flash وOpus 4.8 فيما يتعلق بحقن prompt، ويؤكد أنه سيواصل تسمية المختبرات علنًا ما دامت لا تتعامل مع الأمن بجدية أكبر. ثم يخفف من حدة لهجته بعد نحو عشرين دقيقة في رد على سلسلته الخاصة. 🔗 المنشور
- Anthropic تنشر مقطع فيديو لمؤسسين يبنون باستخدام Claude Managed Agents — مقابلات مع مؤسسي Wispr Flow وActively وPendo حول استخدام النتائج وبيئة sandbox والذاكرة للتوسع. 🔗 المنشور
- RelayShield يفحص ملفات التعليمات بدلًا من شيفرة المستودعات — خدمة مدفوعة تقرأ AGENTS.md وCLAUDE.md و.cursorrules وmcp.json لرصد التعليمات العدائية المكتوبة بلغة طبيعية، والتي لا يكتشفها التحليل الساكن. ولا يتطابق عدد المستودعات الخبيثة المذكور في التدوينة مع مصدرها نفسه. 🔗 التدوينة
- Ai2 تعلن مشاركتها في ECCV 2026 — أبحاث ومداخلات موزعة على امتداد المؤتمر، من دون الإعلان عن عناوين أو برنامج. 🔗 المنشور
- Prismberry تنشر مقالًا عن طبقة الأدوات في وكلاء المؤسسات — نص لتحديد الموقف يميّز بين أدوات المعلومات والتحليل والتنفيذ، من دون إعلان أو قياس، ويروّج لمنتج Agent IQ التابع لناشره. 🔗 التدوينة
- سجل صيانة للمعدات منشور على مدونة Hugging Face — تشخيص لتآكل محمل في مروحة مزوّد طاقة بقدرة 650 W، من دون محتوى متعلق بالذكاء الاصطناعي. 🔗 التدوينة
- ميزوري تتيح Gemini for Education لنحو 1.1 مليون تلميذ وطالب — شراكة على مستوى الولاية تمنح قرابة 100,000 معلم وأكثر من 1.1 مليون تلميذ وطالب وصولًا مجانيًا إلى Gemini for Education وGemini Notebook وشهادات Google، مع استبعاد البيانات من التدريب وترك قرار التبني لكل مؤسسة تعليمية. 🔗 الإعلان
- Dependabot يقرأ سجلات GitHub الخاصة من دون رمز شخصي — يستطيع
GITHUB_TOKENالخاص بـ Dependabot طلب الصلاحيةpackages: readوالسحب من سجلات GitHub Packages الخاصة. وتعود الميزة، التي أُطلقت ثم أُلغيت في يونيو، مع اقتصار بيانات الاعتماد التلقائية على دور الخيار الاحتياطي. 🔗 سجل التغييرات - انتقال بوابة دعم GitHub إلى help.github.com — جُمعت خدمات الدعم والتوثيق والتعلم والمجتمع وموارد الحساب في مكان واحد، مع بحث مدعوم من Copilot لا يتطلب تسجيل الدخول. 🔗 سجل التغييرات
- Genspark تفتتح Spark House خلال SF Tech Week مع وصول مبكر إلى GenTeam — فعالية مجتمعية تمنح المشاركين وصولًا مبكرًا إلى GenTeam وإلى محادثات خاصة بين المؤسسين والمستثمرين. 🔗 المنشور
- إيثان تاندوفسكي يصبح المدير المالي لـ ElevenLabs — ثاني تعيين قيادي خلال ستة أيام لدى ElevenLabs، بعد تعيين آشلي كرامر مديرةً للإيرادات في 2 سبتمبر. 🔗 المنشور
- MiniMax تجمع في طوكيو أصواتًا يابانية من قطاع الترفيه وأربع جهات فاعلة في الذكاء الاصطناعي التوليدي — فعالية تُقام في 11 سبتمبر في شيبويا بمشاركة المنتج ياسوشي أكيموتو وKADOKAWA وKAGAMIAI وHiggsfield وKrea وRunway وHeyGen، من دون إطلاق منتج أو إعلان أرقام. 🔗 المنشور
- بثّان من Nemotron Labs في اليوم نفسه، أحدهما عن OpenShell والآخر عن Domyn — 49 دقيقة و44 ثانية عن تأمين الوكلاء المستقلين باستخدام OpenShell، و54 دقيقة و20 ثانية عن استخدام Domyn لـ Nemotron، من دون نص وصفي أو تفريغ مكتوب. 🔗 المنشور
- HeyGen تقارن بين صورتين رمزيتين للوجه نفسه من دون تسمية أداة أو نموذج — مقارنة تسويقية من دون تسمية أداة منافسة أو ذكر نموذج أو تقديم قياس. 🔗 المنشور
- OpenAI توسّع برنامجها للصحافة ليشمل كليات الصحافة — أكثر من 400 اشتراك في ChatGPT Edu لطلاب الماجستير وأعضاء هيئة التدريس في Newmark J-School التابعة لـ CUNY وMedill School التابعة لـ Northwestern، للعام الدراسي 2026-2027. 🔗 الإعلان
- Perplexity تنشر دليلًا عن العائد على الاستثمار من دمج الذكاء الاصطناعي — تدوينة تعليمية بلا إعلان عن منتج، وجميع أرقامها مأخوذة من أطراف خارجية أو شهادات عملاء. 🔗 التدوينة
ما الذي يعنيه ذلك
يتحول الوكيل الشخصي إلى منتج بنية تحتية، ويتحول أمنه إلى منتج قائم بذاته. لا تكتفي Meta بإطلاق Muse، بل تنشر في اليوم نفسه الوصف الأكثر تفصيلًا حتى الآن لكيفية احتواء وكيل يملك وصولًا إلى shell ومتصفح وصندوق بريد إلكتروني. والخيار الأكثر دلالة هو استخدام رموز بديلة، ما يجعل حقن prompt عديم الجدوى في سرقة بيانات الاعتماد، ليس لأن النموذج أصبح أكثر مقاومة، بل لأنه لم يحصل على السر أصلًا. ويندرج tainted egress ضمن المنطق نفسه: لا تُمنح الثقة للنموذج، بل تُزوَّد النواة بآليات المراقبة. وتقول مكافأة اكتشاف الثغرات البالغة 300,000 دولار، وصراحة الخلاصة التي تقر بأن Muse سيرتكب أخطاء، الشيء نفسه الذي يقوله بوريس تشيرني عندما يقيّم علنًا المختبرات الأخرى بشأن هذا الخطر. لم يعد أمن الوكلاء خانة ينبغي التأشير عليها، بل أصبح مجالًا هندسيًا تُنشر تفاصيله وتُدفع الأموال لمحاولة اختراقه.
ويقدم هذا اليوم أيضًا درسًا في اقتصاد الذكاء الاصطناعي، حيث لم تعد وحدة الحساب هي النتيجة، بل التكلفة لكل مهمة. تجمع Mistral تمويلًا بقيمة 3 مليارات يورو بتقييم يتجاوز 21 مليارًا، وتجمع Cognition أكثر من ملياري يورو بتقييم يبلغ 48 مليارًا، وفي الحالتين يشارك الصناعيون والعملاء في الصفقة بدلًا من اقتصارها على صناديق التكنولوجيا. وفي الوقت نفسه، تنشر Cursor جدولًا يحقق فيه Muse Spark 1.3 نسبة 67.9 في المئة بتكلفة 1.31 دولار لكل مهمة، بينما يدفع متصدر الترتيب 9.64 دولارات مقابل ست نقاط إضافية، وتوثق Anthropic انخفاضات في التكلفة تتراوح بين 52 و73 في المئة من دون خسارة في الأداء، موضحة أن نموذجًا أقوى بمستوى جهد أقل يتغلب غالبًا على نموذج أضعف يُدفع إلى أقصى طاقته. وتضع سارة فريار أرقامًا للطرف الآخر من السلسلة، مع خفض تكاليف الخدمة بنسبة 20 في المئة بفضل استخدام GPT-5.6 Sol لتحسين الطبقة التي تشغّله. هذه أربع طرق للقول إن المفاضلة انتقلت من القدرة إلى سعر تلك القدرة.
أما في المجال العلمي، فلم يعد السؤال ما إذا كانت الوكلاء تنتج نتائج، بل كيف يمكن التحقق منها. تعلن OpenAI عن برهان للتفرد في معادلات Navier-Stokes أنتجه نحو 10,000 وكيل خلال 88 ساعة، وصيغ رسميًا باستخدام Lean، من دون ذكر مراجعة الأقران أو تحقق مؤسسي، وباستخدام نموذج داخلي لا يستطيع أي شخص من الخارج الاستعلام منه. ويُعد حذر الشركة، التي تتنازل عن جائزة الألفية وتتحدث عن لقطة آنية، معلومة بحد ذاته. ويكشف العملان الآخران المنشوران اليوم حجم التباين: ففي MIT، يلتزم Codex بالبروتوكولات المحددة جيدًا لكنه يتعثر أمام الإشارات الملتبسة، ويظل الباحث الخبير أسرع؛ أما لدى Google DeepMind، فلا يدّعي AlphaGenome Atlas إثبات أي شيء، بل يحسب مسبقًا 9 مليارات تنبؤ وينقل الجهد إلى التحقق التجريبي. وتستكمل تدوينة Oruk البرهان بإظهار أن استئصالًا مذهلًا لا يثبت شيئًا من دون مقارنة متطابقة، بينما تذكّر تدوينة Multiverse Computing بأن رقمًا أمنيًا لا يعني شيئًا ما لم يُقَس الجانب الحميد بالصرامة نفسها.
تبقى الطبقة الدنيا، حيث لم تعد المكاسب تأتي من الأوزان. تفتح Cohere محرك خدمة متكاملًا، والتغيير الوحيد فيه هو إزالة الحدود بين kernels، ليحقق معدل نقل يبلغ 1.58x مقارنة بـ vLLM مع جودة مماثلة، وتحرص على القول إن صعوبة كتابة megakernel مبالغ فيها. وتفتح NVIDIA مسارين لكتابة kernels لوحدات GPU بلغة Rust، أحدهما مستخدم بالفعل خارج الشركة في محرك الاستدلال Grout التابع لـ Hugging Face وفي mistral.rs، مع إقرارها بأن لا شيء جاهز لبيئة الإنتاج. وفي AI City Challenge، تعتمد أربعة من أفضل خمسة حلول للفيديو على نماذج Cosmos المكيّفة باستخدام LoRA، فيما يشدد الفريق الفائز على أن الأمر يتعلق بوصفة تكييف لا بمعمارية جديدة. ويروي البرنامج التعليمي للطقس من Earthmover القصة نفسها من الطرف الآخر: يعمل نموذج Aurora على معالج، ولم تكن القدرة الحاسوبية هي العائق، بل تنزيل غيغابايت من الشروط الابتدائية. وفي كل مرة، تكمن القيمة في الهندسة المحيطة بالنموذج، وهي تُنشر للعلن.
المصادر
- إطلاق Muse، Meta
- أمن الوكلاء وسلامتهم باستخدام Muse، Meta
- جولة التمويل من السلسلة D لـ Mistral
- إعلان جولة السلسلة D على X
- حل مسألة Navier-Stokes، OpenAI
- سلسلة OpenAI عن النموذج الداخلي
- Codex وتجارب الحوسبة الكمومية في MIT
- ChatGPT Images 2.5، OpenAI
- Manus يدمج GPT-Image-2.5
- AlphaGenome Atlas، Google DeepMind
- CUDA Rust، NVIDIA
- AI City Challenge ضمن ECCV 2026، NVIDIA
- جولة التمويل من السلسلة E لـ Cognition
- سلسلة Cognition على X
- شراكة Suno وBelieve وTuneCore
- Megakernel لفك الترميز، Cohere
- خفض التكاليف على Claude Platform، Anthropic
- Claude Code 2.1.265
- التحكم المباشر في الوكيل، Amp
- Muse Spark 1.3 في Cursor
- ملء النماذج في Grok Bot
- الإطارات الرئيسية والحلقات في Grok Imagine
- نماذج طقس مفتوحة مع Earthmover، Hugging Face
- الأمن لمن، Multiverse Computing
- شبكة الوصلات العصبية للذبابة والأسلاك المختلطة، Oruk
- Kinetix تنضم إلى Runway
- مقال سارة فريار، OpenAI
- منح الأبحاث المتعلقة بالمراهقين، OpenAI
- بوريس تشيرني عن مخاطر حقن prompt
- مؤسسون يبنون باستخدام Claude Managed Agents
- RelayShield وملفات التعليمات
- Ai2 في ECCV 2026
- طبقة أدوات الوكلاء، Prismberry
- سجل صيانة المعدات
- Gemini for Education في ميزوري
- Dependabot وسجلات GitHub الخاصة
- بوابة دعم GitHub الجديدة
- Spark House خلال SF Tech Week، Genspark
- إيثان تاندوفسكي، المدير المالي لـ ElevenLabs
- فعالية MiniMax في طوكيو
- عمليات بث Nemotron Labs
- مقارنة الصور الرمزية من HeyGen
- برنامج OpenAI للصحافة
- دليل العائد على الاستثمار في الذكاء الاصطناعي، Perplexity