ai-powered-markdown-translatorgpt-5.6-solでフランス語から日本語に翻訳された記事。
Metaは、各ユーザーにクラウド上の専用Linuxマシンを提供するパーソナルエージェントMuseを発表し、同日、そのセキュリティアーキテクチャも公開した。誰でも参加でき、報奨金が最大30万ドルに達するバグ報奨金制度も設ける。Mistralは30億ユーロのシリーズDを発表した。これは欧州のテクノロジー企業が完了した株式資金調達として史上最大となる。一方、OpenAIはエージェントシステムが生成したNavier-Stokes方程式の有限時間特異点形成の証明を公開し、Google DeepMindはヒトDNAで起こり得る90億通りの変異の影響を事前計算した。
MetaがパーソナルエージェントMuseを発表し、セキュリティアーキテクチャを公開
9月8日 — Metaは、iOSおよびAndroidアプリ、ウェブインターフェース、WhatsAppで利用できる、Muse Spark 1.3搭載のパーソナルエージェントMuseを発表した。モデル自体は新しくない。9月2日にMuse CodeとMeta Model APIへ導入され、9月4日には最高レベルの推論モードが一般公開されている。新しいのは、そのモデルを中心に構築された一般消費者向け製品だ。
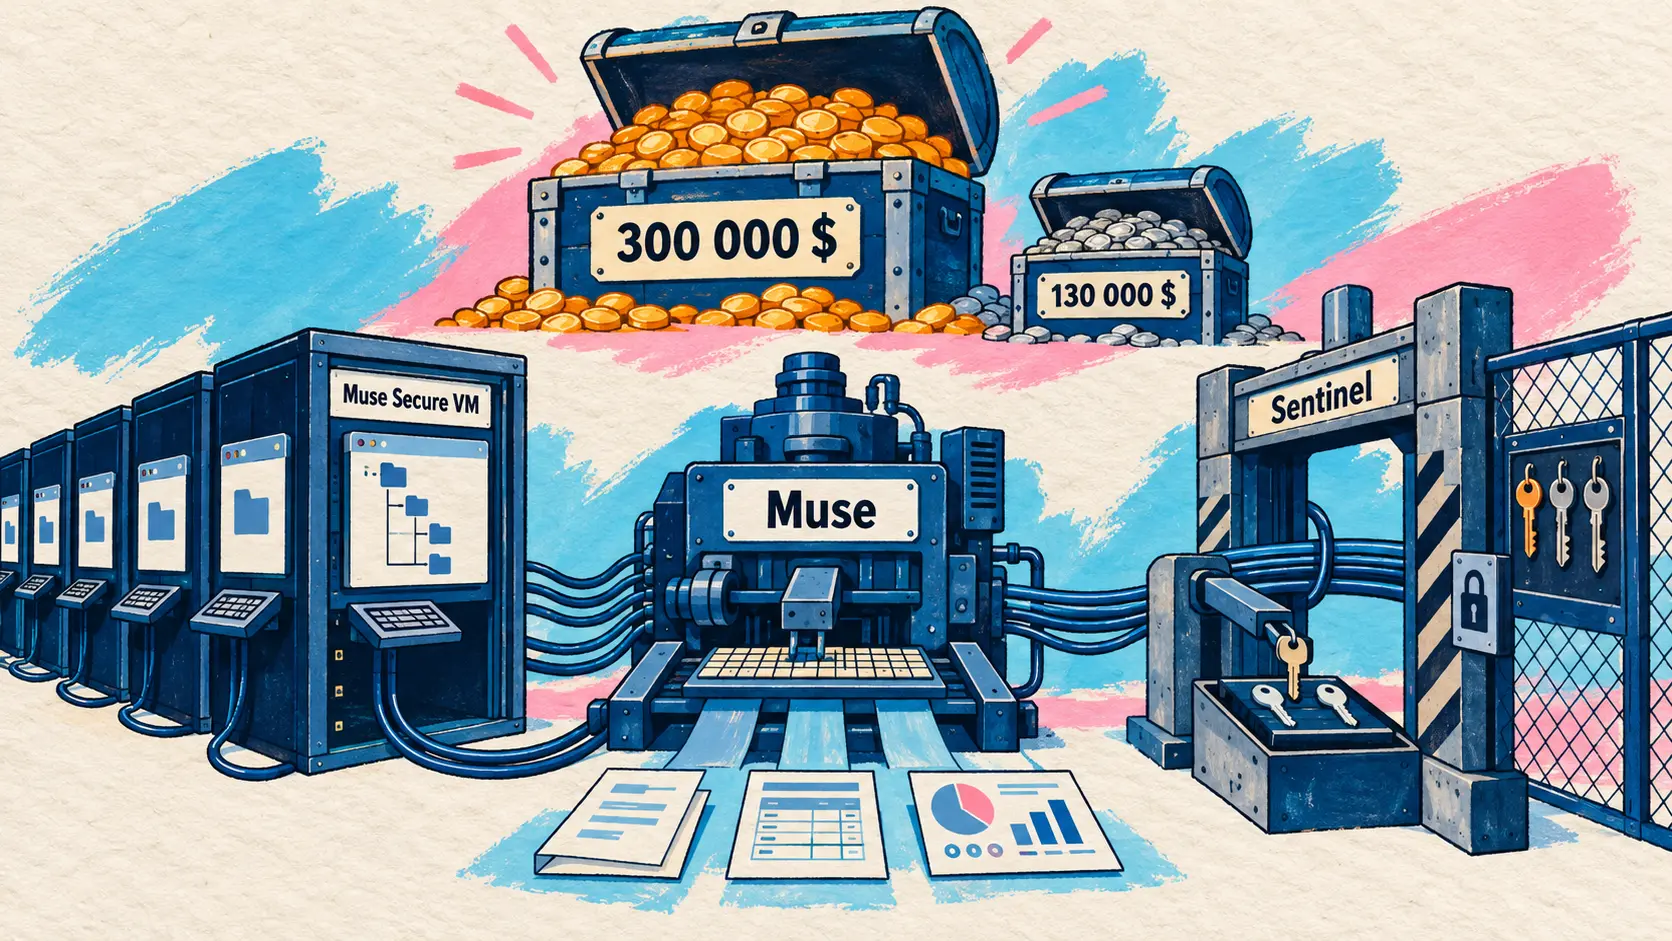
このアーキテクチャは、説明は簡単でも実装は困難な発想に基づいている。各ユーザーにクラウド上の専用コンピューターを割り当てるというものだ。Muse Secure VMは、ファイルシステム、ターミナル、完全なブラウザーを備えた永続的かつ隔離されたLinuxマシンであり、コードのコンパイル、カスタムスキルの開発、複数のサブエージェントの並列実行に十分なストレージ、プロセッサー、メモリーを備える。接続サービスのデータと認証情報について信頼できる唯一の情報源となるのは、Metaの中央集約型インフラではなく、このマシンだ。タスクに必要なツールがなければ、エージェントが自ら作成する。また、単なるテキストの塊ではなく、旅程、PDF、ウェブページ、ダッシュボードなど、MetaがArtifactsと呼ぶ操作可能なオブジェクトを生成する。
第2の大きな転換として掲げられているのは、アプリを閉じていても、エージェントがスケジュールやイベントへの反応に基づいてバックグラウンドで作業し、その結果を通知する価値があるかどうかを自ら判断する点だ。メモリーは永続化され、ユーザーが閲覧・編集できる。さらに「目標」タブでは、エージェントが追跡している内容を一覧できる。一方で、Metaが明らかにしていないこともある。価格は一切公表されておらず、提供国の一覧も発表されていない。
製品発表から20分後、Metaは、Meta Superintelligence Labsのソフトウェアエンジニア兼副社長であるTarek Sheasha名義で、この仕組みのセキュリティに関する技術文書を公開した。基本原則は冒頭から明確だ。システムは、エージェントが攻撃されることを前提として設計されている。コード内でHatchと呼ばれるエージェントハーネスはsystemd-nspawnコンテナー内で動作し、そのrootはホスト上の非特権ユーザーにマッピングされ、システムコールはフィルタリングされ、カーネル権限も取り除かれている。エージェントを侵害した攻撃者が無効化できないよう、4つのサービスが意図的にコンテナー外へ配置されている。セキュリティ分類器、権限を分離したワーカー、認証情報保存デーモン、そしてSentinelだ。
Sentinelは中核となる構成要素だ。コネクター操作またはネットワークへの送信を許可できる唯一の権限主体として、各リクエストをレイヤー4とレイヤー7で評価し、実際に名前解決されたアドレスを検証する。とりわけ重要なのは、エージェントが扱うのは代替トークンだけであり、ネットワーク境界で実際の認証情報に置き換えられる点だ。エージェントは最初から秘密情報を持っていないため、プロンプトインジェクションでそれを吐き出させる攻撃は意味を失う。さらに、カーネルレベルのフロー追跡であるtainted egressも加わる。ユーザーデータを読み取ったすべてのプロセスに印が付けられ、自動承認を失う仕組みだ。この実装では、cgroupsに接続されたeBPFプログラムと、Metaが追加したLinux Security Moduleのフックを組み合わせている。
| アーキテクチャの要素 | 採用された方式 |
|---|---|
| エージェントハーネスのコンテナー | systemd-nspawn、rootを非特権ユーザーにマッピング |
| 承認権限 | コンテナー外のSentinel、レイヤー4および7 |
| エージェントが参照する認証情報 | 代替トークンのみ |
| メールコネクター | ワンタイムコードとリセット用リンクをフィルタリング |
| ブラウザーサブエージェント | 生のDOMではなくアクセシビリティツリーを使用し、ページ内でJavaScriptを不使用 |
| 決済 | 発表時はStripe Link、その後Shop Pay、使い捨てカード |
| バグ報奨金、有効な報告1件当たりの上限 | 30万ドル |
| バグ報奨金、プロンプトインジェクション | 最大13万ドル |
この文書には2つの発表が付随している。バグ報奨金制度は発表と同時にすべての人へ開放され、実証された影響に応じて、有効な報告1件につき最大30万ドルが支払われる。このうち、ユーザー1人に影響を与えるプロンプトインジェクションの成功には最大13万ドルが設定されている。また、年末までの提供を予定するMuse Confidential VMは、Metaが仮想マシン内のデータへアクセスできないことを、暗号学的かつ検証可能な形で保証することを目指している。その設計とソースコードはすでに外部監査機関へ提出されている。文書の結論は企業による発表としては異例なほど率直だ。プロンプトインジェクションは依然として業界全体の未解決問題であり、Museも間違いを犯すという。
🔗 Museの発表 · 🔗 エージェントのセキュリティと安全性、Meta
Mistralが30億ユーロを調達、欧州テクノロジー業界で史上最大の株式資金調達
9月8日 — Mistralは30億ユーロのシリーズDを、210億ユーロ超のポストマネー評価額で実施すると発表した。同社はこのラウンドを、創業からわずか3年で欧州のテクノロジー企業が完了した史上最大の株式資金調達だとしている。
Samsung Electronicsがこの取引を主導する。EQTが運用するScaleup Europe Fundと、既存株主のPSG Equityが共同主導する。さらに、Advent、BlackRockが運用するファンドおよび口座、ルクセンブルク大公国の3者が新たに出資者へ加わる。既存の出資者は長い一覧となり、a16z、Salesforce Ventures、ASML、BNP Paribas CIB、Bpifrance、DST Global、General Catalyst、Index Ventures、Korelya Capital、Lightspeed、NVIDIAなど、3大陸にまたがっている。
注目すべき点は、連続する2回のラウンドを主導した企業の性格だ。シリーズCはASMLが、シリーズDはSamsung Electronicsが主導した。いずれも総合テクノロジーファンドではなく、先端製造業の企業だ。Mistralはこれを、データとインフラの管理が導入を左右する複雑な産業環境の内部へ、最先端モデルを展開する能力に対する信頼の表れだと捉えている。
| 指標 | 値 |
|---|---|
| 調達額 | 30億ユーロ |
| ポストマネー評価額 | 210億ユーロ超 |
| 創業からの年数 | 3年 |
| 主幹事 | Samsung Electronics |
| 共同主幹事 | EQT運用のScaleup Europe Fund、PSG Equity |
| 事業展開国 | 20 |
| 大口法人顧客 | Airbus、ASML、HSBCを含む125社超 |
資金の用途として、同社はまずフロンティア研究を挙げ、続いてトレーニング用計算能力の増強、インフラの拡張、国際市場での商業展開の加速を挙げている。その主張は夏以降に掲げてきた方針を踏襲している。組織に突きつけられている問いは、もはや誰が最も強力なモデルを構築するかではなく、自社インフラの支配権を手放さずにAIをどう活用するかだという。Mistralは、オープンウェイトモデルから計算能力、製品に至るまで、必要なスタック全体を構築する業界唯一の企業だと自らを位置づけている。
Today marks a major step for Mistral: we’re announcing a €3B Series D, the largest equity round ever raised by a European tech company, just three years after launch.
🇯🇵 本日はMistralにとって大きな節目となります。創業からわずか3年で、欧州のテクノロジー企業による株式資金調達として史上最大となる、30億ユーロのシリーズDを発表します。 — @MistralAIのXへの投稿
OpenAIの科学エージェント:Navier-Stokes方程式の証明とMITでの量子ビット較正
9月8日 — OpenAIは、3次元Navier-Stokes方程式における有限時間での特異点形成の証明を、証明支援系Leanによる形式化とともに公開した。発表された結果によれば、初期状態が滑らかで静止している3次元流体に滑らかな外力を加えると、粘性が運動を平滑化し、系のエネルギーが有限に保たれていても、速度が有限時間内に際限なく増大し得る。Clay Mathematics Instituteの正式な定式化では、これは「C」と「D」の命題に相当し、正則性の証明ではなく反証を構成する。
OpenAIが何を主張し、何を主張していないかは、正確に整理する必要がある。この証明は、公開名称のない社内モデルを基盤とする協調エージェントシステムによって生成された。同社によれば、このモデルはGPT-6 Astraより大幅に高性能で、8月28日からトレーニングが継続されている。説明されている唯一の検証は、GPT-6 Astraに任されたLeanでの形式化であり、問題解決から17時間後に完了した。発表では、査読もClay Mathematics Instituteによる検証も行われたとは述べられていない。またOpenAIは、ミレニアム懸賞問題の賞金を申請する意向はないとし、この成果を最終到達点ではなく、ある時点での進捗として提示している。
手法は、少なくとも結果そのものと同じくらい注目に値する。この取り組みは、2つのミレニアム懸賞問題が解決されたという噂を受け、9月1日に始まった。別々のエージェント群に命題の異なる変種が割り当てられ、「A」と「B」は証明へ、「C」と「D」は反証へ向けられた。関連問題である外力のないEuler方程式の正則性については、約100のエージェントが約50時間で反証を生成した。この結果は、Navier-Stokes方程式に取り組むエージェントのプロンプトへ再投入された。
| 指標 | 値 |
|---|---|
| Navier-Stokesグループの同時稼働エージェント数 | 約10 000 |
| 解決までの時間 | 約88時間 |
| Leanによる形式化と検証 | GPT-6 Astraを使用し、さらに17時間 |
| Navier-Stokesで交換されたメッセージ数 | 270万 |
| Navier-Stokesの出力トークン数 | 約1 300億 |
| 試行した全問題で交換されたメッセージ数 | 490万 |
| 試行した全問題の出力トークン数 | 約3 000億 |
| 外力のないEuler方程式の正則性に対する反証 | 約100エージェント、約50時間 |
並行して進められていた研究が、状況を複雑にしている。Anthropicの従業員Levent Alpögeと、NYUの数学教授Tristan Buckmasterは、外力を加えたEuler方程式について成果を得ていた。OpenAIは自社プロジェクトの完了と検証後の9月6日に両者へ連絡し、共同発表と先行研究としての承認を提案したが、その後、両者の成果が自社とは異なる命題を扱っていたことが判明した。
This model represents a step-function improvement on many benchmarks, and its training is ongoing. Our internal model group arrived at the Navier–Stokes solution in 88 hours, using around 10,000 coordinating AI agents. Throughout the effort, we maintained the strict safeguards—including monitoring and isolation—that we apply to all our frontier evaluations.
🇯🇵 このモデルは多くのベンチマークで段階的な大幅改善を示しており、現在もトレーニングが続いています。当社の社内モデル群は、約10 000のAIエージェントを連携させ、88時間でNavier-Stokes方程式の解決に到達しました。この取り組み全体を通じて、監視や隔離を含め、すべてのフロンティアモデル評価に適用している厳格な安全対策を維持しました。 — @OpenAIのXへの投稿
同日、OpenAIは、はるかに控えめではあるが、はるかに検証しやすい事例研究も公開した。MITのEngineering Quantum Systemsグループに所属する博士課程学生Beatriz Yankelevichは、GPT-5.6 Sol搭載のCodexを実験調整ソフトウェアへ接続し、未較正の6量子ビット超伝導チップを較正した。エージェントには測定の種類ごとに固有のskillsが与えられ、測定の実施方法と評価方法が記述されていた。明瞭な信号に対してCodexは、遷移周波数の特定、制御・読み出しパルスの較正、量子情報の保持時間の測定という一連の工程を、ほとんど人手を介さずに完了した。信号が弱い場合やノイズが多い場合には、実用的なパラメーターを見つけるまでにより長い時間を要し、モデルよりも迅速に判断できる経験豊富な研究者の目が必要になることもある。したがって、利点は速度ではなく、常時監督が不要になることだ。この種の標準チップの特性評価には研究者が数日を費やすため、同グループでは現在、定型的な測定をエージェントへ任せている。
🔗 Navier-Stokes方程式の解決、OpenAI · 🔗 Codexと量子実験、OpenAI
ChatGPT Images 2.5、SketchとAPIの2つの画像モデル
9月8日 — OpenAIは、各製品およびAPIでChatGPT Images 2.5を公開した。冒頭で示された利用規模が、その重要性を物語っている。ChatGPT ImagesとAPIのGPT-Imageモデルでは、毎週30億枚を超える画像が作成されている。最も具体的な改善点はレイテンシーで、Images 2.0と比べて最大50パーセント短縮された。そのほか、参照写真への忠実度や、過去の変更がより適切に維持される長い会話での一貫性も向上している。
ChatGPTには3つの機能が追加される。Sketchでは、「@Sketch」と入力することで、視覚的なガイドとして会話内に直接絵を描ける。テンプレートは、ポスターやマーチャンダイジングなどの一般的な形式を網羅する。画像上にコメントを配置して、修正箇所を指定できる。画像を共有する際、その生成に使われたプロンプトも含められるようになった。展開対象は、デスクトップ、モバイル、ウェブの全料金プランにわたる、すべてのChatGPT、ChatGPT Work、Codexユーザーである。
| APIのモデル | 発表された位置付け | レイテンシー |
|---|---|---|
| GPT-Image-2.5 Flare | デフォルトの選択肢、ソーシャル向けコンテンツ、大量生成 | Images 2.0より最大50パーセント短縮 |
| GPT-Image-2.5 Sunburst | 高精度、配信可能なキャンペーン | 生成時間はより長い |
両モデルは、新しい品質設定xhighとmaxに対応し、GPT Image 2のトークン料金を引き継ぐ。Standardプランでは、画像入力100万トークン当たり8.00ドル、画像出力は30.00ドル、テキスト入力は5.00ドルとなる。C2PAメタデータと不可視の電子透かしは維持され、system cardも公開されている。
Manusも同日にモデルを統合
Manusは発表当日の夜、その1時間半前に公開されたOpenAIのメッセージを引用し、GPT-Image-2.5を自社プラットフォームに追加した。9月1日に再び独立したエージェント研究所は、OpenAIではなく自社評価に基づく数値を示している。同社がFlareと呼ぶモデルは、GPT-Image-2の2倍から4倍の速度で高品質な画像を生成するという。会話の進行に沿ってビジュアルを生成するエージェントにとって、この倍率はわずかな品質向上よりも重要だ。生成が作業フロー内に収まるか、待ち時間が発生するかを左右するためである。Manusは透明な背景の生成機能が改善された点も強調しており、完全な自動化を妨げる手作業での切り抜き工程を省けるとしている。
AlphaGenome Atlas、ヒトDNAの90億変異を予測する地図
9月8日 — Google DeepMindは、ヒトDNAで起こり得る一塩基変異それぞれの分子レベルでの影響を予測するデータベース、AlphaGenome Atlasを公開した。ヒトゲノムは約30億塩基対で構成されるが、タンパク質をコードするのはわずか2パーセントにすぎない。残りの98パーセントは、たった一文字の変化でも不可欠な生物学的調節因子を無効にし得るにもかかわらず、いまだほとんど解明されていない。
その手法は、計算負荷の向きを逆転させるものだ。各研究所が変異を一つずつモデルに問い合わせる代わりに、Google DeepMindは、考え得る90億通りすべての塩基置換についてAlphaGenomeモデルの予測を事前計算した。その結果、AlphaFold Databaseの30倍を超える規模とされる、1ペタバイトのデータセットが生まれた。この膨大なデータを活用できるようにするため、AtlasはAVIスコア(AlphaGenome Variant Impact)を導入している。これはコード領域と非コード領域に対する予測を単一の数値に集約し、変異がどの生物学的プロセスを阻害するかを特徴別の寄与度とともに示す。さらに、Googleがゲノムの「単語」と表現する調節単位である、2,500種類を超える反復配列モチーフのカタログも加わっている。
| 指標 | 値 |
|---|---|
| 事前計算された変異 | 90億通り、すべての一塩基変化 |
| データセットの規模 | 1ペタバイト、AlphaFold Databaseの30倍超 |
| カタログ化された配列モチーフ | 2,500種類超 |
| 解析されたUK Biobank参加者 | 54,000人超 |
| 追加で見つかった非コード領域の関連 | 22パーセント増 |
| BMIに関連すると特定された遺伝領域 | 19 |
文書化された2つの利用例が、その効果の大きさを示している。Broad Instituteでは、Laura Covillとそのチームが、診断未確定の希少疾患について候補変異の優先順位付けにAVIスコアを使用した。このツールは、不適切なスプライス部位を作り出すと予測してDNM1遺伝子の変異を有力候補として提示し、症例の解明に決定的な手掛かりをもたらした。University of Exeterでは、Gareth HawkesがUK Biobankの54,000人を超える参加者のデータにAtlasを適用し、非コード領域における遺伝的関連を22パーセント多く発見した。さらに、影響が最も大きい上位1パーセントの変異に絞ることで、ボディマス指数に関連する19の遺伝領域を特定した。
アクセス方法も注目すべき点である。Atlasは、コードを書かない臨床医や生物学者向けのウェブポータルから利用できるほか、AlphaGenome API、Cloud上のModel Gardenでも提供され、研究データはGitHubで公開されている。Googleのエージェント・エコシステムを追う開発者にとって興味深い点として、AtlasはGoogle Antigravity内のスキル(skill)としても配布され、コーディングエージェントから直接利用できる。
🔗 AlphaGenome Atlas、Google DeepMind
NVIDIAがCUDA Rustを公開、CosmosがECCVのAI City Challengeを席巻
9月8日 — NVIDIAはCUDA Rustを公開し、顕在化していた不足を埋めた。AIのシステム層はますますRustで書かれるようになっている一方、GPU kernelだけは例外だった。Rustからkernelを起動することは以前から可能だったが、kernel自体は別の言語で書く必要があった。CUDA Rustは、Rust kernelをPTXへネイティブにコンパイルすることでこの隔たりを解消する。CUDAがすでにC++とPythonで提供している2つのプログラミングモデルに合わせ、異なる2つの方式が用意されている。
| 要素 | cuda-oxide、SIMT方式 | cutile-rs、Tile方式 |
|---|---|---|
| 成熟度 | 初期alpha | crates.ioで公開済み |
| 必要なRustツールチェーン | 固定されたnightly(nightly-2026-04-03) | stable 1.89以上 |
| CUDAバージョン | 12.x以上 | 13.3 |
| 別途必要なLLVM | 必要、clangとlibclangも必要 | 不要 |
| コンパイル | ビルド時にPTXへ | CUDA Tile IR経由のJIT |
| 言及された外部利用例 | なし | Hugging FaceのGrout、mistral.rs |
NVIDIAの推奨は明確だ。ソースコードにアーキテクチャ固有の選択を一切組み込まずに済むため、まずTileから始め、スレッドとメモリの細かな制御が必要になったらSIMTへ移るというものだ。現時点では、この選択には代償が伴う。SIMTでは、高速なkernelの基盤となる共有メモリを扱うために、依然としてunsafeが必要だからだ。根本的な利点は、コンパイル時のメモリ安全性にある。両方式とも、1つのバッファを入力と出力の両方に使う典型的なエイリアシングを拒否し、SIMT側ではerror[E0502]、Tile側ではerror[E0382]を使用する。成熟度についてNVIDIAは誇張していない。どちらのプロジェクトも本番利用の準備は整っておらず、発表された取り組みは2027年以降を見据え、rust-cudaのメンテナーと共同で進められる。
同日、NVIDIAはECCV 2026 AI City Challengeの結果も発表した。交通場面の生成動画予測を扱うトラック5では、上位5つのソリューションのうち4つがCosmosワールド基盤モデルの各バージョンを使用している。QynチームはCosmosAlignで公開ランキングの首位に立った。この手法は、160億パラメータの固定済みCosmos3-Nanoモデルを2段階のLoRA方式で適応させ、4つの予測を生成してメドイドを選び、観測履歴の安定領域を再注入する。スコアは76.39で、SSUPERチームの76.04を0.35ポイント上回った。NVIDIAは、これが新しいアーキテクチャではなく、適応と推論の手法であることを明記している。Cosmosは審判役としても登場する。トラック3の2つのドメイン外ランキングでは、UWIPL_ETRIチームがUniTrafficで優勝し、議論の余地がある主張を独立したCosmos-Reason1検証器に確認させている。
🔗 CUDA Rust、NVIDIA · 🔗 AI City Challengeの結果
Cognitionが20億ドル超を調達、評価額は480億ドルに
9月8日 — 開発エージェントDevinを提供するCognitionは、評価額480億ドルで20億ドルを超える資金を調達したと発表した。このラウンドは、新規投資家のAndreessen HorowitzとAccelが主導し、既存投資家のFounders Fund、General Catalyst、Avenirも参加した。さらにNVIDIA、Benchmark、Bessemer、Kleiner Perkins、Greylock、Lightspeed、T. Rowe Price、Bain Capital Venturesを含む約30の投資家が加わっている。
| 指標 | 2026年5月 | 2026年9月 |
|---|---|---|
| 累計調達額 | 10億ドル超 | 20億ドル超 |
| 評価額 | 260億ドル | 480億ドル |
| 年換算売上高 | 4億9,200万ドル | 約9億ドル |
| 主幹投資家 | Lux Capital、General Catalyst、8VC | Andreessen Horowitz、Accel |
評価額は4か月でほぼ倍増し、1年間では約5倍となり、年換算売上高も同様の勢いで伸びている。Cognitionは、この成長を支える用途を詳しく説明している。Devinは、NVIDIAではチップ設計、GE Aerospaceでは航空、Citiでは金融サービス、Mercedes-Benzでは自動車、ModalではAIインフラに携わっている。NVIDIAが顧客であると同時に今回の投資家でもあることは、こうした企業が社内で利用するツールへのアクセスを確保する手法をよく示している。最近追加された3つの機能により、Devinはタスクの実行から自律的な行動へと進化している。インシデント調査の初動を担うAuto-Triage、脆弱性を選別するSecurity Swarm、Slack、GitHub、Linearのイベントを契機に動作するAutomationsである。1年間で6つの拠点を開設し、そのうち5つは米国外に置かれ、San Francisco、New York、Austinの拠点に加わった。
In the next chapter of software engineering, agents will become proactive by default, software will improve itself, and compute will automatically get allocated toward the highest impact use cases. We’re still at the dawn of the self-driving software era.
🇯🇵 ソフトウェアエンジニアリングの次章では、エージェントは標準で能動的に動き、ソフトウェアは自らを改善し、計算資源は最も影響の大きい用途へ自動的に割り当てられるようになります。自律型ソフトウェアの時代は、まだ夜明けを迎えたばかりです。 — @cognitionのXへの投稿
Suno、前日まで楽曲配信を拒んでいたBelieveおよびTuneCoreと提携
9月8日 — Sunoは、アーティスト育成企業Believeおよび同社のセルフ配信プラットフォームTuneCoreとの世界規模の戦略的提携を発表した。この契約は、異なる2つの事項を対象とする。まず、BelieveがSunoと音楽業界が共同開発する新しい音楽モデルの設計に加わる。次に、ユーザーにとって具体的な点として、この新しい提携モデルで作成された楽曲は、BelieveとTuneCoreを通じてSpotify、Apple Music、Amazon Music、YouTubeへ配信できるようになる。
この発表の意義は、その背景によっていっそう明確になる。Sunoは、BelieveとTuneCoreが今年初め、当時のSunoのモデルを含め、自社の基準を満たさないモデルで制作された音楽は配信しないと発表していた事実を率直に振り返っている。この方針転換は、アーティストに真の選択肢を与え、配信と収益化への道を開くという共通の価値観が話し合いを通じて明らかになった結果だと説明されている。
この契約は、一貫した取り組みの流れに位置付けられる。インディペンデントおよび新進アーティスト向けのSunoのプログラムSparkを発展させるとともに、Warner Music GroupおよびBMGとの既存契約を、インディペンデントレーベルや自主制作アーティストにまで拡張するものだ。Sunoはまた、この契約を最近導入した安全対策とも明確に結び付けている。プラットフォーム外で同社の楽曲を識別するための音声透かしと音響フィンガープリント、そしてストリーミングサービスへの大量配信を防ぐため9月3日に発効したダウンロード制限である。これらの保護策は、BelieveとTuneCoreを通じて配信される音楽にも適用される。発表の最後には今後の日程も示され、Sunoは9月4日にv6と命名していた新モデル群を近日中に公開するとしている。
Cohere、megakernelを中心に構築したvLLMより1.58倍高速なサービングエンジンを公開
9月8日 — Cohereは、デコード用megakernelを全面的に採用した推論サービングエンジンをApache 2.0ライセンスで公開した。同社が初の成果として掲げるのは、実験室での速度実証ではなく、継続的バッチ処理、ページ化attention、prefix cache、ツール呼び出しを備え、OpenAI互換エンドポイントの背後で実際のリクエストを処理できる完全なサーバーだ。提供されるモデルはNorth Mini Codeで、300億パラメータのMixture of Expertsであり、tokenごとに有効になるのは33億パラメータだけだ。
取り組む問題は一言で表せる。デコード中、GPUは計算よりも待機に多くの時間を費やしている。従来のスタックでは操作ごとにkernelを起動し、kernelの各境界が計算グリッド全体にバリアを課す。しかしautoregressive decodingはメモリ帯域幅に制約される。各ステップでNorth Mini CodeはHBMメモリから6.6 GBの重みを転送し、さらに8Kコンテキストでは約0.5 GBのkey-value cacheも転送するため、H100の3.35 TB/sという帯域幅では理論上の上限が毎秒約470 tokenとなる。megakernelは、デコードステップ全体にわたって常駐する単一のpersistent kernelを起動し、依存関係をglobal memory上のcounterにまで減らすことで、こうした境界を取り除く。
| 測定項目 | Megakernel | vLLM v0.24 | 向上率 |
|---|---|---|---|
| デコード、バッチサイズ1、8Kコンテキスト(tok/s) | 292 | 185 | 1.58x |
| AIME 2025、エンドツーエンド(tok/s) | 935 | 661 | 1.41x |
| SciCode、エンドツーエンド(tok/s) | 711 | 560 | 1.37x |
| MMLU-Pro、コンピューター科学サブセット(tok/s) | 948 | 713 | 1.33x |
| LiveCodeBench v6、エンドツーエンド(tok/s) | 803 | 625 | 1.28x |
| GPQA、エンドツーエンド(tok/s) | 787 | 631 | 1.25x |
バッチサイズ1で毎秒292 tokenという結果は理論上限の62パーセントに相当し、vLLMは39パーセントだった。品質に変化はない。SciCodeでは38.9パーセント対38.2パーセント、LiveCodeBench v6では双方とも70.3パーセントで、いずれも7回の実行の平均値だ。注目すべき点として、優位性はexpertの分布に左右される。モデル本来のroutingでは1.32xであるのに対し、シミュレーションした一様routingでは1.14xとなり、一様な測定が不利なケースに当たる。最後にCohereは、直感に反する点を強調している。megakernelの作成は評判ほど難しくなく、単一のCUDAファイル内で16個のopcodeがデコードステップ全体を網羅するという。制限については実装上の制限として明示されている。対象はデコードのみで、prefillは依然として通常のPyTorch kernelで実行され、対応するのはH100とBF16のみ、バッチサイズは1から8までだ。
Anthropic、性能を落とさずClaude Platformの費用を削減する方法を解説
9月8日 — Anthropicは、agentの費用削減は結果の悪化を受け入れることだという通念に異を唱えるエンジニアリングガイドを公開した。そこでは、prompt cacheのヒット率を最大化すること、frontier modelへの移行時にpromptのanti-patternを取り除くこと、タスクに応じてeffortを調整することという3つの手段が解説されている。この手法はClaude Codeで実行可能なコマンドとして提供され、/claude-api prompt-auditと/claude-api hillclimbが/claude-api cost-optimizeに加わる。
| ベンチマーク、Sonnet 5ベースライン | コスト削減率 | 測定内容 |
|---|---|---|
| LegalBench | 約58パーセント | reasoning tokenが102 779から8 284へ |
| tau2-bench retail | 約73パーセント | 明示的なbreakpointを備えたprompt cache |
| OfficeQA Pro | 約52パーセント | 136.20ドルから64.87ドルへ |
| SWE-bench Verified | 約55パーセント | stepの中央値が29から17へ、prompt tokenは半分未満に |
最も実用的な数値はこの表には載っていない。CursorBench 3.2では、effort lowのClaude Fable 5.1がeffort highのFable 5と同等の成績を3分の1の費用で達成している。その一因はcache readの料金で、従来の100万token当たり1.00ドルから0.25ドルに引き下げられた。逆に、ツールを使わないHumanity’s Last Examでは、最後のeffort段階によって費用が46パーセント増える一方、得られる向上は約0.5ポイントにすぎず、benchmarkのノイズに埋もれる程度だ。
Claude Code 2.1.265:pluginフォルダー、1 GBの上限、prompt cacheの修復
9月8日 — Claude Codeは2.1.265に更新され、changelogには50件の項目が掲載された。そのうち34件が修正で、項目がわずか1件だった2.1.263の2日後のリリースとなる。--plugin-dirオプションではpluginフォルダー全体を指定できるようになり、manifestを備えた各サブフォルダーが読み込まれ、実行中に行われた追加や削除も検出される。ディスクに書き込まれるツール結果には1 GBの上限が適用され、ファイルが切り詰められた場合はプレビューに表示される。
最も内容が多いのはprompt cacheに関する部分で、同日に公開されたガイドとも呼応している。2つの別個の修正により、Claude Code自体がcacheの再利用を壊していたケースが解消された。foregroundで起動したsub-agentを再開すると、そのツール一覧とsystem promptのprefixが変化していた。また、agent teammateと再開されたsub-agentでは、SubagentStart hookのcontextと事前読み込みされたskillがprefixの外へ移動していた。セキュリティ関連の修正は2件ある。backslashを含むplugin pathによってmacOSとLinuxでsymbolic linkの封じ込め検証を回避できた問題と、WindowsでreadおよびwriteツールがAppContainerまたは制限付きtoken sandbox内のあらゆるファイルを拒否していた問題だ。第三者が書き込んだartifactの読み取りは、今後は信頼できないコンテンツとして扱われる。
Amp、メッセージキューをリアルタイムの指示操作に置き換え
9月8日 — Ampは、作業中に送信されたメッセージに対するagentのデフォルト動作を変更した。これまではagentの実行中に入力されたメッセージはキューに入り、turnが終了するまで処理されなかったが、今後は可能な最初のタイミングで届けられる。開発元は2つの利点を挙げている。agentがfeedbackをより早く考慮できることと、新しい指示によって不要になった検証stepへの着手をやめられることだ。agentが誤った方向へ進んでいると気づく一般的な場面で、時間とtokenを節約できる。
この変更には副作用もあり、Ampはそれも説明している。指示操作が急すぎる場合は、指示が現在のタスクの後に適用されることを明示するため、「Now, …」ではなく「When done, then…」という形で依頼するよう勧めている。Ship、Review、その他の組み込みactionは従来の動作を維持し、引き続きキューに入る。通常、成果物の提出やレビュー開始の前には作業が完了していることが望ましいためだ。手動でのキュー投入も、アプリケーションとCLIの両方で引き続き利用できる。
Muse Spark 1.3がCursorに登場、CursorBenchで最高のスコア対コスト比
9月8日 — Cursorは、Meta Superintelligence Labsのagentic modelであるMuse Spark 1.3を、発表から6日後に追加した。公開された数値が示すのは、純粋な性能ではなくコストの強みだ。実際の複数ファイルタスクから構築された社内benchmarkのCursorBench 3.2では、Max段階が1タスク当たり1.31ドルで67.9パーセントを獲得し、12位となった。
| モデルと段階 | CursorBench 3.2スコア | タスク当たりのコスト(ドル) | タスク当たりのtoken | 順位 |
|---|---|---|---|---|
| Fable 5.1 Max | 73.4パーセント | 9.64 | 72 060 | 1 |
| Grok 4.6 Extra High | 70.8パーセント | 2.81 | 41 136 | 3 |
| Opus 5 Max | 70.0パーセント | 8.23 | 61 838 | 5 |
| Gemini 3.8 Flash High | 69.2パーセント | 2.38 | 81 524 | 9 |
| Muse Spark 1.3 Max | 67.9パーセント | 1.31 | 33 034 | 12 |
| GPT-5.6 Sol Max | 67.2パーセント | 5.69 | 28 320 | 13 |
| Muse Spark 1.3 Low | 55.0パーセント | 0.45 | 12 181 | 49 |
このためMetaのモデルはスコアではClaude Fable 5.1 Maxに大きく後れを取るが、後者はタスク当たりのコストが7倍を超える。とりわけMax段階ではGPT-5.6 Solを上回りながら、コストは4分の1未満だ。Cursorは、単に利用可能になったと知らせるのではなく、追加した各モデルについてスコアとタスク当たりのコストを一貫して公開する方針を維持している。
Grok Bot、チャットからフォームと認証情報を入力可能に、Grok Imagineはkeyframe制御に対応
9月8日 — SpaceXAIは、Grok Botで会話を離れることなくフォームやlogin pageへ入力できるようにし、あらゆるpassword managerに対応すると発表した。この機能はpersistent agent特有の問題点に応えるものだ。agentがlogin screenを通過したり、個人情報を含むフォームを送信したりする必要が生じるたびに、保存済みの認証情報かユーザーの介入が必要になる。このstepを別のbrowser sessionではなく会話thread内に表示することは、利便性だけでなくセキュリティ上の選択でもある。
その2時間後、Grok Imagineは動画シーンの開始画像と終了画像の制御、さらに継ぎ目のないloop生成に対応し、指示追従性の向上と動画品質の改善も発表された。keyframeによる制御は、連続するshotを制作する際のツールの性質を変える。あるshotの最後の画像を固定すれば、それを次のshotの最初の画像として再利用できるため、生成時の偶然に連続性を委ねずにsequenceをつなげられる。この発表は、Image 2.0モデルを搭載したGrok Imagine Video 1.5 agentの提供開始から3日後に行われた。
🔗 Grok Botでのフォーム入力 · 🔗 Grok Imagineのkeyframe
Hugging Faceブログの3本の研究記事
9月8日 — 同日公開されたHugging Faceコミュニティの記事のうち、気象、モデルの安全性、生物に着想を得たモデルを扱う3本は一読に値する。
GPUなしでオープンな気象モデルを動かす
Hugging FaceとEarthmoverは、ほとんど扱われてこなかった問題について共同記事を公開した。機械学習による気象モデルはノートパソコンで動かせるほど軽量なのに、実際に動かす人はほとんどいないという問題だ。障害として、計算、ストレージ、そして特に帯域幅の3つが挙げられている。計算面では、AIFSを含む複数のモデルが特定のGPUアーキテクチャに限られるflash attentionに依存する。帯域幅については、予報1回当たり約1 GBの初期条件が必要だ。解決策は、公開された3つのartifactで構成される。デモ用space、ストレージbucket、そしてMicrosoftのモデルAuroraを0.25度の事前学習済みversionで動かす再現可能なtutorialだ。初期条件にはEarthmoverのdata marketplaceから提供されるERA5を使用する。GPUは不要で、計算step当たりCPUでは2〜3分、GPUでは数秒かかる。6時間刻みのstepを4回実行して24時間予報を作成し、その後ERA5と比較する。
より安全とされるモデルが無害な質問の4分の3を拒否
Multiverse Computingは、alignment研究の枠を超えて広く知られるべき結果を公開した。Qwen3-8Bに政治的操作の依頼を拒否するよう学習させたところ、一見すると明確な成功に見える数値が得られた。HarmBench、StrongREJECT、WildJailbreakにおける危険な回答の平均率は26.26パーセントから0.14パーセントに低下した。しかし同じcheckpointで、XSTestにおけるover-refusalは2.00パーセントから74.00パーセントへ上昇した。つまり、数値上最も安全な設定は拒否を乱発する仕組みであり、通常の測定ではそれを把握できない。2つの修正が効果を上げた。外部のcompliance responseをtarget model自身の検証済み回答に置き換えると、XSTestのover-refusalは15.20パーセントから5.20パーセントへ低下した。また、無害なboundary pairを追加すると、応答すべき側のover-refusalは32.94パーセントから4.16パーセントに低下し、有害な側の拒否率はわずか4ポイントしか下がらなかった。
🔗 誰のための安全性か、Multiverse Computing
ハエのconnectomeは配線をシャッフルしたものに勝てない
Orukは、connectomeに着想を得たモデル以外にも通用する方法論上の教訓を公開した。チームは、ハエの公開再構成データMaleCNSから結合の強い499個のneuronを、reservoirとして機能するrecurrent networkに複製し、その上に単一のridge readoutだけを学習させた。ハエの配線はテストで平均16.84パーセントの精度を記録し、シャッフルした配線は16.88パーセントだった。差はマイナス0.04ポイントで、信頼区間はゼロをまたいでいる。2番目の実験は反証のように見えたかもしれない。readout weightのnormが最大の50個のneuronを取り除くと、精度が16.91パーセントから10.83パーセントへ低下したためだ。著者らは、これが矛盾しない理由を説明している。劇的なablationが、生物学的topologyの必要性を証明することはない。なお、記事自体に、査読前の論文を基にAI agentが作成したと記載されており、完全な評価datasetは非公開のままだ。
Runway、パリの研究所Kinetixのチームを採用
9月8日 — Runwayは、パリを拠点とするAI研究所Kinetixのチームが同社に加わると発表した。同研究所は、人間の3D motionと物理に基づく動画生成に取り組んでいた。Runwayはこの2つのテーマを、roboticsに応用するworld modelの研究へ直接結び付けている。チームは同社のパリ拠点に加わり、同拠点では研究職とengineering職の採用も進められている。
技術的な主張は、発表内の一文に集約されている。真に有用なrobotは、未知の環境、タスク、状況を理解して対処する必要があり、Runwayによれば大規模な動画事前学習が、こうしたgeneralizationの問題を解決する最も効率的な道となる。これは8月31日に発表されたSolarisと、9月3日に発表されたGWM Worlds 2の直接的な延長線上にある。世界をシミュレートする方法をモデルに学ばせた次は、その中で行動する方法を学ばせようとしている。Kinetixの最高経営責任者Yassine Tahiは、同研究所の創設時の賭けが6年前に始まったと述べている。金額や取引形態は公表されていない。
Sarah Friar、OpenAIの規模とモデルがコストに与える効果を数値化
9月8日 — Sarah Friarは、OpenAIが研究上の進歩をどのように経済活動へ転換しているかについて寄稿した。この文章の注目点は、その論旨よりも初公開された3つの数値にある。
| 指標 | 値 |
|---|---|
| 週間アクティブユーザー | 10億人超 |
| 顧客企業 | 250万社 |
| 個人向けプランにおける6か月後の1日当たりメッセージ数 | 初月より約50パーセント増 |
| 6か月後に試された異なるタスク | 約2倍 |
| 最適化後のエンドツーエンドのサービスコスト | 20パーセント減 |
| token生成効率 | 15パーセント超の向上 |
3つ目の数値は、興味深い循環を完成させている。GPT-5.6 SolはOpenAIの本番サービスソフトウェアの改善に使われ、その結果、サービスコストが20パーセント削減され、さらにtoken生成効率も15パーセント以上向上した。言い換えれば、このモデルは自らを提供する層を最適化することで、自身のインフラの一部を賄っている。また、個人利用の推移は、頻繁に問われながら資料がほとんどなかった継続利用率の問題にも答えている。
OpenAI、青少年に関する独立研究へ500万ドルを拠出
9月8日 — OpenAIは、13~17歳に対する生成AIの影響を対象とし、社会的・情緒的発達を明確な重点分野とする500万ドル規模の独立研究助成プログラムを開始した。個別の助成額は1プロジェクト当たり最大100万ドル。応募は2026年10月6日に締め切られ、採択プロジェクトには遅くとも2026年11月13日までに通知される。2027年第1四半期には中間報告が求められ、間接経費は助成金ごとに10パーセントを上限とする。
注目すべき点が2つある。1つ目は、掲げられた独立性に関するものだ。評価基準には、AI製品提供企業にとって好ましいかどうかにかかわらず、信頼できる結果を生み出すプロジェクトの能力が含まれ、公開は推奨されるものの、資金提供の条件ではない。2つ目は事務的だが重要で、助成金の資金提供と運営を担うのはOpenAI Foundationではなく、営利事業体のOpenAI Group PBCである。この日程にも意味がある。OpenAIは8月31日、AIから未成年者を守るカリフォルニア州法案への支持を表明しており、この投稿では規制当局の意思決定に情報を提供したいとしている。
🔗 青少年研究助成金
短報
- Boris Cherny、prompt injectionリスクをめぐり他の研究所を公に評価 — Claude Codeの開発者は、OpenAIの新モデルをprompt injectionの面でGemini FlashおよびOpus 4.8と同水準に位置づけ、各研究所がセキュリティをより真剣に受け止めるまでは公に名指しすると明言した。その約20分後、自身のスレッドへの返信で語調を和らげている。🔗 投稿
- Anthropic、Claude Managed Agents上で開発する創業者たちの動画を公開 — Wispr Flow、Actively、Pendoの創業者へのインタビューで、成果、sandbox、memoryを活用して規模を拡大する方法を取り上げている。🔗 投稿
- RelayShield、リポジトリのコードではなく指示ファイルをスキャン — AGENTS.md、CLAUDE.md、.cursorrules、mcp.jsonを読み取り、静的解析では検出できない自然言語による悪意ある指示を見つける有料サービス。投稿で引用されている悪意あるリポジトリ数は、その出典自体と一致していない。🔗 記事
- Ai2、ECCV 2026への参加を発表 — 論文と講演が会期中に予定されているが、題名やプログラムは公表されていない。🔗 投稿
- Prismberry、企業向けagentのtool層に関する論考を公開 — 情報、分析、実行のtoolを区別する見解表明で、発表や測定結果はなく、発行元の製品Agent IQを宣伝している。🔗 記事
- Hugging Faceブログにハードウェア保守記録を掲載 — 650 W電源装置のファンにおけるベアリング摩耗の診断で、人工知能に関する内容はない。🔗 記事
- Missouri州、110万人の児童・生徒・学生にGemini for Educationを開放 — 州全体の提携により、約10万人の教員と110万人を超える児童・生徒・学生へGemini for Education、Gemini Notebook、Google認定資格を無償提供する。データは学習対象から除外され、導入するかどうかは各教育機関の判断に委ねられる。🔗 発表
- Dependabot、personal tokenなしでGitHubのprivate registryを読み取り可能に — Dependabotの
GITHUB_TOKENはpackages: read権限を要求し、GitHub Packagesのprivate registryから取得できる。この機能は6月に公開後いったん撤回されていたが、自動認証情報を予備手段に限定して再導入された。🔗 変更履歴 - GitHubのsupport portalがhelp.github.comへ移転 — support、documentation、learning、community、account resourcesを一か所に集約し、ログイン不要でCopilotを利用した検索を提供する。🔗 変更履歴
- Genspark、SF Tech Week期間中にSpark Houseを開設し、GenTeamへの先行アクセスを提供 — 参加者にGenTeamへの先行アクセスと、創業者と投資家による非公開対話の機会を提供するcommunity企画。🔗 投稿
- Ethan Tandowsky、ElevenLabsの最高財務責任者に就任 — 9月2日にAshley Kramerが最高収益責任者へ就任したのに続き、ElevenLabsでは6日間で2人目の経営幹部任命となる。🔗 投稿
- MiniMax、東京で日本のエンターテインメント界の声と生成AI企業4社を集結 — 9月11日に渋谷で開かれるイベントで、プロデューサーの秋元康、KADOKAWA、KAGAMIAI、Higgsfield、Krea、Runway、HeyGenが参加するが、製品公開や数値発表はない。🔗 投稿
- Nemotron Labs、同日にOpenShellとDomynに関する2本を配信 — OpenShellによる自律型agentの保護について49分44秒、DomynによるNemotronの利用について54分20秒の配信で、説明文や文字起こしはない。🔗 投稿
- HeyGen、同じ顔の2つのavatarを比較するもtoolやmodelを明示せず — 競合tool名、model名、測定結果のいずれも示さないmarketing比較。🔗 投稿
- OpenAI、journalism programをjournalism schoolへ拡大 — CUNYのNewmark J-SchoolとNorthwesternのMedill Schoolの修士課程学生および教員向けに、2026~2027年度のChatGPT Edu subscriptionを400件以上提供する。🔗 発表
- Perplexity、AI導入の投資収益率に関するguideを公開 — 製品発表を伴わない解説記事で、すべての数値は第三者または顧客の証言に由来する。🔗 記事
これが意味すること
personal agentはインフラ製品となり、そのセキュリティも独立した製品になりつつある。MetaはMuseを提供するだけではない。同じ日に、shell、browser、mailboxへのアクセス権を持つagentを封じ込める方法について、これまでで最も詳細な説明を公開した。最も示唆に富む選択はsubstitution tokenであり、modelの耐性が高いからではなく、そもそも秘密情報を持たないため、認証情報の窃取を狙うprompt injectionを無意味にする。tainted egressも同じ論理に基づく。modelを信頼するのではなく、kernelを計測・制御する。30万ドルのbug bountyと、Museが誤りを犯すことを認める率直な結論は、Boris Chernyがこのリスクについて他の研究所を公に評価した際と同じことを示している。agent securityはもはや確認項目ではなく、公開され、破らせるために報奨金が支払われるengineering領域である。
この日はAI経済学の教訓にもなっており、評価単位はもはやscoreではなく、task当たりのcostである。Mistralは210億ユーロ超の評価額で30億ユーロ、Cognitionは480億ドルの評価額で20億ドル超を調達した。いずれも、technology fundだけでなく、産業企業や顧客が出資者に名を連ねている。同じ頃、Cursorは、Muse Spark 1.3がtask当たり1.31ドルで67.9パーセントを記録する一方、首位modelはわずか6ポイント上回るために9.64ドルを費やすという一覧を公開した。Anthropicは、performanceを損なわずにcostを52~73パーセント削減できることを資料化し、effortを低く設定した強力なmodelが、最大限まで稼働させた弱いmodelをしばしば上回ることを示した。Sarah Friarはchainのもう一端を数値化し、GPT-5.6 Solに自身を提供する層を最適化させることで、service costを20パーセント削減したと説明している。これらはすべて、判断軸が能力そのものから、その能力の価格へ移ったことを異なる形で示している。
科学の現場では、agentが成果を生み出すかどうかではなく、それをどう検証するかが問題になっている。OpenAIは、約10,000のagentが88時間で生成し、Leanで形式化したNavier-Stokesの特異点の証明を発表したが、peer reviewやinstitutional validationへの言及はなく、外部の誰も照会できないinternal modelを使用している。Millennium Prizeへの応募を見送り、結果をsnapshotと表現する同社の慎重さ自体が情報である。この日のほかの2件の研究は、その対照を鮮明にする。MITでは、Codexは明確に定義されたprotocolをこなす一方、曖昧なsignalには行き詰まり、経験豊富な研究者のほうが依然として速い。Google DeepMindのAlphaGenome Atlasは何かを証明したとは主張せず、90億件のpredictionを事前計算し、作業の重点をexperimental validationへ移している。Orukの記事は、対照を揃えた比較がなければ劇的なablationも何も証明しないと示し、この論証を締めくくる。Multiverse Computingの記事も、安全性の数値はbenign側を同じ厳密さで測定しない限り意味を持たないと念を押している。
最後に残るのは、改善がもはやweightから生まれない低層部分だ。Cohereは、kernel境界を取り除くことだけを変更した完全なserving engineを公開し、同一品質でvLLMの1.58倍のthroughputを実現した。また、megakernelの実装難易度は過大評価されていると明言している。NVIDIAはRustでGPU kernelを書くための2つの道筋を公開した。そのうち1つはすでに社外で、Hugging Faceの推論engineであるGroutやmistral.rsに使用されているが、いずれもproduction readyではないと認めている。AI City Challengeでは、上位5つのvideo solutionのうち4つがLoRAで適応させたCosmos modelを基盤としており、優勝teamは新しいarchitectureではなく適応手法であることを強調した。Earthmoverのweather tutorialも反対側から同じことを物語っている。Aurora modelはCPU上で動作し、障害となっていたのはcomputeではなく、downloadすべき1 GBのinitial conditionだった。いずれの場合も、価値はmodelを取り巻くengineeringにあり、それが公開されている。
出典
- Museの公開、Meta
- Museによるagentのsecurityとsafety、Meta
- MistralのSeries D
- XでのSeries D発表
- Navier-Stokes問題の解法、OpenAI
- internal modelに関するOpenAIのスレッド
- MITにおけるCodexとquantum computing実験
- ChatGPT Images 2.5、OpenAI
- Manus、GPT-Image-2.5を統合
- AlphaGenome Atlas、Google DeepMind
- CUDA Rust、NVIDIA
- ECCV 2026のAI City Challenge、NVIDIA
- CognitionのSeries E
- XでのCognitionのスレッド
- Suno、Believe、TuneCoreの提携
- decoding megakernel、Cohere
- Claude Platformでcostを削減、Anthropic
- Claude Code 2.1.265
- agentのlive steering、Amp
- CursorのMuse Spark 1.3
- Grok Botのform入力
- Grok Imagineのkeyframeとloop
- Earthmoverによるopen weather model、Hugging Face
- 誰のためのsecurityか、Multiverse Computing
- fly connectomeとshuffled wiring、Oruk
- KinetixがRunwayに参加
- Sarah Friarの寄稿、OpenAI
- 青少年研究助成金、OpenAI
- prompt injectionリスクについてのBoris Cherny
- Claude Managed Agents上で開発する創業者たち
- RelayShieldと指示ファイル
- ECCV 2026のAi2
- agentのtool層、Prismberry
- ハードウェア保守記録
- Missouri州のGemini for Education
- DependabotとGitHubのprivate registry
- GitHubの新しいsupport portal
- SF Tech Week期間中のSpark House、Genspark
- ElevenLabs最高財務責任者、Ethan Tandowsky
- 東京でのMiniMaxイベント
- Nemotron Labsの配信
- HeyGenのavatar比較
- OpenAIのjournalism program
- AIの投資収益率に関するguide、Perplexity