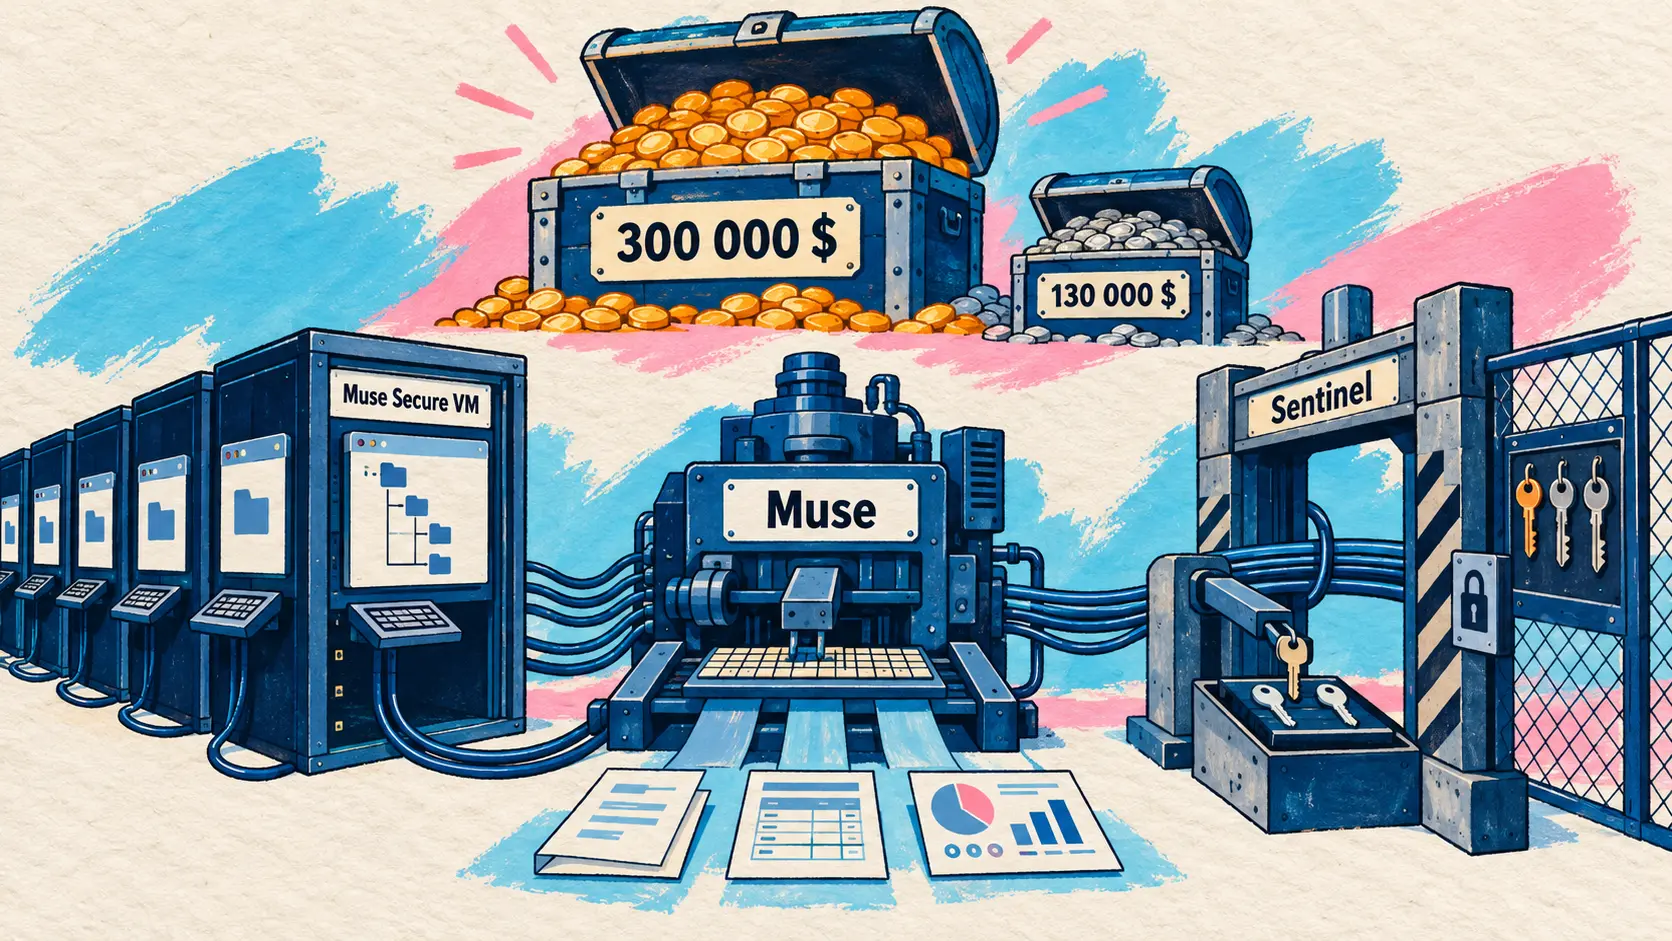
Meta lance Muse, un agent personnel qui donne à chaque utilisateur sa propre machine Linux dans le cloud, et publie le même jour l’architecture de sécurité qui l’entoure, avec un programme de primes à la faille (bug bounty) ouvert à tous jusqu’à 300 000 dollars. Mistral annonce une Série D de 3 milliards d’euros, la plus grande levée en actions jamais bouclée par une entreprise technologique européenne. OpenAI publie de son côté une preuve de singularité en temps fini pour les équations de Navier-Stokes, produite par un système d’agents, et Google DeepMind pré-calcule l’effet des 9 milliards de mutations possibles de l’ADN humain.
Meta lance Muse, son agent personnel, et publie son architecture de sécurité
8 septembre — Meta lance Muse, un agent personnel disponible en applications iOS et Android, en interface web et dans WhatsApp, propulsé par Muse Spark 1.3. Le modèle n’est pas nouveau : il est arrivé le 2 septembre dans Muse Code et la Meta Model API, et son palier de raisonnement maximal est passé en public le 4 septembre. Ce qui l’est, c’est le produit grand public construit autour de lui.
L’architecture repose sur une idée simple à énoncer et lourde à mettre en œuvre : chaque utilisateur reçoit son propre ordinateur dans le cloud. La Muse Secure VM est une machine Linux persistante et isolée, dotée d’un système de fichiers, d’un terminal et d’un navigateur complet, avec assez de stockage, de processeur et de mémoire pour compiler du code, développer des compétences sur mesure et faire tourner des sous-agents en parallèle. C’est cette machine, et non une infrastructure Meta centralisée, qui sert de système de référence pour les données et les identifiants des services connectés. Quand un outil manque à une tâche, l’agent l’écrit lui-même, et il produit des objets manipulables plutôt que des blocs de texte : itinéraires, PDF, pages web et tableaux de bord, que Meta appelle des Artifacts.
Deuxième rupture revendiquée, l’agent travaille en arrière-plan application fermée, sur planification et en réaction à des évènements, puis décide si le résultat mérite une notification. La mémoire est persistante, lisible et modifiable par l’utilisateur, et un onglet Objectifs donne la vue d’ensemble de ce que l’agent suit. Reste ce que Meta ne dit pas : aucun tarif n’est publié et aucune liste de pays de disponibilité n’accompagne le lancement.
Vingt minutes après l’annonce produit, Meta a publié un document d’ingénierie signé Tarek Sheasha, ingénieur logiciel et vice-président chez Meta Superintelligence Labs, sur la sécurité de ce dispositif. Le principe directeur est posé d’emblée : le système est conçu en supposant que l’agent sera attaqué. Le harnais agentique, appelé Hatch dans le code, tourne dans un conteneur systemd-nspawn dont le root est mappé vers un utilisateur non privilégié de l’hôte, avec appels système filtrés et capacités noyau retirées. Quatre services vivent délibérément hors de ce conteneur, pour qu’un attaquant qui compromettrait l’agent ne puisse pas les désactiver : les classifieurs de sécurité, les workers à privilèges séparés, le démon de stockage des identifiants et Sentinel.
Sentinel est la pièce centrale : seule autorité capable d’autoriser une action de connecteur ou une sortie réseau, il évalue chaque requête aux couches 4 et 7 et vérifie l’adresse réellement résolue. Surtout, l’agent ne manipule que des jetons de substitution, remplacés par les identifiants réels à la frontière réseau. Faire cracher un secret à l’agent par injection de prompt devient sans objet, puisqu’il ne l’a jamais eu. S’y ajoute un suivi de flux au niveau du noyau, le tainted egress : tout processus qui lit des données utilisateur est marqué et perd son autorisation automatique. L’implémentation combine des programmes eBPF attachés aux cgroups et des hooks Linux Security Module ajoutés par Meta.
| Élément de l’architecture | Choix retenu |
|---|---|
| Conteneur du harnais agentique | systemd-nspawn, root mappé sur un utilisateur non privilégié |
| Autorité d’autorisation | Sentinel, hors du conteneur, couches 4 et 7 |
| Identifiants vus par l’agent | jetons de substitution uniquement |
| Connecteur courriel | filtrage des codes à usage unique et des liens de réinitialisation |
| Sous-agent navigateur | arbre d’accessibilité, pas de DOM brut, pas de JavaScript dans la page |
| Paiements | Stripe Link au lancement, Shop Pay ensuite, carte à usage unique |
| Bug bounty, plafond par rapport valide | 300 000 dollars |
| Bug bounty, injection de prompt | jusqu’à 130 000 dollars |
Deux annonces accompagnent le document. Le programme de primes à la faille s’ouvre à tous dès le lancement, avec jusqu’à 300 000 dollars par rapport valide selon l’impact démontré, dont jusqu’à 130 000 dollars pour une injection de prompt réussie affectant un utilisateur. Et Muse Confidential VM, prévu d’ici la fin de l’année, doit empêcher cryptographiquement et de manière vérifiable Meta d’accéder aux données d’une machine virtuelle, avec une conception et un code source déjà soumis à des auditeurs externes. La conclusion du texte est inhabituellement franche pour une publication d’entreprise : l’injection de prompt reste un problème ouvert dans l’industrie, et Muse fera des erreurs.
🔗 Lancement de Muse · 🔗 Sécurité et sûreté des agents, Meta
Mistral lève 3 milliards d’euros, la plus grande levée en actions de la tech européenne
8 septembre — Mistral annonce une Série D de 3 milliards d’euros, à une valorisation post-money supérieure à 21 milliards d’euros. L’entreprise présente ce tour comme la plus grande levée en actions jamais bouclée par une société technologique européenne, trois ans après sa création.
Samsung Electronics mène l’opération. Le Scaleup Europe Fund, géré par EQT, et PSG Equity, déjà actionnaire, la co-mènent. Trois nouveaux entrants rejoignent la table : Advent, des fonds et comptes gérés par BlackRock, et le Grand-Duché de Luxembourg. La liste des participations existantes est longue et couvre trois continents, d’a16z à Salesforce Ventures en passant par ASML, BNP Paribas CIB, Bpifrance, DST Global, General Catalyst, Index Ventures, Korelya Capital, Lightspeed et NVIDIA.
Le détail qui mérite l’attention est la nature des deux chefs de file successifs. ASML avait mené la Série C, Samsung Electronics mène la Série D : deux industriels de la fabrication avancée, pas des fonds technologiques généralistes. Mistral y lit un signe de confiance dans sa capacité à déployer des modèles de pointe à l’intérieur d’environnements industriels complexes, où la maîtrise des données et de l’infrastructure conditionne l’adoption.
| Indicateur | Valeur |
|---|---|
| Montant levé | 3 milliards d’euros |
| Valorisation post-money | plus de 21 milliards d’euros |
| Ancienneté de l’entreprise | 3 ans |
| Chef de file | Samsung Electronics |
| Co-chefs de file | Scaleup Europe Fund géré par EQT, PSG Equity |
| Pays d’opération | 20 |
| Grands comptes clients | plus de 125, dont Airbus, ASML et HSBC |
Sur l’usage des fonds, l’entreprise cite en premier lieu la recherche frontière, puis la montée en capacité de calcul pour l’entraînement, l’extension de l’infrastructure et l’accélération commerciale à l’international. L’argumentaire reprend la ligne défendue depuis l’été : la question posée par les organisations ne serait plus de savoir qui construit le modèle le plus puissant, mais comment exploiter l’IA sans céder le contrôle de son infrastructure. Mistral se décrit comme la seule entreprise du secteur à assembler la pile complète nécessaire, des modèles à poids ouverts jusqu’aux produits en passant par la capacité de calcul.
Today marks a major step for Mistral: we’re announcing a €3B Series D, the largest equity round ever raised by a European tech company, just three years after launch.
🇫🇷 Aujourd’hui marque une étape majeure pour Mistral : nous annonçons une Série D de 3 milliards d’euros, la plus grande levée en actions jamais réalisée par une entreprise technologique européenne, trois ans seulement après notre lancement. — @MistralAI sur X
Les agents scientifiques d’OpenAI : une preuve sur Navier-Stokes, des qubits calibrés au MIT
8 septembre — OpenAI publie une preuve de formation de singularité en temps fini pour les équations de Navier-Stokes en trois dimensions, accompagnée d’une formalisation dans l’assistant de preuve Lean. Le résultat annoncé est qu’un fluide tridimensionnel initialement lisse et au repos, soumis à une force extérieure lisse, peut voir sa vitesse croître sans borne en un temps fini, alors que la viscosité tend à lisser le mouvement et que l’énergie du système reste finie. Dans la formulation officielle du Clay Mathematics Institute, cela correspond aux énoncés « C » et « D », ceux qui constituent une réfutation et non une preuve de régularité.
Ce qu’OpenAI revendique et ce qu’elle ne revendique pas mérite d’être posé précisément. La preuve a été produite par un système d’agents coordonnés adossé à un modèle interne sans nom public, décrit par l’entreprise comme significativement plus capable que GPT-6 Astra et dont l’entraînement se poursuit depuis le 28 août. La seule vérification décrite est la formalisation en Lean, confiée à GPT-6 Astra et bouclée en 17 heures après la résolution. L’annonce ne fait état d’aucune relecture par les pairs ni d’aucune validation par le Clay Mathematics Institute, et OpenAI déclare ne pas avoir l’intention de réclamer le prix du millénaire, présentant son résultat comme un instantané plutôt qu’un aboutissement.
La méthode est au moins aussi remarquable que le résultat. L’effort a démarré le 1er septembre, après des rumeurs affirmant que deux problèmes du millénaire venaient d’être résolus. Des groupes d’agents distincts ont reçu des variantes différentes de l’énoncé, les versions « A » et « B » orientées vers une preuve, les versions « C » et « D » vers une réfutation. Sur un problème annexe, la régularité des équations d’Euler non forcées, près de 100 agents ont produit une réfutation en une cinquantaine d’heures ; ce résultat a été réinjecté dans les prompts des agents travaillant sur Navier-Stokes.
| Métrique | Valeur |
|---|---|
| Agents concurrents, groupe Navier-Stokes | de l’ordre de 10 000 |
| Délai jusqu’à la résolution | environ 88 heures |
| Formalisation et vérification en Lean | 17 heures de plus, via GPT-6 Astra |
| Messages échangés, Navier-Stokes | 2,7 millions |
| Tokens de sortie, Navier-Stokes | environ 130 milliards |
| Messages échangés, tous problèmes tentés | 4,9 millions |
| Tokens de sortie, tous problèmes tentés | environ 300 milliards |
| Réfutation de la régularité d’Euler non forcé | près de 100 agents, environ 50 heures |
Un travail concurrent complique le tableau. Levent Alpöge, employé d’Anthropic, et Tristan Buckmaster, professeur de mathématiques à NYU, avaient un résultat sur les équations d’Euler dans leur version forcée. OpenAI les a contactés le 6 septembre, une fois son projet terminé et vérifié, pour proposer une publication conjointe et reconnaître leur antériorité, avant de découvrir que leur résultat portait sur un énoncé différent du sien.
This model represents a step-function improvement on many benchmarks, and its training is ongoing. Our internal model group arrived at the Navier–Stokes solution in 88 hours, using around 10,000 coordinating AI agents. Throughout the effort, we maintained the strict safeguards—including monitoring and isolation—that we apply to all our frontier evaluations.
🇫🇷 Ce modèle représente une amélioration en marche d’escalier sur de nombreux benchmarks, et son entraînement se poursuit. Notre groupe de modèle interne est parvenu à la solution de Navier-Stokes en 88 heures, avec environ 10 000 agents IA coordonnés. Tout au long de l’effort, nous avons maintenu les garde-fous stricts, dont la surveillance et l’isolement, que nous appliquons à toutes nos évaluations de modèles de frontière. — @OpenAI sur X
Le même jour, OpenAI publie une étude de cas nettement plus modeste et nettement plus vérifiable. Beatriz Yankelevich, doctorante du groupe Engineering Quantum Systems du MIT, a branché Codex piloté par GPT-5.6 Sol sur le logiciel qui coordonne ses expériences, pour calibrer une puce à six qubits supraconducteurs non calibrée. Les agents ont reçu des skills propres à chaque type de mesure, décrivant comment la conduire et comment en juger. Sur des signaux clairs, Codex a mené une séquence complète avec peu d’intervention : identification des fréquences de transition, calibration des impulsions de contrôle et de lecture, mesure de la durée de conservation de l’information quantique. Sur des signaux faibles ou bruités, il met plus longtemps à trouver des paramètres exploitables et réclame parfois l’œil d’un chercheur expérimenté, qui reste plus rapide que le modèle. Le gain n’est donc pas la vitesse mais l’absence de supervision permanente : la caractérisation d’une de ces puces standard coûte plusieurs jours à un chercheur, et le groupe confie désormais les mesures de routine à des agents.
🔗 Solution Navier-Stokes, OpenAI · 🔗 Codex et expériences quantiques, OpenAI
ChatGPT Images 2.5, avec Sketch et deux modèles image dans l’API
8 septembre — OpenAI lance ChatGPT Images 2.5 dans ses produits et dans l’API. Le chiffre d’usage donné en ouverture situe l’enjeu : plus de 3 milliards d’images sont créées chaque semaine sur ChatGPT Images et les modèles GPT-Image de l’API. Le gain le plus concret est la latence, réduite jusqu’à 50 pour cent par rapport à Images 2.0, le reste portant sur la fidélité aux photos de référence et sur la cohérence au fil d’une conversation longue, où les modifications antérieures sont mieux préservées.
Trois fonctionnalités arrivent côté ChatGPT. Sketch permet de dessiner directement dans la conversation pour servir de guide visuel, en tapant « @Sketch ». Des templates couvrent les formats courants, affiche ou merchandising. Les commentaires se posent sur l’image pour cibler une retouche. Le partage d’une image peut désormais inclure le prompt qui l’a produite. Le déploiement couvre tous les utilisateurs ChatGPT, ChatGPT Work et Codex, sur desktop, mobile et web, tous paliers confondus.
| Modèle dans l’API | Positionnement annoncé | Latence |
|---|---|---|
| GPT-Image-2.5 Flare | choix par défaut, contenu social, génération en volume | jusqu’à 50 pour cent de moins qu’Images 2.0 |
| GPT-Image-2.5 Sunburst | précision, campagnes prêtes à diffuser | temps de génération plus longs |
Les deux modèles supportent les nouveaux réglages de qualité xhigh et max et reprennent les tarifs de tokens de GPT Image 2, soit sur le palier Standard 8,00 dollars par million de tokens en entrée image, 30,00 dollars en sortie image et 5,00 dollars en entrée texte. Les métadonnées C2PA et le filigrane invisible sont conservés, et une system card accompagne la sortie.
Manus intègre le modèle le jour même
Manus ajoute GPT-Image-2.5 à sa plateforme le soir de l’annonce, en citant le message d’OpenAI publié une heure et demie plus tôt. Le laboratoire d’agents, redevenu indépendant le 1er septembre, avance un chiffre issu de ses propres évaluations et non de celles d’OpenAI : le modèle qu’il désigne sous le nom de Flare produit des images de haute qualité à une vitesse deux à quatre fois supérieure à celle de GPT-Image-2. Pour un agent qui génère des visuels au fil d’une conversation, ce facteur compte davantage qu’un gain de qualité marginal, puisqu’il détermine si la génération reste dans le flux de travail ou impose une attente. Manus met aussi en avant une génération améliorée d’arrière-plans transparents, qui évite l’étape de détourage manuel cassant l’automatisation complète.
AlphaGenome Atlas, la carte prédictive des 9 milliards de mutations de l’ADN humain
8 septembre — Google DeepMind lance AlphaGenome Atlas, une base de données qui prédit l’effet moléculaire de chaque mutation d’une seule lettre possible dans l’ADN humain. Le génome humain compte environ 3 milliards de paires de bases, dont seuls 2 pour cent codent pour des protéines ; les 98 pour cent restants restent largement inexplorés alors qu’un simple changement de lettre peut y désactiver un régulateur biologique essentiel.
La méthode tient en une inversion de charge. Plutôt que de laisser chaque laboratoire interroger le modèle variant par variant, Google DeepMind a pré-calculé les prédictions du modèle AlphaGenome sur la totalité des 9 milliards de substitutions possibles. Le résultat est un jeu de données de 1 pétaoctet, présenté comme plus de trente fois la taille de la AlphaFold Database. Pour rendre ce volume exploitable, l’Atlas introduit le score AVI (AlphaGenome Variant Impact), un nombre unique qui agrège les prédictions sur les régions codantes et non codantes et indique quels processus biologiques un variant perturbe, avec des attributions par caractéristique. S’y ajoute un catalogue de plus de 2 500 motifs de séquence récurrents, les unités régulatrices que Google décrit comme les « mots » du génome.
| Métrique | Valeur |
|---|---|
| Variants pré-calculés | 9 milliards, tous les changements d’une lettre |
| Taille du jeu de données | 1 pétaoctet, plus de 30 fois la AlphaFold Database |
| Motifs de séquence catalogués | plus de 2 500 |
| Participants UK Biobank analysés | plus de 54 000 |
| Associations non codantes supplémentaires | plus 22 pour cent |
| Régions génétiques liées à l’IMC identifiées | 19 |
Deux usages documentés donnent la mesure du gain. Au Broad Institute, Laura Covill et son équipe ont utilisé le score AVI pour hiérarchiser des variants candidats sur des maladies rares restées sans diagnostic : l’outil a mis en avant un variant du gène DNM1 en prédisant qu’il créait un site d’épissage incorrect, ce qui a fourni l’élément déterminant pour résoudre le cas. À l’University of Exeter, Gareth Hawkes a appliqué l’Atlas aux données de plus de 54 000 participants de la UK Biobank et obtenu 22 pour cent d’associations génétiques non codantes supplémentaires, puis identifié 19 régions génétiques liées à l’indice de masse corporelle en se limitant au 1 pour cent de variants les plus impactants.
L’accès est le second point notable. L’Atlas est disponible via un portail web sans écriture de code, à destination des cliniciens et des biologistes qui ne programment pas, mais aussi par l’API AlphaGenome, sur Cloud via Model Garden, avec les données de recherche publiées sur GitHub. Détail qui intéressera les développeurs suivant l’écosystème agentique de Google : l’Atlas est également distribué comme compétence (skill) dans Google Antigravity, donc directement mobilisable par un agent de codage.
🔗 AlphaGenome Atlas, Google DeepMind
NVIDIA lance CUDA Rust, et Cosmos rafle l’AI City Challenge d’ECCV
8 septembre — NVIDIA publie CUDA Rust, sa réponse à un manque devenu visible : la couche systèmes de l’IA est de plus en plus écrite en Rust, mais le kernel GPU restait l’exception. On pouvait déjà lancer un kernel depuis Rust ; il fallait l’écrire ailleurs. CUDA Rust ferme cet écart en compilant les kernels Rust nativement vers PTX, par deux pistes distinctes alignées sur les deux modèles de programmation que CUDA propose déjà en C++ et en Python.
| Élément | cuda-oxide, piste SIMT | cutile-rs, piste Tile |
|---|---|---|
| Maturité | alpha précoce | publié sur crates.io |
| Chaîne Rust requise | nightly épinglée (nightly-2026-04-03) | stable 1.89 ou plus |
| Version de CUDA | 12.x ou plus | 13.3 |
| LLVM à fournir | oui, plus clang et libclang | non |
| Compilation | vers PTX à la construction | JIT via CUDA Tile IR |
| Usages externes cités | aucun | Grout de Hugging Face, mistral.rs |
La recommandation de NVIDIA est explicite : commencer par Tile, parce que le code source n’encode alors aucun choix propre à une architecture, et descendre vers SIMT quand le contrôle fin des threads et de la mémoire devient nécessaire. Cet arbitrage a un coût aujourd’hui, puisqu’en SIMT la mémoire partagée, socle des kernels rapides, exige encore unsafe. L’argument de fond est la sécurité mémoire à la compilation : les deux pistes refusent l’aliasing classique où un tampon sert à la fois d’entrée et de sortie, avec error[E0502] côté SIMT et error[E0382] côté Tile. Sur la maturité, NVIDIA ne survend pas : aucun des deux projets n’est prêt pour la production, et l’engagement annoncé porte sur 2027 et au-delà, avec un travail conjoint avec les mainteneurs de rust-cuda.
Le même jour, NVIDIA publie le palmarès de l’AI City Challenge d’ECCV 2026. Sur la piste 5, consacrée à la prévision vidéo générative de scènes de trafic, quatre des cinq meilleures solutions utilisent des versions des modèles de fondation de monde Cosmos. L’équipe Qyn remporte le classement public avec CosmosAlign, qui adapte le modèle figé Cosmos3-Nano de 16 milliards de paramètres par une recette LoRA en deux étapes, génère quatre prévisions, retient le médoïde et réinjecte les régions stables de l’historique observé : 76,39 contre 76,04 pour l’équipe SSUPER, soit 0,35 point d’avance. NVIDIA prend soin de préciser qu’il s’agit d’une recette d’adaptation et d’inférence, pas d’une nouvelle architecture. Cosmos apparaît aussi comme juge : sur les deux classements hors domaine de la piste 3, l’équipe UWIPL_ETRI l’emporte avec UniTraffic, qui fait contrôler les affirmations disputées par un vérificateur Cosmos-Reason1 indépendant.
🔗 CUDA Rust, NVIDIA · 🔗 Palmarès AI City Challenge
Cognition lève plus de 2 milliards de dollars et atteint 48 milliards de valorisation
8 septembre — Cognition, l’éditeur de l’agent de développement Devin, annonce une levée de plus de 2 milliards de dollars pour une valorisation de 48 milliards. Le tour est mené par deux nouveaux entrants, Andreessen Horowitz et Accel, aux côtés des investisseurs déjà présents Founders Fund, General Catalyst et Avenir. Une trentaine de participants complètent la table, dont NVIDIA, Benchmark, Bessemer, Kleiner Perkins, Greylock, Lightspeed, T. Rowe Price et Bain Capital Ventures.
| Indicateur | Mai 2026 | Septembre 2026 |
|---|---|---|
| Montant levé, cumul du tour | plus de 1 milliard de dollars | plus de 2 milliards |
| Valorisation | 26 milliards de dollars | 48 milliards |
| Chiffre d’affaires annualisé | 492 millions de dollars | près de 900 millions |
| Chefs de file | Lux Capital, General Catalyst, 8VC | Andreessen Horowitz, Accel |
La valorisation a donc presque doublé en quatre mois et a été multipliée par près de cinq en un an, avec un chiffre d’affaires annualisé qui suit la même pente. Cognition détaille les usages qui portent cette croissance : Devin travaille sur la conception de puces chez NVIDIA, sur l’aviation chez GE Aerospace, sur les services financiers chez Citi, sur l’automobile chez Mercedes-Benz et sur l’infrastructure IA chez Modal. Le fait que NVIDIA soit à la fois client et investisseur du tour illustre la manière dont ces entreprises verrouillent l’accès aux outils qu’elles utilisent en interne. Trois capacités récentes déplacent Devin de l’exécution de tâches vers l’action autonome : Auto-Triage pour la première passe d’investigation d’incident, Security Swarm pour le tri des vulnérabilités, et Automations déclenché par des évènements Slack, GitHub ou Linear. Six bureaux ont été ouverts en un an, dont cinq hors des États-Unis, en plus des pôles de San Francisco, New York et Austin.
In the next chapter of software engineering, agents will become proactive by default, software will improve itself, and compute will automatically get allocated toward the highest impact use cases. We’re still at the dawn of the self-driving software era.
🇫🇷 Dans le prochain chapitre de l’ingénierie logicielle, les agents deviendront proactifs par défaut, le logiciel s’améliorera lui-même, et la puissance de calcul sera automatiquement allouée vers les usages à plus fort impact. Nous sommes encore à l’aube de l’ère du logiciel autonome. — @cognition sur X
Suno signe avec Believe et TuneCore, qui refusaient hier de distribuer sa musique
8 septembre — Suno annonce un partenariat stratégique mondial avec Believe, société de développement d’artistes, et sa plateforme d’auto-distribution TuneCore. L’accord porte sur deux choses distinctes. D’abord, Believe entre dans la conception des nouveaux modèles musicaux que Suno développe avec l’industrie. Ensuite, et c’est le point concret pour les utilisateurs, les morceaux créés avec ce nouveau modèle partenaire deviendront éligibles à la distribution via Believe et TuneCore, donc vers Spotify, Apple Music, Amazon Music et YouTube.
Le contexte donne sa portée à l’annonce. Suno rappelle sans détour que plus tôt cette année, Believe et TuneCore avaient annoncé qu’ils ne distribueraient pas de musique produite avec des modèles ne satisfaisant pas leurs critères, ceux de Suno de l’époque compris. Le retournement est présenté comme le produit de discussions ayant fait apparaître des valeurs communes : donner des choix réels aux artistes et ouvrir des voies de distribution et de revenus.
L’accord s’inscrit dans une séquence cohérente. Il prolonge Spark, le programme de Suno destiné aux artistes indépendants et émergents, et complète les accords existants avec Warner Music Group et BMG en y ajoutant les labels indépendants et les artistes auto-produits. Suno le lie aussi explicitement à ses garde-fous récents : le filigrane audio et l’empreinte acoustique destinés à identifier ses morceaux hors plateforme, et les limites de téléchargement entrées en vigueur le 3 septembre pour empêcher la diffusion de masse vers les services de streaming. Ces protections s’appliqueront à la musique distribuée par Believe et TuneCore. L’annonce se termine sur un calendrier : Suno annonce le lancement très prochain de ses nouveaux modèles, dont la famille avait été nommée v6 le 4 septembre.
Cohere ouvre un moteur de service (serving) bâti autour d’un megakernel, 1,58x plus rapide que vLLM
8 septembre — Cohere publie un moteur de service d’inférence entièrement construit autour d’un megakernel de décodage, sous licence Apache 2.0. L’entreprise revendique une première : non pas une démonstration de vitesse en laboratoire, mais un serveur complet capable de traiter de vraies requêtes derrière un point d’accès compatible OpenAI, avec traitement par lots continu, attention paginée, cache de préfixe et appel d’outils. Le modèle servi est North Mini Code, un mélange d’experts de 30 milliards de paramètres dont 3,3 milliards seulement sont actifs par token.
Le problème attaqué tient en une phrase : pendant le décodage, le GPU passe beaucoup de temps à attendre plutôt qu’à calculer. Une pile classique lance un noyau (kernel) par opération, et chaque frontière de noyau impose une barrière sur toute la grille de calcul. Or le décodage autoregressif est limité par la bande passante mémoire : à chaque étape, North Mini Code fait transiter 6,6 Go de poids depuis la mémoire HBM, plus environ 0,5 Go de cache clé-valeur à 8K de contexte, ce qui place le plafond théorique autour de 470 tokens par seconde sur les 3,35 To/s d’un H100. Un megakernel supprime ces frontières en lançant un seul noyau persistant qui reste résident pendant toute l’étape de décodage, avec des dépendances réduites à des compteurs en mémoire globale.
| Mesure | Megakernel | vLLM v0.24 | Gain |
|---|---|---|---|
| Décodage, taille de lot 1, contexte 8K (tok/s) | 292 | 185 | 1,58x |
| AIME 2025, bout en bout (tok/s) | 935 | 661 | 1,41x |
| SciCode, bout en bout (tok/s) | 711 | 560 | 1,37x |
| MMLU-Pro, sous-ensemble informatique (tok/s) | 948 | 713 | 1,33x |
| LiveCodeBench v6, bout en bout (tok/s) | 803 | 625 | 1,28x |
| GPQA, bout en bout (tok/s) | 787 | 631 | 1,25x |
Les 292 tokens par seconde à taille de lot 1 représentent 62 pour cent du plafond théorique, contre 39 pour cent pour vLLM. La qualité ne bouge pas : 38,9 pour cent contre 38,2 sur SciCode, 70,3 pour cent des deux côtés sur LiveCodeBench v6, moyennes sur sept exécutions. Un détail mérite l’attention : l’avance dépend de la distribution des experts, avec 1,32x sous le routage réel du modèle contre 1,14x sous routage uniforme simulé, ce qui fait des mesures uniformes le cas défavorable. Cohere insiste enfin sur un point contre-intuitif : écrire un megakernel serait plus simple que sa réputation ne le laisse croire, avec un unique fichier CUDA où seize codes d’opération couvrent toute l’étape de décodage. Les limites sont assumées et qualifiées de limites d’implémentation : décodage seulement, le préremplissage tournant encore en noyaux PyTorch ordinaires, H100 et BF16 uniquement, tailles de lot de 1 à 8.
Anthropic documente comment baisser la facture Claude Platform sans perdre en performance
8 septembre — Anthropic publie un guide d’ingénierie qui prend le contre-pied de l’idée reçue selon laquelle réduire la facture d’un agent revient à accepter de moins bons résultats. Trois leviers y sont documentés : maximiser le taux de succès du cache de prompt, retirer les anti-patterns de prompt lors du passage à un modèle de frontière, et calibrer l’effort à la tâche. La méthode est livrée sous forme de commandes exécutables dans Claude Code, avec /claude-api prompt-audit et /claude-api hillclimb qui rejoignent /claude-api cost-optimize.
| Banc d’essai, base Sonnet 5 | Baisse de coût | Détail mesuré |
|---|---|---|
| LegalBench | environ 58 pour cent | tokens de raisonnement de 102 779 à 8 284 |
| tau2-bench retail | environ 73 pour cent | cache de prompt avec points de coupure explicites |
| OfficeQA Pro | environ 52 pour cent | de 136,20 à 64,87 dollars |
| SWE-bench Verified | environ 55 pour cent | étapes médianes de 29 à 17, tokens de prompt divisés par plus de deux |
Le chiffre le plus actionnable ne figure pas dans ce tableau. Sur CursorBench 3.2, Claude Fable 5.1 à effort low égale Fable 5 à effort high pour un tiers du coût, dont une part vient du tarif des lectures de cache, facturées 0,25 dollar le million de tokens contre 1,00 dollar auparavant. À l’inverse, sur Humanity’s Last Exam sans outils, le dernier palier d’effort achète environ un demi-point pour 46 pour cent de coût en plus, un gain noyé dans le bruit du benchmark.
🔗 Réduire les coûts sur Claude Platform
Claude Code 2.1.265 : dossiers de plugins, plafond de 1 Go et réparation du cache de prompt
8 septembre — Claude Code passe en 2.1.265 avec cinquante entrées de changelog, dont trente-quatre correctifs, deux jours après une 2.1.263 qui n’en portait qu’une. L’option --plugin-dir accepte désormais un dossier entier de plugins, chaque sous-dossier muni d’un manifeste étant chargé, les ajouts et suppressions faits pendant l’exécution étant détectés. Un plafond de 1 Go s’applique aux résultats d’outils écrits sur disque, l’aperçu signalant qu’un fichier a été tronqué.
La partie la plus dense concerne le cache de prompt, en écho au guide publié le même jour. Deux correctifs distincts réparent des cas où Claude Code cassait lui-même la réutilisation du cache : la reprise d’un sous-agent lancé au premier plan changeait sa liste d’outils et son préfixe de prompt système, tandis que les coéquipiers d’agents et les sous-agents repris déplaçaient hors du préfixe le contexte des hooks SubagentStart et les skills préchargées. Deux correctifs relèvent de la sécurité : un chemin de plugin contenant un antislash contournait la vérification de confinement des liens symboliques sur macOS et Linux, et sur Windows les outils de lecture et d’écriture refusaient tout fichier dans un AppContainer ou un bac à sable à jeton restreint. La lecture d’un artifact écrit par un tiers est désormais traitée comme du contenu non fiable.
Amp remplace la file d’attente des messages par un pilotage en direct
8 septembre — Amp change le comportement par défaut de son agent face aux messages envoyés en cours de travail. Jusqu’ici, un message tapé pendant que l’agent tournait était mis en file d’attente et n’était traité qu’une fois le tour terminé ; il est désormais délivré à la première occasion possible. L’éditeur avance deux bénéfices : l’agent prend en compte le retour plus tôt, et il cesse d’engager des étapes de vérification que la nouvelle consigne rend inutiles, ce qui économise du temps et des tokens dans le cas courant où l’on voit l’agent partir dans la mauvaise direction.
Le changement n’est pas sans effet de bord, et Amp le documente. Si le pilotage se révèle trop brutal, l’éditeur conseille de formuler les demandes en « When done, then… » plutôt qu’en « Now, … », pour indiquer explicitement que l’instruction s’applique après la tâche en cours. Ship, Review et les autres actions intégrées conservent l’ancien comportement et restent mises en file, puisqu’on souhaite en général que le travail soit terminé avant de livrer ou de lancer une relecture. La mise en file manuelle reste disponible, dans l’application comme dans le CLI.
Muse Spark 1.3 arrive dans Cursor avec le meilleur rapport score-coût de CursorBench
8 septembre — Cursor ajoute Muse Spark 1.3, le modèle agentique de Meta Superintelligence Labs, six jours après sa présentation. Les chiffres publiés ne racontent pas une histoire de performance brute mais de coût. Sur CursorBench 3.2, le banc d’essai maison construit à partir de tâches réelles multi-fichiers, le palier Max obtient 67,9 pour cent pour 1,31 dollar par tâche et se classe douzième.
| Modèle et palier | Score CursorBench 3.2 | Coût par tâche, en dollars | Tokens par tâche | Rang |
|---|---|---|---|---|
| Fable 5.1 Max | 73,4 pour cent | 9,64 | 72 060 | 1 |
| Grok 4.6 Extra High | 70,8 pour cent | 2,81 | 41 136 | 3 |
| Opus 5 Max | 70,0 pour cent | 8,23 | 61 838 | 5 |
| Gemini 3.8 Flash High | 69,2 pour cent | 2,38 | 81 524 | 9 |
| Muse Spark 1.3 Max | 67,9 pour cent | 1,31 | 33 034 | 12 |
| GPT-5.6 Sol Max | 67,2 pour cent | 5,69 | 28 320 | 13 |
| Muse Spark 1.3 Low | 55,0 pour cent | 0,45 | 12 181 | 49 |
Le modèle de Meta se place donc loin derrière Claude Fable 5.1 Max sur le score, mais ce dernier coûte plus de sept fois plus cher par tâche. Il devance surtout GPT-5.6 Sol dans son palier Max en coûtant plus de quatre fois moins. Cursor maintient sa méthode, qui consiste à publier systématiquement le score et le coût par tâche de chaque modèle ajouté plutôt qu’une simple disponibilité.
Grok Bot fait remplir formulaires et identifiants depuis le chat, Grok Imagine gagne le contrôle par images clés
8 septembre — SpaceXAI permet désormais de renseigner formulaires et pages de connexion pour son Grok Bot sans quitter la conversation, avec prise en charge annoncée de n’importe quel gestionnaire de mots de passe. La fonction répond à un point de friction propre aux agents persistants : dès que l’agent doit franchir un écran de connexion ou soumettre un formulaire contenant des informations personnelles, il lui faut soit des identifiants stockés, soit une intervention de l’utilisateur. Faire remonter cette étape dans le fil de conversation plutôt que dans une session de navigateur séparée est un choix d’ergonomie autant que de sécurité.
Deux heures plus tard, Grok Imagine gagne le contrôle des images de début et de fin d’une scène vidéo, ainsi que la génération de boucles sans couture, avec un meilleur suivi des instructions et une qualité vidéo annoncée supérieure. Le contrôle par images clés change la nature de l’outil pour qui produit des plans successifs : fixer la dernière image d’un plan permet de la réutiliser comme première image du suivant, donc d’enchaîner des séquences dont la continuité ne dépend plus du hasard de la génération. L’annonce arrive trois jours après la mise en service de l’agent Grok Imagine Video 1.5 propulsé par le modèle Image 2.0.
🔗 Remplissage de formulaires dans Grok Bot · 🔗 Images clés dans Grok Imagine
Trois billets de recherche sur le blog Hugging Face
8 septembre — Trois publications de la communauté Hugging Face méritent la lecture le même jour, sur la météo, la sécurité des modèles et les modèles inspirés du vivant.
Faire tourner un modèle météo ouvert sans GPU
Hugging Face et Earthmover publient un billet conjoint sur un problème rarement traité : les modèles météo par apprentissage sont assez légers pour tourner sur un ordinateur portable, et pourtant presque personne ne les lance. Trois obstacles sont identifiés, le calcul (plusieurs modèles dont AIFS dépendent de flash attention, limitée à certaines architectures de cartes graphiques), le stockage, et surtout la bande passante, avec environ 1 Go de conditions initiales par prévision. La réponse tient en trois artefacts publics : un espace de démonstration, un compartiment de stockage (bucket) et un tutoriel reproductible qui fait tourner Aurora, le modèle de Microsoft, en version pré-entraînée à 0,25 degré, avec des conditions initiales ERA5 servies par le marché de données Earthmover. Aucun GPU n’est requis : deux à trois minutes par pas de calcul sur processeur, quelques secondes sur carte graphique, et quatre pas de six heures pour une prévision à vingt-quatre heures comparée ensuite à ERA5.
🔗 Modèles météo ouverts avec Earthmover
Un modèle réputé plus sûr qui refuse trois quarts des questions inoffensives
Multiverse Computing publie un résultat qui devrait circuler bien au-delà de la recherche sur l’alignement. En entraînant Qwen3-8B à refuser les demandes de manipulation politique, l’équipe obtient des chiffres qui ressemblent à une victoire nette : le taux moyen de réponse dangereuse sur HarmBench, StrongREJECT et WildJailbreak tombe de 26,26 à 0,14 pour cent. Au même point de contrôle, le sur-refus sur XSTest monte de 2,00 à 74,00 pour cent. Autrement dit, la configuration la plus sûre sur le papier est une machine à refuser, et rien dans les mesures habituelles ne permet de le voir. Deux corrections font le travail : remplacer les réponses de conformité externes par des réponses vérifiées du modèle cible fait retomber le sur-refus XSTest de 15,20 à 5,20 pour cent, et l’ajout de paires de frontière bénignes fait tomber le sur-refus du côté à satisfaire de 32,94 à 4,16 pour cent, tandis que le refus du côté nocif ne perd que quatre points.
🔗 Sécurité pour qui, Multiverse Computing
Un connectome de mouche ne bat pas son propre câblage mélangé
Oruk publie une leçon de méthode qui vaut au-delà des modèles inspirés de connectomes. L’équipe a copié 499 neurones fortement connectés de la reconstruction publique MaleCNS d’une mouche dans un réseau récurrent servant de réservoir, avec une seule lecture ridge entraînée par-dessus. Le câblage de la mouche obtient 16,84 pour cent de précision moyenne au test, un câblage mélangé 16,88 pour cent : l’écart vaut moins 0,04 point, avec un intervalle de confiance qui enjambe zéro. La deuxième expérience aurait pu passer pour une preuve du contraire, puisque retirer les 50 neurones aux plus grandes normes de poids de lecture fait chuter la précision de 16,91 à 10,83 pour cent. Les auteurs expliquent pourquoi il n’y a pas de contradiction : une ablation spectaculaire ne démontre jamais qu’une topologie biologique était nécessaire. À signaler, le billet indique lui-même avoir été préparé par un agent IA à partir d’un article non relu par les pairs, et le jeu d’évaluation complet reste privé.
🔗 Connectome et câblage mélangé, Oruk
Runway recrute l’équipe du laboratoire parisien Kinetix
8 septembre — Runway annonce que l’équipe de Kinetix, laboratoire de recherche en IA basé à Paris, le rejoint. Le laboratoire travaillait sur le mouvement humain en 3D et sur la génération vidéo ancrée dans la physique, deux sujets que Runway rattache directement à sa recherche sur les modèles de monde appliqués à la robotique. L’équipe intègre le pôle parisien de l’entreprise, qui recrute par ailleurs en recherche et en ingénierie sur place.
L’argument technique tient en une phrase de l’annonce : un robot réellement utile doit comprendre et gérer des environnements, des tâches et des situations inédites, et le pré-entraînement vidéo à grande échelle offre selon Runway la voie la plus efficace pour résoudre ces problèmes de généralisation. C’est la continuité directe de Solaris, présenté le 31 août, et de GWM Worlds 2, présenté le 3 septembre : après avoir appris à des modèles à simuler le monde, Runway veut leur apprendre à y agir. Yassine Tahi, directeur général de Kinetix, situe le pari fondateur du laboratoire six ans en arrière. Aucun montant ni structure d’opération n’est communiqué.
Sarah Friar chiffre l’échelle d’OpenAI et l’effet de ses modèles sur ses coûts
8 septembre — Sarah Friar publie une tribune sur la façon dont OpenAI convertit ses avancées de recherche en activité économique. L’intérêt du texte tient à trois chiffres inédits plutôt qu’à son argumentaire.
| Indicateur | Valeur |
|---|---|
| Utilisateurs actifs hebdomadaires | plus d’un milliard |
| Entreprises clientes | 2,5 millions |
| Messages quotidiens à six mois, plans individuels | environ 50 pour cent de plus qu’au premier mois |
| Tâches distinctes essayées à six mois | environ le double |
| Coûts de service de bout en bout après optimisation | moins 20 pour cent |
| Efficacité de génération de tokens | plus de 15 pour cent |
Le troisième chiffre boucle une boucle intéressante. GPT-5.6 Sol a servi à améliorer le logiciel de service en production d’OpenAI, avec à la clé 20 pour cent de coûts de service en moins, auxquels s’ajoutent plus de 15 pour cent d’efficacité gagnée sur la génération de tokens. Autrement dit, le modèle finance une partie de sa propre infrastructure en optimisant la couche qui le sert. La trajectoire d’usage individuel répond par ailleurs à une question souvent posée et rarement documentée, celle de la rétention.
🔗 Le travail désormais à portée, OpenAI
OpenAI engage 5 millions de dollars sur la recherche indépendante concernant les adolescents
8 septembre — OpenAI ouvre un programme de bourses de 5 millions de dollars destiné à la recherche indépendante sur les effets de l’IA générative chez les 13-17 ans, avec un accent explicite sur le développement social et émotionnel. Les bourses individuelles montent jusqu’à 1 million de dollars par projet. Les candidatures se ferment le 6 octobre 2026, les projets retenus sont notifiés au plus tard le 13 novembre 2026, un point d’étape est attendu au premier trimestre 2027, et les frais généraux sont plafonnés à 10 pour cent par bourse.
Deux détails méritent d’être relevés. Le premier concerne l’indépendance revendiquée : parmi les critères d’évaluation figure la capacité du projet à produire des résultats fiables qu’ils soient ou non favorables aux fournisseurs de produits d’IA, et la publication est encouragée sans être une condition du financement. Le second est administratif mais compte, puisque les bourses sont financées et gérées par OpenAI Group PBC, l’entité commerciale, et non par la OpenAI Foundation. Le calendrier n’est pas neutre : OpenAI avait apporté son soutien le 31 août au projet de loi californien sur la sécurité des mineurs face à l’IA, et le billet indique vouloir alimenter les décisions des régulateurs.
🔗 Bourses de recherche sur les adolescents
Brèves
- Boris Cherny mesure publiquement les autres laboratoires sur le risque d’injection de prompt — le créateur de Claude Code situe le nouveau modèle d’OpenAI au niveau de Gemini Flash et d’Opus 4.8 sur l’injection de prompt, et assume de nommer publiquement les laboratoires tant qu’ils ne prendront pas la sécurité plus au sérieux. Il nuance le ton une vingtaine de minutes plus tard dans une réponse à son propre fil. 🔗 Publication
- Anthropic publie une vidéo de fondateurs qui construisent sur Claude Managed Agents — entretiens avec les fondateurs de Wispr Flow, Actively et Pendo sur l’usage des outcomes, du bac à sable et de la mémoire pour passer à l’échelle. 🔗 Publication
- RelayShield scanne les fichiers d’instructions plutôt que le code des dépôts — service payant qui lit AGENTS.md, CLAUDE.md, .cursorrules et mcp.json pour détecter les consignes hostiles en langage naturel que l’analyse statique ne voit pas. Un chiffre de dépôts malveillants cité dans le billet ne concorde pas avec sa propre source. 🔗 Billet
- Ai2 annonce sa présence à ECCV 2026 — articles et interventions répartis sur la conférence, sans titre ni programme communiqués. 🔗 Publication
- Prismberry publie un essai sur la couche d’outils des agents d’entreprise — texte de positionnement qui distingue outils d’information, d’analyse et d’action, sans annonce ni mesure, et qui promeut le produit Agent IQ de son éditeur. 🔗 Billet
- Un carnet de maintenance matérielle publié sur le blog Hugging Face — diagnostic d’une usure de roulement sur le ventilateur d’une alimentation de 650 W, sans contenu relatif à l’intelligence artificielle. 🔗 Billet
- Le Missouri ouvre Gemini for Education à 1,1 million d’élèves et étudiants — partenariat à l’échelle de l’État donnant à près de 100 000 enseignants et plus de 1,1 million d’élèves un accès sans frais à Gemini for Education, Gemini Notebook et aux certifications Google, avec des données exclues de l’entraînement et une adoption laissée au choix de chaque établissement. 🔗 Annonce
- Dependabot lit les registres GitHub privés sans jeton personnel — le
GITHUB_TOKENde Dependabot peut demander la permissionpackages: readet tirer depuis les registres GitHub Packages privés. La fonctionnalité, sortie puis annulée en juin, revient avec les identifiants automatiques réduits au rôle de repli. 🔗 Changelog - Le portail de support de GitHub déménage vers help.github.com — support, documentation, apprentissage, communauté et ressources de compte réunis au même endroit, avec une recherche propulsée par Copilot sans connexion requise. 🔗 Changelog
- Genspark ouvre Spark House pendant la SF Tech Week avec un accès anticipé à GenTeam — opération communautaire donnant aux participants un accès anticipé à GenTeam et à des conversations privées entre fondateurs et investisseurs. 🔗 Publication
- Ethan Tandowsky devient directeur financier d’ElevenLabs — deuxième nomination de direction en six jours chez ElevenLabs, après celle d’Ashley Kramer comme directrice des revenus le 2 septembre. 🔗 Publication
- MiniMax réunit à Tokyo les voix japonaises du divertissement et quatre acteurs de l’IA générative — évènement du 11 septembre à Shibuya avec le producteur Yasushi Akimoto, KADOKAWA, KAGAMIAI, Higgsfield, Krea, Runway et HeyGen, sans lancement ni chiffre. 🔗 Publication
- Deux diffusions Nemotron Labs le même jour, sur OpenShell et sur Domyn — 49 minutes 44 sur la sécurisation des agents autonomes par OpenShell, 54 minutes 20 sur l’usage de Nemotron par Domyn, sans texte descriptif ni transcription. 🔗 Publication
- HeyGen oppose deux avatars du même visage sans nommer d’outil ni de modèle — comparaison marketing sans outil concurrent nommé, sans modèle cité et sans mesure. 🔗 Publication
- OpenAI étend son programme journalisme aux écoles de journalisme — plus de 400 abonnements ChatGPT Edu pour les étudiants de master et enseignants de la Newmark J-School de CUNY et de la Medill School de Northwestern, pour 2026-2027. 🔗 Annonce
- Perplexity publie un guide sur le retour sur investissement de l’intégration de l’IA — billet pédagogique sans annonce produit, dont tous les chiffres proviennent de tiers ou de témoignages clients. 🔗 Billet
Ce que ça signifie
L’agent personnel devient un produit d’infrastructure, et sa sécurité devient un produit à part entière. Meta ne se contente pas de livrer Muse : il publie le même jour la description la plus détaillée à ce jour de la manière de contenir un agent qui dispose d’un shell, d’un navigateur et d’un accès à une boîte mail. Le choix le plus instructif est celui des jetons de substitution, qui rend l’injection de prompt sans objet sur le vol d’identifiants, non parce que le modèle résiste mieux mais parce qu’il n’a jamais eu le secret. Le tainted egress relève de la même logique : on ne fait pas confiance au modèle, on instrumente le noyau. Le bug bounty à 300 000 dollars et la franchise de la conclusion, qui reconnaît que Muse fera des erreurs, disent la même chose que Boris Cherny quand il évalue publiquement les autres laboratoires sur ce risque. La sécurité des agents n’est plus une case à cocher, c’est une surface d’ingénierie que l’on publie et que l’on paie pour faire casser.
La journée est aussi une leçon d’économie de l’IA, et l’unité de compte n’est plus le score mais le coût par tâche. Mistral lève 3 milliards d’euros à plus de 21 milliards de valorisation, Cognition plus de 2 milliards à 48 milliards, avec dans les deux cas des industriels et des clients à la table plutôt que des seuls fonds technologiques. Au même moment, Cursor publie une grille où Muse Spark 1.3 obtient 67,9 pour cent pour 1,31 dollar par tâche quand le premier du classement paie 9,64 dollars pour six points de plus, et Anthropic documente des baisses de coût de 52 à 73 pour cent sans perte de performance, en montrant qu’un modèle plus fort à effort plus bas bat souvent un modèle plus faible poussé à fond. Sarah Friar chiffre l’autre bout de la chaîne, avec 20 pour cent de coûts de service en moins obtenus en faisant optimiser par GPT-5.6 Sol la couche qui le sert. Ce sont quatre façons de dire que l’arbitrage s’est déplacé de la capacité vers le prix de cette capacité.
Sur le terrain scientifique, la question n’est plus si les agents produisent des résultats mais comment on les vérifie. OpenAI annonce une preuve de singularité pour Navier-Stokes produite par de l’ordre de 10 000 agents en 88 heures, formalisée en Lean, sans relecture par les pairs ni validation institutionnelle mentionnées, et avec un modèle interne que personne à l’extérieur ne peut interroger. La prudence de l’entreprise, qui renonce au prix du millénaire et parle d’instantané, est en soi une information. Les deux autres travaux du jour donnent la mesure du contraste : au MIT, Codex tient des protocoles bien définis mais bute sur les signaux ambigus, et un chercheur expérimenté reste plus rapide ; chez Google DeepMind, AlphaGenome Atlas ne prétend rien démontrer, il pré-calcule 9 milliards de prédictions et déplace l’effort vers la validation expérimentale. Le billet d’Oruk boucle la démonstration en montrant qu’une ablation spectaculaire ne prouve rien sans comparaison appariée, et celui de Multiverse Computing rappelle qu’un chiffre de sécurité ne veut rien dire tant que le côté bénin n’est pas mesuré avec la même rigueur.
Reste la couche basse, celle où les gains ne viennent plus des poids. Cohere ouvre un moteur de service complet où le seul changement est la suppression des frontières de noyaux, pour 1,58x le débit de vLLM à qualité identique, et prend soin de dire que la difficulté d’écriture d’un megakernel est surestimée. NVIDIA ouvre deux pistes pour écrire des kernels GPU en Rust, dont l’une est déjà utilisée hors de chez lui dans le moteur d’inférence Grout de Hugging Face et dans mistral.rs, et assume que rien n’est prêt pour la production. Sur l’AI City Challenge, quatre des cinq meilleures solutions vidéo reposent sur des modèles Cosmos adaptés par LoRA, l’équipe gagnante insistant sur le fait qu’il s’agit d’une recette d’adaptation et non d’une architecture nouvelle. Le tutoriel météo d’Earthmover raconte la même chose depuis l’autre extrémité : le modèle Aurora tient sur un processeur, ce qui bloquait n’était pas le calcul mais le gigaoctet de conditions initiales à télécharger. À chaque fois, la valeur se trouve dans l’ingénierie qui entoure le modèle, et elle se publie.
Sources
- Lancement de Muse, Meta
- Sécurité et sûreté des agents avec Muse, Meta
- Série D de Mistral
- Annonce de la Série D sur X
- Solution du problème de Navier-Stokes, OpenAI
- Fil OpenAI sur le modèle interne
- Codex et expériences de calcul quantique au MIT
- ChatGPT Images 2.5, OpenAI
- Manus intègre GPT-Image-2.5
- AlphaGenome Atlas, Google DeepMind
- CUDA Rust, NVIDIA
- AI City Challenge d’ECCV 2026, NVIDIA
- Série E de Cognition
- Fil Cognition sur X
- Partenariat Suno, Believe et TuneCore
- Megakernel de décodage, Cohere
- Réduire les coûts sur Claude Platform, Anthropic
- Claude Code 2.1.265
- Pilotage en direct de l’agent, Amp
- Muse Spark 1.3 dans Cursor
- Remplissage de formulaires dans Grok Bot
- Images clés et boucles dans Grok Imagine
- Modèles météo ouverts avec Earthmover, Hugging Face
- Sécurité pour qui, Multiverse Computing
- Connectome de mouche et câblage mélangé, Oruk
- Kinetix rejoint Runway
- Tribune de Sarah Friar, OpenAI
- Bourses de recherche sur les adolescents, OpenAI
- Boris Cherny sur le risque d’injection de prompt
- Fondateurs qui construisent sur Claude Managed Agents
- RelayShield et les fichiers d’instructions
- Ai2 à ECCV 2026
- La couche d’outils des agents, Prismberry
- Carnet de maintenance matérielle
- Gemini for Education dans le Missouri
- Dependabot et les registres GitHub privés
- Nouveau portail de support GitHub
- Spark House pendant la SF Tech Week, Genspark
- Ethan Tandowsky, directeur financier d’ElevenLabs
- Évènement MiniMax à Tokyo
- Diffusions Nemotron Labs
- Comparaison d’avatars HeyGen
- Programme journalisme d’OpenAI
- Guide sur le retour sur investissement de l’IA, Perplexity