ai-powered-markdown-translatorArticolo tradotto dal francese all’italiano con gpt-5.6-sol.
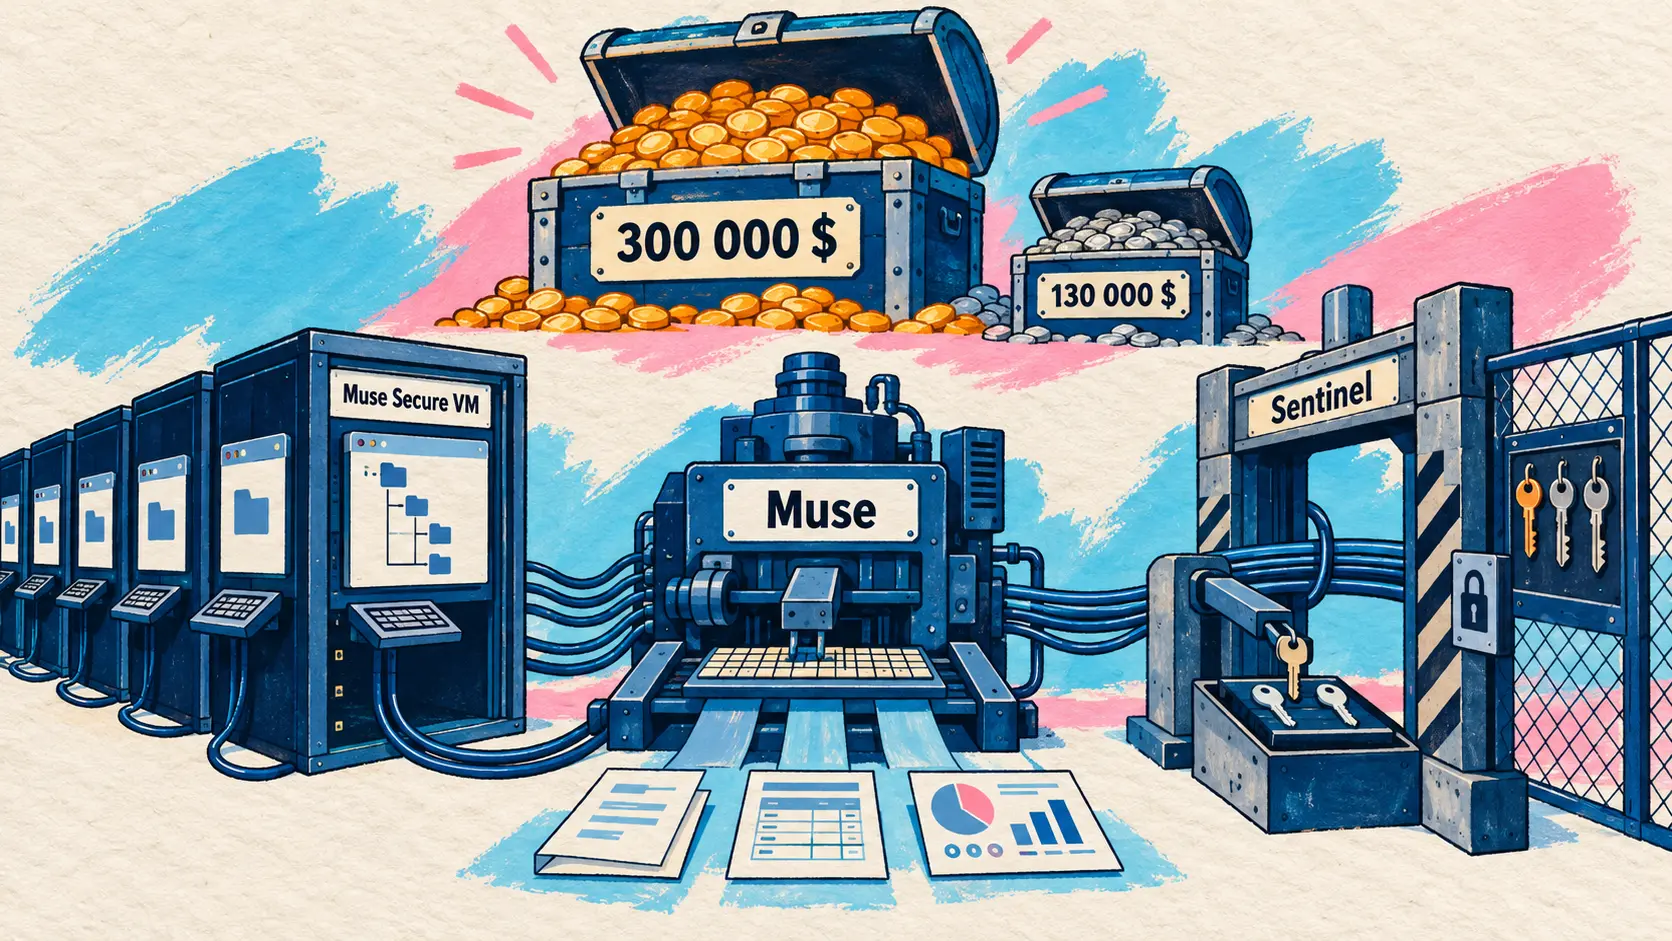
Meta lancia Muse, un agente personale che assegna a ogni utente una propria macchina Linux nel cloud, e pubblica lo stesso giorno l’architettura di sicurezza che lo circonda, con un programma di ricompense per le vulnerabilità (bug bounty) aperto a tutti fino a 300.000 dollari. Mistral annuncia un round di Serie D da 3 miliardi di euro, il più grande aumento di capitale mai concluso da un’azienda tecnologica europea. OpenAI pubblica, dal canto suo, una dimostrazione della formazione di una singolarità in tempo finito per le equazioni di Navier-Stokes, prodotta da un sistema di agenti, mentre Google DeepMind precalcola l’effetto dei 9 miliardi di possibili mutazioni del DNA umano.
Meta lancia Muse, il suo agente personale, e pubblica la sua architettura di sicurezza
8 settembre — Meta lancia Muse, un agente personale disponibile come applicazione per iOS e Android, tramite interfaccia web e in WhatsApp, basato su Muse Spark 1.3. Il modello non è nuovo: è arrivato il 2 settembre in Muse Code e nella Meta Model API, mentre il suo livello massimo di ragionamento è diventato pubblico il 4 settembre. La novità è il prodotto destinato al grande pubblico costruito intorno al modello.
L’architettura si basa su un’idea semplice da enunciare ma complessa da realizzare: ogni utente riceve il proprio computer nel cloud. Muse Secure VM è una macchina Linux persistente e isolata, dotata di file system, terminale e browser completo, con spazio di archiviazione, potenza di calcolo e memoria sufficienti per compilare codice, sviluppare skill personalizzate ed eseguire sotto-agenti in parallelo. È questa macchina, e non un’infrastruttura centralizzata di Meta, a fungere da sistema di riferimento per i dati e le credenziali dei servizi connessi. Quando manca uno strumento per svolgere un’attività, l’agente lo scrive autonomamente e produce oggetti manipolabili anziché blocchi di testo: itinerari, PDF, pagine web e dashboard, che Meta chiama Artifacts.
La seconda innovazione rivendicata è che l’agente lavora in background anche quando l’applicazione è chiusa, secondo una pianificazione e in risposta a eventi, decidendo poi se il risultato meriti una notifica. La memoria è persistente, leggibile e modificabile dall’utente, mentre una scheda Obiettivi offre una panoramica di ciò che l’agente sta monitorando. Resta ciò che Meta non dice: non è stato pubblicato alcun prezzo e il lancio non è accompagnato da un elenco dei Paesi in cui il prodotto è disponibile.
Venti minuti dopo l’annuncio del prodotto, Meta ha pubblicato un documento tecnico firmato da Tarek Sheasha, ingegnere software e vicepresidente presso Meta Superintelligence Labs, dedicato alla sicurezza di questo sistema. Il principio guida viene chiarito fin dall’inizio: il sistema è progettato partendo dal presupposto che l’agente sarà attaccato. L’agent harness, chiamato Hatch nel codice, viene eseguito in un container systemd-nspawn il cui utente root è mappato su un utente non privilegiato dell’host, con system call filtrate e funzionalità del kernel rimosse. Quattro servizi risiedono deliberatamente all’esterno del container, affinché un aggressore che comprometta l’agente non possa disattivarli: i classificatori di sicurezza, i worker con privilegi separati, il daemon per l’archiviazione delle credenziali e Sentinel.
Sentinel è il componente centrale: unica autorità in grado di autorizzare un’azione di un connettore o il traffico di rete in uscita, valuta ogni richiesta ai livelli 4 e 7 e verifica l’indirizzo effettivamente risolto. Soprattutto, l’agente gestisce soltanto token sostitutivi, che vengono rimpiazzati con le credenziali reali al confine della rete. Indurre l’agente a rivelare un segreto tramite prompt injection diventa irrilevante, perché non ne è mai stato in possesso. A ciò si aggiunge il tracciamento dei flussi a livello del kernel, il tainted egress: qualsiasi processo che legga dati dell’utente viene contrassegnato e perde l’autorizzazione automatica. L’implementazione combina programmi eBPF collegati ai cgroup e hook di Linux Security Module aggiunti da Meta.
| Elemento dell’architettura | Scelta adottata |
|---|---|
| Container dell’agent harness | systemd-nspawn, root mappato su un utente non privilegiato |
| Autorità di autorizzazione | Sentinel, fuori dal container, livelli 4 e 7 |
| Credenziali visibili all’agente | esclusivamente token sostitutivi |
| Connettore e-mail | filtraggio dei codici monouso e dei link di reimpostazione |
| Sotto-agente del browser | albero di accessibilità, nessun DOM grezzo, nessun JavaScript nella pagina |
| Pagamenti | Stripe Link al lancio, successivamente Shop Pay, carta monouso |
| Bug bounty, massimale per report valido | 300.000 dollari |
| Bug bounty, prompt injection | fino a 130.000 dollari |
Il documento è accompagnato da due annunci. Il programma di ricompense per le vulnerabilità è aperto a tutti fin dal lancio, con un massimo di 300.000 dollari per ogni report valido in base all’impatto dimostrato, di cui fino a 130.000 dollari per una prompt injection riuscita che interessi un utente. Inoltre, Muse Confidential VM, previsto entro la fine dell’anno, dovrà impedire a Meta, in modo crittograficamente verificabile, di accedere ai dati di una macchina virtuale, con progettazione e codice sorgente già sottoposti a revisori esterni. La conclusione del testo è insolitamente schietta per una pubblicazione aziendale: la prompt injection resta un problema irrisolto nel settore e Muse commetterà errori.
🔗 Lancio di Muse · 🔗 Sicurezza e protezione degli agenti, Meta
Mistral raccoglie 3 miliardi di euro, il più grande aumento di capitale della tech europea
8 settembre — Mistral annuncia un round di Serie D da 3 miliardi di euro, con una valutazione post-money superiore a 21 miliardi di euro. L’azienda presenta il round come il più grande aumento di capitale mai concluso da una società tecnologica europea, a tre anni dalla sua fondazione.
Samsung Electronics guida l’operazione. Lo Scaleup Europe Fund, gestito da EQT, e PSG Equity, già azionista, la co-guidano. Tre nuovi investitori entrano nella compagine: Advent, fondi e conti gestiti da BlackRock e il Granducato di Lussemburgo. L’elenco degli investitori esistenti è lungo e comprende tre continenti, da a16z a Salesforce Ventures, passando per ASML, BNP Paribas CIB, Bpifrance, DST Global, General Catalyst, Index Ventures, Korelya Capital, Lightspeed e NVIDIA.
Il dettaglio che merita attenzione è la natura dei due investitori capofila successivi. ASML aveva guidato la Serie C, Samsung Electronics guida la Serie D: due aziende della manifattura avanzata, non fondi tecnologici generalisti. Mistral vi legge un segnale di fiducia nella propria capacità di implementare modelli all’avanguardia all’interno di ambienti industriali complessi, nei quali il controllo dei dati e dell’infrastruttura condiziona l’adozione.
| Indicatore | Valore |
|---|---|
| Capitale raccolto | 3 miliardi di euro |
| Valutazione post-money | oltre 21 miliardi di euro |
| Età dell’azienda | 3 anni |
| Investitore capofila | Samsung Electronics |
| Co-investitori capofila | Scaleup Europe Fund gestito da EQT, PSG Equity |
| Paesi in cui opera | 20 |
| Grandi clienti aziendali | oltre 125, tra cui Airbus, ASML e HSBC |
Quanto all’impiego dei fondi, l’azienda cita innanzitutto la ricerca di frontiera, quindi l’aumento della capacità di calcolo per l’addestramento, l’espansione dell’infrastruttura e l’accelerazione commerciale a livello internazionale. L’argomentazione riprende la posizione sostenuta dall’estate: la domanda posta dalle organizzazioni non sarebbe più chi costruisce il modello più potente, bensì come sfruttare l’IA senza cedere il controllo della propria infrastruttura. Mistral si descrive come l’unica azienda del settore capace di assemblare l’intero stack necessario, dai modelli open-weight ai prodotti, passando per la capacità di calcolo.
Today marks a major step for Mistral: we’re announcing a €3B Series D, the largest equity round ever raised by a European tech company, just three years after launch.
🇮🇹 Oggi segna una tappa fondamentale per Mistral: annunciamo un round di Serie D da 3 miliardi di euro, il più grande aumento di capitale mai realizzato da un’azienda tecnologica europea, a soli tre anni dal nostro lancio. — @MistralAI su X
Gli agenti scientifici di OpenAI: una dimostrazione sulle equazioni di Navier-Stokes, qubit calibrati al MIT
8 settembre — OpenAI pubblica una dimostrazione della formazione di una singolarità in tempo finito per le equazioni tridimensionali di Navier-Stokes, accompagnata da una formalizzazione nell’assistente alla dimostrazione Lean. Il risultato annunciato è che un fluido tridimensionale inizialmente liscio e a riposo, sottoposto a una forza esterna regolare, può vedere la propria velocità crescere senza limiti in un tempo finito, sebbene la viscosità tenda a uniformare il moto e l’energia del sistema resti finita. Nella formulazione ufficiale del Clay Mathematics Institute, ciò corrisponde agli enunciati «C» e «D», quelli che costituiscono una confutazione e non una dimostrazione di regolarità.
È opportuno precisare ciò che OpenAI rivendica e ciò che non rivendica. La dimostrazione è stata prodotta da un sistema coordinato di agenti basato su un modello interno privo di un nome pubblico, descritto dall’azienda come significativamente più capace di GPT-6 Astra e il cui addestramento prosegue dal 28 agosto. L’unica verifica descritta è la formalizzazione in Lean, affidata a GPT-6 Astra e completata in 17 ore dopo la risoluzione. L’annuncio non menziona alcuna revisione tra pari né alcuna convalida da parte del Clay Mathematics Institute, e OpenAI dichiara di non avere intenzione di reclamare il premio del millennio, presentando il proprio risultato come un’istantanea anziché come un traguardo definitivo.
Il metodo è notevole almeno quanto il risultato. Il lavoro è iniziato il 1º settembre, dopo alcune indiscrezioni secondo cui due problemi del millennio sarebbero appena stati risolti. Gruppi distinti di agenti hanno ricevuto varianti diverse dell’enunciato: le versioni «A» e «B» orientate verso una dimostrazione, le versioni «C» e «D» verso una confutazione. Su un problema collaterale, la regolarità delle equazioni di Eulero non forzate, quasi 100 agenti hanno prodotto una confutazione in una cinquantina di ore; questo risultato è stato poi reinserito nei prompt degli agenti impegnati sulle equazioni di Navier-Stokes.
| Metrica | Valore |
|---|---|
| Agenti simultanei, gruppo Navier-Stokes | nell’ordine di 10.000 |
| Tempo necessario per la risoluzione | circa 88 ore |
| Formalizzazione e verifica in Lean | altre 17 ore, tramite GPT-6 Astra |
| Messaggi scambiati, Navier-Stokes | 2,7 milioni |
| Token di output, Navier-Stokes | circa 130 miliardi |
| Messaggi scambiati, tutti i problemi affrontati | 4,9 milioni |
| Token di output, tutti i problemi affrontati | circa 300 miliardi |
| Confutazione della regolarità di Eulero non forzata | quasi 100 agenti, circa 50 ore |
Un lavoro concorrente complica il quadro. Levent Alpöge, dipendente di Anthropic, e Tristan Buckmaster, professore di matematica alla NYU, disponevano di un risultato sulle equazioni di Eulero nella loro versione forzata. OpenAI li ha contattati il 6 settembre, una volta completato e verificato il proprio progetto, per proporre una pubblicazione congiunta e riconoscere la loro priorità, prima di scoprire che il loro risultato riguardava un enunciato diverso dal proprio.
This model represents a step-function improvement on many benchmarks, and its training is ongoing. Our internal model group arrived at the Navier–Stokes solution in 88 hours, using around 10,000 coordinating AI agents. Throughout the effort, we maintained the strict safeguards—including monitoring and isolation—that we apply to all our frontier evaluations.
🇮🇹 Questo modello rappresenta un miglioramento a gradini su numerosi benchmark e il suo addestramento prosegue. Il nostro gruppo di modelli interni è giunto alla soluzione delle equazioni di Navier-Stokes in 88 ore, con circa 10.000 agenti IA coordinati. Durante tutto il lavoro abbiamo mantenuto le rigorose misure di sicurezza, tra cui il monitoraggio e l’isolamento, che applichiamo a tutte le nostre valutazioni dei modelli di frontiera. — @OpenAI su X
Lo stesso giorno, OpenAI pubblica un caso di studio decisamente più modesto e molto più verificabile. Beatriz Yankelevich, dottoranda del gruppo Engineering Quantum Systems del MIT, ha collegato Codex, gestito da GPT-5.6 Sol, al software che coordina i suoi esperimenti, per calibrare un chip non calibrato con sei qubit superconduttori. Gli agenti hanno ricevuto skill specifiche per ciascun tipo di misurazione, che descrivevano come eseguirla e come valutarla. In presenza di segnali chiari, Codex ha completato un’intera sequenza con pochi interventi: identificazione delle frequenze di transizione, calibrazione degli impulsi di controllo e lettura, misurazione del tempo di conservazione dell’informazione quantistica. Con segnali deboli o rumorosi, impiega più tempo a trovare parametri utilizzabili e talvolta richiede l’occhio di un ricercatore esperto, che resta più rapido del modello. Il vantaggio, dunque, non è la velocità, ma l’assenza di una supervisione continua: la caratterizzazione di uno di questi chip standard richiede diversi giorni di lavoro a un ricercatore e il gruppo affida ormai le misurazioni di routine agli agenti.
🔗 Soluzione delle equazioni di Navier-Stokes, OpenAI · 🔗 Codex ed esperimenti quantistici, OpenAI
ChatGPT Images 2.5, con Sketch e due modelli di immagini nell’API
8 settembre — OpenAI lancia ChatGPT Images 2.5 nei suoi prodotti e nell’API. Il dato sull’utilizzo fornito in apertura chiarisce la portata: ogni settimana vengono create più di 3 miliardi di immagini su ChatGPT Images e con i modelli GPT-Image dell’API. Il miglioramento più concreto riguarda la latenza, ridotta fino al 50 per cento rispetto a Images 2.0; gli altri progressi interessano la fedeltà alle foto di riferimento e la coerenza nel corso di una conversazione lunga, in cui le modifiche precedenti vengono preservate meglio.
Tre funzionalità arrivano su ChatGPT. Sketch consente di disegnare direttamente nella conversazione per fornire una guida visiva, digitando «@Sketch». I template coprono i formati più comuni, dai poster al merchandising. È possibile inserire commenti sull’immagine per indicare con precisione un ritocco. La condivisione di un’immagine può ora includere il prompt che l’ha generata. Il rilascio riguarda tutti gli utenti di ChatGPT, ChatGPT Work e Codex, su desktop, mobile e web, per tutti i piani.
| Modello nell’API | Posizionamento dichiarato | Latenza |
|---|---|---|
| GPT-Image-2.5 Flare | scelta predefinita, contenuti social, generazione in volume | fino al 50 per cento in meno rispetto a Images 2.0 |
| GPT-Image-2.5 Sunburst | precisione, campagne pronte per la pubblicazione | tempi di generazione più lunghi |
Entrambi i modelli supportano le nuove impostazioni di qualità xhigh e max e mantengono le tariffe per i token di GPT Image 2: nel piano Standard, 8,00 dollari per milione di token di input immagine, 30,00 dollari per l’output immagine e 5,00 dollari per l’input testuale. I metadati C2PA e il watermark invisibile vengono mantenuti e una system card accompagna il rilascio.
Manus integra il modello il giorno stesso
Manus aggiunge GPT-Image-2.5 alla propria piattaforma la sera dell’annuncio, citando il messaggio di OpenAI pubblicato un’ora e mezza prima. Il laboratorio di agenti, tornato indipendente il 1° settembre, presenta un dato ricavato dalle proprie valutazioni e non da quelle di OpenAI: il modello che chiama Flare produce immagini di alta qualità a una velocità da due a quattro volte superiore rispetto a GPT-Image-2. Per un agente che genera contenuti visivi nel corso di una conversazione, questo fattore conta più di un miglioramento marginale della qualità, poiché determina se la generazione resta integrata nel flusso di lavoro o impone un’attesa. Manus evidenzia inoltre una migliore generazione degli sfondi trasparenti, che evita la fase di scontorno manuale, incompatibile con un’automazione completa.
AlphaGenome Atlas, la mappa predittiva dei 9 miliardi di mutazioni del DNA umano
8 settembre — Google DeepMind lancia AlphaGenome Atlas, un database che predice l’effetto molecolare di ogni possibile mutazione di una singola lettera nel DNA umano. Il genoma umano contiene circa 3 miliardi di coppie di basi, delle quali solo il 2 per cento codifica proteine; il restante 98 per cento rimane in gran parte inesplorato, sebbene la modifica di una sola lettera possa disattivare un regolatore biologico essenziale.
Il metodo consiste in un’inversione del carico di lavoro. Anziché lasciare che ogni laboratorio interroghi il modello variante per variante, Google DeepMind ha precalcolato le previsioni del modello AlphaGenome per tutti i 9 miliardi di sostituzioni possibili. Il risultato è un dataset da 1 petabyte, descritto come oltre trenta volte più grande dell’AlphaFold Database. Per rendere utilizzabile questo volume, l’Atlas introduce il punteggio AVI (AlphaGenome Variant Impact), un singolo numero che aggrega le previsioni sulle regioni codificanti e non codificanti e indica quali processi biologici vengono alterati da una variante, con attribuzioni per caratteristica. A ciò si aggiunge un catalogo di oltre 2.500 motivi di sequenza ricorrenti, le unità regolatrici che Google descrive come le «parole» del genoma.
| Metrica | Valore |
|---|---|
| Varianti precalcolate | 9 miliardi, tutte le modifiche di una lettera |
| Dimensione del dataset | 1 petabyte, oltre 30 volte l’AlphaFold Database |
| Motivi di sequenza catalogati | più di 2.500 |
| Partecipanti della UK Biobank analizzati | più di 54.000 |
| Associazioni non codificanti aggiuntive | più 22 per cento |
| Regioni genetiche legate all’IMC identificate | 19 |
Due applicazioni documentate mostrano l’entità del vantaggio. Al Broad Institute, Laura Covill e il suo team hanno utilizzato il punteggio AVI per stabilire la priorità delle varianti candidate in casi di malattie rare rimasti senza diagnosi: lo strumento ha evidenziato una variante del gene DNM1, prevedendo che creasse un sito di splicing errato, e ha così fornito l’elemento decisivo per risolvere il caso. Alla University of Exeter, Gareth Hawkes ha applicato l’Atlas ai dati di oltre 54.000 partecipanti della UK Biobank, ottenendo il 22 per cento di associazioni genetiche non codificanti aggiuntive, e ha poi identificato 19 regioni genetiche legate all’indice di massa corporea limitandosi all’1 per cento delle varianti con maggiore impatto.
L’accesso è il secondo aspetto degno di nota. L’Atlas è disponibile tramite un portale web che non richiede la scrittura di codice, destinato ai medici e ai biologi che non programmano, ma anche attraverso l’API AlphaGenome e su Cloud tramite Model Garden, mentre i dati di ricerca sono pubblicati su GitHub. Un dettaglio interessante per gli sviluppatori che seguono l’ecosistema agentico di Google: l’Atlas viene distribuito anche come competenza (skill) in Google Antigravity e può quindi essere utilizzato direttamente da un agente di coding.
🔗 AlphaGenome Atlas, Google DeepMind
NVIDIA lancia CUDA Rust e Cosmos domina l’AI City Challenge dell’ECCV
8 settembre — NVIDIA pubblica CUDA Rust, la sua risposta a una lacuna divenuta evidente: il livello di sistema dell’AI viene scritto sempre più spesso in Rust, ma il kernel GPU restava un’eccezione. Era già possibile avviare un kernel da Rust, ma bisognava scriverlo altrove. CUDA Rust colma questa distanza compilando nativamente i kernel Rust in PTX, attraverso due percorsi distinti allineati ai due modelli di programmazione che CUDA offre già in C++ e Python.
| Elemento | cuda-oxide, percorso SIMT | cutile-rs, percorso Tile |
|---|---|---|
| Maturità | alpha iniziale | pubblicato su crates.io |
| Toolchain Rust richiesta | nightly bloccata (nightly-2026-04-03) | stable 1.89 o successiva |
| Versione di CUDA | 12.x o successiva | 13.3 |
| LLVM da fornire | sì, oltre a clang e libclang | no |
| Compilazione | in PTX durante la build | JIT tramite CUDA Tile IR |
| Utilizzi esterni menzionati | nessuno | Grout di Hugging Face, mistral.rs |
La raccomandazione di NVIDIA è esplicita: iniziare da Tile, perché in questo modo il codice sorgente non incorpora alcuna scelta specifica di un’architettura, e passare a SIMT quando diventa necessario un controllo dettagliato dei thread e della memoria. Oggi questo compromesso ha un costo, poiché in SIMT la memoria condivisa, fondamento dei kernel veloci, richiede ancora unsafe. L’argomento centrale è la sicurezza della memoria in fase di compilazione: entrambi i percorsi impediscono il classico aliasing in cui un buffer viene usato contemporaneamente come input e output, con error[E0502] sul versante SIMT e error[E0382] su quello Tile. Quanto alla maturità, NVIDIA non esagera: nessuno dei due progetti è pronto per la produzione e l’impegno dichiarato riguarda il 2027 e gli anni successivi, con un lavoro congiunto con i manutentori di rust-cuda.
Lo stesso giorno, NVIDIA pubblica i risultati dell’AI City Challenge dell’ECCV 2026. Nella traccia 5, dedicata alla previsione video generativa delle scene di traffico, quattro delle cinque migliori soluzioni utilizzano versioni dei modelli fondazionali del mondo Cosmos. Il team Qyn vince la classifica pubblica con CosmosAlign, che adatta il modello congelato Cosmos3-Nano da 16 miliardi di parametri attraverso una procedura LoRA in due fasi, genera quattro previsioni, seleziona il medoide e reinserisce le regioni stabili della cronologia osservata: 76,39 contro 76,04 del team SSUPER, con un vantaggio di 0,35 punti. NVIDIA precisa che si tratta di una procedura di adattamento e inferenza, non di una nuova architettura. Cosmos compare anche nel ruolo di giudice: in entrambe le classifiche fuori dominio della traccia 3, il team UWIPL_ETRI vince con UniTraffic, che fa verificare le affermazioni controverse da un verificatore Cosmos-Reason1 indipendente.
🔗 CUDA Rust, NVIDIA · 🔗 Risultati dell’AI City Challenge
Cognition raccoglie più di 2 miliardi di dollari e raggiunge una valutazione di 48 miliardi
8 settembre — Cognition, l’azienda che sviluppa l’agente di sviluppo Devin, annuncia un finanziamento di oltre 2 miliardi di dollari con una valutazione di 48 miliardi. Il round è guidato da due nuovi investitori, Andreessen Horowitz e Accel, insieme agli investitori già presenti Founders Fund, General Catalyst e Avenir. Una trentina di partecipanti completano il gruppo, tra cui NVIDIA, Benchmark, Bessemer, Kleiner Perkins, Greylock, Lightspeed, T. Rowe Price e Bain Capital Ventures.
| Indicatore | Maggio 2026 | Settembre 2026 |
|---|---|---|
| Capitale raccolto, totale del round | più di 1 miliardo di dollari | più di 2 miliardi |
| Valutazione | 26 miliardi di dollari | 48 miliardi |
| Fatturato annualizzato | 492 milioni di dollari | quasi 900 milioni |
| Investitori principali | Lux Capital, General Catalyst, 8VC | Andreessen Horowitz, Accel |
La valutazione è quindi quasi raddoppiata in quattro mesi ed è aumentata di quasi cinque volte in un anno, con un fatturato annualizzato che segue la stessa traiettoria. Cognition descrive nel dettaglio gli utilizzi che alimentano questa crescita: Devin lavora alla progettazione di chip presso NVIDIA, nel settore aeronautico presso GE Aerospace, nei servizi finanziari presso Citi, nel settore automobilistico presso Mercedes-Benz e nell’infrastruttura AI presso Modal. Il fatto che NVIDIA sia al tempo stesso cliente e investitore del round illustra il modo in cui queste aziende si assicurano l’accesso agli strumenti che utilizzano internamente. Tre funzionalità recenti spostano Devin dall’esecuzione di attività all’azione autonoma: Auto-Triage per la prima fase di analisi degli incidenti, Security Swarm per la classificazione delle vulnerabilità e Automations, attivato da eventi di Slack, GitHub o Linear. In un anno sono stati aperti sei uffici, cinque dei quali fuori dagli Stati Uniti, oltre alle sedi di San Francisco, New York e Austin.
In the next chapter of software engineering, agents will become proactive by default, software will improve itself, and compute will automatically get allocated toward the highest impact use cases. We’re still at the dawn of the self-driving software era.
🇮🇹 Nel prossimo capitolo dell’ingegneria del software, gli agenti diventeranno proattivi per impostazione predefinita, il software migliorerà autonomamente e la potenza di calcolo verrà assegnata automaticamente agli utilizzi con il maggiore impatto. Siamo ancora agli albori dell’era del software autonomo. — @cognition su X
Suno firma con Believe e TuneCore, che fino a ieri rifiutavano di distribuire la sua musica
8 settembre — Suno annuncia una partnership strategica globale con Believe, società di sviluppo degli artisti, e con la sua piattaforma di autodistribuzione TuneCore. L’accordo riguarda due aspetti distinti. In primo luogo, Believe partecipa alla progettazione dei nuovi modelli musicali che Suno sta sviluppando insieme all’industria. In secondo luogo, ed è l’aspetto concreto per gli utenti, i brani creati con questo nuovo modello sviluppato in partnership diventeranno idonei alla distribuzione tramite Believe e TuneCore, e quindi su Spotify, Apple Music, Amazon Music e YouTube.
Il contesto mostra la portata dell’annuncio. Suno ricorda apertamente che, all’inizio di quest’anno, Believe e TuneCore avevano annunciato che non avrebbero distribuito musica prodotta con modelli che non soddisfacevano i loro criteri, compresi quelli di Suno dell’epoca. L’inversione di rotta viene presentata come il risultato di discussioni che hanno fatto emergere valori comuni: offrire agli artisti scelte reali e aprire nuove possibilità di distribuzione e guadagno.
L’accordo si inserisce in una sequenza coerente. Prosegue Spark, il programma di Suno destinato agli artisti indipendenti ed emergenti, e completa gli accordi già esistenti con Warner Music Group e BMG, aggiungendo etichette indipendenti e artisti autoprodotti. Suno lo collega inoltre esplicitamente alle sue recenti misure di protezione: il watermark audio e l’impronta acustica destinati a identificare i suoi brani fuori dalla piattaforma, nonché i limiti di download entrati in vigore il 3 settembre per impedire la distribuzione di massa verso i servizi di streaming. Queste protezioni si applicheranno alla musica distribuita da Believe e TuneCore. L’annuncio si conclude con una tempistica: Suno prevede di lanciare molto presto i suoi nuovi modelli, la cui famiglia era stata denominata v6 il 4 settembre.
🔗 Partnership con Believe, Suno
Cohere apre un motore di serving basato su un megakernel, 1,58 volte più veloce di vLLM
8 settembre — Cohere pubblica un motore di serving per l’inferenza interamente costruito attorno a un megakernel di decodifica, con licenza Apache 2.0. L’azienda rivendica una novità assoluta: non una dimostrazione di velocità in laboratorio, ma un server completo capace di elaborare richieste reali dietro un endpoint compatibile con OpenAI, con batching continuo, paged attention, cache dei prefissi e chiamata di strumenti. Il modello servito è North Mini Code, un mixture of experts da 30 miliardi di parametri, dei quali solo 3,3 miliardi sono attivi per token.
Il problema affrontato si riassume in una frase: durante la decodifica, la GPU trascorre molto tempo ad aspettare anziché calcolare. Uno stack classico avvia un kernel per operazione e ogni confine tra kernel impone una barriera sull’intera griglia di calcolo. Tuttavia, la decodifica autoregressiva è limitata dalla larghezza di banda della memoria: a ogni passaggio, North Mini Code trasferisce 6,6 GB di pesi dalla memoria HBM, più circa 0,5 GB di cache chiave-valore con un contesto di 8K, collocando il limite teorico attorno a 470 token al secondo sui 3,35 TB/s di una H100. Un megakernel elimina questi confini avviando un unico kernel persistente che rimane residente per l’intero passaggio di decodifica, con dipendenze ridotte a contatori nella memoria globale.
| Misura | Megakernel | vLLM v0.24 | Incremento |
|---|---|---|---|
| Decodifica, batch size 1, contesto 8K (tok/s) | 292 | 185 | 1,58x |
| AIME 2025, end-to-end (tok/s) | 935 | 661 | 1,41x |
| SciCode, end-to-end (tok/s) | 711 | 560 | 1,37x |
| MMLU-Pro, sottoinsieme informatico (tok/s) | 948 | 713 | 1,33x |
| LiveCodeBench v6, end-to-end (tok/s) | 803 | 625 | 1,28x |
| GPQA, end-to-end (tok/s) | 787 | 631 | 1,25x |
I 292 token al secondo con batch size 1 rappresentano il 62 per cento del limite teorico, contro il 39 per cento di vLLM. La qualità non cambia: 38,9 per cento contro 38,2 su SciCode, 70,3 per cento per entrambi su LiveCodeBench v6, come medie di sette esecuzioni. Un dettaglio merita attenzione: il vantaggio dipende dalla distribuzione degli esperti, con 1,32x usando il routing reale del modello contro 1,14x con un routing uniforme simulato, il che rende le misurazioni uniformi il caso sfavorevole. Cohere insiste infine su un punto controintuitivo: scrivere un megakernel sarebbe più semplice di quanto lasci supporre la sua reputazione, con un unico file CUDA nel quale sedici codici operativi coprono l’intero passaggio di decodifica. I limiti sono dichiarati e definiti limiti di implementazione: solo decodifica, mentre il prefill viene ancora eseguito con normali kernel PyTorch, esclusivamente H100 e BF16, batch size da 1 a 8.
Anthropic documenta come ridurre i costi di Claude Platform senza perdere prestazioni
8 settembre — Anthropic pubblica una guida ingegneristica che contesta l’idea diffusa secondo cui ridurre i costi di un agente significhi accettare risultati peggiori. Vengono documentate tre leve: massimizzare il tasso di successo della prompt cache, eliminare gli anti-pattern dei prompt durante il passaggio a un frontier model e calibrare l’effort in base al compito. Il metodo viene fornito sotto forma di comandi eseguibili in Claude Code, con /claude-api prompt-audit e /claude-api hillclimb che si aggiungono a /claude-api cost-optimize.
| Benchmark, baseline Sonnet 5 | Riduzione dei costi | Dettaglio misurato |
|---|---|---|
| LegalBench | circa 58 per cento | token di ragionamento da 102 779 a 8 284 |
| tau2-bench retail | circa 73 per cento | prompt cache con punti di interruzione espliciti |
| OfficeQA Pro | circa 52 per cento | da 136,20 a 64,87 dollari |
| SWE-bench Verified | circa 55 per cento | passaggi mediani da 29 a 17, token di prompt più che dimezzati |
Il dato più immediatamente utilizzabile non compare in questa tabella. Su CursorBench 3.2, Claude Fable 5.1 con effort low eguaglia Fable 5 con effort high a un terzo del costo, in parte grazie alla tariffa delle letture dalla cache, fatturate 0,25 dollari per milione di token contro 1,00 dollaro in precedenza. Al contrario, su Humanity’s Last Exam senza strumenti, l’ultimo livello di effort permette di guadagnare circa mezzo punto a fronte di un aumento dei costi del 46 per cento, un miglioramento sommerso dal rumore del benchmark.
🔗 Ridurre i costi su Claude Platform
Claude Code 2.1.265: cartelle di plugin, limite di 1 GB e riparazione della prompt cache
8 settembre — Claude Code passa alla versione 2.1.265 con cinquanta voci nel changelog, tra cui trentaquattro correzioni, due giorni dopo una versione 2.1.263 che ne conteneva soltanto una. L’opzione --plugin-dir ora accetta un’intera cartella di plugin: viene caricata ogni sottocartella dotata di manifest e vengono rilevate le aggiunte e le rimozioni effettuate durante l’esecuzione. Ai risultati degli strumenti scritti su disco si applica un limite di 1 GB e l’anteprima segnala quando un file è stato troncato.
La parte più corposa riguarda la prompt cache, in linea con la guida pubblicata lo stesso giorno. Due correzioni distinte risolvono casi nei quali Claude Code comprometteva autonomamente il riutilizzo della cache: la ripresa di un sub-agent avviato in primo piano modificava il suo elenco di strumenti e il prefisso del prompt di sistema, mentre i compagni degli agenti e i sub-agent ripresi spostavano fuori dal prefisso il contesto degli hook SubagentStart e le skill precaricate. Due correzioni riguardano la sicurezza: un percorso di plugin contenente una barra rovesciata aggirava la verifica di confinamento dei link simbolici su macOS e Linux, mentre su Windows gli strumenti di lettura e scrittura rifiutavano qualsiasi file all’interno di un AppContainer o di una sandbox con token limitato. La lettura di un artifact scritto da terzi viene ora trattata come contenuto non attendibile.
Amp sostituisce la coda dei messaggi con il controllo in tempo reale
8 settembre — Amp modifica il comportamento predefinito del proprio agente nei confronti dei messaggi inviati mentre è al lavoro. Finora, un messaggio digitato durante l’esecuzione dell’agente veniva messo in coda ed elaborato soltanto al termine del turno; ora viene consegnato alla prima occasione possibile. L’azienda indica due vantaggi: l’agente tiene conto prima del feedback e smette di avviare passaggi di verifica resi inutili dalla nuova istruzione, risparmiando tempo e token nel caso comune in cui ci si accorga che l’agente sta procedendo nella direzione sbagliata.
La modifica non è priva di effetti collaterali e Amp li documenta. Se il controllo si rivela troppo brusco, l’azienda consiglia di formulare le richieste con «When done, then…» anziché «Now, …», per indicare esplicitamente che l’istruzione va applicata dopo il compito in corso. Ship, Review e le altre azioni integrate mantengono il comportamento precedente e restano in coda, poiché generalmente si desidera che il lavoro sia terminato prima di consegnarlo o avviare una revisione. L’inserimento manuale in coda rimane disponibile sia nell’applicazione sia nella CLI.
🔗 Controlla, non accodare, Amp
Muse Spark 1.3 arriva in Cursor con il miglior rapporto punteggio-costo di CursorBench
8 settembre — Cursor aggiunge Muse Spark 1.3, il modello agentico di Meta Superintelligence Labs, sei giorni dopo la sua presentazione. I dati pubblicati non raccontano una storia di prestazioni assolute, bensì di costi. Su CursorBench 3.2, il benchmark interno costruito a partire da attività reali su più file, il livello Max ottiene il 67,9 per cento con un costo di 1,31 dollari per attività e si classifica dodicesimo.
| Modello e livello | Punteggio CursorBench 3.2 | Costo per attività, in dollari | Token per attività | Posizione |
|---|---|---|---|---|
| Fable 5.1 Max | 73,4 per cento | 9,64 | 72 060 | 1 |
| Grok 4.6 Extra High | 70,8 per cento | 2,81 | 41 136 | 3 |
| Opus 5 Max | 70,0 per cento | 8,23 | 61 838 | 5 |
| Gemini 3.8 Flash High | 69,2 per cento | 2,38 | 81 524 | 9 |
| Muse Spark 1.3 Max | 67,9 per cento | 1,31 | 33 034 | 12 |
| GPT-5.6 Sol Max | 67,2 per cento | 5,69 | 28 320 | 13 |
| Muse Spark 1.3 Low | 55,0 per cento | 0,45 | 12 181 | 49 |
Il modello di Meta si colloca quindi molto indietro rispetto a Claude Fable 5.1 Max nel punteggio, ma quest’ultimo costa oltre sette volte di più per attività. Soprattutto, supera GPT-5.6 Sol nel livello Max costando più di quattro volte meno. Cursor mantiene il proprio metodo, che consiste nel pubblicare sistematicamente il punteggio e il costo per attività di ogni modello aggiunto, anziché limitarsi ad annunciarne la disponibilità.
Grok Bot consente di compilare moduli e credenziali dalla chat, Grok Imagine ottiene il controllo tramite fotogrammi chiave
8 settembre — SpaceXAI consente ora di compilare moduli e pagine di accesso per il proprio Grok Bot senza abbandonare la conversazione, con supporto dichiarato per qualsiasi password manager. La funzione affronta un punto critico specifico degli agenti persistenti: non appena l’agente deve superare una schermata di accesso o inviare un modulo contenente informazioni personali, necessita di credenziali memorizzate oppure dell’intervento dell’utente. Portare questo passaggio nel thread della conversazione anziché in una sessione separata del browser è una scelta tanto ergonomica quanto di sicurezza.
Due ore più tardi, Grok Imagine ottiene il controllo delle immagini iniziali e finali di una scena video, oltre alla generazione di loop senza interruzioni, con un migliore rispetto delle istruzioni e una qualità video dichiarata superiore. Il controllo tramite fotogrammi chiave cambia la natura dello strumento per chi produce inquadrature successive: fissare l’ultima immagine di un’inquadratura permette di riutilizzarla come prima immagine della successiva, concatenando così sequenze la cui continuità non dipende più dalla casualità della generazione. L’annuncio arriva tre giorni dopo il lancio dell’agente Grok Imagine Video 1.5, basato sul modello Image 2.0.
🔗 Compilazione di moduli in Grok Bot · 🔗 Fotogrammi chiave in Grok Imagine
Tre articoli di ricerca sul blog di Hugging Face
8 settembre — Tre pubblicazioni della comunità di Hugging Face meritano di essere lette nello stesso giorno e riguardano meteorologia, sicurezza dei modelli e modelli ispirati agli organismi viventi.
Eseguire un modello meteorologico aperto senza GPU
Hugging Face ed Earthmover pubblicano un articolo congiunto su un problema affrontato di rado: i modelli meteorologici basati sul machine learning sono abbastanza leggeri da funzionare su un computer portatile, eppure quasi nessuno li esegue. Vengono identificati tre ostacoli: il calcolo (diversi modelli, tra cui AIFS, dipendono dalla flash attention, limitata a determinate architetture di schede grafiche), lo spazio di archiviazione e soprattutto la larghezza di banda, con circa 1 GB di condizioni iniziali per previsione. La risposta consiste in tre artifact pubblici: uno spazio dimostrativo, un bucket di archiviazione e un tutorial riproducibile che esegue Aurora, il modello di Microsoft, nella versione pre-addestrata a 0,25 gradi, con condizioni iniziali ERA5 fornite dal marketplace di dati Earthmover. Non è richiesta alcuna GPU: da due a tre minuti per passaggio di calcolo su CPU, pochi secondi su scheda grafica e quattro passaggi da sei ore per una previsione a ventiquattro ore, successivamente confrontata con ERA5.
🔗 Modelli meteorologici aperti con Earthmover
Un modello considerato più sicuro che rifiuta tre quarti delle domande innocue
Multiverse Computing pubblica un risultato che dovrebbe circolare ben oltre la ricerca sull’allineamento. Addestrando Qwen3-8B a rifiutare le richieste di manipolazione politica, il team ottiene dati che sembrano indicare una vittoria netta: il tasso medio di risposte pericolose su HarmBench, StrongREJECT e WildJailbreak scende dal 26,26 allo 0,14 per cento. Allo stesso checkpoint, l’over-refusal su XSTest sale dal 2,00 al 74,00 per cento. In altre parole, la configurazione più sicura sulla carta è una macchina che rifiuta e nulla nelle metriche abituali permette di accorgersene. Due correzioni risolvono il problema: sostituire le risposte esterne di conformità con risposte verificate del modello target riduce l’over-refusal su XSTest dal 15,20 al 5,20 per cento, mentre l’aggiunta di coppie benign boundary riduce l’over-refusal sul lato da soddisfare dal 32,94 al 4,16 per cento, mentre il rifiuto sul lato dannoso perde soltanto quattro punti.
🔗 Sicurezza per chi, Multiverse Computing
Un connectome di mosca non supera il proprio cablaggio mescolato
Oruk pubblica una lezione metodologica valida ben oltre i modelli ispirati ai connectome. Il team ha copiato 499 neuroni fortemente connessi dalla ricostruzione pubblica MaleCNS di una mosca in una rete ricorrente usata come reservoir, con un unico readout ridge addestrato al di sopra. Il cablaggio della mosca ottiene una precisione media al test del 16,84 per cento, mentre un cablaggio mescolato raggiunge il 16,88 per cento: la differenza è di meno 0,04 punti, con un intervallo di confidenza che attraversa lo zero. Il secondo esperimento avrebbe potuto sembrare una prova del contrario, poiché rimuovere i 50 neuroni con le norme più elevate dei pesi di readout fa scendere la precisione dal 16,91 al 10,83 per cento. Gli autori spiegano perché non vi sia contraddizione: un’ablazione spettacolare non dimostra mai che una topologia biologica fosse necessaria. Va segnalato che l’articolo stesso dichiara di essere stato preparato da un agente IA a partire da un paper non sottoposto a peer review e che il dataset completo di valutazione resta privato.
🔗 Connectome e cablaggio mescolato, Oruk
Runway assume il team del laboratorio parigino Kinetix
8 settembre — Runway annuncia l’ingresso del team di Kinetix, laboratorio di ricerca sull’IA con sede a Parigi. Il laboratorio lavorava sul movimento umano in 3D e sulla generazione video ancorata alla fisica, due temi che Runway collega direttamente alla propria ricerca sui world model applicati alla robotica. Il team entra a far parte della sede parigina dell’azienda, che sta inoltre assumendo personale locale nei settori della ricerca e dell’ingegneria.
L’argomentazione tecnica si riassume in una frase dell’annuncio: un robot realmente utile deve comprendere e gestire ambienti, compiti e situazioni inediti e, secondo Runway, il pre-addestramento video su larga scala offre la strada più efficace per risolvere questi problemi di generalizzazione. È la prosecuzione diretta di Solaris, presentato il 31 agosto, e di GWM Worlds 2, presentato il 3 settembre: dopo aver insegnato ai modelli a simulare il mondo, Runway vuole insegnare loro ad agire al suo interno. Yassine Tahi, amministratore delegato di Kinetix, colloca la scommessa fondante del laboratorio sei anni fa. Non vengono comunicati né l’importo né la struttura dell’operazione.
Sarah Friar quantifica la scala di OpenAI e l’effetto dei suoi modelli sui costi
8 settembre — Sarah Friar pubblica un editoriale su come OpenAI converte i propri progressi nella ricerca in attività economica. L’interesse del testo risiede in tre dati inediti più che nelle sue argomentazioni.
| Indicatore | Valore |
|---|---|
| Utenti attivi settimanali | più di un miliardo |
| Aziende clienti | 2,5 milioni |
| Messaggi quotidiani dopo sei mesi, piani individuali | circa il 50 per cento in più rispetto al primo mese |
| Attività distinte provate dopo sei mesi | circa il doppio |
| Costi di servizio end-to-end dopo l’ottimizzazione | meno 20 per cento |
| Efficienza nella generazione di token | più del 15 per cento |
Il terzo dato chiude un cerchio interessante. GPT-5.6 Sol è stato utilizzato per migliorare il software di servizio in produzione di OpenAI, ottenendo una riduzione del 20 per cento dei costi di servizio, alla quale si aggiunge un incremento di oltre il 15 per cento dell’efficienza nella generazione di token. In altre parole, il modello finanzia una parte della propria infrastruttura ottimizzando il livello che lo eroga. L’andamento dell’utilizzo individuale risponde inoltre a una domanda posta spesso e raramente documentata: quella della fidelizzazione.
🔗 Il lavoro ora a portata di mano, OpenAI
OpenAI stanzia 5 milioni di dollari per la ricerca indipendente sugli adolescenti
8 settembre — OpenAI apre un programma di sovvenzioni da 5 milioni di dollari destinato alla ricerca indipendente sugli effetti dell’IA generativa tra i giovani dai 13 ai 17 anni, con un’attenzione esplicita allo sviluppo sociale ed emotivo. Le singole sovvenzioni arrivano fino a 1 milione di dollari per progetto. Le candidature si chiudono il 6 ottobre 2026, i progetti selezionati saranno notificati entro il 13 novembre 2026, un aggiornamento sullo stato di avanzamento è previsto nel primo trimestre del 2027 e i costi generali sono limitati al 10 per cento per sovvenzione.
Due dettagli meritano di essere sottolineati. Il primo riguarda l’indipendenza dichiarata: tra i criteri di valutazione figura la capacità del progetto di produrre risultati affidabili, indipendentemente dal fatto che siano favorevoli o meno ai fornitori di prodotti di IA, e la pubblicazione è incoraggiata senza costituire una condizione per il finanziamento. Il secondo è amministrativo ma rilevante, poiché le sovvenzioni sono finanziate e gestite da OpenAI Group PBC, l’entità commerciale, e non dalla OpenAI Foundation. La tempistica non è neutrale: il 31 agosto OpenAI aveva sostenuto il disegno di legge californiano sulla sicurezza dei minori di fronte all’IA e l’articolo afferma di voler contribuire alle decisioni delle autorità di regolamentazione.
🔗 Sovvenzioni per la ricerca sugli adolescenti
In breve
- Boris Cherny valuta pubblicamente gli altri laboratori sul rischio di prompt injection — il creatore di Claude Code colloca il nuovo modello di OpenAI allo stesso livello di Gemini Flash e Opus 4.8 per quanto riguarda la prompt injection e dichiara di essere disposto a nominare pubblicamente i laboratori finché non prenderanno più seriamente la sicurezza. Circa venti minuti dopo attenua i toni in una risposta al proprio thread. 🔗 Pubblicazione
- Anthropic pubblica un video di fondatori che sviluppano su Claude Managed Agents — interviste ai fondatori di Wispr Flow, Actively e Pendo sull’uso di outcomes, sandbox e memoria per passare su larga scala. 🔗 Pubblicazione
- RelayShield analizza i file di istruzioni anziché il codice dei repository — servizio a pagamento che legge AGENTS.md, CLAUDE.md, .cursorrules e mcp.json per rilevare istruzioni ostili in linguaggio naturale che l’analisi statica non individua. Un dato sui repository dannosi citato nell’articolo non coincide con la sua stessa fonte. 🔗 Articolo
- Ai2 annuncia la propria presenza a ECCV 2026 — articoli e interventi distribuiti nel corso della conferenza, senza titoli né programma comunicati. 🔗 Pubblicazione
- Prismberry pubblica un saggio sul livello degli strumenti degli agenti aziendali — testo di posizionamento che distingue tra strumenti di informazione, analisi e azione, senza annunci né misurazioni, e che promuove il prodotto Agent IQ del suo editore. 🔗 Articolo
- Un diario di manutenzione hardware pubblicato sul blog di Hugging Face — diagnosi dell’usura di un cuscinetto nella ventola di un alimentatore da 650 W, senza contenuti relativi all’intelligenza artificiale. 🔗 Articolo
- Il Missouri apre Gemini for Education a 1,1 milioni di alunni e studenti — partnership a livello statale che offre a quasi 100.000 insegnanti e a più di 1,1 milioni di alunni e studenti l’accesso gratuito a Gemini for Education, Gemini Notebook e alle certificazioni Google, con i dati esclusi dall’addestramento e l’adozione lasciata alla scelta di ciascun istituto. 🔗 Annuncio
- Dependabot legge i registri GitHub privati senza token personale — il
GITHUB_TOKENdi Dependabot può richiedere l’autorizzazionepackages: readed effettuare il pull dai registri privati di GitHub Packages. La funzionalità, rilasciata e poi ritirata a giugno, ritorna con le credenziali automatiche ridotte a soluzione di ripiego. 🔗 Changelog - Il portale di supporto di GitHub si trasferisce su help.github.com — supporto, documentazione, formazione, comunità e risorse dell’account riuniti nello stesso luogo, con una ricerca basata su Copilot che non richiede l’accesso. 🔗 Changelog
- Genspark apre Spark House durante la SF Tech Week con accesso anticipato a GenTeam — iniziativa per la comunità che offre ai partecipanti l’accesso anticipato a GenTeam e a conversazioni private tra fondatori e investitori. 🔗 Pubblicazione
- Ethan Tandowsky diventa direttore finanziario di ElevenLabs — seconda nomina dirigenziale in sei giorni presso ElevenLabs, dopo quella di Ashley Kramer a direttrice dei ricavi il 2 settembre. 🔗 Pubblicazione
- MiniMax riunisce a Tokyo le voci giapponesi dell’intrattenimento e quattro protagonisti dell’IA generativa — evento dell’11 settembre a Shibuya con il produttore Yasushi Akimoto, KADOKAWA, KAGAMIAI, Higgsfield, Krea, Runway e HeyGen, senza lanci né dati. 🔗 Pubblicazione
- Due dirette di Nemotron Labs nello stesso giorno, su OpenShell e Domyn — 49 minuti e 44 secondi sulla messa in sicurezza degli agenti autonomi tramite OpenShell, 54 minuti e 20 secondi sull’uso di Nemotron da parte di Domyn, senza testo descrittivo né trascrizione. 🔗 Pubblicazione
- HeyGen mette a confronto due avatar dello stesso volto senza nominare alcuno strumento o modello — confronto di marketing senza indicare uno strumento concorrente, citare un modello o fornire misurazioni. 🔗 Pubblicazione
- OpenAI estende il proprio programma di giornalismo alle scuole di giornalismo — più di 400 abbonamenti ChatGPT Edu per gli studenti di master e i docenti della Newmark J-School di CUNY e della Medill School di Northwestern, per il 2026-2027. 🔗 Annuncio
- Perplexity pubblica una guida sul ritorno sull’investimento dell’integrazione dell’IA — articolo didattico senza annunci di prodotto, nel quale tutti i dati provengono da terze parti o da testimonianze di clienti. 🔗 Articolo
Che cosa significa
L’agente personale diventa un prodotto infrastrutturale e la sua sicurezza diventa un prodotto a sé stante. Meta non si limita a distribuire Muse: pubblica lo stesso giorno la descrizione finora più dettagliata di come contenere un agente dotato di shell, browser e accesso a una casella di posta elettronica. La scelta più istruttiva è quella dei token sostitutivi, che rende irrilevante la prompt injection ai fini del furto di credenziali, non perché il modello resista meglio, ma perché non ha mai avuto accesso al segreto. Il tainted egress segue la stessa logica: non ci si fida del modello, si strumenta il kernel. Il bug bounty da 300.000 dollari e la franchezza della conclusione, che riconosce che Muse commetterà errori, dicono la stessa cosa di Boris Cherny quando valuta pubblicamente gli altri laboratori su questo rischio. La sicurezza degli agenti non è più una casella da spuntare: è una superficie ingegneristica che viene resa pubblica e per la cui violazione si è disposti a pagare.
La giornata offre anche una lezione di economia dell’IA e l’unità di conto non è più il punteggio, ma il costo per attività. Mistral raccoglie 3 miliardi di euro con una valutazione superiore a 21 miliardi, Cognition più di 2 miliardi con una valutazione di 48 miliardi, in entrambi i casi con aziende industriali e clienti al tavolo anziché soltanto fondi tecnologici. Nello stesso momento, Cursor pubblica una tabella in cui Muse Spark 1.3 ottiene il 67,9 per cento a 1,31 dollari per attività, mentre il primo in classifica paga 9,64 dollari per sei punti in più, e Anthropic documenta riduzioni dei costi dal 52 al 73 per cento senza perdita di prestazioni, mostrando che un modello più potente con un livello di sforzo inferiore spesso supera un modello più debole spinto al massimo. Sarah Friar quantifica l’altro estremo della catena, con una riduzione del 20 per cento dei costi di servizio ottenuta facendo ottimizzare a GPT-5.6 Sol il livello che lo eroga. Sono quattro modi per dire che il compromesso si è spostato dalla capacità al prezzo di tale capacità.
Sul piano scientifico, la domanda non è più se gli agenti producano risultati, ma come verificarli. OpenAI annuncia una prova di singolarità per Navier-Stokes prodotta da circa 10.000 agenti in 88 ore, formalizzata in Lean, senza menzionare revisione tra pari né convalida istituzionale e con un modello interno che nessuno all’esterno può interrogare. La prudenza dell’azienda, che rinuncia al premio del millennio e parla di un’istantanea, è di per sé un’informazione. Gli altri due lavori della giornata mostrano l’entità del contrasto: al MIT, Codex gestisce protocolli ben definiti ma si blocca davanti a segnali ambigui, e un ricercatore esperto rimane più veloce; presso Google DeepMind, AlphaGenome Atlas non pretende di dimostrare nulla, ma pre-calcola 9 miliardi di predizioni e sposta lo sforzo verso la convalida sperimentale. L’articolo di Oruk completa la dimostrazione mostrando che un’ablazione spettacolare non prova nulla senza un confronto abbinato, mentre quello di Multiverse Computing ricorda che un dato sulla sicurezza non significa nulla finché il versante benigno non viene misurato con lo stesso rigore.
Rimane il livello più basso, quello in cui i progressi non derivano più dai pesi. Cohere rende disponibile un motore di servizio completo nel quale l’unico cambiamento consiste nella rimozione dei confini tra kernel, ottenendo un throughput pari a 1,58x quello di vLLM a parità di qualità, e tiene a precisare che la difficoltà di scrittura di un megakernel è sovrastimata. NVIDIA apre due strade per scrivere kernel GPU in Rust, una delle quali è già utilizzata al di fuori dell’azienda nel motore di inferenza Grout di Hugging Face e in mistral.rs, e ammette che nulla è pronto per la produzione. Nell’AI City Challenge, quattro delle cinque migliori soluzioni video si basano su modelli Cosmos adattati tramite LoRA, con il team vincitore che sottolinea come si tratti di una tecnica di adattamento e non di una nuova architettura. Il tutorial meteorologico di Earthmover racconta la stessa storia dall’altra estremità: il modello Aurora funziona su un processore; l’ostacolo non era il calcolo, ma il gigabyte di condizioni iniziali da scaricare. Ogni volta, il valore risiede nell’ingegneria che circonda il modello, e viene reso pubblico.
Fonti
- Lancio di Muse, Meta
- Sicurezza e protezione degli agenti con Muse, Meta
- Serie D di Mistral
- Annuncio della Serie D su X
- Soluzione del problema di Navier-Stokes, OpenAI
- Thread di OpenAI sul modello interno
- Codex ed esperimenti di calcolo quantistico al MIT
- ChatGPT Images 2.5, OpenAI
- Manus integra GPT-Image-2.5
- AlphaGenome Atlas, Google DeepMind
- CUDA Rust, NVIDIA
- AI City Challenge di ECCV 2026, NVIDIA
- Serie E di Cognition
- Thread di Cognition su X
- Partnership tra Suno, Believe e TuneCore
- Megakernel di decodifica, Cohere
- Ridurre i costi su Claude Platform, Anthropic
- Claude Code 2.1.265
- Controllo in tempo reale dell’agente, Amp
- Muse Spark 1.3 in Cursor
- Compilazione di moduli in Grok Bot
- Fotogrammi chiave e loop in Grok Imagine
- Modelli meteorologici aperti con Earthmover, Hugging Face
- Sicurezza per chi, Multiverse Computing
- Connettoma della mosca e cablaggio rimescolato, Oruk
- Kinetix entra a far parte di Runway
- Editoriale di Sarah Friar, OpenAI
- Sovvenzioni per la ricerca sugli adolescenti, OpenAI
- Boris Cherny sul rischio di prompt injection
- Fondatori che sviluppano su Claude Managed Agents
- RelayShield e i file di istruzioni
- Ai2 a ECCV 2026
- Il livello degli strumenti degli agenti, Prismberry
- Diario di manutenzione hardware
- Gemini for Education nel Missouri
- Dependabot e i registri GitHub privati
- Nuovo portale di supporto GitHub
- Spark House durante la SF Tech Week, Genspark
- Ethan Tandowsky, direttore finanziario di ElevenLabs
- Evento MiniMax a Tokyo
- Dirette di Nemotron Labs
- Confronto tra avatar di HeyGen
- Programma di giornalismo di OpenAI
- Guida sul ritorno sull’investimento dell’IA, Perplexity