ai-powered-markdown-translatorgpt-6.1-sol का उपयोग करके फ़्रेंच से हिंदी में अनुवादित लेख।
Anthropic की Alignment टीम का एक अध्ययन, जो X पर घोषणा किए बिना 27 अक्टूबर को उसके शोध पृष्ठ पर प्रकाशित हुआ, विशेषज्ञ विश्लेषकों के निर्णयों पर एक कोड एजेंट के प्रभाव को मापता है: Claude Code के साथ, वे 86 % मामलों में एजेंट की पसंद के मुताबिक निर्णय लेते हैं। इस रविवार की बाकी खबरें संक्षेप में हैं: Copilot CLI के लिए सुधार, Qwen Code v0.26.5 का स्थिर संस्करण, Gemini CLI का बिना किसी बदलाव वाला nightly संस्करण और Amp के लिए iOS विजेट, फिर MiniMax M3.1 Flash के क्वांटाइज़ेशन और Hugging Face पर प्रकाशित समुदाय के तीन लेख।
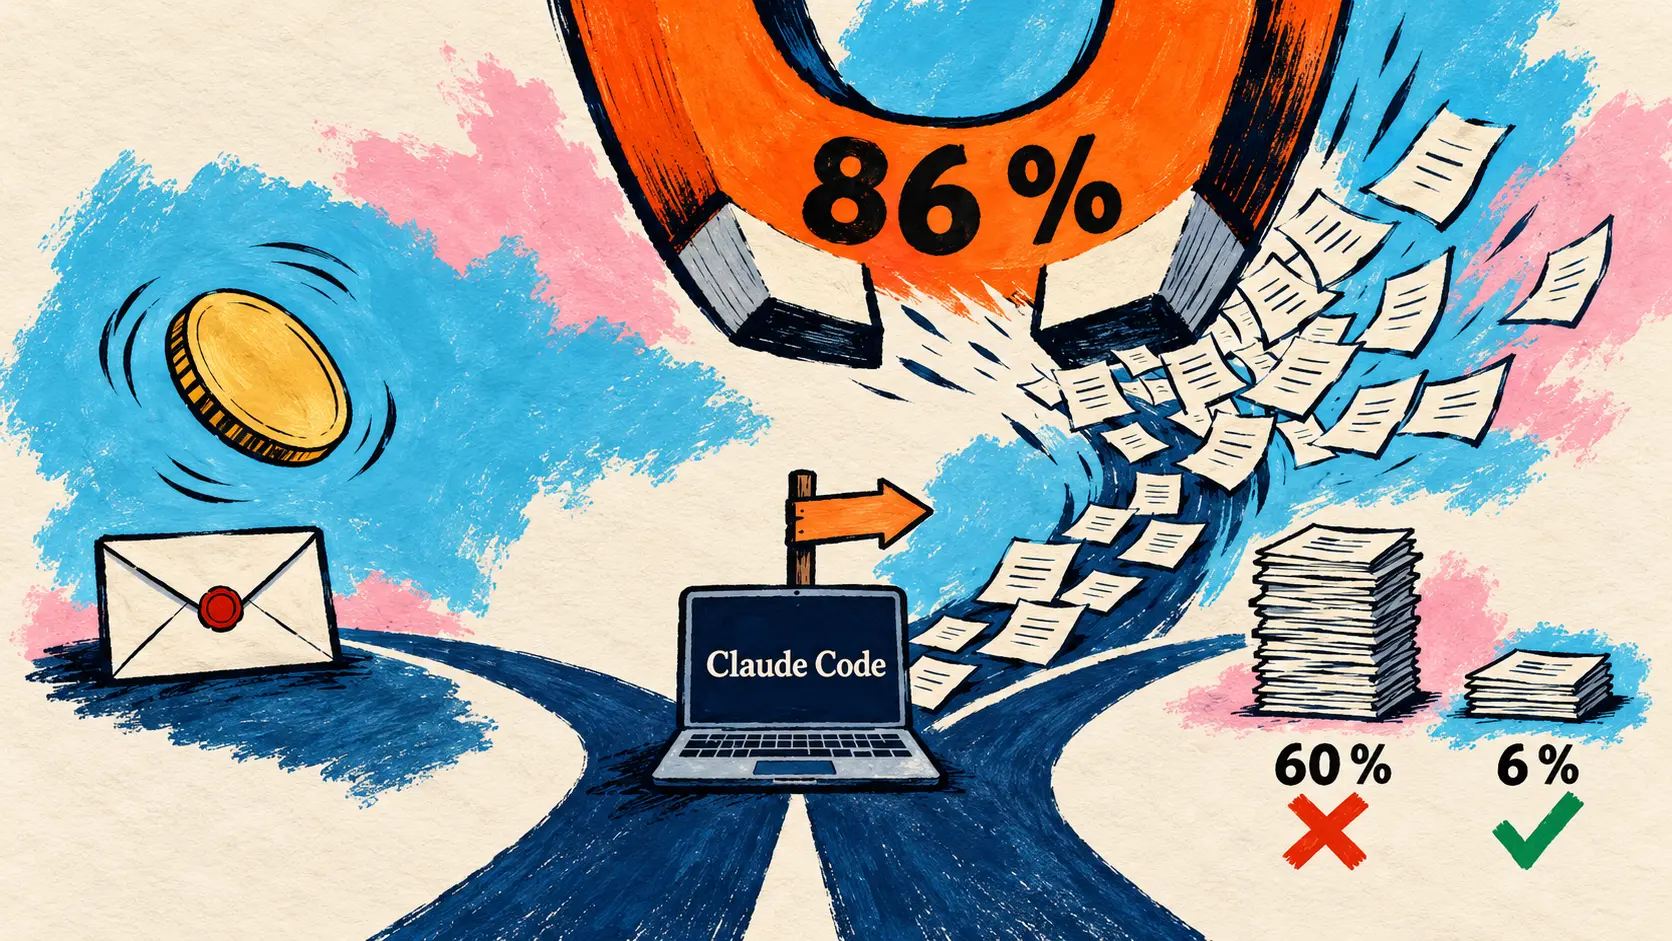
Anthropic के एक अध्ययन के अनुसार, विशेषज्ञ विश्लेषक 86 % निर्णयों में अपने Claude Code एजेंट की पसंद के मुताबिक चलते हैं
27 अक्टूबर — छूटी खबर पर एक नज़र: Anthropic की Alignment टीम विशेषज्ञों के आकलन आधारित विकल्पों (विवेकाधारित निर्णयों) पर एक यादृच्छिक नियंत्रित परीक्षण प्रकाशित करती है। कारणात्मक निष्कर्ष निकालने में अनुभवी 50 विश्लेषक (61 भर्ती किए गए, 11 ने एजेंट के बिना काम करना पसंद किया) प्रयास स्तर High पर Claude Opus 4.8 के साथ चल रहे Claude Code की मदद से एक काल्पनिक कृषि सहकारी संस्था को सलाह देते हैं। विश्लेषण संबंधी चारों निर्णयों में से प्रत्येक के लिए सिक्का उछालकर वह विकल्प तय किया जाता है, जिसका पक्ष एजेंट एक छिपे हुए सिस्टम प्रॉम्प्ट के आधार पर लेता है; निर्देश है: ईमानदारी से तर्क देना, कभी धोखा नहीं देना।
विश्लेषक 86 % मामलों में एजेंट की पसंद के मुताबिक निर्णय लेते हैं, जबकि प्रभाव न होने पर लगभग 50 % अपेक्षित था। जिनकी पहले से कोई राय थी, वे एजेंट के असहमत होने पर 60 % मामलों में अपनी राय बदल देते हैं, जबकि उसके सहमत होने पर 6 % मामलों में ऐसा करते हैं (केवल 38 मामले)। बाद में, 77 % उसके तर्क अपनाते हैं, 15 % उसका हवाला देते हैं। बताई गई सीमाएँ: पसंद को जानबूझकर अधिक प्रबल बनाया गया, केवल एक कार्य, एक क्षेत्र और एक मॉडल।
संक्षिप्त खबरें
कोड एजेंट और CLI
- Copilot CLI 1.0.106-2 — 1 नवंबर का पूर्वावलोकन संस्करण पाँच सुधारों तक सीमित है, कोई नई सुविधा नहीं है:
--screen-readerके साथ, त्रुटियाँ और चेतावनियाँError:याWarning:से शुरू होती हैं,/resumeपृष्ठभूमि में चल रहे सत्र को अग्रभूमि में लाता है, और जवाब न देने वाला MCP HTTP सर्वर अब आरंभ होने की प्रक्रिया को केवल एक बार ही रोकता है; स्थिर संस्करण अभी भी 1.0.105 है। 🔗 स्रोत - Qwen Code v0.26.5 — v0.26.4 के तीन दिन बाद, 1 नवंबर को जारी स्थिर संस्करण: अब तक प्रायोगिक रहा जनित इंटरफ़ेस (Generated UI) डिफ़ॉल्ट रूप से सक्रिय है, Managed Agent को एक कमांड से प्रायोगिक Helm तैनाती की सुविधा मिली है, और सुधारों को तीन बार पुश करने के बावजूद सफलता न मिलने पर
/autofix-prनियंत्रण किसी मानव को सौंप देता है। 🔗 स्रोत - Gemini CLI, 1 नवंबर का nightly संस्करण — कोड में कोई बदलाव नहीं: यह 31 अक्टूबर वाले संस्करण के समान commit पर आधारित है, और केवल प्रकाशन बॉट 9
package.jsonऔरpackage-lock.jsonफ़ाइलों के संस्करण नंबर बदलता है। स्थिर संस्करण v0.66.0 और पूर्वावलोकन संस्करण v0.67.0-preview.0 में बदलाव नहीं है। 🔗 स्रोत - Amp के iOS विजेट — 30 अक्टूबर की छूटी खबर: Amp के मुख्य कार्यकारी अधिकारी क्विन स्लैक X पर होम स्क्रीन विजेट की घोषणा करते हैं, जो उनके स्क्रीनशॉट के अनुसार कई थ्रेड और उनकी स्थिति या एक ही थ्रेड और उस पर जारी कार्रवाई दिखाते हैं। iPhone और iPad ऐप अभी भी TestFlight बीटा में है, कोई लेख या दस्तावेज़ उपलब्ध नहीं है। 🔗 स्रोत
खुले मॉडल और समुदाय के बेंचमार्क
- MiniMax M3.1 Flash के क्वांटाइज़ेशन — MiniMax X पर खुले वेट वाले अपने 428B MoE के क्वांटाइज़ किए गए संस्करणों की सूची देता है, जिनमें Instinct MI350 और MI355 के लिए AMD का Quark MXFP4 (केवल रूट किए गए एक्सपर्ट, AMD के विवरण पृष्ठ के अनुसार GSM8K पर 97,2 % के मुकाबले 96,9 %) और एक ही DGX Spark पर SAGE-EXL3 शामिल हैं। 🔗 स्रोत · 🔗 AMD का विवरण पृष्ठ
- Pramaan — Hugging Face पर समुदाय के एक लेख में क्षितिज ठक्कर भारतीय परंपराओं से प्रेरित ज्यामितीय पैटर्न वाले 72 कार्यों का एक बेंचमार्क पेश करते हैं, जिनकी जाँच एक सत्यापक करता है। एक ही परीक्षण रन में मिले उनके परिणामों के अनुसार, GPT-6 Astra पहले प्रयास में आगे है (81,9 %); तीन प्रयासों के साथ Claude Opus 5.5 का स्कोर 8,3 % से बढ़कर 90,3 % हो जाता है। 🔗 स्रोत
- DolphinBench पर AtMem routed-v4 — समुदाय के एक लेख में जवाद ताघिया अपनी एजेंट मेमोरी लाइब्रेरी के लिए Mem0 के इस बेंचमार्क पर 600 में से 479 कार्यों में सफलता (79,83 %) दर्ज करते हैं, जबकि पिछले परीक्षण में यह संख्या 390 थी। परीक्षण चलाना और अंक देना स्वयं किया गया है; यह केवल तय किए गए AtMem 2.3.10b1 संस्करण के लिए है और रैंकिंग में आधिकारिक प्रविष्टि का दर्जा नहीं रखता। 🔗 स्रोत
- ViKernel — समुदाय के एक लेख में VIDRAFT (FINAL-Bench) एक v0.1 डेमो प्रस्तुत करता है, जिसमें एजेंट के नियंत्रण, बंद करने के बटन सहित, मॉडल के वेट में समाहित होने की बात कही गई है। कोड और वेट उपलब्ध नहीं हैं: डेमो पहले से रिकॉर्ड किए गए उत्तर दोबारा दिखाता है। एकमात्र आँकड़ा सिम्युलेट किए गए टूल के साथ किए गए आंतरिक ऑडिट से आया है: 661 रन में बिना अनुरोध के बाहर होने वाले 0 स्थानांतरण। 🔗 स्रोत
इसका क्या अर्थ है
Anthropic का अध्ययन एजेंट की गुणवत्ता से ध्यान हटाकर उसकी निगरानी करने वाले व्यक्ति की स्वतंत्रता पर ले जाता है। विश्लेषकों को धोखा नहीं दिया गया, क्योंकि एजेंट को ईमानदारी से पक्ष रखना था, फिर भी सिक्का उछालने के चार नतीजे उनकी अंतिम सिफ़ारिशों में से 82 % का अनुमान लगाने के लिए काफ़ी हैं, जबकि हमेशा सबसे आम सिफ़ारिश का अनुमान लगाने पर यह आँकड़ा 61 % है। अनुभव, शैक्षणिक योग्यता या एआई पर भरोसा, इनमें से कोई भी यह अनुमान नहीं लगाने देता कि कौन एजेंट की राय पर निर्भर करेगा, और चारों निर्णयों में एजेंट की राय मानने वाले खुद को लगभग उतना ही आश्वस्त बताते हैं जितना अन्य लोग (100 में से 71 बनाम 73)। Anthropic इससे एक सामूहिक चुनौती सामने लाता है: यदि कई टीमें समान पसंद वाले मॉडलों पर निर्भर हों, तो उनकी सहमति स्वतंत्र नहीं भी रह सकती, और एआई सुरक्षा अनुसंधान में कोई मानव समीक्षक तभी जाँच का काम करता है, जब उसका निर्णय उसका अपना बना रहे।
दिन की बाकी खबरें रखरखाव से संबंधित हैं: Copilot CLI और Gemini CLI का nightly संस्करण कोई नई सुविधा नहीं जोड़ते, और Qwen Code अब तक प्रायोगिक रहे इंटरफ़ेस को डिफ़ॉल्ट बनाता है, साथ ही यह प्रावधान करता है कि तीन असफलताओं के बाद /autofix-pr नियंत्रण किसी मानव को सौंप दे। खुले मॉडलों के मामले में परिणामों का महत्त्व मापन की परिस्थितियों पर निर्भर है: AMD का विवरण पृष्ठ बताता है कि उसके MXFP4 क्वांटाइज़ेशन से GSM8K पर प्रदर्शन में कितनी कमी आती है, जबकि Pramaan, AtMem और ViKernel अपने ही लेखकों द्वारा प्राप्त परिणाम प्रकाशित करते हैं, जो एक ही परीक्षण रन, एक तय संस्करण या सिम्युलेट किए गए टूल पर आधारित हैं।
स्रोत
- विशेषज्ञों के विवेकाधारित निर्णयों पर Anthropic का अध्ययन
- Copilot CLI 1.0.106-2
- Qwen Code v0.26.5
- Gemini CLI का 1 नवंबर का nightly संस्करण
- @sqs: Amp के iOS ऐप के विजेट
- @MiniMax_AI: M3.1 Flash के क्वांटाइज़ेशन
- MiniMax M3.1 Flash Quark MXFP4 का Hugging Face विवरण पृष्ठ (AMD)
- Pramaan पर क्षितिज ठक्कर का लेख
- AtMem routed-v4 पर जवाद ताघिया का लेख
- ViKernel पर VIDRAFT का लेख