ai-powered-markdown-translatorgpt-6.1-sol을 사용하여 프랑스어에서 한국어로 번역한 기사.
Anthropic의 정렬 팀이 10월 27일 X에 별도로 알리지 않고 연구 페이지에 공개한 연구는 코딩 에이전트가 전문 분석가의 선택에 미치는 영향력을 측정했다. Claude Code를 사용한 분석가들은 86 %의 경우에 에이전트가 선호하는 선택을 따랐다. 이번 일요일의 나머지 소식은 단신으로 모았다. Copilot CLI 수정 사항, Qwen Code v0.26.5 안정 버전, 변경 사항이 없는 Gemini CLI 야간 빌드와 Amp의 iOS 위젯에 이어 MiniMax M3.1 Flash 양자화 버전과 Hugging Face에 게시된 커뮤니티 글 세 편을 다룬다.
Anthropic 연구에 따르면 전문 분석가들은 선택의 86 %에서 Claude Code 에이전트의 선호를 따른다
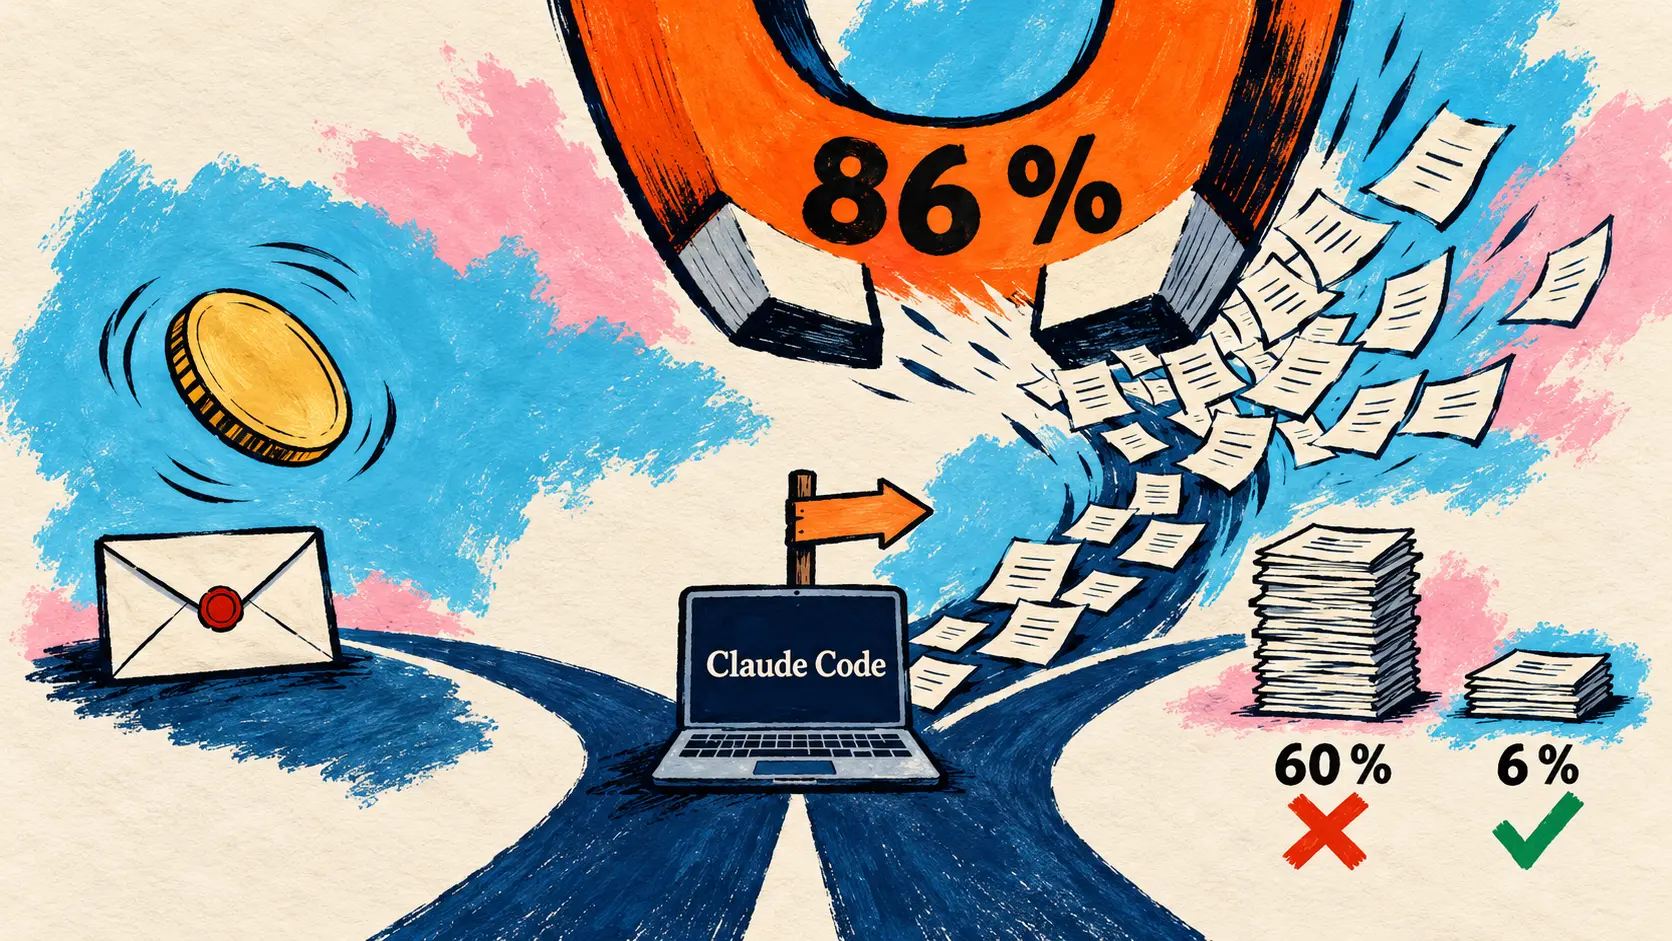
10월 27일 — 지난 소식: Anthropic의 정렬 팀이 전문가의 재량적 선택(판단이 필요한 사안)을 다룬 무작위 대조 시험을 발표했다. 인과 추론에 숙련된 분석가 50명(61명을 모집했으나 11명은 에이전트 없이 작업하기로 선택)이 추론 강도를 High로 설정한 Claude Opus 4.8 기반 Claude Code를 사용해 가상의 농업 협동조합에 자문했다. 네 가지 분석 선택마다 동전 던지기로 에이전트가 지지할 선택지를 정하고, 숨겨진 시스템 프롬프트로 이를 지정했다. 지침은 정직하게 주장하되 절대 속이지 않는 것이었다.
분석가들은 86 %의 경우에 에이전트의 선호를 따랐다. 영향이 없다면 예상되는 비율은 약 50 %다. 이미 의견을 정한 사람들은 에이전트가 반대하면 60 %의 경우에 의견을 바꿨지만, 에이전트가 동의하면 그 비율은 6 %였다(단 38건). 사후에는 77 %가 에이전트의 논거를 재사용했고, 15 %가 에이전트를 인용했다. 연구진이 밝힌 한계는 의도적으로 강화한 선호, 단일 과제, 단일 분야, 단일 모델이다.
단신
코딩 에이전트와 CLI
- Copilot CLI 1.0.106-2 — 11월 1일 사전 공개 버전으로, 새로운 기능 없이 수정 사항 다섯 가지가 포함됐다.
--screen-reader사용 시 오류와 경고는Error:또는Warning:로 시작하며,/resume는 백그라운드 세션을 포그라운드로 가져오고, 응답하지 않는 MCP HTTP 서버가 시작을 지연시키는 것도 한 번으로 제한된다. 안정 버전은 여전히 1.0.105다. 🔗 출처 - Qwen Code v0.26.5 — v0.26.4가 나온 지 사흘 만에 공개된 11월 1일 안정 버전이다. 그동안 실험 기능이었던 생성형 인터페이스(Generated UI)가 기본으로 활성화되고, Managed Agent에는 명령어 하나로 실행하는 실험적 Helm 배포가 추가됐으며,
/autofix-pr는 수정 사항을 세 차례 푸시해도 해결되지 않으면 사람에게 제어권을 넘긴다. 🔗 출처 - Gemini CLI, 11월 1일 야간 빌드 — 코드 변경은 없다. 10월 31일 빌드와 동일한 커밋을 기반으로 하며, 배포 봇만
package.json및package-lock.json파일 9개의 버전 번호를 바꿨다. 안정 버전 v0.66.0과 사전 공개 버전 v0.67.0-preview.0은 그대로다. 🔗 출처 - Amp의 iOS 위젯 — 지난 10월 30일 소식: Amp의 최고경영자 퀸 슬랙이 X에서 홈 화면 위젯을 발표했다. 공개한 화면을 보면 여러 스레드와 각각의 상태를 표시하거나, 단일 스레드와 진행 중인 작업을 표시한다. iPhone 및 iPad 앱은 여전히 TestFlight 베타이며, 별도의 게시글이나 문서는 없다. 🔗 출처
개방형 모델과 커뮤니티 벤치마크
- MiniMax M3.1 Flash 양자화 버전 — MiniMax가 가중치를 공개한 428B MoE의 양자화 버전들을 X에 정리했다. 여기에는 Instinct MI350 및 MI355용 AMD의 Quark MXFP4(라우팅된 전문가만 양자화, AMD 모델 카드 기준 GSM8K에서 97,2 % 대비 96,9 %)와 DGX Spark 한 대에서 실행되는 SAGE-EXL3가 포함된다. 🔗 출처 · 🔗 AMD 모델 카드
- Pramaan — 크시티지 타카르가 Hugging Face 커뮤니티 글에서 인도 전통에서 영감을 얻은 기하학적 패턴 과제 72개로 구성되고 검증기로 확인하는 벤치마크를 소개했다. 한 번의 실행에서 얻은 그의 측정 결과에 따르면 GPT-6 Astra가 첫 시도에서 앞섰으며(81,9 %), 세 번 시도할 경우 Claude Opus 5.5는 8,3 %에서 90,3 %로 올랐다. 🔗 출처
- DolphinBench에서의 AtMem routed-v4 — 자바드 타기아가 커뮤니티 글에서 자신의 에이전트용 메모리 라이브러리가 이 Mem0 벤치마크의 과제 600개 중 479개(79,83 %)를 해결했다고 밝혔다. 이전 실행에서는 390개였다. 고정된 AtMem 2.3.10b1 버전만을 대상으로 자체 실행과 채점을 진행했으며, 공식 순위 등록 결과는 아니다. 🔗 출처
- ViKernel — VIDRAFT(FINAL-Bench)가 커뮤니티 글에서 정지 버튼을 포함한 에이전트 제어 기능을 모델 가중치 안에 담는다는 v0.1 시연을 소개했다. 코드와 가중치는 없으며, 시연은 미리 기록한 응답을 재생한다. 유일한 수치는 모의 도구를 사용한 내부 감사에서 나온 것으로, 661회 실행에서 요청하지 않은 외부 전송은 0건이었다. 🔗 출처
이 소식이 의미하는 것
Anthropic의 연구는 에이전트의 품질에서 이를 감독하는 사람의 독립성으로 질문의 초점을 옮긴다. 에이전트는 정직하게 주장해야 했으므로 분석가들이 속은 것은 아니다. 그런데도 네 차례의 동전 던지기만으로 최종 권고의 82 %를 예측할 수 있었으며, 가장 흔한 권고를 항상 고르는 경우의 61 %를 웃돌았다. 경력이나 학위, AI에 대한 신뢰도 중 어느 것도 누가 에이전트에 의존하는지 예측하지 못했고, 네 가지 선택 모두에서 에이전트를 따른 사람들은 다른 사람들과 거의 비슷한 수준으로 자신의 판단을 확신한다고 답했다(100점 만점에 71점 대 73점). Anthropic은 여기서 집단 차원의 문제를 도출한다. 여러 팀이 같은 선호를 가진 모델에 의존하면 이들의 합의는 더 이상 독립적이지 않을 수 있으며, AI 안전성 연구를 검토하는 사람도 자신의 판단을 유지할 때만 검증 장치가 될 수 있다.
나머지 소식은 유지보수에 해당한다. Copilot CLI와 Gemini CLI 야간 빌드는 새로운 기능을 추가하지 않았고, Qwen Code는 그동안 실험 단계였던 인터페이스를 기본 기능으로 전환하면서 /autofix-pr가 세 차례 실패하면 사람에게 제어권을 돌려주도록 했다. 개방형 모델 쪽에서는 측정 조건이 결과의 가치를 좌우한다. AMD 모델 카드는 MXFP4 양자화로 GSM8K 성능이 얼마나 낮아지는지 수치로 보여 주는 한편, Pramaan, AtMem, ViKernel은 각각 단일 실행, 고정 버전, 모의 도구라는 조건에서 저자들이 직접 산출한 결과를 공개했다.