ai-powered-markdown-translator本文由 gpt-6.1-sol 从法语翻译成中文。
Anthropic 对齐团队于 10 月 27 日在其研究页面发表了一项研究,未在 X 上发布公告。研究衡量了编程智能体对资深分析师选择的影响:使用 Claude Code 时,他们在 86 % 的情况下遵从智能体的偏好。本周日的其余内容以简讯为主:Copilot CLI 修复问题、Qwen Code v0.26.5 发布稳定版、Gemini CLI 每夜构建版没有实质更新、Amp 推出 iOS 小组件,此外还有 MiniMax M3.1 Flash 的量化版本,以及在 Hugging Face 上发表的三篇社区文章。
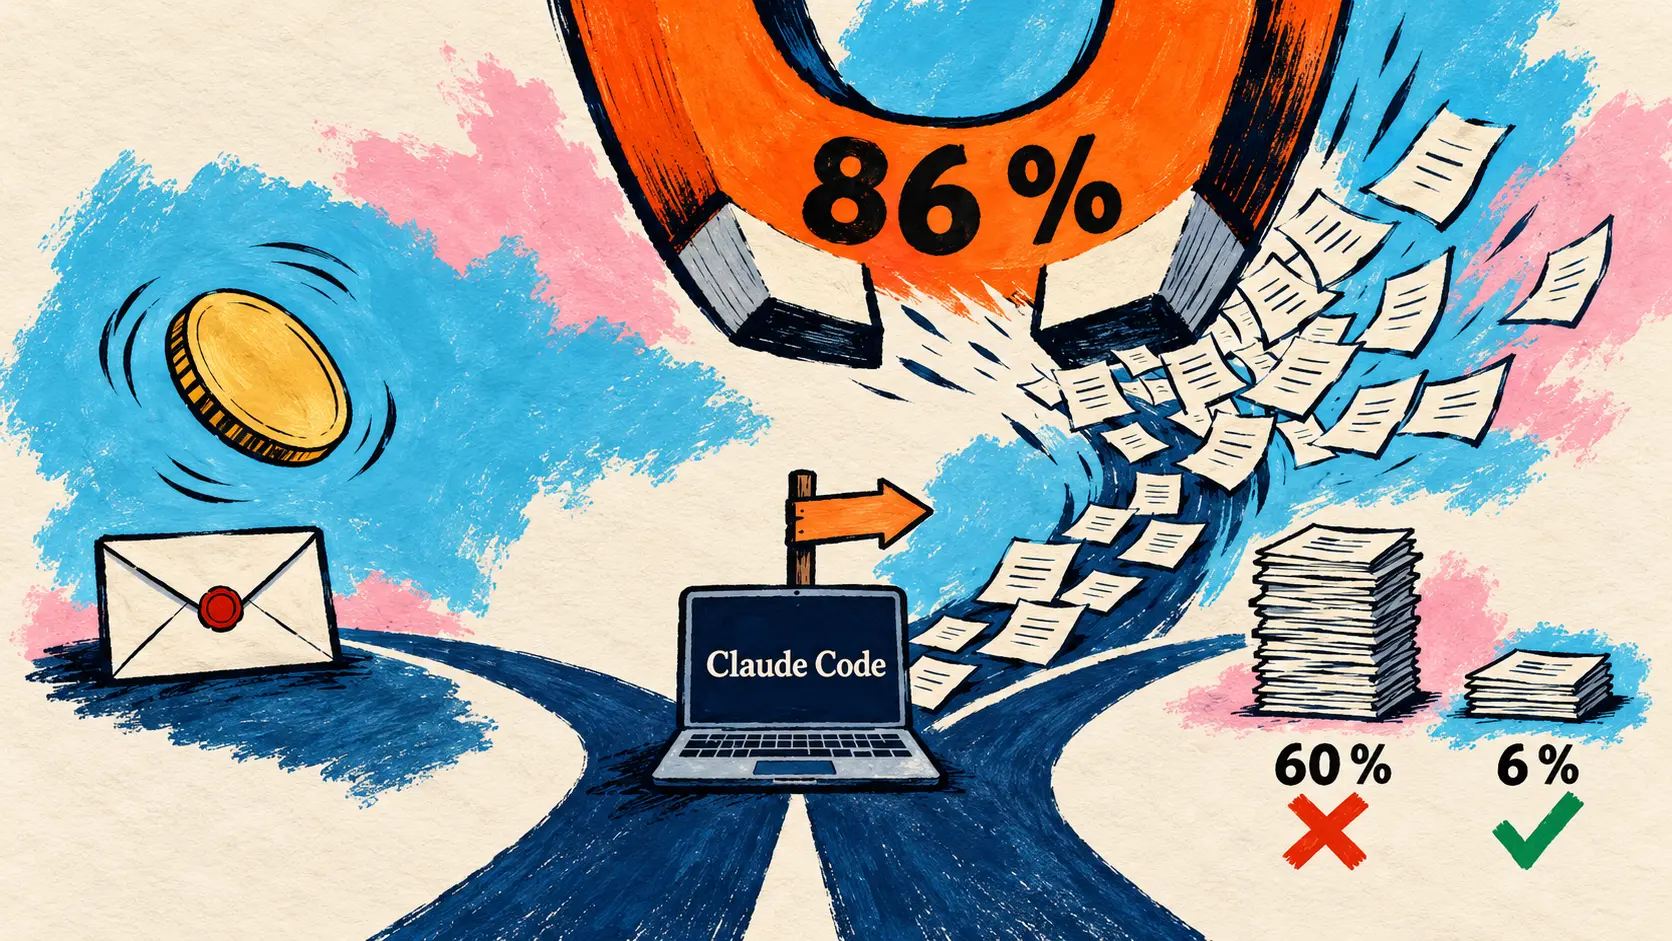
据 Anthropic 研究,资深分析师在 86 % 的选择中遵从其 Claude Code 智能体的偏好
10 月 27 日 — 补报:Anthropic 对齐团队发表了一项针对专家分析取舍(判断性决策)的随机对照试验。50 名熟悉因果推断的分析师(共招募 61 人,其中 11 人选择不使用智能体)通过 Claude Code,使用推理强度设为 High 的 Claude Opus 4.8,为一家虚构的农业合作社提供建议。针对四项分析选择中的每一项,都通过抛硬币决定智能体支持哪个选项,并通过隐藏的系统提示词设定;指令是:诚实地论证,绝不欺骗。
分析师在 86 % 的情况下遵从智能体的偏好,而在没有影响的情况下,预期比例约为 50 %。对于原本已有看法的分析师,当智能体反对他们时,60 % 会改变意见;当智能体赞同时,这一比例为 6 %(仅有 38 个案例)。事后,77 % 的分析师采用了智能体的论点,15 % 引用了它。研究声明的局限包括:刻意强化了偏好,且仅涉及一项任务、一个领域和一个模型。
简讯
智能体与编程 CLI
- Copilot CLI 1.0.106-2 — 11 月 1 日发布的预览版包含五项修复,没有新增功能:使用
--screen-reader时,错误和警告以Error:或Warning:开头,/resume可将后台会话带回前台,无响应的 MCP HTTP 服务器只会阻塞启动一次;稳定版仍为 1.0.105。🔗 来源 - Qwen Code v0.26.5 — 11 月 1 日发布的稳定版,距 v0.26.4 发布三天:此前处于实验阶段的生成式界面(Generated UI)现已默认启用,Managed Agent 新增通过一条命令进行 Helm 部署的实验功能,
/autofix-pr会在三次修复推送失败后交由人工接手。🔗 来源 - Gemini CLI,11 月 1 日每夜构建版 — 没有代码变更:它基于与 10 月 31 日版本相同的提交,仅由发布机器人修改了 9 个
package.json和package-lock.json文件的版本号。稳定版 v0.66.0 和预览版 v0.67.0-preview.0 均未变化。🔗 来源 - Amp 的 iOS 小组件 — 补报 10 月 30 日消息:Amp 首席执行官奎因·斯莱克在 X 上宣布推出主屏幕小组件。根据其截图,小组件可显示多个会话及其状态,或显示一个会话及其正在执行的操作。iPhone 和 iPad 应用仍为 TestFlight 测试版,尚无相关文章或文档。🔗 来源
开放模型与社区基准测试
- MiniMax M3.1 Flash 量化版本 — MiniMax 在 X 上汇总了其 428B 参数开放权重 MoE 模型的量化版本,包括 AMD 面向 Instinct MI350 和 MI355 的 Quark MXFP4(仅量化路由专家;根据 AMD 模型卡,在 GSM8K 上的成绩为 96,9 %,对照值为 97,2 %),以及可在单台 DGX Spark 上运行的 SAGE-EXL3。🔗 来源 · 🔗 AMD 模型卡
- Pramaan — 克希蒂杰·塔卡尔在 Hugging Face 社区文章中介绍了一套包含 72 项任务的基准,任务围绕受印度传统启发的几何图案展开,并由验证器检查。据其单次运行的测量结果,GPT-6 Astra 在首次尝试时领先(81,9 %);允许三次尝试后,Claude Opus 5.5 从 8,3 % 提升至 90,3 %。🔗 来源
- AtMem routed-v4 在 DolphinBench 上的表现 — 贾瓦德·塔吉亚在一篇社区文章中测得,其智能体记忆库在 Mem0 的这套基准中完成了 600 项任务中的 479 项(79,83 %),上一轮为 390 项。运行和评分均由作者自行完成,不构成排行榜的正式成绩,且仅针对固定版本 AtMem 2.3.10b1。🔗 来源
- ViKernel — VIDRAFT(FINAL-Bench)在一篇社区文章中介绍了一个 v0.1 演示,据称可将智能体的控制机制存入模型权重,包含停止按钮。没有代码,也没有权重:演示只是重放预录的回答。唯一的数据来自使用模拟工具的内部审计:661 次运行中,未经请求的对外传输为 0 次。🔗 来源
这意味着什么
Anthropic 的研究将关注点从智能体的质量转向监督者的独立性。分析师并未受到欺骗,因为智能体被要求诚实地论证;然而,仅凭四次抛硬币的结果,就足以预测他们 82 % 的最终建议,而始终猜测最常见的建议只能达到 61 %。经验、学历以及对人工智能的信任程度,都无法预测谁会听从智能体;在四项选择中全部听从智能体的人,自述信心几乎与其他人相同(满分 100 分时,分别为 71 分和 73 分)。Anthropic 由此提出了一个集体层面的问题:如果多个团队依赖偏好相同的模型,他们的一致意见可能不再来自独立判断;人工智能安全研究中的人工审阅者,只有保持自己的判断,才能发挥把关作用。
当天其余消息主要围绕维护更新:Copilot CLI 和 Gemini CLI 每夜构建版均未新增功能,Qwen Code 则默认启用了此前处于实验阶段的界面,同时设定 /autofix-pr 在三次失败后交由人工接手。开放模型方面,信息的价值取决于测量条件:AMD 模型卡量化了其 MXFP4 量化在 GSM8K 上造成的性能损失,而 Pramaan、AtMem 和 ViKernel 发布的结果均由各自作者测得,分别基于单次运行、固定版本或模拟工具。