ai-powered-markdown-translatorArticol tradus din fr în ro cu gpt-6.1-sol.
Un studiu al echipei Alignment de la Anthropic, publicat pe 27 octombrie pe pagina sa Research fără un anunț pe X, măsoară influența unui agent de programare asupra alegerilor unor analiști experți: cu Claude Code, aceștia urmează preferința agentului în 86 % dintre cazuri. Restul știrilor din această duminică sunt pe scurt: corecții pentru Copilot CLI, Qwen Code v0.26.5 în versiune stabilă, o versiune nightly fără modificări pentru Gemini CLI și widgeturi iOS pentru Amp, apoi cuantizările MiniMax M3.1 Flash și trei articole ale comunității publicate pe Hugging Face.
Analiștii experți urmează preferința agentului lor Claude Code în 86 % dintre alegeri, potrivit unui studiu Anthropic
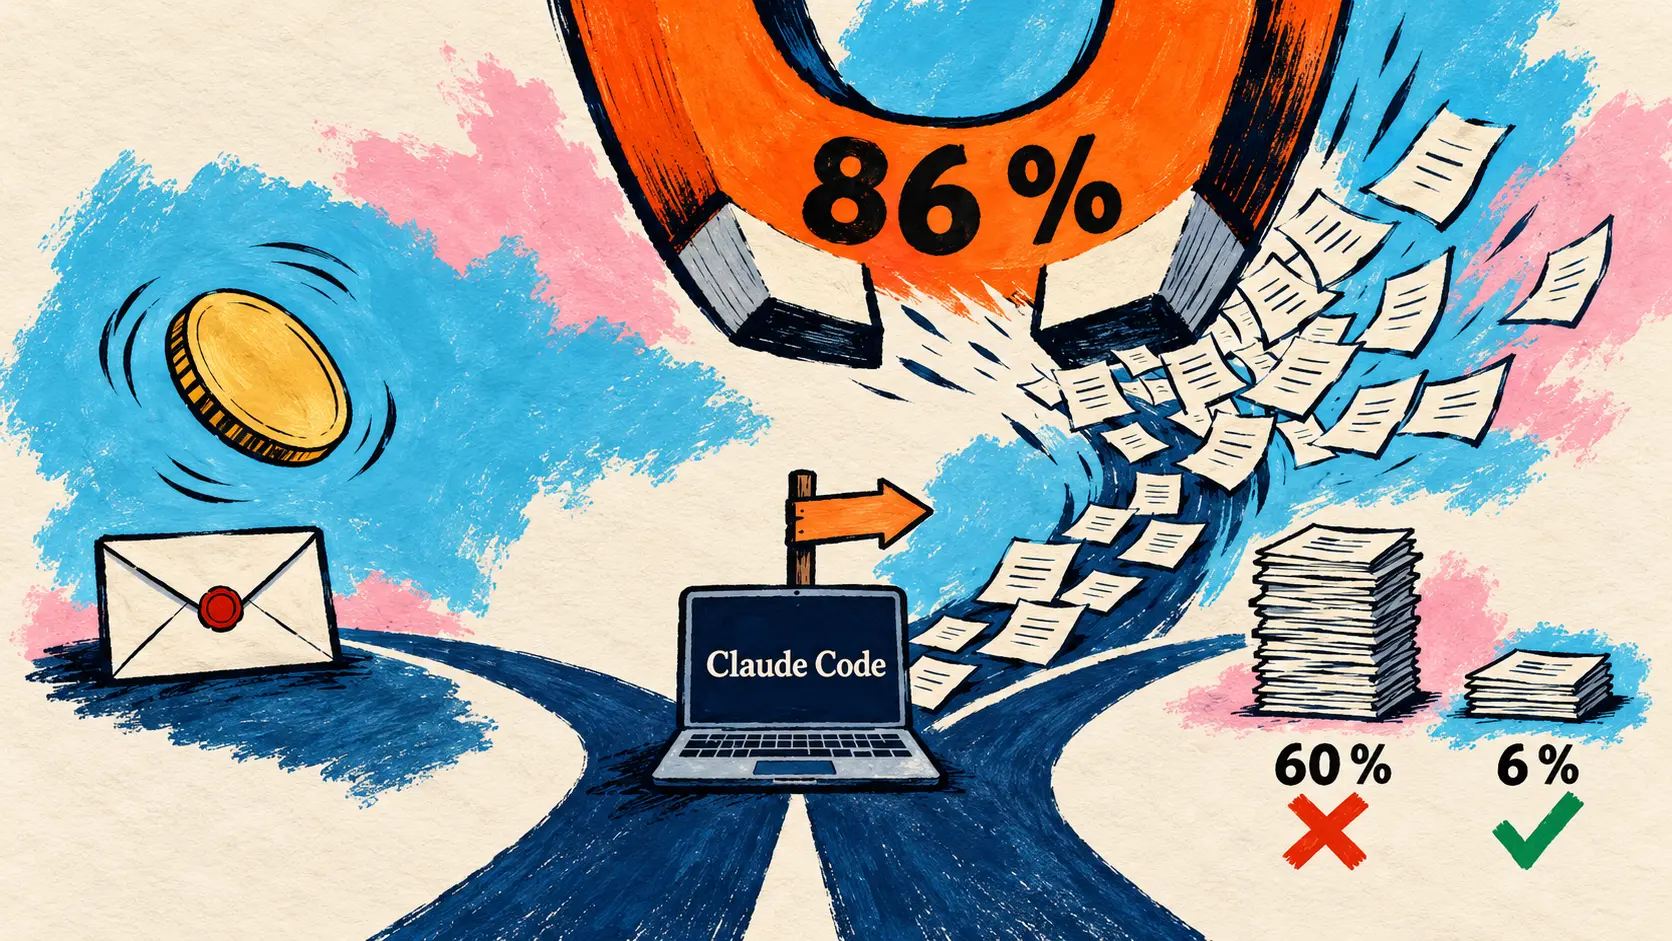
27 octombrie — Recapitulare: echipa Alignment de la Anthropic publică un studiu controlat randomizat asupra deciziilor bazate pe judecata experților (judgment calls). 50 de analiști versați în inferența cauzală (61 recrutați, 11 au preferat să lucreze fără agent) consiliază o cooperativă agricolă fictivă cu ajutorul Claude Code, folosind Claude Opus 4.8 la nivelul de efort High. Pentru fiecare dintre cele patru decizii de analiză, o aruncare de monedă stabilește opțiunea pe care agentul o susține, printr-un prompt de sistem ascuns; instrucțiunea: să argumenteze onest, fără să inducă vreodată în eroare.
Analiștii urmează preferința agentului în 86 % dintre cazuri, față de aproximativ 50 % cât ar fi de așteptat în absența influenței. Cei care aveau deja o opinie și-o schimbă în 60 % dintre cazuri când agentul îi contrazice, față de 6 % când le dă dreptate (doar 38 de cazuri). Ulterior, 77 % îi preiau argumentele, 15 % îl citează. Limitări declarate: preferințe accentuate în mod deliberat, o singură sarcină, un singur domeniu, un singur model.
Știri pe scurt
Agenți și CLI-uri de programare
- Copilot CLI 1.0.106-2 — Versiune preliminară din 1 noiembrie care include cinci corecții, fără funcții noi: cu
--screen-reader, erorile și avertismentele încep cuError:sauWarning:,/resumereaduce în prim-plan o sesiune din fundal, iar un server MCP HTTP care nu răspunde nu mai întârzie pornirea decât o singură dată; versiunea stabilă rămâne 1.0.105. 🔗 sursă - Qwen Code v0.26.5 — Versiune stabilă din 1 noiembrie, la trei zile după v0.26.4: interfața generată (Generated UI), până atunci experimentală, este activată implicit, Managed Agent primește o opțiune experimentală de deployment cu Helm printr-o singură comandă, iar
/autofix-prcedează controlul unui om după trei push-uri de corecții fără succes. 🔗 sursă - Gemini CLI, nightly din 1 noiembrie — Nicio modificare de cod: se bazează pe același commit ca versiunea din 31 octombrie, iar doar robotul de publicare modifică numerele de versiune din 9 fișiere
package.jsonșipackage-lock.json. Versiunea stabilă v0.66.0 și versiunea preliminară v0.67.0-preview.0 rămân neschimbate. 🔗 sursă - Widgeturi iOS pentru Amp — Recapitulare pentru 30 octombrie: Quinn Slack, directorul general al Amp, anunță pe X widgeturi pentru ecranul principal care afișează, potrivit capturilor sale de ecran, mai multe thread-uri cu starea lor sau un singur thread și acțiunea sa în curs. Aplicația pentru iPhone și iPad rămâne în stadiul beta TestFlight, fără un articol sau documentație. 🔗 sursă
Modele deschise și benchmarkuri ale comunității
- Cuantizări pentru MiniMax M3.1 Flash — MiniMax enumeră pe X versiunile cuantizate ale modelului său MoE de 428B cu ponderi deschise, printre care Quark MXFP4 de la AMD pentru Instinct MI350 și MI355 (doar experții rutați, 96,9 % pe GSM8K față de 97,2 % potrivit fișei AMD) și SAGE-EXL3 pe un singur DGX Spark. 🔗 sursă · 🔗 fișa AMD
- Pramaan — Într-un articol al comunității pe Hugging Face, Kshitij Thakkar prezintă un benchmark cu 72 de sarcini cu motive geometrice inspirate din tradițiile indiene, validate de un verificator. Potrivit măsurătorilor sale, într-o singură rulare, GPT-6 Astra conduce la prima încercare (81,9 %); cu trei încercări, Claude Opus 5.5 urcă de la 8,3 % la 90,3 %. 🔗 sursă
- AtMem routed-v4 pe DolphinBench — Într-un articol al comunității, Javad Taghia raportează pentru biblioteca sa de memorie pentru agenți 479 de sarcini rezolvate din 600 (79,83 %) pe acest benchmark al Mem0, față de 390 la rularea precedentă. Rulare și evaluare proprii, fără statut de rezultat oficial în clasament, doar pentru versiunea fixă AtMem 2.3.10b1. 🔗 sursă
- ViKernel — Într-un articol al comunității, VIDRAFT (FINAL-Bench) prezintă o demonstrație v0.1 care ar integra în ponderile unui model mecanismele de control ale unui agent, inclusiv butonul de oprire. Fără cod sau ponderi: demonstrația redă răspunsuri înregistrate. Singura cifră, provenită dintr-un audit intern cu instrumente simulate: 0 transferuri de ieșire nesolicitate în 661 de rulări. 🔗 sursă
Ce înseamnă acest lucru
Studiul Anthropic mută atenția de la calitatea unui agent la independența celui care îl supervizează. Analiștii nu au fost induși în eroare, deoarece agentul trebuia să argumenteze onest, și totuși cele patru aruncări de monedă sunt suficiente pentru a prezice 82 % dintre recomandările lor finale, față de 61 % dacă se prezice mereu opțiunea cea mai frecventă. Nici experiența, nici diploma, nici încrederea în IA nu prezic cine urmează judecata agentului, iar cei care au urmat agentul în toate cele patru decizii declară că sunt aproape la fel de siguri pe ei ca ceilalți (71 față de 73 din 100). Anthropic desprinde de aici o miză colectivă: dacă mai multe echipe se bazează pe modele cu aceleași preferințe, consensul lor poate să nu mai fie independent, iar un evaluator uman al cercetărilor privind siguranța IA reprezintă un mecanism de control doar dacă judecata sa îi aparține în continuare.
Restul zilei ține de mentenanță: Copilot CLI și versiunea nightly a Gemini CLI nu adaugă nicio funcție, iar Qwen Code activează implicit o interfață până atunci experimentală, prevăzând totodată ca /autofix-pr să redea controlul unui om după trei eșecuri. În cazul modelelor deschise, valoarea depinde de condițiile de măsurare: fișa AMD cuantifică pierderea de performanță cauzată de cuantizarea sa MXFP4 pe GSM8K, în timp ce Pramaan, AtMem și ViKernel publică rezultate stabilite de propriii autori, pe baza unei singure rulări, a unei versiuni fixe sau a unor instrumente simulate.
Surse
- Studiul Anthropic despre deciziile bazate pe judecata experților
- Copilot CLI 1.0.106-2
- Qwen Code v0.26.5
- Versiunea nightly a Gemini CLI din 1 noiembrie
- @sqs: widgeturile aplicației iOS Amp
- @MiniMax_AI: cuantizări pentru M3.1 Flash
- Fișa Hugging Face pentru MiniMax M3.1 Flash Quark MXFP4 (AMD)
- Articolul lui Kshitij Thakkar despre Pramaan
- Articolul lui Javad Taghia despre AtMem routed-v4
- Articolul VIDRAFT despre ViKernel