ai-powered-markdown-translatorArtigo traduzido do fr para o pt com gpt-6.1-sol.
Um estudo da equipa Alignment da Anthropic, publicado a 27 de outubro na sua página Research sem anúncio no X, mede o peso de um agente de código nas escolhas de analistas especializados: com Claude Code, seguem a preferência do agente em 86 % dos casos. O resto deste domingo resume-se a breves: correções para Copilot CLI, Qwen Code v0.26.5 em versão estável, uma nightly sem alterações de Gemini CLI e widgets iOS para Amp, seguidos das quantizações de MiniMax M3.1 Flash e de três publicações da comunidade no Hugging Face.
Analistas especializados seguem a preferência do seu agente Claude Code em 86 % das escolhas, segundo um estudo da Anthropic
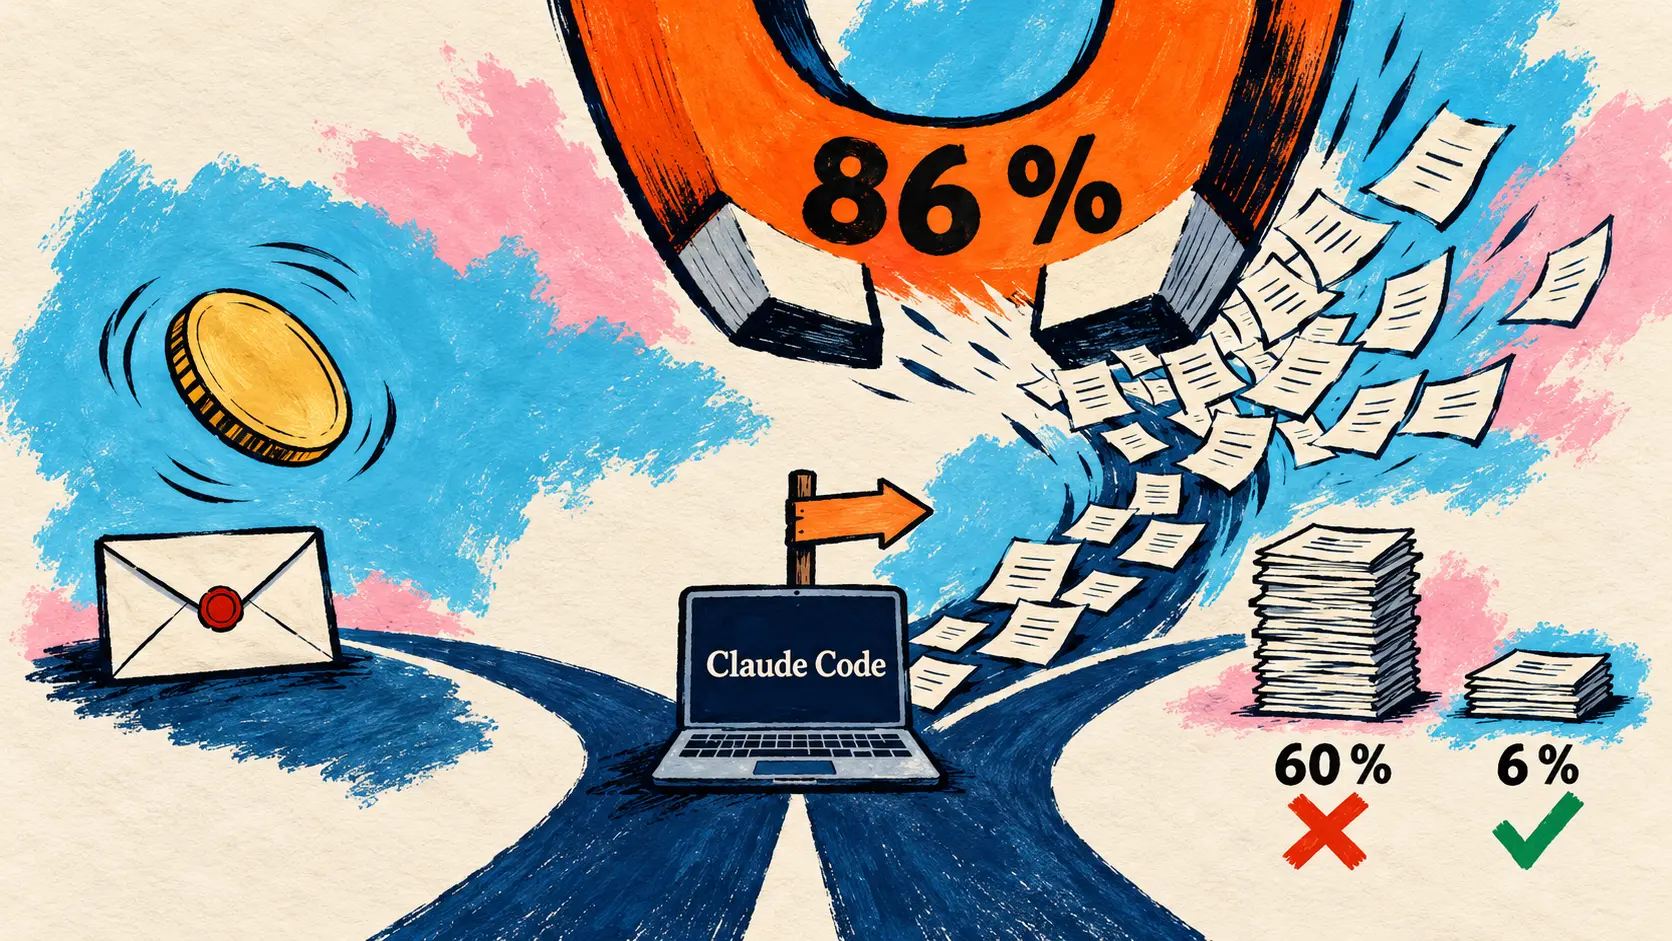
27 de outubro — Recapitulação: a equipa Alignment da Anthropic publica um ensaio controlado aleatorizado sobre as decisões de avaliação (judgment calls) de especialistas. 50 analistas experientes em inferência causal (61 recrutados, 11 preferiram trabalhar sem o agente) aconselham uma cooperativa agrícola fictícia com Claude Code, usando Claude Opus 4.8 com esforço High. Para cada uma das quatro decisões de análise, um lançamento de moeda determina a opção que o agente defende, através de um prompt de sistema oculto; a instrução: defender a sua posição com honestidade, sem nunca enganar.
Os analistas seguem a preferência do agente em 86 % dos casos, face aos cerca de 50 % esperados sem influência. Os que já tinham uma opinião mudam-na em 60 % dos casos quando o agente os contradiz, contra 6 % quando concorda com eles (apenas 38 casos). Posteriormente, 77 % retomam os seus argumentos e 15 % citam-no. Limitações declaradas: preferências deliberadamente reforçadas, uma única tarefa, um único domínio, um único modelo.
Breves
Agentes e CLI de código
- Copilot CLI 1.0.106-2 — Versão de pré-lançamento de 1 de novembro com cinco correções, sem novas funcionalidades: com
--screen-reader, os erros e avisos começam porError:ouWarning:,/resumetraz uma sessão em segundo plano para primeiro plano, e um servidor MCP HTTP que não responde só atrasa o arranque uma vez; a versão estável continua a ser a 1.0.105. 🔗 fonte - Qwen Code v0.26.5 — Versão estável de 1 de novembro, três dias após a v0.26.4: a interface gerada (Generated UI), até então experimental, fica ativada por predefinição, o Managed Agent recebe uma opção experimental de implementação com Helm através de um único comando, e
/autofix-prpassa o controlo a um humano após três envios de correções sem sucesso. 🔗 fonte - Gemini CLI, nightly de 1 de novembro — Sem alterações de código: baseia-se no mesmo commit da versão de 31 de outubro, e apenas o robô de publicação altera os números de versão de 9 ficheiros
package.jsonepackage-lock.json. A versão estável v0.66.0 e a versão de pré-lançamento v0.67.0-preview.0 mantêm-se inalteradas. 🔗 fonte - Widgets iOS da Amp — Recapitulação de 30 de outubro: Quinn Slack, diretor-geral da Amp, anuncia no X widgets para o ecrã inicial que mostram, segundo as suas capturas de ecrã, várias conversas com o respetivo estado ou uma única conversa e a sua ação em curso. A aplicação para iPhone e iPad continua em beta no TestFlight, sem publicação nem documentação. 🔗 fonte
Modelos abertos e bancos de ensaio da comunidade
- Quantizações de MiniMax M3.1 Flash — A MiniMax enumera no X as versões quantizadas do seu MoE de 428B com pesos abertos, incluindo Quark MXFP4 da AMD para Instinct MI350 e MI355 (apenas experts encaminhados, 96,9 % no GSM8K contra 97,2 % segundo a ficha da AMD) e SAGE-EXL3 num único DGX Spark. 🔗 fonte · 🔗 ficha da AMD
- Pramaan — Numa publicação da comunidade no Hugging Face, Kshitij Thakkar apresenta um banco de 72 tarefas com padrões geométricos inspirados nas tradições indianas, controlados por um verificador. Segundo as suas medições, numa única execução, GPT-6 Astra lidera à primeira tentativa (81,9 %); com três tentativas, Claude Opus 5.5 passa de 8,3 % para 90,3 %. 🔗 fonte
- AtMem routed-v4 no DolphinBench — Numa publicação da comunidade, Javad Taghia avalia a sua biblioteca de memória para agentes, que conclui com sucesso 479 tarefas em 600 (79,83 %) neste banco de ensaio da Mem0, contra 390 na execução anterior. Execução e avaliação próprias, sem contar como resultado oficial na classificação, apenas para a versão fixa AtMem 2.3.10b1. 🔗 fonte
- ViKernel — Numa publicação da comunidade, VIDRAFT (FINAL-Bench) apresenta uma demonstração v0.1 que integraria nos pesos de um modelo os controlos de um agente, incluindo o botão de paragem. Sem código nem pesos: a demo reproduz respostas gravadas. O único número, proveniente de uma auditoria interna com ferramentas simuladas: 0 transferências de saída não solicitadas em 661 execuções. 🔗 fonte
O que isto significa
O estudo da Anthropic desloca a questão da qualidade de um agente para a independência de quem o supervisiona. Os analistas não foram enganados, uma vez que o agente tinha de defender a sua posição com honestidade, e, ainda assim, os quatro lançamentos de moeda bastam para prever 82 % das suas recomendações finais, contra 61 % quando se adivinha sempre a mais frequente. Nem a experiência, nem o diploma, nem a confiança na IA permitem prever quem se entrega ao critério do agente, e os que seguiram o agente nas quatro escolhas declaram-se quase tão seguros de si como os restantes (71 contra 73 em 100). A Anthropic identifica aqui uma questão coletiva: se várias equipas se apoiarem em modelos com as mesmas preferências, a sua concordância pode deixar de ser independente, e um revisor humano de investigação em segurança da IA só funciona como controlo se mantiver o seu próprio discernimento.
O resto do dia é dedicado à manutenção: Copilot CLI e a nightly de Gemini CLI não acrescentam funcionalidades, e Qwen Code ativa por predefinição uma interface até então experimental, prevendo também que /autofix-pr devolva o controlo a um humano após três falhas. Quanto aos modelos abertos, o valor está nas condições de medição: a ficha da AMD quantifica o custo da sua quantização MXFP4 no GSM8K, enquanto Pramaan, AtMem e ViKernel publicam resultados obtidos pelos seus próprios autores, numa única execução, numa versão fixa ou com ferramentas simuladas.
Fontes
- Estudo da Anthropic sobre as decisões de avaliação dos especialistas
- Copilot CLI 1.0.106-2
- Qwen Code v0.26.5
- Nightly de Gemini CLI de 1 de novembro
- @sqs: widgets da aplicação iOS da Amp
- @MiniMax_AI: quantizações de M3.1 Flash
- Ficha no Hugging Face de MiniMax M3.1 Flash Quark MXFP4 (AMD)
- Publicação de Kshitij Thakkar sobre Pramaan
- Publicação de Javad Taghia sobre AtMem routed-v4
- Publicação de VIDRAFT sobre ViKernel