ai-powered-markdown-translatorArtikel mit gpt-6.1-sol aus dem Französischen ins Deutsche übersetzt.
Eine Studie des Alignment-Teams von Anthropic, die am 27. Oktober auf dessen Research-Seite ohne Ankündigung auf X veröffentlicht wurde, misst den Einfluss eines Code-Agenten auf die Entscheidungen erfahrener Analysten: Mit Claude Code folgen sie in 86 % der Fälle der Präferenz des Agenten. Der Rest dieses Sonntags lässt sich in Kurzmeldungen zusammenfassen: Korrekturen für Copilot CLI, Qwen Code v0.26.5 als stabile Version, eine unveränderte Nightly von Gemini CLI und iOS-Widgets für Amp, außerdem die Quantisierungen von MiniMax M3.1 Flash und drei auf Hugging Face veröffentlichte Community-Beiträge.
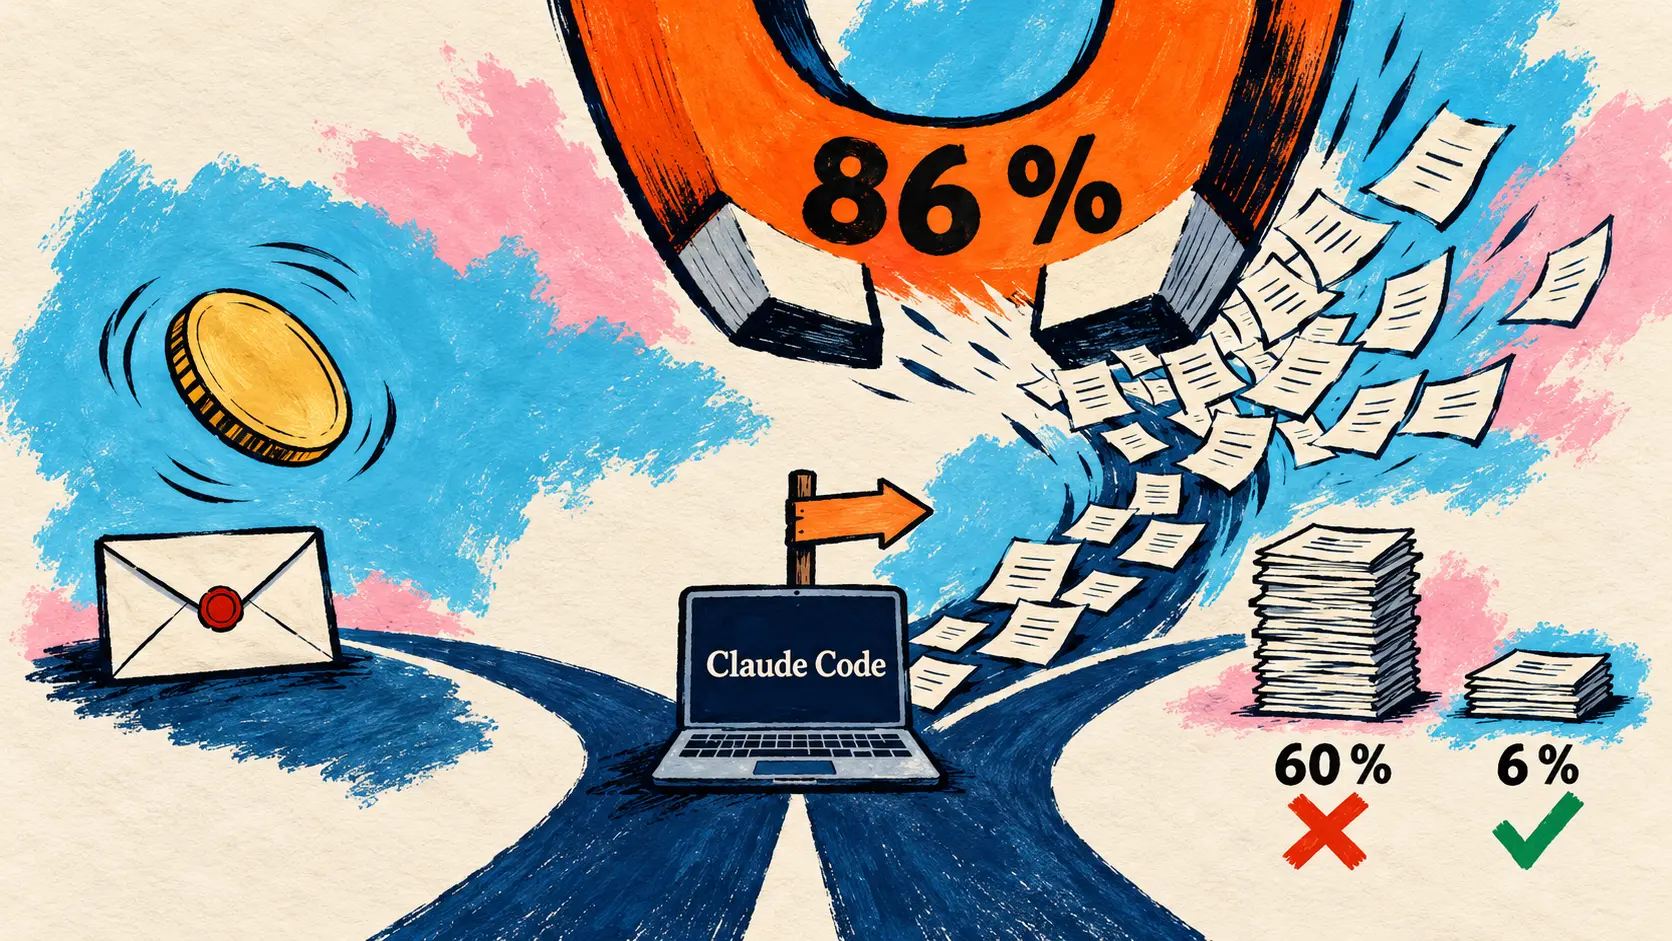
Erfahrene Analysten folgen laut einer Anthropic-Studie bei 86 % der Entscheidungen der Präferenz ihres Agenten Claude Code
27. Oktober — Nachtrag: Das Alignment-Team von Anthropic veröffentlicht eine randomisierte kontrollierte Studie zu Ermessensentscheidungen (judgment calls) von Experten. 50 in kausaler Inferenz erfahrene Analysten (61 rekrutiert, 11 zogen es vor, ohne den Agenten zu arbeiten) beraten eine fiktive landwirtschaftliche Genossenschaft mit Claude Code auf Basis von Claude Opus 4.8 mit der Effort-Einstellung High. Für jede der vier Analyseentscheidungen legt ein Münzwurf über einen verborgenen System-Prompt fest, welche Option der Agent vertritt; die Vorgabe: ehrlich argumentieren, ohne jemals zu täuschen.
Die Analysten folgen in 86 % der Fälle der Präferenz des Agenten, gegenüber den etwa 50 %, die ohne Einfluss zu erwarten wären. Wer bereits eine Meinung hatte, ändert sie in 60 % der Fälle, wenn der Agent widerspricht, gegenüber 6 %, wenn er zustimmt (nur 38 Fälle). Im Nachhinein übernehmen 77 % seine Argumente, 15 % nennen ihn als Quelle. Angegebene Einschränkungen: bewusst verstärkte Präferenzen, nur eine Aufgabe, ein Fachgebiet und ein Modell.
Kurzmeldungen
Code-Agenten und CLIs
- Copilot CLI 1.0.106-2 — Vorabversion vom 1. November mit fünf Korrekturen, ohne neue Funktion: Mit
--screen-readerbeginnen Fehler und Warnungen mitError:oderWarning:,/resumeholt eine Hintergrundsitzung in den Vordergrund, und ein nicht antwortender MCP-HTTP-Server verzögert den Start nur noch einmal; die stabile Version bleibt 1.0.105. 🔗 Quelle - Qwen Code v0.26.5 — Stabile Version vom 1. November, drei Tage nach v0.26.4: Die bisher experimentelle generierte Benutzeroberfläche (Generated UI) ist standardmäßig aktiviert, der Managed Agent erhält ein experimentelles Helm-Deployment mit einem einzigen Befehl, und
/autofix-prübergibt nach drei erfolglosen Pushes mit Korrekturen an einen Menschen. 🔗 Quelle - Gemini CLI, Nightly vom 1. November — Keine Codeänderung: Sie basiert auf demselben Commit wie die Version vom 31. Oktober, und nur der Release-Bot ändert die Versionsnummern in 9 Dateien
package.jsonundpackage-lock.json. Die stabile Version v0.66.0 und die Vorabversion v0.67.0-preview.0 bleiben unverändert. 🔗 Quelle - iOS-Widgets von Amp — Nachtrag zum 30. Oktober: Quinn Slack, Geschäftsführer von Amp, kündigt auf X Widgets für den Home-Bildschirm an, die seinen Screenshots zufolge mehrere Threads mit ihrem Status oder einen einzelnen Thread mit seiner laufenden Aktion anzeigen. Die App für iPhone und iPad bleibt eine TestFlight-Beta, ohne Blogbeitrag oder Dokumentation. 🔗 Quelle
Offene Modelle und Community-Benchmarks
- Quantisierungen von MiniMax M3.1 Flash — MiniMax listet auf X die quantisierten Versionen seines 428B-MoE mit offenen Gewichten auf, darunter Quark MXFP4 von AMD für Instinct MI350 und MI355 (nur geroutete Experten, 96,9 % auf GSM8K gegenüber 97,2 % laut AMD-Modellkarte) und SAGE-EXL3 auf einem einzigen DGX Spark. 🔗 Quelle · 🔗 AMD-Modellkarte
- Pramaan — In einem Community-Beitrag auf Hugging Face stellt Kshitij Thakkar einen Benchmark mit 72 Aufgaben zu geometrischen Mustern vor, die von indischen Traditionen inspiriert sind und durch einen Verifikator geprüft werden. Seinen Messungen aus einem einzigen Durchlauf zufolge führt GPT-6 Astra beim ersten Versuch (81,9 %); mit drei Versuchen steigt Claude Opus 5.5 von 8,3 % auf 90,3 %. 🔗 Quelle
- AtMem routed-v4 auf DolphinBench — In einem Community-Beitrag misst Javad Taghia für seine Speicherbibliothek für Agenten 479 erfolgreich gelöste Aufgaben von 600 (79,83 %) auf diesem Benchmark von Mem0, gegenüber 390 im vorherigen Durchlauf. Ausführung und Bewertung erfolgen in Eigenregie, gelten nicht als offizieller Ranglisteneintrag und beziehen sich ausschließlich auf die festgeschriebene Version AtMem 2.3.10b1. 🔗 Quelle
- ViKernel — In einem Community-Beitrag stellt VIDRAFT (FINAL-Bench) eine Demo v0.1 vor, die die Steuerungsmechanismen eines Agenten einschließlich Abschaltknopf in den Gewichten eines Modells unterbringen soll. Weder Code noch Gewichte sind verfügbar: Die Demo spielt aufgezeichnete Antworten ab. Die einzige Kennzahl stammt aus einem internen Audit mit simulierten Tools: 0 nicht angeforderte ausgehende Übertragungen bei 661 Durchläufen. 🔗 Quelle
Was das bedeutet
Die Studie von Anthropic verschiebt die Frage von der Qualität eines Agenten hin zur Unabhängigkeit der Person, die ihn beaufsichtigt. Die Analysten wurden nicht getäuscht, da der Agent ehrlich argumentieren musste, und dennoch reichen die vier Münzwürfe aus, um 82 % ihrer endgültigen Empfehlungen vorherzusagen, gegenüber 61 %, wenn man immer auf die häufigste tippt. Weder Erfahrung noch Bildungsabschluss noch Vertrauen in KI sagen voraus, wer sich auf den Agenten verlässt, und diejenigen, die dem Agenten bei allen vier Entscheidungen folgten, geben sich fast ebenso sicher wie die anderen (71 gegenüber 73 von 100). Anthropic leitet daraus eine kollektive Herausforderung ab: Wenn sich mehrere Teams auf Modelle mit denselben Präferenzen stützen, ist ihre Übereinstimmung möglicherweise nicht mehr unabhängig, und ein menschlicher Gutachter für Forschung zur KI-Sicherheit stellt nur dann eine Kontrolle dar, wenn sein Urteil sein eigenes bleibt.
Der Rest des Tages steht im Zeichen der Wartung: Copilot CLI und die Nightly von Gemini CLI bringen keine neuen Funktionen, und Qwen Code aktiviert eine bislang experimentelle Benutzeroberfläche standardmäßig und sieht zugleich vor, dass /autofix-pr nach drei Fehlschlägen die Kontrolle an einen Menschen zurückgibt. Bei offenen Modellen liegt der Wert in den Messbedingungen: Die AMD-Modellkarte beziffert, welche Einbußen ihre MXFP4-Quantisierung auf GSM8K verursacht, während Pramaan, AtMem und ViKernel Ergebnisse veröffentlichen, die ihre eigenen Autoren anhand eines einzigen Durchlaufs, einer festgeschriebenen Version oder simulierter Tools ermittelt haben.
Quellen
- Anthropic-Studie zu Ermessensentscheidungen von Experten
- Copilot CLI 1.0.106-2
- Qwen Code v0.26.5
- Nightly von Gemini CLI vom 1. November
- @sqs: Widgets der iOS-App von Amp
- @MiniMax_AI: Quantisierungen von M3.1 Flash
- Hugging-Face-Modellkarte von MiniMax M3.1 Flash Quark MXFP4 (AMD)
- Beitrag von Kshitij Thakkar über Pramaan
- Beitrag von Javad Taghia über AtMem routed-v4
- Beitrag von VIDRAFT über ViKernel