ai-powered-markdown-translatorArtikel vertaald van het Frans naar het Nederlands met gpt-6.1-sol.
Een onderzoek van het Alignment-team van Anthropic, op 27 oktober gepubliceerd op de Research-pagina zonder aankondiging op X, meet hoeveel invloed een codeagent heeft op de keuzes van ervaren analisten: met Claude Code volgen ze in 86 % van de gevallen de voorkeur van de agent. De overige berichten van deze zondag zijn kort: fixes voor Copilot CLI, Qwen Code v0.26.5 als stabiele versie, een nightly van Gemini CLI zonder wijzigingen en iOS-widgets voor Amp, gevolgd door de kwantisaties van MiniMax M3.1 Flash en drie communitybijdragen op Hugging Face.
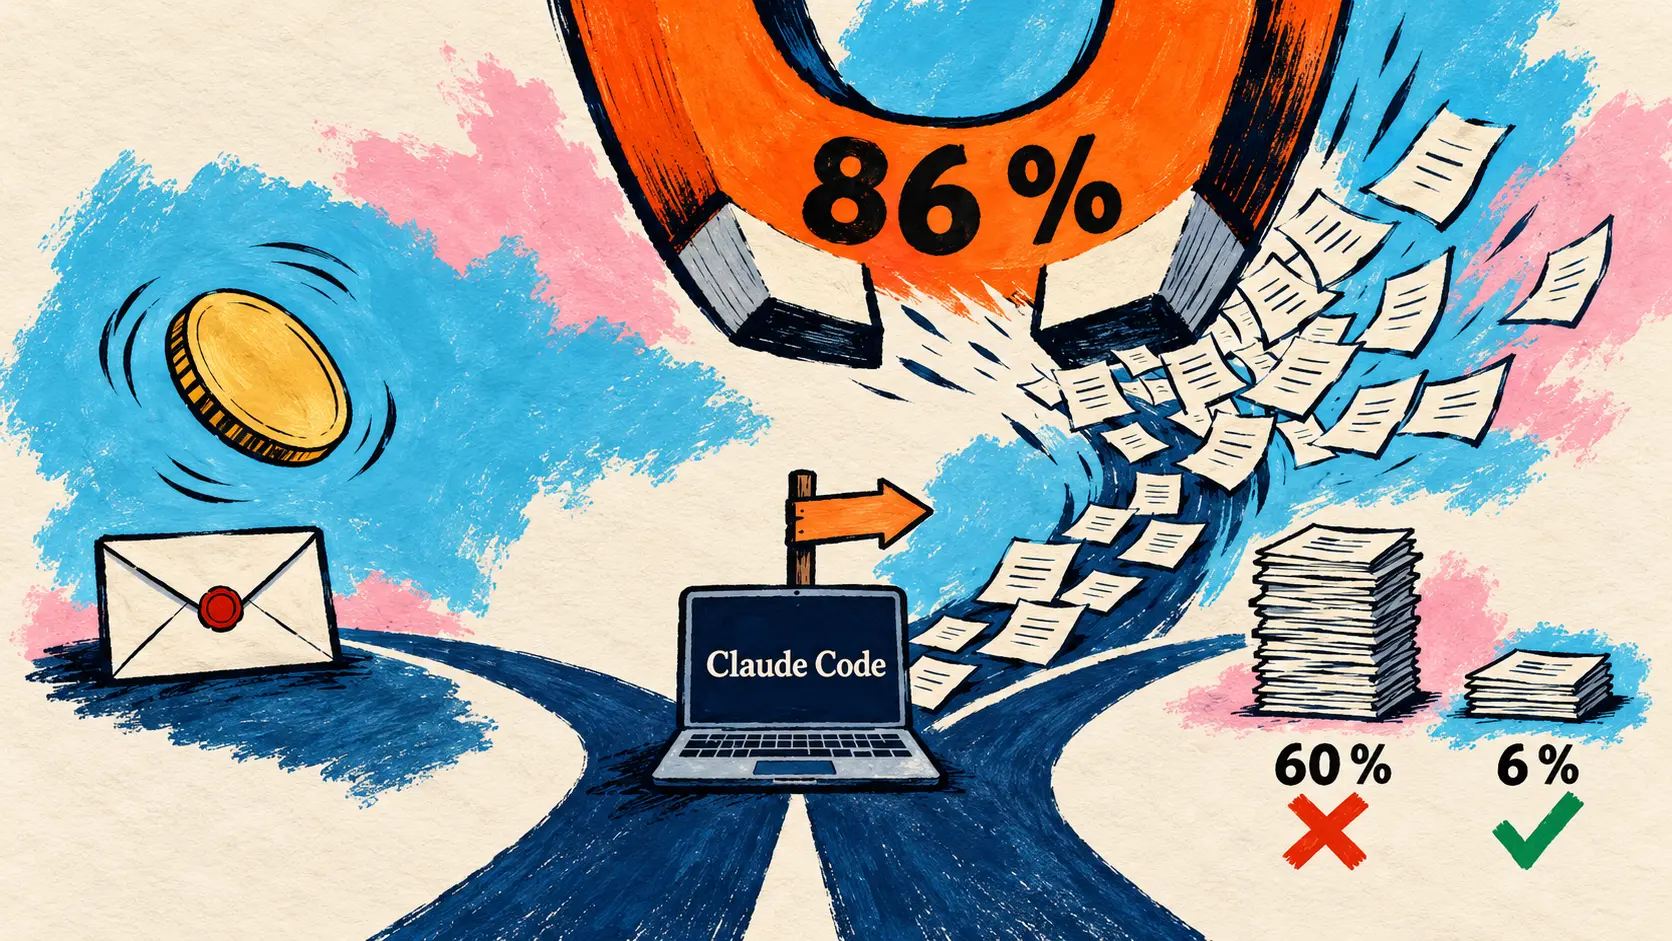
Ervaren analisten volgen bij 86 % van de keuzes de voorkeur van hun Claude Code-agent, volgens een onderzoek van Anthropic
27 oktober — Terugblik: het Alignment-team van Anthropic publiceert een gerandomiseerd gecontroleerd onderzoek naar beoordelingskeuzes (judgment calls) van experts. 50 analisten met veel ervaring in causale inferentie (61 geworven, 11 werkten liever zonder de agent) adviseren een fictieve landbouwcoöperatie met Claude Code, op Claude Opus 4.8 met inspanningsniveau High. Voor elk van de vier analysekeuzes bepaalt een muntworp welke optie de agent verdedigt, via een verborgen systeemprompt; de instructie: eerlijk argumenteren, zonder ooit te misleiden.
De analisten volgen in 86 % van de gevallen de voorkeur van de agent, tegenover de ongeveer 50 % die zonder invloed wordt verwacht. Wie al een mening had, verandert die in 60 % van de gevallen wanneer de agent die tegenspreekt, tegenover 6 % wanneer de agent ermee instemt (slechts 38 gevallen). Achteraf neemt 77 % de argumenten van de agent over en citeert 15 % de agent. Vermelde beperkingen: bewust versterkte voorkeuren, één taak, één domein, één model.
Korte berichten
Agents en CLI’s voor code
- Copilot CLI 1.0.106-2 — Pre-release van 1 november met vijf fixes, zonder nieuwe functies: met
--screen-readerbeginnen foutmeldingen en waarschuwingen metError:ofWarning:, haalt/resumeeen achtergrondsessie naar de voorgrond en vertraagt een niet-reagerende MCP HTTP-server het opstarten nog maar één keer; de stabiele versie blijft 1.0.105. 🔗 bron - Qwen Code v0.26.5 — Stabiele versie van 1 november, drie dagen na v0.26.4: de gegenereerde interface (Generated UI), die tot dan toe experimenteel was, is standaard ingeschakeld, de Managed Agent krijgt een experimentele Helm-deployment met één commando en
/autofix-prdraagt de controle over aan een mens na drie pushes met fixes die niets opleveren. 🔗 bron - Gemini CLI, nightly van 1 november — Geen codewijzigingen: deze is gebaseerd op dezelfde commit als die van 31 oktober, en alleen de publicatiebot wijzigt de versienummers van 9 bestanden
package.jsonenpackage-lock.json. De stabiele versie v0.66.0 en de pre-release v0.67.0-preview.0 blijven ongewijzigd. 🔗 bron - iOS-widgets van Amp — Terugblik op 30 oktober: Quinn Slack, algemeen directeur van Amp, kondigt op X widgets voor het beginscherm aan die volgens zijn screenshots meerdere threads met hun status tonen, of één thread met de lopende actie. De app voor iPhone en iPad blijft een TestFlight-bèta, zonder blogbericht of documentatie. 🔗 bron
Open modellen en benchmarks uit de community
- Kwantisaties van MiniMax M3.1 Flash — MiniMax somt op X de gekwantiseerde versies op van zijn MoE van 428B met open gewichten, waaronder Quark MXFP4 van AMD voor de Instinct MI350 en MI355 (alleen gerouteerde experts, 96,9 % op GSM8K tegenover 97,2 % volgens de modelkaart van AMD) en SAGE-EXL3 op één DGX Spark. 🔗 bron · 🔗 modelkaart van AMD
- Pramaan — In een communitybijdrage op Hugging Face presenteert Kshitij Thakkar een benchmark met 72 taken rond geometrische patronen die zijn geïnspireerd op Indiase tradities en door een verificator worden gecontroleerd. Volgens zijn metingen, op basis van één run, gaat GPT-6 Astra bij de eerste poging aan kop (81,9 %); met drie pogingen stijgt Claude Opus 5.5 van 8,3 % naar 90,3 %. 🔗 bron
- AtMem routed-v4 op DolphinBench — In een communitybijdrage meet Javad Taghia met zijn geheugenbibliotheek voor agents 479 geslaagde taken uit 600 (79,83 %) op deze benchmark van Mem0, tegenover 390 bij de vorige run. Uitvoering en beoordeling in eigen beheer, zonder status als officiële inzending voor de ranglijst, uitsluitend voor de vastgezette versie AtMem 2.3.10b1. 🔗 bron
- ViKernel — In een communitybijdrage presenteert VIDRAFT (FINAL-Bench) een v0.1-demo die de besturingsmechanismen van een agent, inclusief stopknop, in de gewichten van een model zou onderbrengen. Geen code of gewichten: de demo speelt opgenomen antwoorden af. Het enige cijfer, afkomstig uit een interne audit met gesimuleerde tools: 0 ongevraagde uitgaande overdrachten op 661 runs. 🔗 bron
Wat dit betekent
Het onderzoek van Anthropic verschuift de vraag van de kwaliteit van een agent naar de onafhankelijkheid van degene die er toezicht op houdt. De analisten zijn niet misleid, aangezien de agent eerlijk moest argumenteren, en toch volstaan de vier muntworpen om 82 % van hun uiteindelijke aanbevelingen te voorspellen, tegenover 61 % als steeds de meest voorkomende wordt geraden. Ervaring, opleidingsniveau en vertrouwen in AI voorspellen geen van alle wie op de agent afgaat, en degenen die de agent bij alle vier de keuzes volgden, zeggen bijna even zeker van zichzelf te zijn als de anderen (71 tegenover 73 op 100). Anthropic leidt hieruit een collectief vraagstuk af: als meerdere teams steunen op modellen met dezelfde voorkeuren, is hun overeenstemming mogelijk niet langer onafhankelijk, en een menselijke beoordelaar van onderzoek naar AI-veiligheid vormt alleen een controle als diens oordeel het eigen oordeel blijft.
De rest van de dag draait om onderhoud: Copilot CLI en de nightly van Gemini CLI voegen geen functies toe, en Qwen Code schakelt een tot dan toe experimentele interface standaard in, terwijl het erin voorziet dat /autofix-pr na drie mislukkingen de controle aan een mens teruggeeft. Bij open modellen hangt de waarde af van de meetomstandigheden: de modelkaart van AMD becijfert wat zijn MXFP4-kwantisatie aan prestaties kost op GSM8K, terwijl Pramaan, AtMem en ViKernel resultaten publiceren die door hun eigen auteurs zijn vastgesteld, op basis van één run, een vastgezette versie of gesimuleerde tools.
Bronnen
- Onderzoek van Anthropic naar beoordelingskeuzes van experts
- Copilot CLI 1.0.106-2
- Qwen Code v0.26.5
- Nightly van Gemini CLI van 1 november
- @sqs: widgets van de iOS-app van Amp
- @MiniMax_AI: kwantisaties van M3.1 Flash
- Hugging Face-modelkaart van MiniMax M3.1 Flash Quark MXFP4 (AMD)
- Bijdrage van Kshitij Thakkar over Pramaan
- Bijdrage van Javad Taghia over AtMem routed-v4
- Bijdrage van VIDRAFT over ViKernel