ai-powered-markdown-translatorgpt-6.1-solを使用してフランス語から日本語に翻訳された記事。
Anthropicのアラインメントチームが、Xでの告知なしに10月27日に同社の研究ページで公開した研究では、コーディングエージェントが専門アナリストの選択に及ぼす影響の大きさを測定している。Claude Codeを使った場合、アナリストは86 %のケースでエージェントの選好に従った。この日曜日のそのほかの話題は短報でまとめる。Copilot CLIの修正、Qwen Code v0.26.5の安定版、変更のないGemini CLIのナイトリー版、AmpのiOSウィジェットに続き、MiniMax M3.1 Flashの量子化版とHugging Faceで公開された3本のコミュニティ記事を取り上げる。
Anthropicの研究によると、専門アナリストは選択の86 %でClaude Codeエージェントの選好に従う
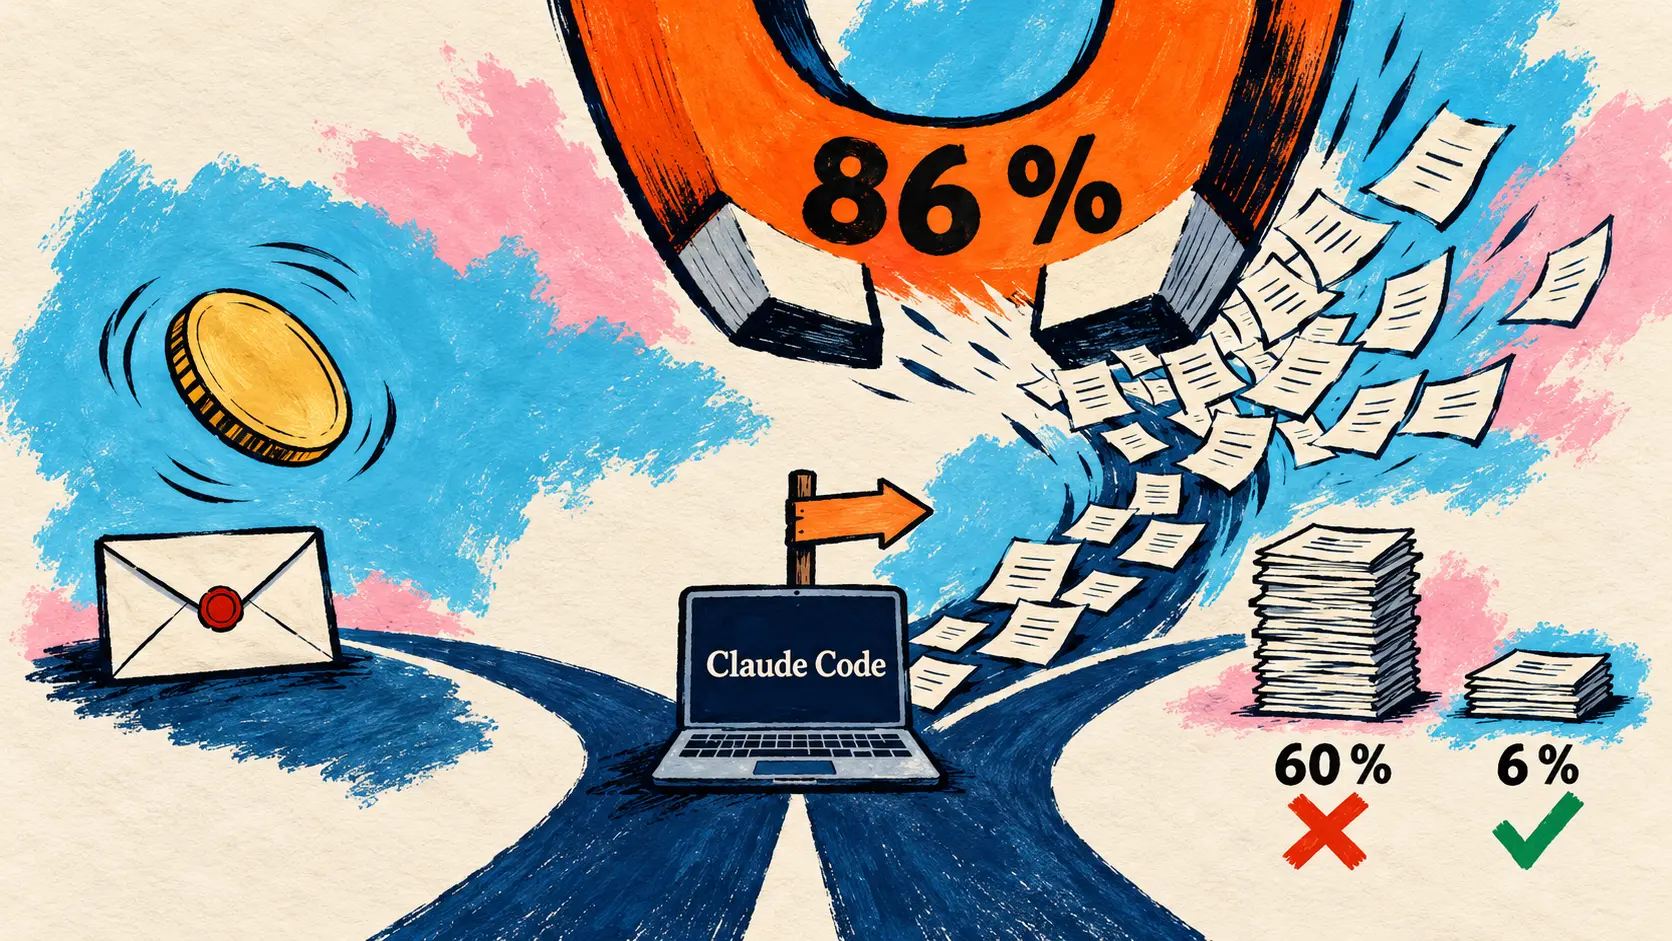
10月27日 — 補足:Anthropicのアラインメントチームが、専門家の判断に委ねられる選択(裁量的判断)に関するランダム化比較試験を公開した。因果推論に熟練した50人のアナリスト(61人を募集し、11人はエージェントを使わずに作業することを選択)が、推論の労力をHighに設定したClaude Opus 4.8を使うClaude Codeで、架空の農業協同組合に助言する。分析における4つの選択それぞれについて、コイントスでエージェントが支持する選択肢を決め、非公開のシステムプロンプトで指定する。指示は、決して欺かず、誠実にその選択肢を支持する論を述べることだった。
アナリストは86 %のケースでエージェントの選好に従った。影響がなければ、約50 %になると見込まれる。すでに意見を持っていた人が意見を変えた割合は、エージェントが反対した場合は60 %、賛成した場合は6 %だった(後者はわずか38件)。事後には77 %がエージェントの論拠を取り入れ、15 %がエージェントを引用した。明示された限界として、選好を意図的に強めていること、課題、分野、モデルがそれぞれ1つだけであることが挙げられている。
短報
コーディングエージェントとCLI
- Copilot CLI 1.0.106-2 — 11月1日のプレビュー版は5件の修正で構成され、新機能はない。
--screen-readerではエラーと警告がError:またはWarning:で始まり、/resumeでバックグラウンドのセッションをフォアグラウンドに戻せるようになった。また、応答しないMCP HTTPサーバーによる起動待ちは1回だけになった。安定版は1.0.105のまま。🔗 出典 - Qwen Code v0.26.5 — v0.26.4から3日後となる11月1日の安定版。これまで実験的だった生成インターフェース(Generated UI)が既定で有効になり、Managed Agentには1コマンドで実行できる実験的なHelmデプロイが加わった。また、修正を3回プッシュしても成功しなかった場合、
/autofix-prが人間に引き継ぐ。🔗 出典 - Gemini CLI、11月1日のナイトリー版 — コードの変更はない。10月31日版と同じコミットに基づき、リリース用ボットが9個の
package.jsonおよびpackage-lock.jsonファイルのバージョン番号を変更しただけだ。安定版v0.66.0とプレビュー版v0.67.0-preview.0に変更はない。🔗 出典 - AmpのiOSウィジェット — 10月30日の補足:Ampの最高経営責任者クイン・スラックが、ホーム画面用ウィジェットをXで発表した。掲載されたスクリーンショットによると、複数のスレッドとそれぞれの状態、または1つのスレッドと進行中の処理を表示する。iPhoneおよびiPadアプリは引き続きTestFlightのベータ版で、記事やドキュメントはない。🔗 出典
オープンモデルとコミュニティによるベンチマーク
- MiniMax M3.1 Flashの量子化版 — MiniMaxが、重みを公開した428BのMoEの量子化版をXで紹介している。Instinct MI350およびMI355向けのAMDのQuark MXFP4(ルーティング対象のエキスパートのみを量子化。AMDのモデルカードによるとGSM8Kで96,9 %、比較対象は97,2 %)や、1台のDGX Sparkで動くSAGE-EXL3などが含まれる。🔗 出典 · 🔗 AMDのモデルカード
- Pramaan — Hugging Faceのコミュニティ記事で、クシティジ・タッカルが、インドの伝統に着想を得た幾何学模様の72タスクからなり、検証器で判定されるベンチマークを紹介している。1回の実行での本人の測定によると、初回の試行ではGPT-6 Astraが首位(81,9 %)。3回試行すると、Claude Opus 5.5は8,3 %から90,3 %に上昇する。🔗 出典
- DolphinBenchでのAtMem routed-v4 — コミュニティ記事で、ジャヴァド・タギアが自作のエージェント用メモリライブラリを測定し、Mem0のこのベンチマークで600タスク中479タスクに成功(79,83 %)したと報告している。前回の390タスクから増加した。実行と採点は独自に行われ、公式ランキングへの登録としては扱われない。対象はバージョンを固定したAtMem 2.3.10b1のみ。🔗 出典
- ViKernel — コミュニティ記事で、VIDRAFT(FINAL-Bench)が、停止ボタンを含むエージェントの制御機構をモデルの重みの中に組み込むというv0.1のデモを紹介している。コードも重みも公開されておらず、デモでは記録済みの応答を再生する。唯一の数値は、模擬ツールを使った内部監査によるもので、661回の実行で要求されていない外部への転送は0件だった。🔗 出典
これが意味すること
Anthropicの研究は、エージェントの品質から、それを監督する人の判断の独立性へと論点を移している。エージェントには誠実に論じるよう指示されていたため、アナリストは欺かれていない。それでも、4回のコイントスの結果だけで最終提言の82 %を予測できる。常に最も頻度の高い提言を推測した場合は61 %だった。経験、学歴、人工知能への信頼度のいずれからも、誰がエージェントに判断を委ねるかは予測できない。また、4つの選択すべてでエージェントに従った人の自己評価による確信度は、ほかの人とほぼ同じだった(100点中71対73)。Anthropicはここから、集団全体に関わる課題を導き出している。複数のチームが同じ選好を持つモデルに依存する場合、チーム間の意見の一致は独立した判断の結果ではなくなる可能性がある。そして、人工知能の安全性研究を人間がレビューすることがチェックとして機能するのは、その判断が本人のものであり続ける場合だけだ。
そのほかの話題は保守作業が中心だ。Copilot CLIとGemini CLIのナイトリー版には新機能がなく、Qwen Codeはこれまで実験的だったインターフェースを既定で有効にするとともに、3回失敗したら/autofix-prが人間に引き継ぐ仕組みを用意している。オープンモデルについては、測定条件が結果の価値を左右する。AMDのモデルカードはMXFP4量子化によるGSM8Kでの性能低下を数値で示している一方、Pramaan、AtMem、ViKernelは、それぞれ1回の実行、固定されたバージョン、模擬ツールという条件で、開発者自身が測定した結果を公開している。