ai-powered-markdown-translatorمقال مترجم من الفرنسية إلى العربية باستخدام gpt-6.1-sol.
تقيس دراسة لفريق المواءمة في Anthropic، نُشرت في 27 أكتوبر على صفحة الأبحاث لديها دون إعلان على X، مدى تأثير وكيل برمجة في خيارات محللين خبراء: مع Claude Code، يتبعون الخيار الذي يفضّله الوكيل في 86 % من الحالات. أما بقية أخبار هذا الأحد فتأتي في موجزات: إصلاحات لـ Copilot CLI، وانتقال Qwen Code v0.26.5 إلى الإصدار المستقر، وإصدار ليلي بلا تغييرات من Gemini CLI وعناصر واجهة iOS لـ Amp، ثم نسخ مكمّمة من MiniMax M3.1 Flash وثلاث تدوينات مجتمعية نُشرت على Hugging Face.
محللون خبراء يتبعون تفضيل وكيلهم Claude Code في 86 % من الخيارات، وفقًا لدراسة أجرتها Anthropic
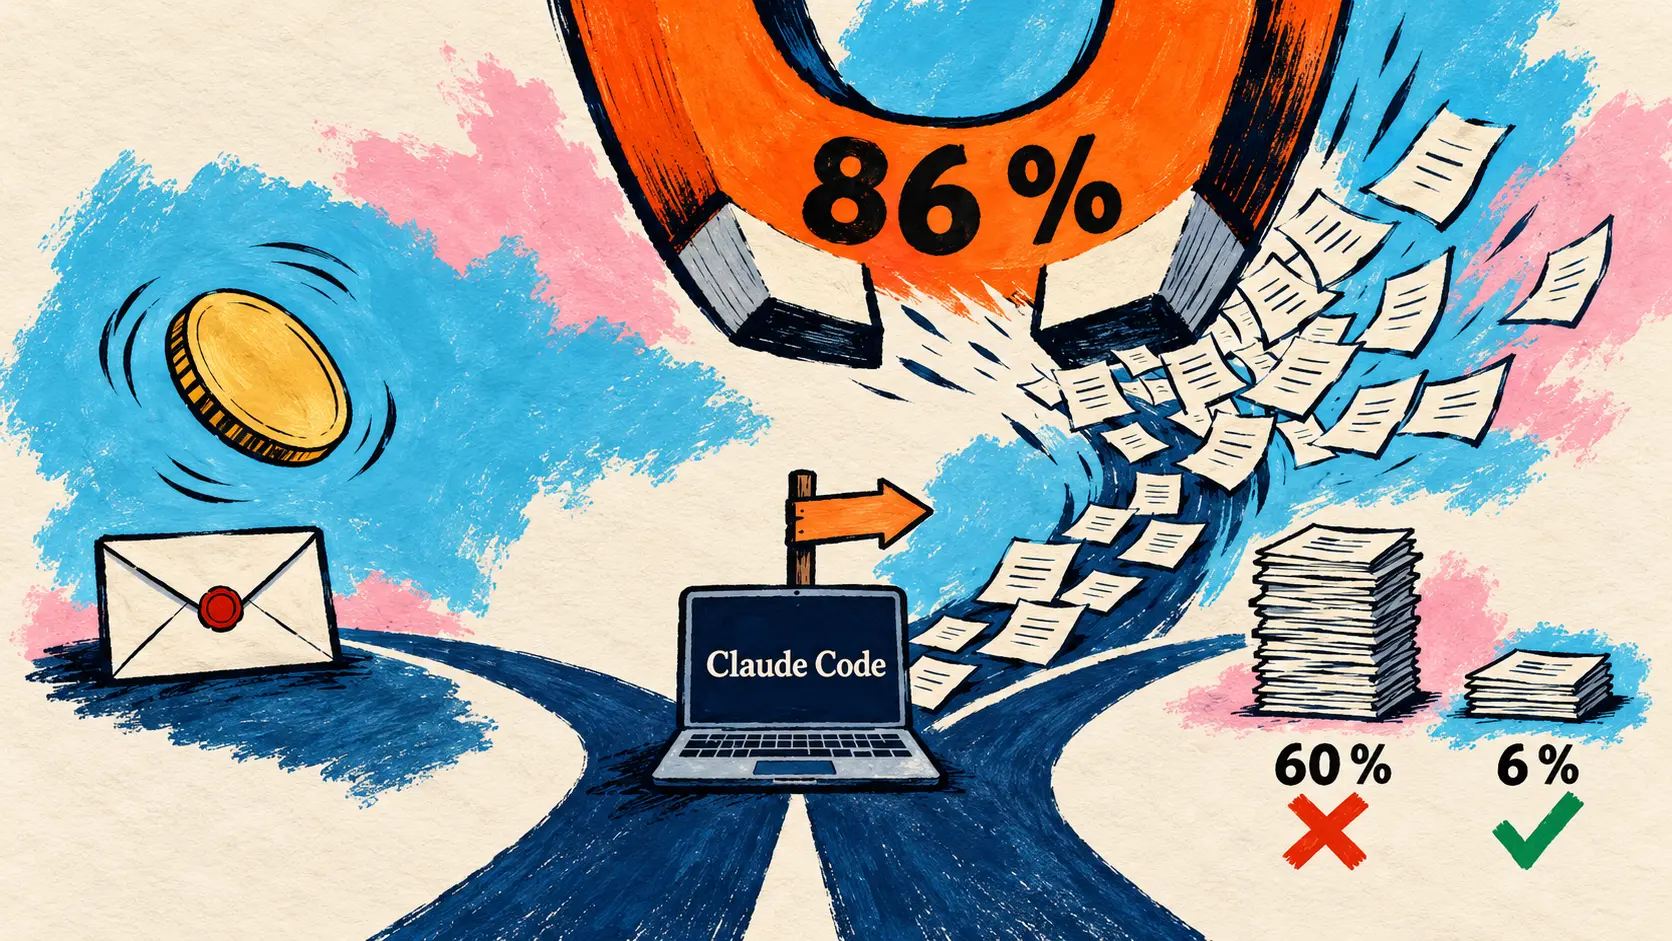
27 أكتوبر — استدراك: ينشر فريق المواءمة في Anthropic تجربة عشوائية مضبوطة حول خيارات الخبراء القائمة على التقدير (الأحكام التقديرية). يقدّم 50 محللًا متمرسًا في الاستدلال السببي (استُقطب 61 محللًا، وفضّل 11 منهم العمل دون الوكيل) مشورة لتعاونية زراعية وهمية باستخدام Claude Code، الذي يعمل بنموذج Claude Opus 4.8 مع مستوى جهد High. ولكل واحد من خيارات التحليل الأربعة، تحدّد رمية عملة الخيار الذي يدافع عنه الوكيل، بواسطة موجّه نظام مخفي؛ والتعليمات هي: الدفاع عن الخيار بصدق، دون تضليل مطلقًا.
يتبع المحللون تفضيل الوكيل في 86 % من الحالات، مقابل نحو 50 % متوقعة في غياب التأثير. ويغيّر من كانت لديهم آراء مسبقة رأيهم في 60 % من الحالات حين يخالفهم الوكيل، مقابل 6 % حين يوافقهم (38 حالة فقط). وبعد ذلك، يعيد 77 % استخدام حججه، ويستشهد به 15 %. حدود الدراسة المعلنة: تعزيز التفضيلات عمدًا، ومهمة واحدة، ومجال واحد، ونموذج واحد.
أخبار موجزة
وكلاء البرمجة وأدوات CLI
- Copilot CLI 1.0.106-2 — إصدار أولي بتاريخ 1 نوفمبر يضم خمسة إصلاحات، دون وظيفة جديدة: عند استخدام
--screen-reader، تبدأ الأخطاء والتحذيرات بـError:أوWarning:، ويعيد/resumeجلسة تعمل في الخلفية إلى الواجهة، ولم يعد خادم MCP HTTP الذي لا يستجيب يؤخّر بدء التشغيل إلا مرة واحدة؛ ويبقى الإصدار المستقر هو 1.0.105. 🔗 المصدر - Qwen Code v0.26.5 — إصدار مستقر بتاريخ 1 نوفمبر، بعد ثلاثة أيام من v0.26.4: أصبحت الواجهة المولّدة (Generated UI)، التي كانت تجريبية حتى الآن، مفعّلة افتراضيًا، وحصل Managed Agent على إمكانية نشر تجريبية باستخدام Helm بأمر واحد، ويُحيل
/autofix-prالمهمة إلى شخص بعد ثلاث دفعات غير ناجحة من الإصلاحات. 🔗 المصدر - Gemini CLI، الإصدار الليلي بتاريخ 1 نوفمبر — لا تغييرات في الشيفرة: يعتمد على نفس التثبيت الذي استند إليه إصدار 31 أكتوبر، ولا يغيّر سوى روبوت النشر أرقام الإصدارات في 9 ملفات
package.jsonوpackage-lock.json. ويظل الإصدار المستقر v0.66.0 والإصدار الأولي v0.67.0-preview.0 دون تغيير. 🔗 المصدر - عناصر واجهة iOS في Amp — استدراك لأخبار 30 أكتوبر: يعلن كوين سلاك، الرئيس التنفيذي لـ Amp، على X عن عناصر واجهة للشاشة الرئيسية تعرض، وفقًا للقطات الشاشة التي نشرها، عدة محادثات مع حالة كل منها، أو محادثة واحدة والإجراء الجاري فيها. ويظل تطبيق iPhone وiPad نسخة تجريبية عبر TestFlight، دون تدوينة أو توثيق. 🔗 المصدر
النماذج المفتوحة ومنصات الاختبار المجتمعية
- النسخ المكمّمة من MiniMax M3.1 Flash — تسرد MiniMax على X النسخ المكمّمة من نموذجها MoE ذي الأوزان المفتوحة بحجم 428B، ومنها Quark MXFP4 من AMD المخصص لـ Instinct MI350 وMI355 (الخبراء الموجّهون فقط، و96,9 % على GSM8K مقابل 97,2 % وفقًا لبطاقة AMD) وSAGE-EXL3 على جهاز DGX Spark واحد. 🔗 المصدر · 🔗 بطاقة AMD
- Pramaan — في تدوينة مجتمعية على Hugging Face، يقدّم كشتيج ثاكار منصة تضم 72 مهمة لأنماط هندسية مستوحاة من التقاليد الهندية، تخضع لفحص أداة تحقّق. ووفقًا لقياساته، في تشغيل واحد، يتصدّر GPT-6 Astra في المحاولة الأولى (81,9 %)؛ ومع ثلاث محاولات، ينتقل Claude Opus 5.5 من 8,3 % إلى 90,3 %. 🔗 المصدر
- AtMem routed-v4 على DolphinBench — في تدوينة مجتمعية، يقيس جواد تاغيا أداء مكتبة الذاكرة الخاصة به والموجّهة للوكلاء، فتنجح في 479 مهمة من أصل 600 (79,83 %) على منصة الاختبار هذه من Mem0، مقابل 390 في الجولة السابقة. التنفيذ والتقييم من إعداده، ولا تُعدّ النتائج مشاركة رسمية في الترتيب، وتخصّ فقط الإصدار المجمّد AtMem 2.3.10b1. 🔗 المصدر
- ViKernel — في تدوينة مجتمعية، يقدّم VIDRAFT (FINAL-Bench) عرضًا توضيحيًا بالإصدار v0.1 يُفترض أنه يضمّن ضوابط الوكيل في أوزان نموذج، بما فيها زر الإيقاف. لم تُنشر شيفرة ولا أوزان: يعيد العرض التوضيحي تشغيل إجابات مسجّلة. الرقم الوحيد، المستمد من تدقيق داخلي بأدوات محاكاة: 0 عمليات نقل صادرة غير مطلوبة من أصل 661 تشغيلًا. 🔗 المصدر
ما الذي يعنيه ذلك
تنقل دراسة Anthropic السؤال من جودة الوكيل إلى استقلالية من يشرف عليه. لم يتعرّض المحللون للتضليل، إذ كان على الوكيل الدفاع عن خياره بصدق، ومع ذلك تكفي رميات العملة الأربع للتنبؤ بـ 82 % من توصياتهم النهائية، مقابل 61 % عند تخمين التوصية الأكثر شيوعًا دائمًا. ولا تتنبأ الخبرة ولا الشهادة ولا الثقة بالذكاء الاصطناعي بمن يعتمد على الوكيل، ويصف الذين اتبعوا الوكيل في الخيارات الأربعة أنفسهم بأنهم واثقون من قراراتهم بدرجة تكاد تساوي ثقة الآخرين (71 مقابل 73 من أصل 100). وتستخلص Anthropic من ذلك مسألة ذات بُعد جماعي: إذا استندت عدة فرق إلى نماذج ذات تفضيلات متماثلة، فقد لا يعود اتفاقها مستقلًا، ولا يشكّل مراجع بشري لأبحاث سلامة الذكاء الاصطناعي آلية رقابة إلا إذا ظل حكمه نابعًا منه.
تندرج بقية أخبار اليوم ضمن أعمال الصيانة: لا يضيف Copilot CLI ولا الإصدار الليلي من Gemini CLI أي وظيفة، ويجعل Qwen Code واجهة كانت تجريبية حتى الآن مفعّلة افتراضيًا، مع النص على أن يُعيد /autofix-pr المهمة إلى شخص بعد ثلاثة إخفاقات. وعلى صعيد النماذج المفتوحة، تكمن القيمة في ظروف القياس: تحدّد بطاقة AMD بالأرقام مقدار الخسارة في الأداء الناتجة عن تكميم MXFP4 على GSM8K، بينما تنشر Pramaan وAtMem وViKernel نتائج أعدّها مؤلفوها أنفسهم، في تشغيل واحد، أو بإصدار مجمّد، أو بأدوات محاكاة.
المصادر
- دراسة Anthropic حول خيارات الخبراء القائمة على التقدير
- Copilot CLI 1.0.106-2
- Qwen Code v0.26.5
- الإصدار الليلي من Gemini CLI بتاريخ 1 نوفمبر
- @sqs: عناصر واجهة تطبيق iOS من Amp
- @MiniMax_AI: النسخ المكمّمة من M3.1 Flash
- بطاقة MiniMax M3.1 Flash Quark MXFP4 على Hugging Face (AMD)
- تدوينة كشتيج ثاكار حول Pramaan
- تدوينة جواد تاغيا حول AtMem routed-v4
- تدوينة VIDRAFT حول ViKernel