ai-powered-markdown-translatorArtikel översatt från franska till svenska med gpt-6.1-sol.
En studie från Anthropics Alignment-team, publicerad den 27 oktober på företagets Research-sida utan något tillkännagivande på X, mäter hur stort inflytande en kodagent har över expertanalytikers val: med Claude Code följer de agentens preferens i 86 % av fallen. Resten av denna söndag ryms i notiser: buggfixar för Copilot CLI, Qwen Code v0.26.5 som stabil version, en nightly utan ändringar för Gemini CLI och iOS-widgetar för Amp, följt av kvantiseringar av MiniMax M3.1 Flash och tre communityinlägg publicerade på Hugging Face.
Expertanalytiker följer sin Claude Code-agents preferens i 86 % av valen, enligt en studie från Anthropic
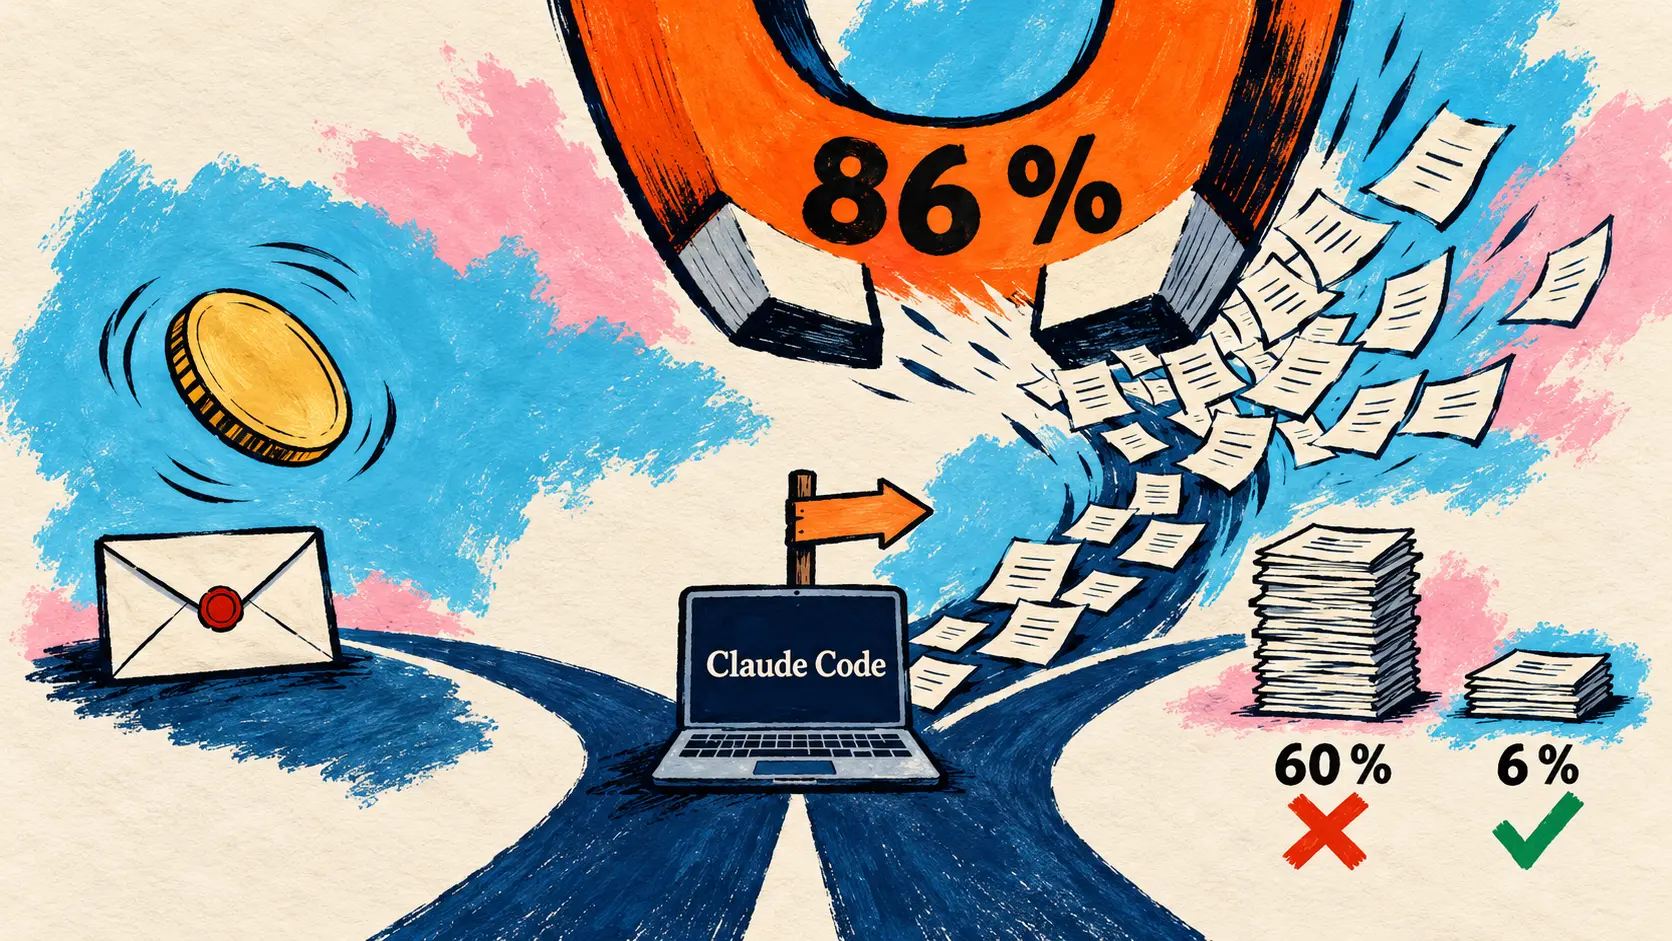
27 oktober — Tillbakablick: Anthropics Alignment-team publicerar en randomiserad kontrollerad studie av experters bedömningsbeslut (judgment calls). 50 analytiker med stor vana vid kausal inferens (61 rekryterade, varav 11 föredrog att arbeta utan agenten) ger råd till ett fiktivt jordbrukskooperativ med Claude Code, som kör Claude Opus 4.8 med ansträngningsnivån High. För vart och ett av de fyra analysvalen avgör en slantsingling vilket alternativ agenten försvarar, genom en dold systemprompt; instruktionen är att argumentera ärligt, utan att någonsin vilseleda.
Analytikerna följer agentens preferens i 86 % av fallen, jämfört med cirka 50 % som förväntas utan påverkan. De som redan hade en uppfattning ändrar sig i 60 % av fallen när agenten säger emot dem, jämfört med 6 % när den håller med dem (endast 38 fall). Efteråt återanvänder 77 % dess argument, och 15 % hänvisar till den. Angivna begränsningar: avsiktligt förstärkta preferenser, en enda uppgift, ett enda område, en enda modell.
Notiser
Kodagenter och CLI-verktyg
- Copilot CLI 1.0.106-2 — Förhandsversion från den 1 november med fem buggfixar, utan nya funktioner: med
--screen-readerbörjar fel och varningar medError:ellerWarning:,/resumeflyttar en bakgrundssession till förgrunden, och en HTTP-server för MCP som inte svarar fördröjer nu uppstarten bara en gång; den stabila versionen är fortfarande 1.0.105. 🔗 källa - Qwen Code v0.26.5 — Stabil version från den 1 november, tre dagar efter v0.26.4: det genererade gränssnittet (Generated UI), som hittills varit experimentellt, är aktiverat som standard, Managed Agent får experimentell driftsättning med Helm med ett enda kommando, och
/autofix-prlämnar över till en människa efter tre misslyckade omgångar med korrigeringar. 🔗 källa - Gemini CLI, nightly från den 1 november — Inga kodändringar: den bygger på samma commit som versionen från den 31 oktober, och endast publiceringsboten ändrar versionsnumren i 9
package.json- ochpackage-lock.json-filer. Den stabila versionen v0.66.0 och förhandsversionen v0.67.0-preview.0 förblir oförändrade. 🔗 källa - Amps iOS-widgetar — Tillbakablick på den 30 oktober: Quinn Slack, vd för Amp, presenterar på X widgetar för hemskärmen som enligt hans skärmbilder visar flera trådar med deras status eller en enda tråd och dess pågående åtgärd. Appen för iPhone och iPad är fortfarande en TestFlight-beta, utan blogginlägg eller dokumentation. 🔗 källa
Öppna modeller och communityns benchmarktester
- Kvantiseringar av MiniMax M3.1 Flash — MiniMax listar på X kvantiserade versioner av sin MoE med 428B och öppna vikter, däribland AMD:s Quark MXFP4 för Instinct MI350 och MI355 (endast routade experter, 96,9 % på GSM8K jämfört med 97,2 % enligt AMD:s modellkort) och SAGE-EXL3 på en enda DGX Spark. 🔗 källa · 🔗 AMD:s modellkort
- Pramaan — I ett communityinlägg på Hugging Face presenterar Kshitij Thakkar en testsvit med 72 uppgifter med geometriska mönster inspirerade av indiska traditioner, som kontrolleras av en verifierare. Enligt hans mätningar från en enda körning leder GPT-6 Astra på första försöket (81,9 %); med tre försök går Claude Opus 5.5 från 8,3 % till 90,3 %. 🔗 källa
- AtMem routed-v4 på DolphinBench — I ett communityinlägg mäter Javad Taghia sitt minnesbibliotek för agenter till 479 lösta uppgifter av 600 (79,83 %) på denna testsvit från Mem0, jämfört med 390 vid föregående körning. Egen körning och poängsättning, utan att räknas som ett officiellt resultat på topplistan, för enbart den låsta versionen AtMem 2.3.10b1. 🔗 källa
- ViKernel — I ett communityinlägg presenterar VIDRAFT (FINAL-Bench) en demonstration i v0.1 som uppges kunna placera en agents kontrollmekanismer, inklusive stoppknappen, i en modells vikter. Varken kod eller vikter finns tillgängliga: demonstrationen spelar upp inspelade svar. Den enda siffran kommer från en intern granskning med simulerade verktyg: 0 oombedda utgående överföringar under 661 körningar. 🔗 källa
Vad det innebär
Anthropics studie flyttar fokus från agentens kvalitet till självständigheten hos den som övervakar den. Analytikerna blev inte vilseledda, eftersom agenten skulle argumentera ärligt, och ändå räcker de fyra slantsinglingarna för att förutsäga 82 % av deras slutliga rekommendationer, jämfört med 61 % om man alltid gissar på den vanligaste. Varken erfarenhet, examen eller förtroende för AI förutsäger vem som förlitar sig på agenten, och de som följde agenten i alla fyra valen uppger att de är nästan lika säkra på sin bedömning som de andra (71 jämfört med 73 av 100). Anthropic drar slutsatsen att detta är en kollektiv utmaning: om flera team förlitar sig på modeller med samma preferenser kanske deras samstämmighet inte längre är oberoende, och en mänsklig granskare av forskning om AI-säkerhet fungerar som en kontroll endast om bedömningen förblir granskarens egen.
Resten av dagen handlar om underhåll: Copilot CLI och Gemini CLI:s nightly tillför inga funktioner, och Qwen Code aktiverar som standard ett gränssnitt som hittills varit experimentellt, samtidigt som /autofix-pr ska lämna tillbaka kontrollen till en människa efter tre misslyckanden. För öppna modeller ligger värdet i mätvillkoren: AMD:s modellkort kvantifierar hur mycket dess MXFP4-kvantisering kostar i prestanda på GSM8K, medan Pramaan, AtMem och ViKernel publicerar resultat som tagits fram av deras egna upphovspersoner, från en enda körning, en låst version eller simulerade verktyg.
Källor
- Anthropics studie om experters bedömningsbeslut
- Copilot CLI 1.0.106-2
- Qwen Code v0.26.5
- Gemini CLI:s nightly från den 1 november
- @sqs: widgetar för Amps iOS-app
- @MiniMax_AI: kvantiseringar av M3.1 Flash
- Hugging Face-modellkort för MiniMax M3.1 Flash Quark MXFP4 (AMD)
- Kshitij Thakkars inlägg om Pramaan
- Javad Taghias inlägg om AtMem routed-v4
- VIDRAFT:s inlägg om ViKernel