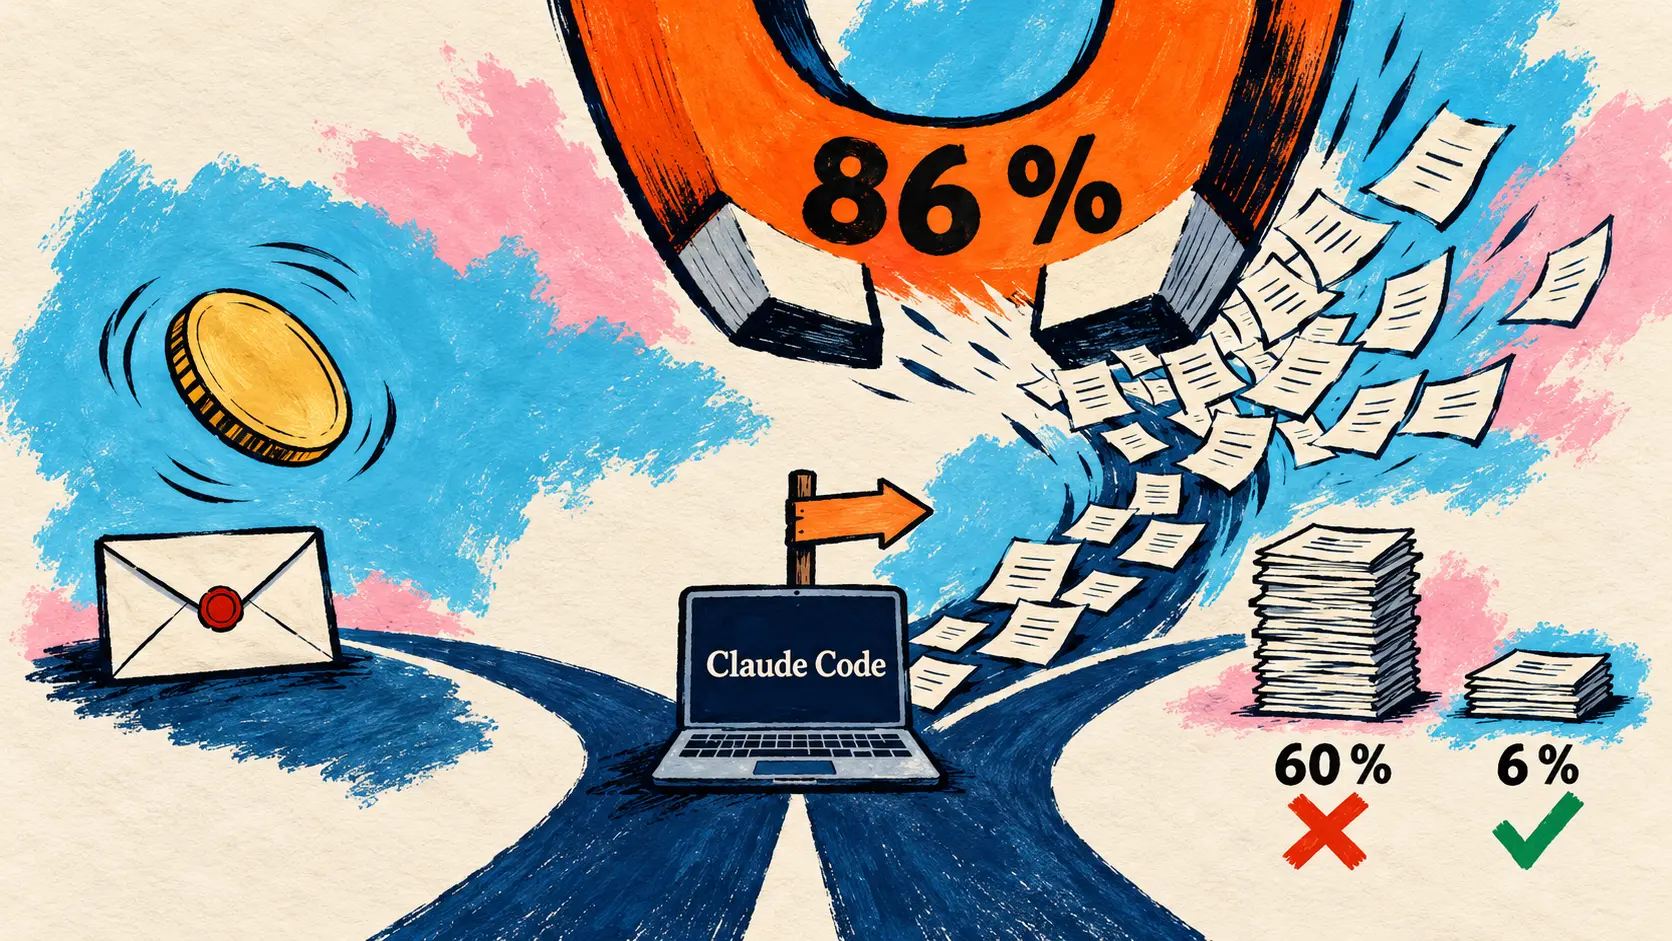
Une étude de l’équipe Alignment d’Anthropic, publiée le 27 octobre sur sa page Research sans annonce sur X, mesure le poids d’un agent de code dans les choix d’analystes experts : avec Claude Code, ils suivent la préférence de l’agent dans 86 % des cas. Le reste de ce dimanche tient en brèves : des correctifs pour Copilot CLI, Qwen Code v0.26.5 en stable, une nightly vide de Gemini CLI et des widgets iOS pour Amp, puis les quantifications de MiniMax M3.1 Flash et trois billets communautaires publiés sur Hugging Face.
Des analystes experts suivent la préférence de leur agent Claude Code dans 86 % des choix, selon une étude d’Anthropic
27 octobre — Rattrapage : l’équipe Alignment d’Anthropic publie un essai contrôlé randomisé sur les choix d’appréciation (judgment calls) d’experts. 50 analystes rompus à l’inférence causale (61 recrutés, 11 ont préféré travailler sans l’agent) conseillent une coopérative agricole fictive avec Claude Code, sur Claude Opus 4.8 en effort High. Pour chacun des quatre choix d’analyse, un tirage à pile ou face fixe l’option que l’agent défend, par un prompt système caché ; consigne : plaider honnêtement, sans jamais tromper.
Les analystes suivent la préférence de l’agent dans 86 % des cas, contre environ 50 % attendus sans influence. Ceux qui avaient déjà un avis en changent dans 60 % des cas quand l’agent les contredit, contre 6 % quand il les approuve (38 cas seulement). Après coup, 77 % reprennent ses arguments, 15 % le citent. Limites déclarées : préférences volontairement renforcées, une seule tâche, un seul domaine, un seul modèle.
Brèves
Agents et CLI de code
- Copilot CLI 1.0.106-2 — Préversion du 1er novembre faite de cinq correctifs, sans nouvelle fonction : avec
--screen-reader, erreurs et avertissements commencent parError:ouWarning:,/resumeramène une session de fond au premier plan, et un serveur MCP HTTP muet ne retient plus le démarrage qu’une fois ; la stable reste la 1.0.105. 🔗 source - Qwen Code v0.26.5 — Version stable du 1er novembre, trois jours après la v0.26.4 : l’interface générée (Generated UI), jusque-là expérimentale, est activée par défaut, le Managed Agent gagne un déploiement Helm expérimental en une commande, et
/autofix-prpasse la main à un humain après trois poussées de correctifs sans succès. 🔗 source - Gemini CLI, nightly du 1er novembre — Aucun changement de code : elle repose sur le même commit que celle du 31 octobre, et seul le robot de publication modifie les numéros de version de 9 fichiers
package.jsonetpackage-lock.json. La stable v0.66.0 et la préversion v0.67.0-preview.0 ne changent pas. 🔗 source - Widgets iOS d’Amp — Rattrapage du 30 octobre : Quinn Slack, directeur général d’Amp, annonce sur X des widgets d’écran d’accueil qui affichent, selon ses captures, plusieurs fils avec leur état ou un seul fil et son action en cours. L’application iPhone et iPad reste une bêta TestFlight, sans billet ni documentation. 🔗 source
Modèles ouverts et bancs d’essai communautaires
- Quantifications de MiniMax M3.1 Flash — MiniMax recense sur X les versions quantifiées de son MoE de 428B à poids ouverts, dont Quark MXFP4 d’AMD pour les Instinct MI350 et MI355 (experts routés seulement, 96,9 % sur GSM8K contre 97,2 % selon la fiche d’AMD) et SAGE-EXL3 sur un seul DGX Spark. 🔗 source · 🔗 fiche d’AMD
- Pramaan — Dans un billet communautaire sur Hugging Face, Kshitij Thakkar présente un banc de 72 tâches de motifs géométriques inspirés des traditions indiennes, contrôlés par un vérificateur. Selon ses mesures, sur une seule exécution, GPT-6 Astra mène au premier essai (81,9 %) ; avec trois essais, Claude Opus 5.5 passe de 8,3 % à 90,3 %. 🔗 source
- AtMem routed-v4 sur DolphinBench — Dans un billet communautaire, Javad Taghia mesure sa bibliothèque de mémoire pour agents à 479 tâches réussies sur 600 (79,83 %) sur ce banc de Mem0, contre 390 au passage précédent. Exécution et notation maison, sans valeur d’entrée officielle au classement, pour la seule version figée AtMem 2.3.10b1. 🔗 source
- ViKernel — Dans un billet communautaire, VIDRAFT (FINAL-Bench) présente une démonstration v0.1 qui logerait dans les poids d’un modèle les contrôles d’un agent, bouton d’arrêt compris. Ni code ni poids : la démo rejoue des réponses enregistrées. Seul chiffre, issu d’un audit interne à outils simulés : 0 transfert sortant non demandé sur 661 exécutions. 🔗 source
Ce que ça signifie
L’étude d’Anthropic déplace la question de la qualité d’un agent vers l’indépendance de celui qui le supervise. Les analystes n’ont pas été trompés, puisque l’agent devait plaider honnêtement, et pourtant les quatre tirages à pile ou face suffisent à prédire 82 % de leurs recommandations finales, contre 61 % en devinant toujours la plus fréquente. Ni l’expérience, ni le diplôme, ni la confiance dans l’IA ne prédisent qui s’en remet à l’agent, et ceux qui ont suivi l’agent sur les quatre choix se disent presque aussi sûrs d’eux que les autres (71 contre 73 sur 100). Anthropic en tire un enjeu collectif : si plusieurs équipes s’appuient sur des modèles aux mêmes préférences, leur accord peut ne plus être indépendant, et un relecteur humain de recherche en sûreté de l’IA n’est un contrôle que si son jugement reste le sien.
Le reste de la journée relève de l’entretien : Copilot CLI et la nightly de Gemini CLI n’ajoutent aucune fonction, et Qwen Code fait passer par défaut une interface jusque-là expérimentale, tout en prévoyant que /autofix-pr rende la main à un humain après trois échecs. Côté modèles ouverts, la valeur tient aux conditions de mesure : la fiche d’AMD chiffre ce que sa quantification MXFP4 coûte sur GSM8K, tandis que Pramaan, AtMem et ViKernel publient des résultats établis par leurs propres auteurs, sur une seule exécution, une version figée ou des outils simulés.
Sources
- Étude d’Anthropic sur les choix d’appréciation des experts
- Copilot CLI 1.0.106-2
- Qwen Code v0.26.5
- Nightly de Gemini CLI du 1er novembre
- @sqs : widgets de l’application iOS d’Amp
- @MiniMax_AI : quantifications de M3.1 Flash
- Fiche Hugging Face de MiniMax M3.1 Flash Quark MXFP4 (AMD)
- Billet de Kshitij Thakkar sur Pramaan
- Billet de Javad Taghia sur AtMem routed-v4
- Billet de VIDRAFT sur ViKernel