ai-powered-markdown-translatorArtículo traducido del francés al español con gpt-6.1-sol.
Un estudio del equipo Alignment de Anthropic, publicado el 27 de octubre en su página Research sin anuncio en X, mide el peso de un agente de código en las decisiones de analistas expertos: con Claude Code, siguen la preferencia del agente en el 86 % de los casos. El resto de este domingo se resume en noticias breves: correcciones para Copilot CLI, Qwen Code v0.26.5 en versión estable, una nightly sin cambios de Gemini CLI y widgets iOS para Amp, seguidos de las cuantizaciones de MiniMax M3.1 Flash y tres publicaciones comunitarias en Hugging Face.
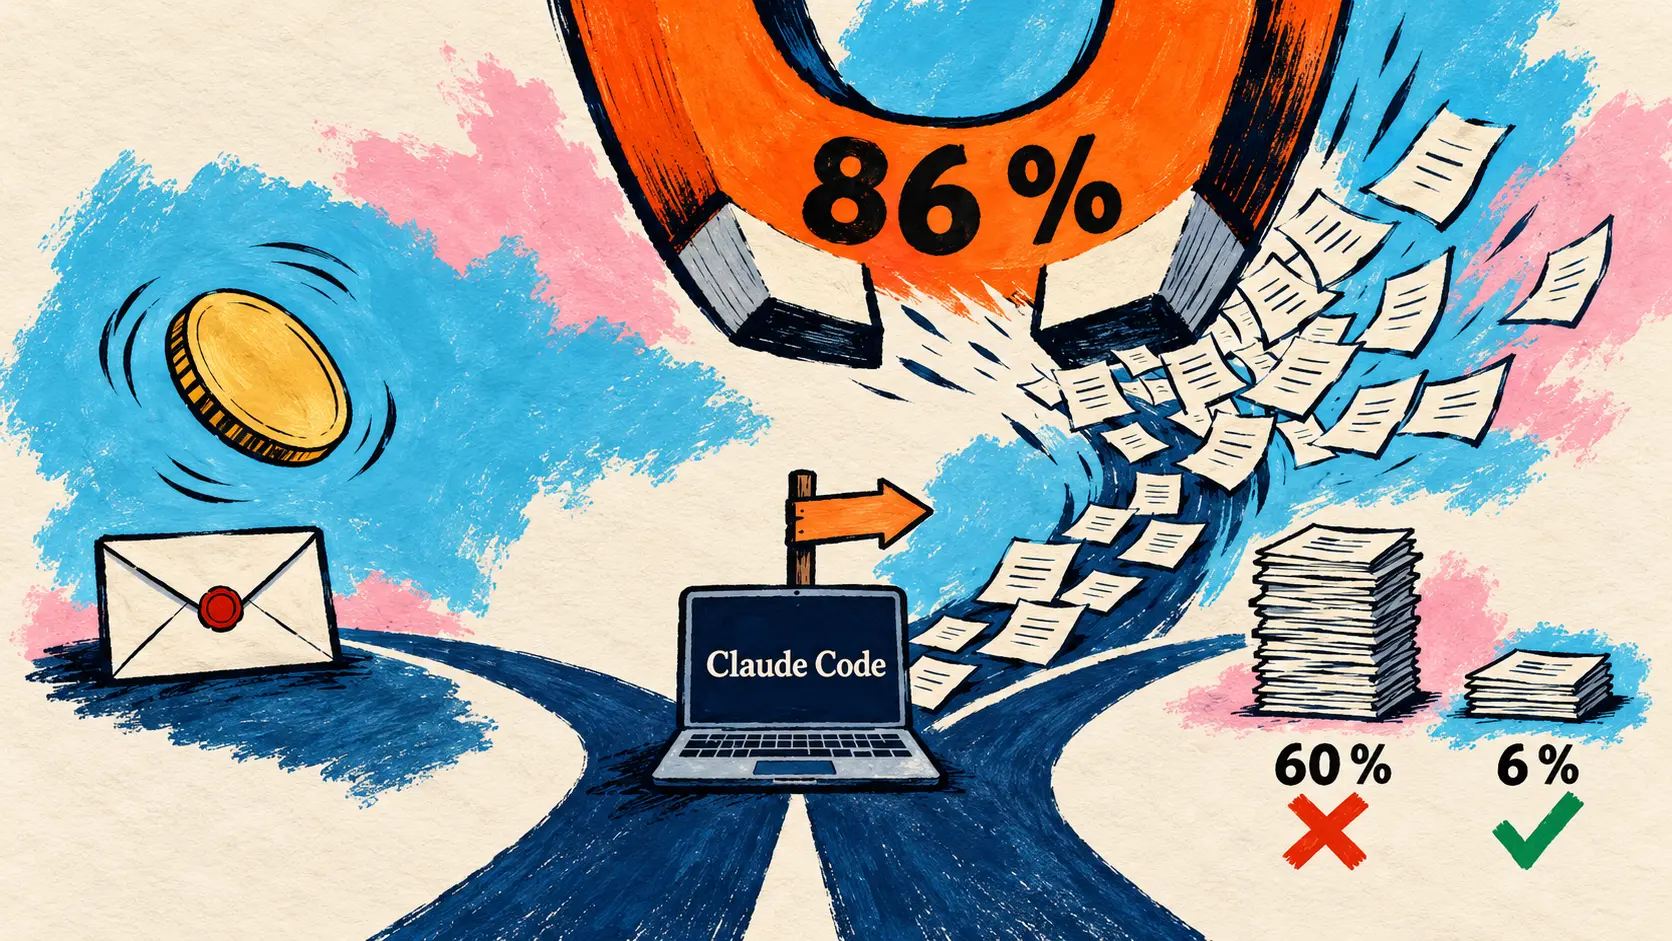
Analistas expertos siguen la preferencia de su agente Claude Code en el 86 % de las decisiones, según un estudio de Anthropic
27 de octubre — Repaso: el equipo Alignment de Anthropic publica un ensayo controlado aleatorizado sobre las decisiones basadas en el criterio (judgment calls) de expertos. 50 analistas con experiencia en inferencia causal (61 reclutados, 11 prefirieron trabajar sin el agente) asesoran a una cooperativa agrícola ficticia con Claude Code, usando Claude Opus 4.8 con esfuerzo High. Para cada una de las cuatro decisiones de análisis, un lanzamiento de moneda determina la opción que defiende el agente mediante un prompt de sistema oculto; la instrucción: argumentar con honestidad, sin engañar nunca.
Los analistas siguen la preferencia del agente en el 86 % de los casos, frente al aproximadamente 50 % esperado sin influencia. Quienes ya tenían una opinión la cambian en el 60 % de los casos cuando el agente los contradice, frente al 6 % cuando les da la razón (solo 38 casos). A posteriori, el 77 % retoma sus argumentos y el 15 % lo cita. Limitaciones declaradas: preferencias reforzadas deliberadamente, una sola tarea, un solo ámbito y un solo modelo.
Noticias breves
Agentes y CLI de código
- Copilot CLI 1.0.106-2 — Versión preliminar del 1 de noviembre con cinco correcciones, sin nuevas funciones: con
--screen-reader, los errores y las advertencias empiezan porError:oWarning:,/resumedevuelve una sesión en segundo plano al primer plano, y un servidor MCP HTTP que no responde solo bloquea el arranque una vez; la versión estable sigue siendo la 1.0.105. 🔗 fuente - Qwen Code v0.26.5 — Versión estable del 1 de noviembre, tres días después de la v0.26.4: la interfaz generada (Generated UI), hasta entonces experimental, se activa por defecto, Managed Agent incorpora un despliegue Helm experimental con un solo comando, y
/autofix-prcede el control a una persona tras tres envíos de correcciones sin éxito. 🔗 fuente - Gemini CLI, nightly del 1 de noviembre — Ningún cambio de código: se basa en el mismo commit que la del 31 de octubre, y solo el bot de publicación modifica los números de versión de 9 archivos
package.jsonypackage-lock.json. La versión estable v0.66.0 y la versión preliminar v0.67.0-preview.0 no cambian. 🔗 fuente - Widgets iOS de Amp — Repaso del 30 de octubre: Quinn Slack, director general de Amp, anuncia en X widgets de pantalla de inicio que muestran, según sus capturas, varios hilos con su estado o un solo hilo y su acción en curso. La aplicación para iPhone y iPad sigue siendo una beta de TestFlight, sin publicación ni documentación. 🔗 fuente
Modelos abiertos y bancos de pruebas comunitarios
- Cuantizaciones de MiniMax M3.1 Flash — MiniMax enumera en X las versiones cuantizadas de su MoE de 428B con pesos abiertos, entre ellas Quark MXFP4 de AMD para Instinct MI350 y MI355 (solo expertos enrutados, 96,9 % en GSM8K frente al 97,2 % según la ficha de AMD) y SAGE-EXL3 en un solo DGX Spark. 🔗 fuente · 🔗 ficha de AMD
- Pramaan — En una publicación comunitaria en Hugging Face, Kshitij Thakkar presenta un banco de 72 tareas de patrones geométricos inspirados en las tradiciones indias, comprobados por un verificador. Según sus mediciones, en una sola ejecución, GPT-6 Astra lidera al primer intento (81,9 %); con tres intentos, Claude Opus 5.5 pasa del 8,3 % al 90,3 %. 🔗 fuente
- AtMem routed-v4 en DolphinBench — En una publicación comunitaria, Javad Taghia evalúa su biblioteca de memoria para agentes y obtiene 479 tareas completadas con éxito de 600 (79,83 %) en este banco de Mem0, frente a las 390 de la evaluación anterior. Ejecución y puntuación propias, sin validez como entrada oficial en la clasificación, únicamente para la versión fijada AtMem 2.3.10b1. 🔗 fuente
- ViKernel — En una publicación comunitaria, VIDRAFT (FINAL-Bench) presenta una demostración v0.1 que alojaría en los pesos de un modelo los controles de un agente, incluido el botón de parada. Sin código ni pesos: la demo reproduce respuestas grabadas. La única cifra, procedente de una auditoría interna con herramientas simuladas: 0 transferencias salientes no solicitadas en 661 ejecuciones. 🔗 fuente
Qué significa
El estudio de Anthropic desplaza la cuestión de la calidad de un agente hacia la independencia de quien lo supervisa. Los analistas no fueron engañados, puesto que el agente debía argumentar con honestidad, y aun así los cuatro lanzamientos de moneda bastan para predecir el 82 % de sus recomendaciones finales, frente al 61 % si se adivina siempre la más frecuente. Ni la experiencia, ni la titulación, ni la confianza en la IA predicen quién se deja guiar por el agente, y quienes siguieron al agente en las cuatro decisiones afirman estar casi tan seguros de sí mismos como los demás (71 frente a 73 sobre 100). Anthropic extrae de ello un reto colectivo: si varios equipos se apoyan en modelos con las mismas preferencias, su acuerdo puede dejar de ser independiente, y un revisor humano de investigaciones sobre seguridad de la IA solo sirve como control si conserva su propio criterio.
El resto de la jornada corresponde al mantenimiento: Copilot CLI y la nightly de Gemini CLI no añaden ninguna función, y Qwen Code activa por defecto una interfaz hasta entonces experimental, al tiempo que prevé que /autofix-pr devuelva el control a una persona tras tres fallos. En cuanto a los modelos abiertos, el valor reside en las condiciones de medición: la ficha de AMD cuantifica el coste de su cuantización MXFP4 en GSM8K, mientras que Pramaan, AtMem y ViKernel publican resultados obtenidos por sus propios autores, en una sola ejecución, con una versión fijada o con herramientas simuladas.
Fuentes
- Estudio de Anthropic sobre las decisiones basadas en el criterio de expertos
- Copilot CLI 1.0.106-2
- Qwen Code v0.26.5
- Nightly de Gemini CLI del 1 de noviembre
- @sqs: widgets de la aplicación iOS de Amp
- @MiniMax_AI: cuantizaciones de M3.1 Flash
- Ficha de Hugging Face de MiniMax M3.1 Flash Quark MXFP4 (AMD)
- Publicación de Kshitij Thakkar sobre Pramaan
- Publicación de Javad Taghia sobre AtMem routed-v4
- Publicación de VIDRAFT sobre ViKernel