ai-powered-markdown-translatorArtykuł przetłumaczony z francuskiego na polski za pomocą gpt-6.1-sol.
Badanie zespołu Alignment firmy Anthropic, opublikowane 27 października na stronie Research bez zapowiedzi na X, mierzy wpływ agenta programistycznego na decyzje doświadczonych analityków: korzystając z Claude Code, w 86 % przypadków kierują się preferencją agenta. Pozostałe wiadomości z tej niedzieli to krótkie doniesienia: poprawki w Copilot CLI, stabilne wydanie Qwen Code v0.26.5, wydanie nightly Gemini CLI bez zmian oraz widżety iOS dla Amp, a następnie skwantyzowane wersje MiniMax M3.1 Flash i trzy wpisy społeczności opublikowane na Hugging Face.
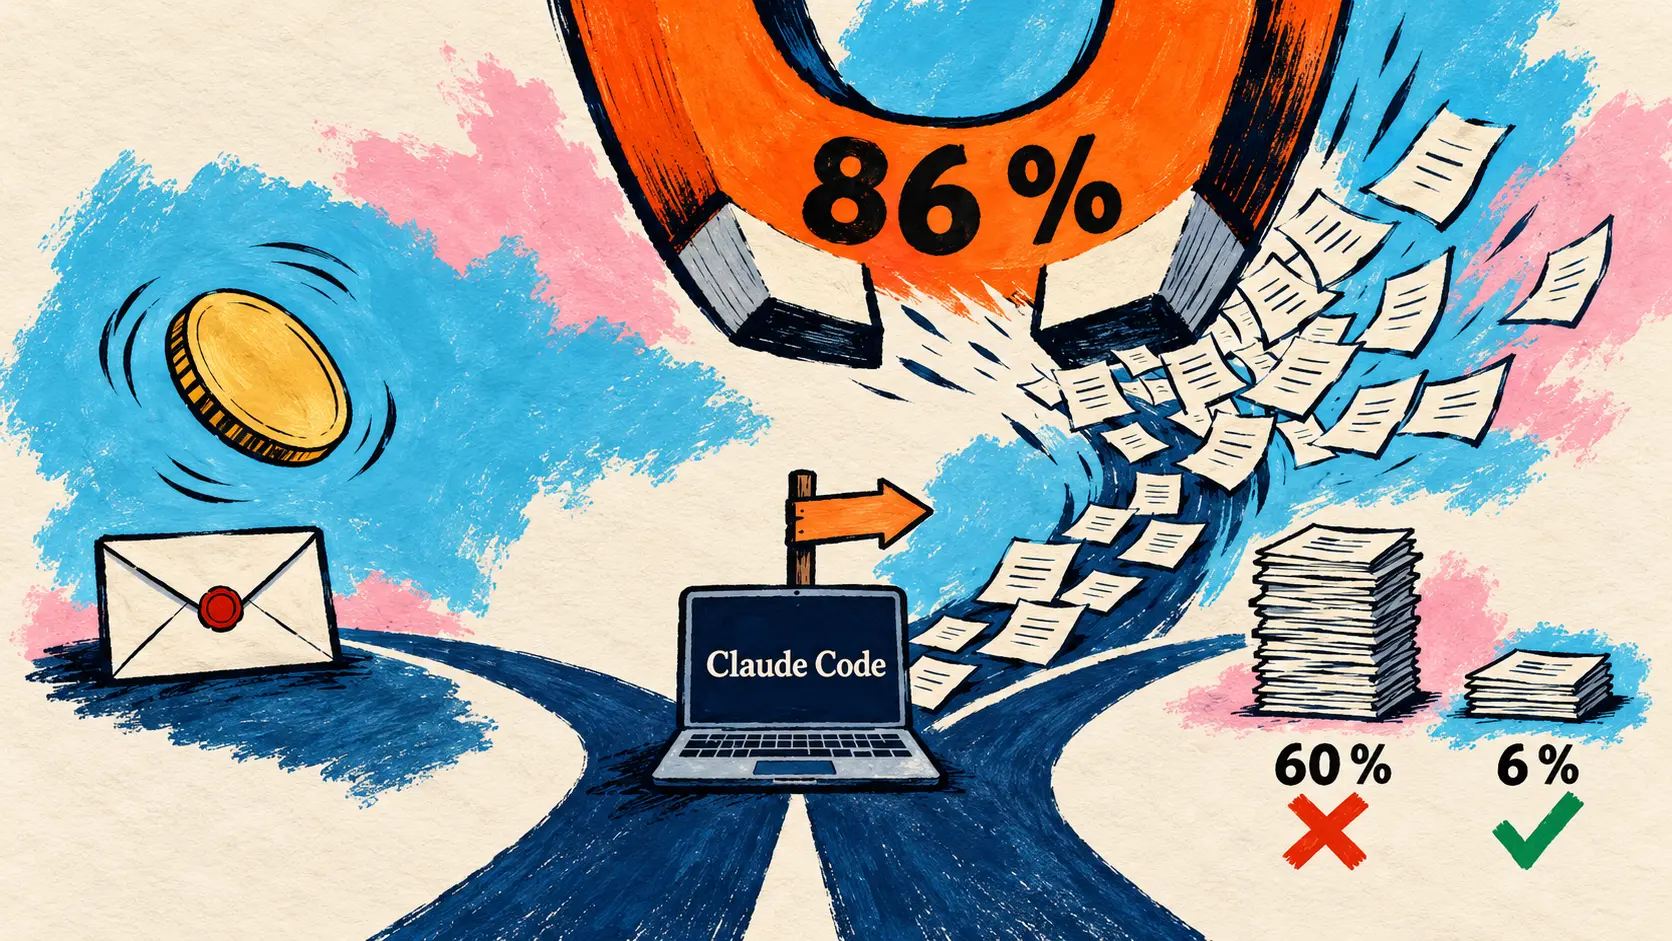
Według badania Anthropic doświadczeni analitycy kierują się preferencją swojego agenta Claude Code w 86 % decyzji
27 października — Uzupełnienie wiadomości: zespół Alignment firmy Anthropic publikuje randomizowane badanie kontrolowane dotyczące decyzji ekspertów wymagających osądu (judgment calls). 50 analityków biegłych we wnioskowaniu przyczynowym (zrekrutowano 61, a 11 wolało pracować bez agenta) doradza fikcyjnej spółdzielni rolniczej z pomocą Claude Code, korzystając z Claude Opus 4.8 z poziomem wysiłku High. Dla każdej z czterech decyzji analitycznych rzut monetą określa opcję, której agent broni na podstawie ukrytego promptu systemowego; polecenie: argumentować uczciwie, nigdy nie wprowadzając w błąd.
Analitycy kierują się preferencją agenta w 86 % przypadków, wobec oczekiwanych około 50 % przy braku wpływu. Ci, którzy mieli już wyrobione zdanie, zmieniają je w 60 % przypadków, gdy agent im przeczy, wobec 6 %, gdy się z nimi zgadza (tylko 38 przypadków). Później 77 % przytacza jego argumenty, a 15 % powołuje się na niego. Wskazane ograniczenia: celowo wzmocnione preferencje, jedno zadanie, jedna dziedzina, jeden model.
Krótkie wiadomości
Agenci i CLI do programowania
- Copilot CLI 1.0.106-2 — Wydanie wstępne z 1 listopada obejmuje pięć poprawek, bez nowych funkcji: przy użyciu
--screen-readerbłędy i ostrzeżenia zaczynają się odError:lubWarning:,/resumeprzenosi sesję działającą w tle na pierwszy plan, a nieodpowiadający serwer MCP HTTP opóźnia teraz uruchomienie tylko raz; wersją stabilną pozostaje 1.0.105. 🔗 źródło - Qwen Code v0.26.5 — Stabilne wydanie z 1 listopada, trzy dni po v0.26.4: generowany interfejs (Generated UI), dotąd eksperymentalny, jest domyślnie włączony, Managed Agent zyskuje eksperymentalne wdrożenie przez Helm jednym poleceniem, a
/autofix-prprzekazuje kontrolę człowiekowi po trzech nieskutecznych próbach wprowadzenia poprawek. 🔗 źródło - Gemini CLI, wydanie nightly z 1 listopada — Bez zmian w kodzie: opiera się na tym samym commicie co wydanie z 31 października, a jedynie bot publikujący zmienia numery wersji w 9 plikach
package.jsonipackage-lock.json. Stabilna wersja v0.66.0 i wydanie wstępne v0.67.0-preview.0 pozostają bez zmian. 🔗 źródło - Widżety iOS dla Amp — Uzupełnienie wiadomości z 30 października: Quinn Slack, dyrektor generalny Amp, zapowiada na X widżety ekranu głównego, które według jego zrzutów ekranu wyświetlają kilka wątków wraz z ich stanem albo jeden wątek i aktualnie wykonywaną w nim czynność. Aplikacja na iPhone i iPad pozostaje w wersji beta w TestFlight, bez wpisu ani dokumentacji. 🔗 źródło
Otwarte modele i społecznościowe testy porównawcze
- Skwantyzowane wersje MiniMax M3.1 Flash — MiniMax wymienia na X skwantyzowane wersje swojego MoE o rozmiarze 428B z otwartymi wagami, w tym Quark MXFP4 od AMD dla Instinct MI350 i MI355 (tylko eksperci wybierani przez router, 96,9 % w GSM8K wobec 97,2 % według karty AMD) oraz SAGE-EXL3 na pojedynczym DGX Spark. 🔗 źródło · 🔗 karta AMD
- Pramaan — We wpisie społeczności na Hugging Face Kshitij Thakkar przedstawia zestaw 72 zadań dotyczących wzorów geometrycznych inspirowanych tradycjami indyjskimi, sprawdzanych przez weryfikator. Według jego pomiarów z jednego uruchomienia GPT-6 Astra prowadzi przy pierwszej próbie (81,9 %); przy trzech próbach wynik Claude Opus 5.5 rośnie z 8,3 % do 90,3 %. 🔗 źródło
- AtMem routed-v4 w DolphinBench — We wpisie społeczności Javad Taghia podaje wynik swojej biblioteki pamięci dla agentów: 479 pomyślnie wykonanych zadań na 600 (79,83 %) w tym zestawie testów Mem0, wobec 390 w poprzednim podejściu. Uruchomienie i ocena przeprowadzone we własnym zakresie, bez statusu oficjalnego wyniku w rankingu, wyłącznie dla zamrożonej wersji AtMem 2.3.10b1. 🔗 źródło
- ViKernel — We wpisie społeczności VIDRAFT (FINAL-Bench) przedstawia demo v0.1, które miałoby umieszczać w wagach modelu mechanizmy kontroli agenta, w tym przycisk zatrzymania. Nie udostępniono ani kodu, ani wag: demo odtwarza zapisane odpowiedzi. Jedyna liczba, pochodząca z wewnętrznego audytu z symulowanymi narzędziami: 0 niezleconych transferów wychodzących na 661 uruchomień. 🔗 źródło
Co to oznacza
Badanie Anthropic przenosi uwagę z jakości agenta na niezależność osoby, która go nadzoruje. Analitycy nie zostali wprowadzeni w błąd, ponieważ agent miał argumentować uczciwie, a mimo to cztery rzuty monetą wystarczają do przewidzenia 82 % ich ostatecznych rekomendacji, wobec 61 % przy każdorazowym wskazywaniu najczęstszej. Ani doświadczenie, ani wykształcenie, ani zaufanie do sztucznej inteligencji nie pozwalają przewidzieć, kto zda się na agenta, a osoby, które poszły za jego wskazaniami we wszystkich czterech decyzjach, deklarują niemal taką samą pewność siebie jak pozostali (71 wobec 73 na 100). Anthropic wskazuje na problem zbiorowy: jeśli kilka zespołów korzysta z modeli o tych samych preferencjach, zgodność ich opinii może przestać wynikać z niezależnych ocen, a człowiek recenzujący badania nad bezpieczeństwem sztucznej inteligencji stanowi mechanizm kontroli tylko wtedy, gdy zachowuje własny osąd.
Pozostałe wiadomości dnia dotyczą utrzymania: Copilot CLI i wydanie nightly Gemini CLI nie dodają żadnych funkcji, a Qwen Code domyślnie włącza interfejs, który dotąd był eksperymentalny, przewidując jednocześnie, że /autofix-pr odda kontrolę człowiekowi po trzech niepowodzeniach. W przypadku otwartych modeli wartość informacji zależy od warunków pomiaru: karta AMD określa liczbowo, ile kosztuje jego kwantyzacja MXFP4 pod względem wyniku w GSM8K, natomiast Pramaan, AtMem i ViKernel publikują wyniki ustalone przez własnych autorów, na podstawie jednego uruchomienia, zamrożonej wersji lub symulowanych narzędzi.
Źródła
- Badanie Anthropic dotyczące decyzji ekspertów wymagających osądu
- Copilot CLI 1.0.106-2
- Qwen Code v0.26.5
- Wydanie nightly Gemini CLI z 1 listopada
- @sqs: widżety aplikacji Amp na iOS
- @MiniMax_AI: skwantyzowane wersje M3.1 Flash
- Karta MiniMax M3.1 Flash Quark MXFP4 (AMD) na Hugging Face
- Wpis Kshitija Thakkara o Pramaan
- Wpis Javada Taghii o AtMem routed-v4
- Wpis VIDRAFT o ViKernel