ai-powered-markdown-translatorArticolo tradotto dal francese all’italiano con gpt-6.1-sol.
Uno studio del team Alignment di Anthropic, pubblicato il 27 ottobre sulla sua pagina Research senza un annuncio su X, misura il peso di un agente di programmazione nelle scelte di analisti esperti: con Claude Code, seguono la preferenza dell’agente nell’86 % dei casi. Il resto di questa domenica si riassume in brevi notizie: correzioni per Copilot CLI, Qwen Code v0.26.5 in versione stabile, una nightly di Gemini CLI priva di novità e widget iOS per Amp, poi le quantizzazioni di MiniMax M3.1 Flash e tre post della community pubblicati su Hugging Face.
Analisti esperti seguono la preferenza del loro agente Claude Code nell’86 % delle scelte, secondo uno studio di Anthropic
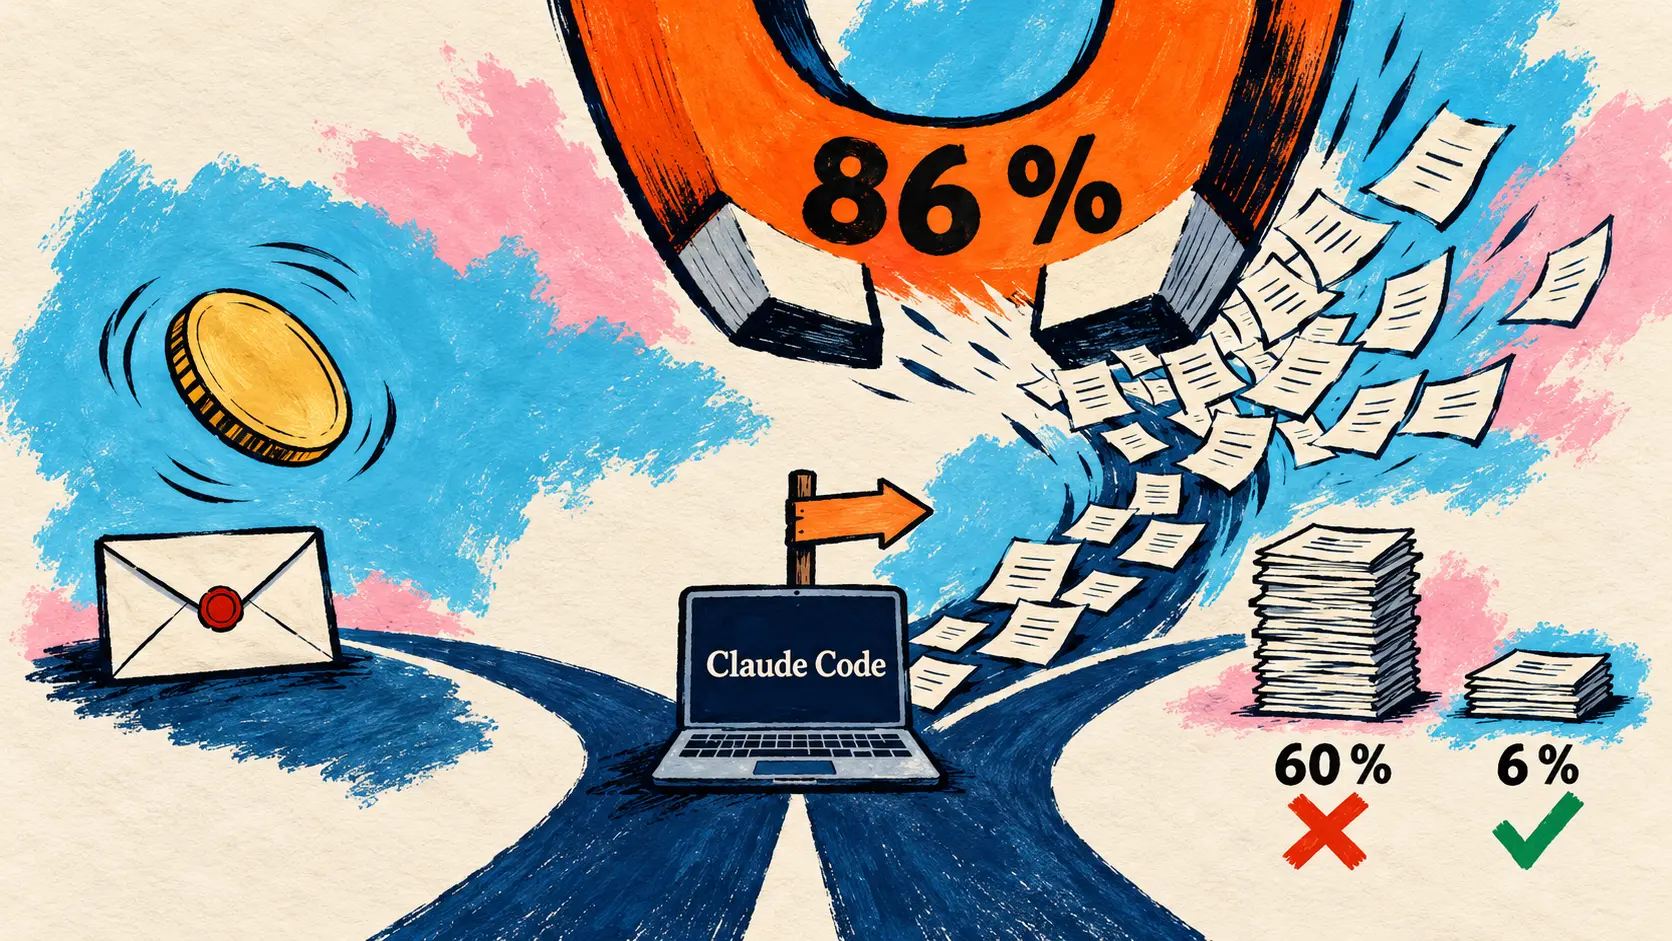
27 ottobre — Riepilogo: il team Alignment di Anthropic pubblica uno studio controllato randomizzato sulle scelte discrezionali (judgment calls) degli esperti. 50 analisti esperti di inferenza causale (61 reclutati, 11 hanno preferito lavorare senza l’agente) forniscono consulenza a una cooperativa agricola fittizia con Claude Code, usando Claude Opus 4.8 con effort High. Per ciascuna delle quattro scelte di analisi, un lancio di moneta determina l’opzione sostenuta dall’agente, tramite un prompt di sistema nascosto; l’istruzione è argomentare onestamente, senza mai ingannare.
Gli analisti seguono la preferenza dell’agente nell’86 % dei casi, contro il 50 % circa atteso in assenza di influenza. Chi aveva già un’opinione la cambia nel 60 % dei casi quando l’agente lo contraddice, contro il 6 % quando gli dà ragione (solo 38 casi). A posteriori, il 77 % ne riprende le argomentazioni, il 15 % lo cita. Limiti dichiarati: preferenze intenzionalmente rafforzate, un solo compito, un solo ambito, un solo modello.
Brevi notizie
Agenti e CLI di programmazione
- Copilot CLI 1.0.106-2 — Versione di anteprima del 1° novembre composta da cinque correzioni, senza nuove funzionalità: con
--screen-reader, errori e avvisi iniziano conError:oWarning:,/resumeriporta in primo piano una sessione in background e un server MCP HTTP che non risponde ritarda l’avvio solo una volta; la versione stabile resta la 1.0.105. 🔗 fonte - Qwen Code v0.26.5 — Versione stabile del 1° novembre, tre giorni dopo la v0.26.4: l’interfaccia generata (Generated UI), finora sperimentale, è attivata per impostazione predefinita, il Managed Agent ottiene un deployment Helm sperimentale con un solo comando e
/autofix-prpassa il controllo a un essere umano dopo tre push di correzioni senza successo. 🔗 fonte - Gemini CLI, nightly del 1° novembre — Nessuna modifica al codice: si basa sullo stesso commit di quella del 31 ottobre e solo il bot di pubblicazione modifica i numeri di versione di 9 file
package.jsonepackage-lock.json. La versione stabile v0.66.0 e la versione di anteprima v0.67.0-preview.0 restano invariate. 🔗 fonte - Widget iOS di Amp — Riepilogo del 30 ottobre: Quinn Slack, amministratore delegato di Amp, annuncia su X widget per la schermata Home che mostrano, stando alle sue schermate, più conversazioni con il relativo stato oppure una sola conversazione con l’azione in corso. L’applicazione per iPhone e iPad resta una beta TestFlight, senza post né documentazione. 🔗 fonte
Modelli aperti e benchmark della community
- Quantizzazioni di MiniMax M3.1 Flash — MiniMax elenca su X le versioni quantizzate del suo MoE da 428B a pesi aperti, tra cui Quark MXFP4 di AMD per Instinct MI350 e MI355 (solo gli esperti selezionati dal routing, 96,9 % su GSM8K contro 97,2 % secondo la scheda di AMD) e SAGE-EXL3 su un solo DGX Spark. 🔗 fonte · 🔗 scheda di AMD
- Pramaan — In un post della community su Hugging Face, Kshitij Thakkar presenta un benchmark di 72 compiti su motivi geometrici ispirati alle tradizioni indiane, controllati da un verificatore. Secondo le sue misurazioni, su una sola esecuzione, GPT-6 Astra è in testa al primo tentativo (81,9 %); con tre tentativi, Claude Opus 5.5 passa dall’8,3 % al 90,3 %. 🔗 fonte
- AtMem routed-v4 su DolphinBench — In un post della community, Javad Taghia misura la sua libreria di memoria per agenti: 479 compiti riusciti su 600 (79,83 %) su questo benchmark di Mem0, contro 390 nella prova precedente. Esecuzione e valutazione condotte in proprio, senza validità come risultato ufficiale in classifica, per la sola versione fissata AtMem 2.3.10b1. 🔗 fonte
- ViKernel — In un post della community, VIDRAFT (FINAL-Bench) presenta una dimostrazione v0.1 che incorporerebbe nei pesi di un modello i controlli di un agente, pulsante di arresto compreso. Né codice né pesi disponibili: la demo riproduce risposte registrate. Unico dato, proveniente da un audit interno con strumenti simulati: 0 trasferimenti in uscita non richiesti su 661 esecuzioni. 🔗 fonte
Cosa significa
Lo studio di Anthropic sposta la questione dalla qualità di un agente all’indipendenza di chi lo supervisiona. Gli analisti non sono stati ingannati, poiché l’agente doveva argomentare onestamente, eppure i quattro lanci di moneta bastano a prevedere l’82 % delle loro raccomandazioni finali, contro il 61 % ottenuto scegliendo sempre quella più frequente. Né l’esperienza, né il titolo di studio, né la fiducia nell’IA permettono di prevedere chi si affiderà all’agente, e chi ha seguito l’agente in tutte e quattro le scelte si dichiara quasi altrettanto sicuro di sé quanto gli altri (71 contro 73 su 100). Anthropic ne ricava una questione collettiva: se più team si affidano a modelli con le stesse preferenze, il loro accordo può non essere più indipendente, e un revisore umano della ricerca sulla sicurezza dell’IA costituisce un controllo solo se il suo giudizio resta autonomo.
Il resto della giornata riguarda la manutenzione: Copilot CLI e la nightly di Gemini CLI non aggiungono alcuna funzionalità, mentre Qwen Code attiva per impostazione predefinita un’interfaccia finora sperimentale, prevedendo al contempo che /autofix-pr restituisca il controllo a un essere umano dopo tre fallimenti. Per i modelli aperti, il valore sta nelle condizioni di misurazione: la scheda di AMD quantifica quanto costa la sua quantizzazione MXFP4 in termini di prestazioni su GSM8K, mentre Pramaan, AtMem e ViKernel pubblicano risultati ottenuti dai rispettivi autori, su una sola esecuzione, una versione fissata o strumenti simulati.
Fonti
- Studio di Anthropic sulle scelte discrezionali degli esperti
- Copilot CLI 1.0.106-2
- Qwen Code v0.26.5
- Nightly di Gemini CLI del 1° novembre
- @sqs: widget dell’applicazione iOS di Amp
- @MiniMax_AI: quantizzazioni di M3.1 Flash
- Scheda Hugging Face di MiniMax M3.1 Flash Quark MXFP4 (AMD)
- Post di Kshitij Thakkar su Pramaan
- Post di Javad Taghia su AtMem routed-v4
- Post di VIDRAFT su ViKernel